2026.10.29 · AI CODING × 3 / 具身智能 × 2
同一套题
五个分数
ONE TEST, FIVE SCORES
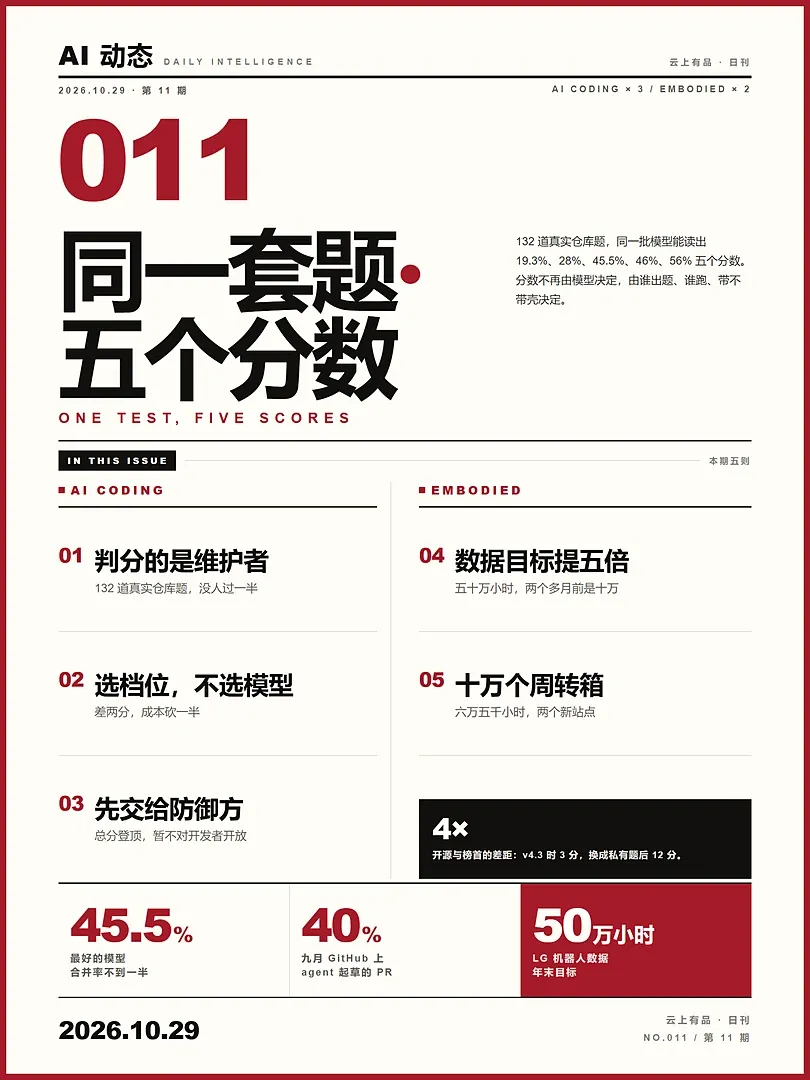
132 道题全部来自真实开源仓库,由二十多位维护者按「我愿不愿意合并这段改动」打分,任何一项阻塞检查失手就是零分。厂商自己的表上,最好的 Claude Opus 5.5 拿到 45.5%,没有一个模型过一半。
第二天,Artificial Analysis 把同一项装进新指数:Opus 5.5 是 46%,DeepSeek V4.1-Flash 是 28%——而它在厂商表上只有 19.3%。同一批模型,同一套题,五个分数。分数不再由模型单独决定。
「记分牌不止一块,选哪一块就是在定价。」
01 / AI CODING — 三则
判据换了主人
分数就散了
所有编码榜都在问「能不能跑通」。FrontierCode 2.0 换了一个问法:维护者愿不愿意把这段改动合进自己的仓库。
10 月 27 日,Cognition 发布 FrontierCode 2.0。题目由二十多位开源维护者从自己的仓库里出,每人每题投入四十小时以上;一共 132 道,全部是真实的、带着原有代码风格与历史包袱的任务。评分不是「测试过没过」,而是一组加权细则:功能对不对、对一段故意写得不充分的提示解读得够不够、设计与改动范围是否克制。任何一项阻塞性检查失手,整题记零分。
2.0 比 1.1 严在哪里,官方给了对照:题目来自多 55% 的仓库,阻塞项多 43%,参考解要多改 67% 的文件、89% 的行,代码库本身大 25%;参考解与上游原始提交不一致的比例从 60% 升到 80%。最关键的一处迁移是「彻底性」类阻塞项从 168 条涨到 501 条,接近三倍,成了最常失守的一类;反过来,「改动范围」类放宽了,平均失守率从 9.0% 降到 3.8%。翻成一句话:修一个地方不算修好,所有同类地方都得修。
结果全线掉下来。Claude Opus 5.5 45.5%(1.1 上是 54.6%),GPT-6 Astra 42.8%(53.3%),Claude Sonnet 5.5 41.0%,Grok 4.7 28.6%(47.6%),Gemini 4 Argon 26.3%(47.5%),Muse Wonder 1.0 24.3%,SWE-2 23.9%(50.0%),DeepSeek V4.1 Flash 19.3%,Kimi K3 17.7%。没有一个过一半。
第二天,Artificial Analysis 发布 Intelligence Index v5,把 FrontierCode 2.0 直接装进主指数,占编码那 25% 权重里的 15%,Terminal-Bench 4.0 占剩下的 10%。同时把 60% 的评测权重建在私有测试集或隐藏答案上——这是它自今年 1 月 v4 上线以来最大的一次重构,公开题库里被训练数据污染过的空间,被系统性地挤掉了。
同一项、同一批题,AA 给出的数字是:Opus 5.5 46%,DeepSeek V4.1-Flash(max 档)28%,Gemini 4 Argon 25.7%,Kimi K3.1 Pro 25.5%,GPT-6 Luna 25.2%。对照厂商表,Opus 5.5 只差 0.5 分,几乎完全复现;DeepSeek 从 19.3% 跳到 28%,差 8.7 分——这个距离比第一名到第五名之间的差距还大。
两边都没有解释这 8.7 分从哪来。可以确定的是:这道题现在有两个官方分数,而且都不是错的。厂商按自己的壳跑,AA 按自己的壳跑,模型只是其中的一个零件。
再加一层壳,数字还会变。在 AA 那张把「模型 + 编码工具」一起打分的 Coding Agent Index 上,Claude Code 挂 Opus 5.5 Max 在 FrontierCode 上是 56%,比裸模型的 46% 高 10 分;GitHub 的 Copilot Fusion Max 在同一项上是 51%。同一套 132 道题,从 19.3% 到 56%,横跨 37 个点。
这才是 v5 真正改掉的东西。它没有让模型变差,它让「一个模型一个分数」这件事不成立了。九项评测里没有模型全拿:Opus 5.5 拿下 FrontierCode 与 HLE-Diamond(68%)以及 AA-Omniscience(48 分);GPT-6 Astra 拿下 Terminal-Bench-Science(63%)与 CritPt v2 难题子集(72%);Kimi K3.1 Pro 在 Terminal-Bench 4.0 上以 67% 领先;Gemini 4 Argon 在 AutomationBench 上是 78%;Claude Sonnet 5.5 在 AA-Briefcase 上拿到 1812 Elo。总分榜是 Opus 5.5 58、GPT-6 Astra 57、GPT-6.1 Sol 55、Gemini 4 Argon 50。
努力值这一栏也在放大分化。Opus 5.5 从最低档到 max 档跨 23 分,单任务成本从 0.98 美元涨到 10.04 美元,差十倍。Sonnet 5.5 的档间分差从 v4.3 的 20 分扩到 29 分,GPT-6.1 Sol 翻倍到 20 分。同一个模型,省钱模式和全力模式,已经不是同一个模型。
开源那一侧的账更清楚。v4.3 时,最强开源模型与榜首差 3 分;v5 把公开题换成私有题、加重智能体实战之后,差距变成 12 分,四倍。Kimi K3.1 Pro 以 46 分是名义上最强的开源权重模型,但权重要到 11 月 4 日前才发;已发权重的天花板是 32 分,DeepSeek V4.1 Flash 与 GLM-5.3 并列。
落到采购上只有一句话:这个分数是哪张表出的、跑在哪个 effort 档、带不带壳、判据是谁写的。四项缺任何一项,数字都不能横向比。
这一则的三条线
COMPARISON — 同一项,五个分数
一道题
五种结算
五条都叫 FrontierCode 2.0,来自三份不同的表:厂商发布表、AA 的模型榜、AA 那张把模型与编码工具合起来打分的 agent 榜。「带壳」指的是 Claude Code 挂 Opus 5.5 Max。五条互不换算,也不该被平均——它们量的是同一个模型在同一套题上、被不同的人跑出来的结果,横轴都是百分比,每条都对应同一批 132 道题。
SIGNAL — 另外两则
首发给了防御方
模型退到后台
GEMINI 4 CARBON · 先给防守的人
10 月 29 日,Google 发布 Gemini 4 Carbon,在 AA 的 v5.0 榜上以 59 分排第一,压过 Opus 5.5 的 58。定价与两周前的 Argon 一致:入门期每百万 token 输入 2 美元、输出 10 美元,缓存输入再打 95% 折;优惠结束后回到 4 美元与 20 美元。
官方把重点放在网络安全全流程:SEC-bench Pro 88.2%,在真实软件里挖隐藏漏洞;ExploitGym 54.8%,判断漏洞能不能真被利用;CWE-bench 71.0%,把验证过的漏洞变成能跑的补丁。WebDev Arena 上升 89 个 Elo 到 1769 分,排第四。
官方称它生成安全代码的成功率比 Argon 提升两倍以上;Chrome 团队称它出高质量补丁的水平比其它实验室的前沿模型好 10 倍。这两条都没有第三方复现。长程任务是另一半卖点:连跑数天、穿过多次失败路径,完成跨大代码库与底层系统的根因定位。
这周先给部分网络安全防御方,之后才逐步扩到可信合作方,最后才是开发者、企业与消费者。一个新模型的第一批用户不是开发者,而是防守方——能力到了「先控制谁能用」比「先让更多人用」更要紧的阶段。
GITHUB COPILOT FUSION · 不再选模型
10 月 28 日 Universe,Copilot Fusion 全量开放。模型下拉框换成一个档位:Standard / High / Max。三种跑法由路由当次决定——单模型直接做;级联,便宜模型起草、质检不过就升级;互评,一个起草、另一个审、起草的改。
在 AA 的 Coding Agent Index 上,Fusion Max 60 分,Claude Code 挂 Opus 5.5 Max 是 61.7;单任务 5.59 美元对 11.42 美元,token 约一半,时间少约 40%。省下的钱来自把简单步骤分给便宜模型,不是模型本身更强。
Terminal-Bench 4.0 上 Fusion 以 71 排第一,FrontierCode 上 51 排第三,Claude Code 加 Opus 5.5 在后者是 56。同一个产品,三个榜,第一、第三、差两分——多模型编排本身就很难被单一指标描述。
企业客户不再单独买 Copilot 订阅,按消耗的 AI credits 付;付费档用 Fusion 的模型费用打七折到 11 月 30 日。平台侧的底数:九月有 40% 的 PR 起于 agent 草稿,三月是 17%,单月 1.1 亿次;同期 61% 自选模型的用户用了不止一个模型。
左边这条最该记的不是 59 分,是发布顺序。一个前沿模型的第一批用户是防守方而不是开发者,等于承认「谁能用」已经和能力本身一样重要。同时要看清:88.2%、54.8%、71.0% 三个数字全部出自厂商,独立复现还没出现。
右边给的是采购口径。Fusion 不是更强的模型,是把「用哪个模型」这个决定从人手里拿走,换成一套路由加三个档位。它省下的钱来自把简单步骤分给便宜模型——在每一步都需要最强模型的均匀负载上,这个优势会缩小。而它在三个榜上位次不同,正好说明:编排层的价值不在分数,在被编排之后还能不能解释清楚每一步是谁做的。
02 / EMBODIED — 两则
不再报成功率
改报小时和箱
具身智能这一侧,这一周公布的全是可以被审计的累计量:数据小时、运行小时、搬运件数、年产能。
10 月 28 日,LG 电子在三季度电话会上把机器人数据工厂的目标改了:原定今年 10 万小时,现在要累计 50 万小时——两个多月,五倍。工厂在首尔瑞草良才研发园区,一万平方米,四季度全面运营,与英伟达在仿真、世界模型与开发平台上合作。昌原的执行器试产线上半年已经建成,下半年在做量产准备。
顺序也讲清楚了:先做制造与物流,2030 年再进家庭。家庭那一步的答案不是「机器人更强」,是「家电也一起改」——他们在同时准备「为机器人设计的家电」和「为家电设计的机器人」。与英伟达合作的双足人形计划 2027 年一季度亮相。中长期还留了一个口子:数据可以对外卖,也可以做付费测试服务。
50 万小时不是能力指标,是原料库存。它的意思很直接:这一行现在最缺的不是模型,是能被用来训练的小时数;而小时数可以被计划、被审计、被写进季报,成功率不行。
另一个方向来自仓储。10 月 28 日,GXO 与 Agility Robotics 扩大合作,把 Digit 部署到北卡 Statesville 与田纳西 Lebanon 两个站点。自 2024 年那份被称作行业第一份人形机器人商业化部署、也是第一份按机器人服务计费的合约以来,Digit 在佐治亚 Flowery Branch 一个站点搬了超过 10 万个周转箱;全部商用与客户项目累计超过 6.5 万小时真实运行。
扩产的节奏也写死了:2027 年初先上 Digit 4,等 Digit 5 商用再迁。俄勒冈 Salem 的 RoboFab 七万平方英尺,设计年产能 1 万台。与 Churchill Capital Corp XI 的合并预计今年四季度完成,之后就是一家上市公司。
10 万个箱子是这一行目前唯一被公开的「累计交付」账本。它不含成功率,也不含节拍,只含做了多少——而这恰好是采购方唯一能拿去核对的数字。演示视频可以重拍,班表和电费不能。
记小时
数据小时决定能训什么,运行小时决定能承诺什么。LG 与 Agility 报的都是这一栏,而不是某一项任务的峰值成功率。
记件数
10 万个周转箱比任何演示都难伪造,因为它对应班表、电费与故障停机。件数是唯一自带成本凭证的指标。
记产能
年产能 1 万台、2027 年初上 Digit 4。这两句是写给采购和投行的,不是写给展会的——产能意味着交付可以被排期。
这两个数字单位一样、含义不同:LG 的 50 万小时是准备用来训练的原料,Agility 的 6.5 万小时是已经交付的劳动。它们都不能换算成成功率——而这正是它们值得引用的原因:能公开的数,通常是能被审计的数。
03 / LEDGERS — 四种记法,四本账
四种记法
四本账
这一期的五个数字,各自记在不同的账本上。把它们并排放,比任何一个单看都清楚。
01被合并的比例
FrontierCode 2.0 的 132 道题,最好成绩 45.5%。分子是维护者真点了合并的,分母是全部提交。这是今天唯一一个由收货方打分的编码指标——它不问你有多强,只问这段活我收不收。
02两份表的差
同一个 DeepSeek V4.1-Flash,厂商表 19.3%,AA 复现 28%,差 8.7 分。差在哪没有公开说明,两家也都没撤回自己的数字。这不是谁错了,是两份不同的壳。
03原料库存
LG 的 50 万小时,是年末要达到的累计数据量;两个多月前这个数字还是 10 万。它说明这一行的瓶颈不在模型侧,在能被采集、清洗、标注的小时数上。
04交付账本
Agility 的 10 万个周转箱与 6.5 万小时,是累计做过的活,不是某一次做成的峰值。年产能 1 万台是这本账的下一行——它把交付变成了可以排期的东西。
CHAIN — 五环
从「跑通」
到「收下」
五条线索走的是同一个方向:判据从产出方手里,移到收货方手里。
判据换人
从「测试过不过」换成「维护者愿不愿合并」。132 道题,最好 45.5%,没有一个过一半。
分数裂开
同一个模型,19.3% 与 28% 都是官方数字;同一份权重加上壳,还能到 56%。
计费换单位
Copilot 从席位换成 credits,模型下拉框换成三个档位。钱按用掉的算,不按坐进来的人算。
首发换对象
Carbon 先给网络安全防御方,再给开发者。谁先用,也是发布策略的一部分。
具身换账本
不报成功率,报 50 万小时数据、10 万个箱子、1 万台年产能。可审计的量才有采购价值。
链上最容易被忽略的是第二环。分数裂开之后,比的就不再是模型,而是「谁有资格出这张表」。Cognition 出题、AA 复现、GitHub 自己报——三张表在同一个星期出现,没有一张是中立方的。这意味着任何一次横评,都必须先回答一个采购问题:这张表的作者,最后要从谁的采购单里收钱。
BOUNDARIES — 三条边界
引用之前
三件事要写明
不可比
FrontierCode 2.0 与 1.1 不是同一套题:Opus 5.5 从 54.6% 掉到 45.5%,是题变难了,不是模型变弱了。跨版本比分数,等于换了一把尺子还按旧刻度读。
自报
Carbon 的「两倍」与「十倍」、Fusion 的「一半成本」、LG 的「50 万小时」,全部是厂商口径。第三方复现出现之前,它们只能当方向,不能当结论。
样本
132 道题、二十多位维护者,样本不大。第一名与第三名之间只差 4.5 分,这个距离不构成排序,更不构成采购理由。
CLOSING — 本期结论
这一期没有新模型的故事,只有记分牌的故事。
132 道真实仓库题,Claude Opus 5.5 在厂商表上是 45.5%,在 AA 的模型榜上是 46%,加上 Claude Code 这层壳是 56%;DeepSeek V4.1-Flash 在厂商表上是 19.3%,在 AA 那儿是 28%。五个数字都叫 FrontierCode 2.0,没有一个错。
同一个星期,另外三件事也在换账本。Gemini 4 Carbon 拿下总分第一,但第一批用户是网络安全防御方;GitHub 把模型下拉框换成三个档位,企业改成按 credits 付费;LG 把机器人训练数据目标从 10 万小时提到 50 万,Agility 报出 10 万个周转箱与 6.5 万小时。
串起来是一句话:能力还在涨,但「能力」这个词已经装不下一个数字了。判据是谁写的、跑在哪个档、带不带壳、算的是小时还是件数——每一项都在改这把尺子的刻度,也每一项都在改价目表。
所以这一期真正该带走的不是那五个分数,是那四个问题。答得出来的人,能把分数变成采购条款;答不出来的人,只是把别人的尺子当成了自己的能力。
云上有品 · AI 动态 · NO.011