2026.11.01 · AI CODING × 3 / 具身智能 × 2
放宽计量
收紧验收
LOOSER METERS, TIGHTER GATES
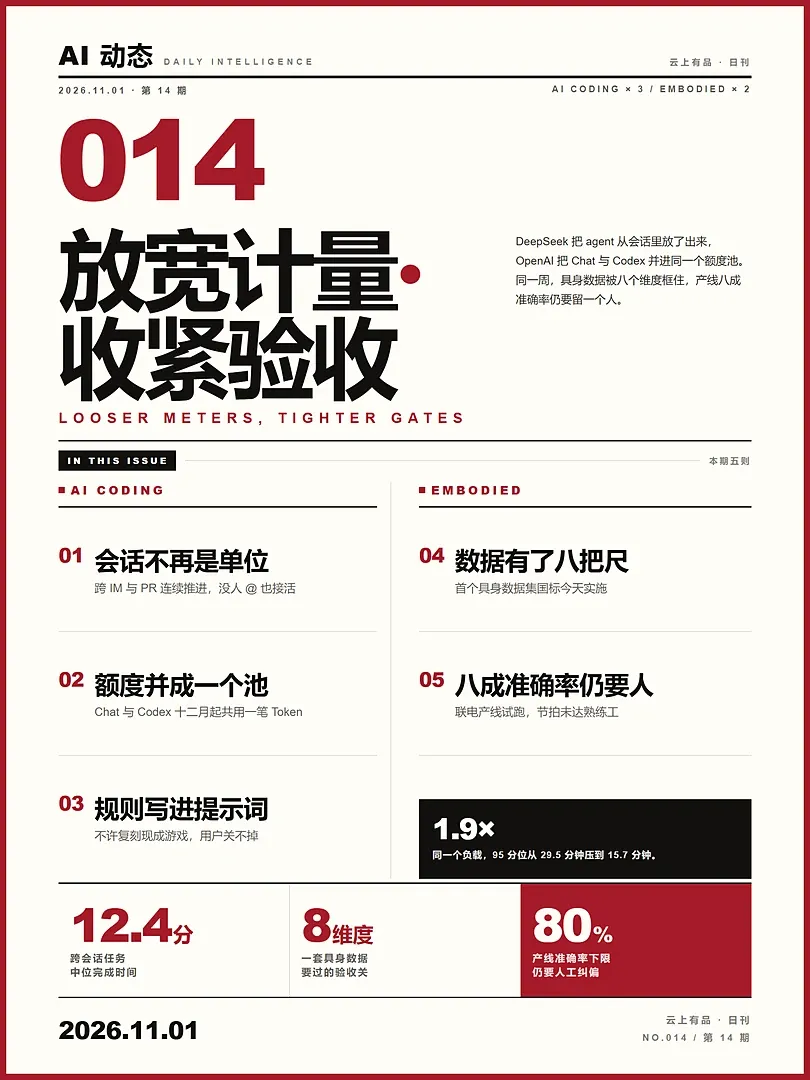
10 月 31 日晚,DeepSeek 把一个 agent 从会话里放了出来:任务中位 12.4 分钟完成,95 分位 15.7 分钟,对照的单会话方案是 29.5 分钟。同一天,工信部给具身数据集定了八个维度;联电上海工厂的机器人试跑准确率 80–90%,仍要人修偏差。
软件这一侧在把量词放大,硬件那一侧在把量词做实。这一期五件事,做的都是同一件事:换量词。
「放开的每一寸,都要重新量一遍。」
01 / AI CODING — 三则
一个智能体
不再有会话
会话是给人用的单位,不是给 agent 用的。
10 月 31 日晚,DeepSeek 的 Harness 团队发了一篇技术文章,标题是《Super-agent 设计探索:迈向更自主的 Agent 系统》,同时把原型代码放上了 GitHub。
它提的问题很朴素:现在所有 agent 都以一个会话为单位。一个会话里能干几件事,取决于人还记得多少上下文、还在不在电脑前、有没有同时开三个窗口。人的注意力,成了系统的并发上限。
Super-agent 想要的是另一种东西:一个跨会话、能并行推进多件事、不用人逐条下指令、出问题能自己恢复的连续实体。团队给了四个词——连续、高效、主动、持久。
做法是把系统劈成两层。上层 Router 收消息、分任务、维护全局上下文;下层 Worker 只管执行。用户面前始终只有一个 agent,底下开了几个会话由系统自己管。开发者不用再记住每个会话进行到哪一步,也不用反复交代前情。
第二个设计叫「订阅与直通」。一个 Worker 接手某条 GitHub PR 之后,可以直接订阅这条 PR 的后续评论;有人提修改意见,消息直接进这个 Worker,不必再经 Router 转发。团队做了对照:去掉直通,Router 的决策次数增加约 30%,读缓存的 Token 从 2,323 万涨到 3,177 万。
也就是说,直通不只是体验优化,它是成本结构的一部分。
第三个变化在工具调用上:从「单次函数调用」变成「持续事件订阅」。它要跨 IM 群聊、GitHub、邮件一起工作,消息不再是孤立指令,而是持续流入的事件流。配合两级过滤——先用程序规则筛掉无关消息,再让模型判断剩下的事件要不要动手——把无效调用压下去。
最能说明它想变成什么的,是一个叫「投机执行」的机制。群里有人在讨论一个 Bug,agent 可以先自己去复现、查原因,找到一条简单可行的修复,再交给用户;没找到有效结果就保持安静,不打扰人。
团队说,内部实例已经在这么做:持续盯公共群聊,没人 @ 它也能识别出缺陷,在后台试着修,然后提 PR。它同时参与问题复现、代码审查响应和自己的迭代。
持久性靠存算分离。计算可以在云上跑,会话状态单独存,本地保留原来的工作环境。笔记本合上、机器离线,云端的 agent 仍然维持着任务状态,等设备重新上线接着做。
实验在模拟环境里跑:约 300 条消息、20 项工作请求,对比 Super-agent 和「单会话 + 子 agent」两种配置,每种重复 5 次。结果是任务完成时间中位 12.4 分钟、95 分位 15.7 分钟;单会话方案在中性提示下,95 分位是 29.5 分钟。
尾延迟从 29.5 压到 15.7,接近腰斩。这是这组数字里最值钱的一条——中位数只说明典型任务快不快,95 分位才说明最慢的那批会不会拖住整条流水线。同一篇里还有一个:Router 批处理之后,单个决定分摊到的推理时间从 6.4 秒降到 1.6 秒。
代价也写在文章里:它是拿更多 Token 换时间和稳定性。团队自己标了边界——实验基于合成负载与简化环境,只能算初步参考,既不是产品结论,也不是对外的性能承诺。
真正拦在生产前面的不是这些数字,是另外几件事:权限体系、审计日志、可观测性、成本治理、工具接口标准、状态存储一致性。这些在原型里都没有答案。
最后一句留给单位。过去一年,AI 编程的评价单位是「一轮对话答得对不对」。Super-agent 把单位换成了「一件事从投递到关闭要多久」。换完之后,之前所有跑分都不能直接拿来做横评——它们测的其实是另一个东西。
这一则的三条线
SIGNAL — 另外两则
一个把池子并了
一个把名字改了
OPENAI · 十二月起,一个池子
从十二月起,Plus、Pro 与 Business 的配额在 ChatGPT 和 Codex 之间共享。计量方式也从「几小时内能发多少条消息」改成按 Token 算。只有日常的即时聊天不扣额度,也不计入任何一档。
各档到底有多少 Token、不同模型之间怎么折算,官方都没有给表。给的是一句承诺:绝大部分人被卡额度、等重置的频率,不会比现在更高。
10 月底先把 Pro 100/200/500 与 Business Premium 的工作与 Codex 额度翻倍,同时撤回了 Pro 200 原定的削减;十一月小范围测试界面合并;十二月才合池。同一周还上线了设备绑号上限,登出旧账号不释放名额。
ANTHROPIC · 「20x」一直不是周额度
10 月 30 日,Max 5x 改成 Max(仍是每月 100 美元),Max 20x 改成 Ultra(仍是 200 美元)。老用户自动切换,不用做任何操作。
通过验证的 Ultra 账户取消 5 小时滚动窗口。周上限一动没动,仍是 Pro 的 10 倍;Max 档的 5 小时窗也还在。额度总量没有增加,变的是一天里的节奏。
订阅产品负责人公开致歉:2025 年 4 月设这档时只有 5 小时窗,额度是 Pro 的 20 倍,所以叫 20x;后来加了周上限,定在 10 倍,名字没跟着改。名字里的 20x,从来不是周额度。
两件事发生在同一周,方向相反,动的是同一样东西:额度这个单位的边界。
OpenAI 把边界往外并——两条产品线合成一个池;Anthropic 把边界往上挪——5 小时的窗换成一整周。但两家都没把最重要的那张表放出来:一个池子里究竟有多少 Token,一周究竟等于多少次调用。用户拿到的是更大的容器,不是更多的水。
COMPARISON — 五十万小时够不够
数据按小时算
缺口按倍数算
截至 2026 年初的行业口径:全球高质量真实物理交互数据总量约 50 万小时,而让物理 AI 真正跑起来需要千万小时量级,缺口超过 95%。第三行不是增量,是那 50 万小时里少数被公开披露的单家盘子——睿尔曼的真机数据累计签约近 10 万小时,光轮智能开源十万小时全模态人类数据集。两根细线说的是同一件事:喊得最响的量级,放到这条尺子上只有个位数百分比。
02 / EMBODIED — 两则
数据先过八道关
产线还留一个人
数据集从「有多少小时」变成「过几道关」。
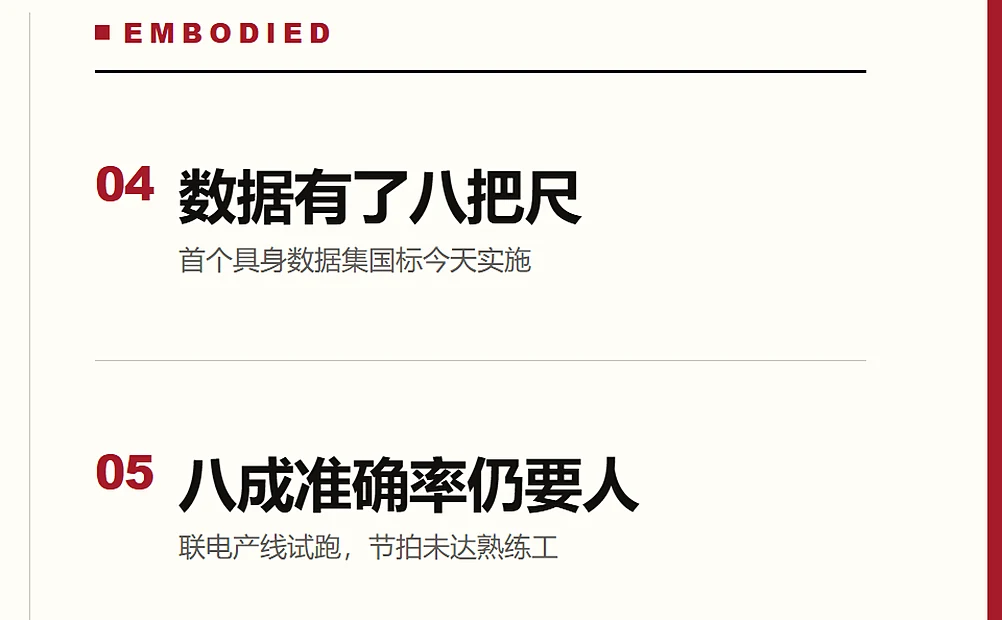
11 月 1 日,工信部的 YD/T 6771-2026 开始实施,名字是《具身智能数据集质量要求及评价方法》。这是国内第一份针对具身智能数据集的质量标准。
它给了八个维度:完整性、一致性、多样性、真实性、易用性、实用性、可扩展性、安全性。
此前这一行没有统一评判标准。3D 训练数据的格式各写各的,一套数据从一个团队搬到另一个团队,往往要先重做一遍清洗和标定,很难当成资产交易。标准落地之后,至少有了同一把尺子。
为什么这把尺子现在才来?因为数据缺口大到没法再用「我们在采」来回答。同一周里,供给端的三条动作都围着这个缺口转:睿尔曼说自 6 月进入规模化交付以来,真机数据累计签约近 10 万小时,月交付能力到万小时级;光轮智能开源了十万小时的全模态人类数据集;再往前,优必选 Walker S 系列的数采订单已超过 7.5 亿元。
但小时数不是答案。50 万小时里有多少能直接进训练,取决于它过得了八道关里的几道。这才是标准真正的杀伤力:它不增加数据,它让一部分存量数据的价值归零。
产线那一端,同一周给了一个更朴素的对照。
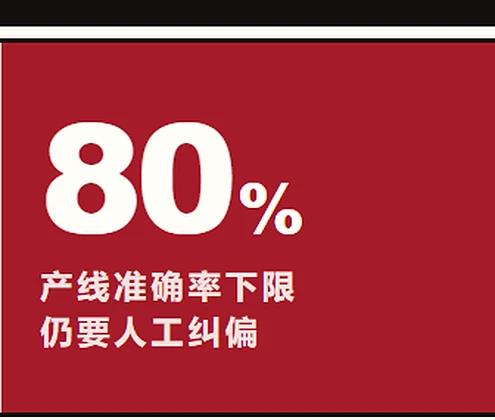
博银合创的首台具身机器人进入联合汽车电子上海工厂的量产线试跑,做标准化取放料。设备今年 6 月才开始调试,10 月进线。当前作业准确率 80–90%,支持热插拔换电,单电池续航约 6 小时;仍需要少量人工介入修正放料偏差,整体节拍效率尚未达到熟练人工水平。
联电上海厂厂长的说法是,焊接、拧紧、点胶这些高精度工艺早已全面机器替代,但线边物料搬运、上下料、散料分拣这些末端环节,长期高度依赖人工。传统工业机器人对定位精度要求太高,AGV 解决了车间大范围运输,最后那一公里的精准取放料一直没有成熟方案。
所以这条新闻真正的价值不是 80–90% 这个数字,是它把失败率和接管环节一起公开了。过去两年,具身智能对外的数字多是「演示成功率」;演示允许重试、允许挑场景、允许人在旁边看着。产线不行。
准确率
取放料 80–90%。这是单工位试跑口径,不是整线验收,也不是长期稳定性。
人还在
仍需少量人工修正放料偏差,节拍未达熟练工。替岗和并岗,是两个不同的采购决定。
成本线
业内测算整机降到 20 万元以下才有大规模替代的经济性。热插拔换电,单电池约 6 小时。
这条线还有一个容易被忽略的细节:四个月,从调设备到进量产线试跑。博银合创是博世集团旗下博原资本与银河通用联合孵化的公司,走的是垂类路线——不追全场景泛化,只做工业制造与厂内物流。垂类的好处是任务边界清楚,数据能攒成可复用的作业序列;坏处是每换一个工位,验收都要重来一遍。
把两件事放在一起看:标准在给数据发尺子,产线在给机器人发考卷。尺子和考卷都不是能力,它们是让能力可以被比价的东西。
03 / METERS — 四个新量词
换一个量词
换一套算法
分钟 / 任务
中位完成时间。单位从「一轮对话」变成「一件事做完」,尾延迟比平均更值得看。
道关 / 数据
从按小时计价,改成按八个维度验收。存量数据第一次有了「不合规」这个状态。
% / 产线
准确率下限。剩下那一到两成,是人。人机配比开始进采购条款。
万小时 / 签约
睿尔曼的签约量。它和交付量之间,隔着验收合格率这一层。
CHAIN — 五环
从「一个会话」
到「一份验收单」
五件事串成一条链:量词一变,上下游的账都要重记。
换量词
agent 从会话变成任务,额度从条数变成 Token,套餐从 5 小时变成一整周。
换口径
任务完成时间、尾延迟、Token 成本,替下了单轮准确率和消息条数这两个旧指标。
换分母
数据不再按小时算,按八道关算。50 万小时里能用的,没有 50 万。
换验收
产线不看演示成功率,看准确率、人工介入率、节拍这三样。
换账本
订阅变成算力钱包,数据变成可评估资产,机器人变成产线上的一条有效工时。
链上最容易断的是第二环。量词和口径是两件事:把「消息条数」换成「Token」,如果折算表不公布,用户只是换了一个自己看不懂的数字。到今天为止,OpenAI 没有公布各档的 Token 总量,Anthropic 的周额度也只以「Pro 的几倍」表达,没有绝对次数。
BOUNDARIES — 三条边界
三件事
还不能当定论
未复现
12.4 与 15.7 来自合成负载与简化环境,团队自己写明是初步参考。Router、Worker 与 Watchdog 是否用不同规模的模型,原文没有披露。
未公布
十二月合池之后各档的 Token 总量与折算表都没有放出来。官方承诺的是「被卡额度的频率不会更高」,不是「总量更多」。
非交付
10 万小时是签约量不是交付量;80–90% 是单工位试跑不是整线验收;国标只管质量维度,不管数据够不够用,也不管谁能用。
CLOSING — 本期结论
这一期五件事,做的都是同一件事:把量词换掉。
agent 的量词从「会话」换成「任务」,额度的量词从「条数」换成「Token」,套餐的量词从「5 小时」换成「一周」,数据的量词从「小时」换成「维度」,机器人的量词从「台」换成「工时」。
换量词看着是文字工作,其实是定价工作。一小时的采数服务和一套过了八道关的数据集,成本差好几倍;一次会话和一件做完的事,价值也差好几倍。谁先把量词定下来,谁就拿到了报价的主动权。
但今天这五个新量词,有四个还没有公开的换算表。12.4 分钟来自合成环境,Token 池没公布容量,八个维度没有权重,有效工时没有统一算法。
于是所有对外的数字都还能用,只是不能相加。
云上有品 · AI 动态 · NO.014