2026.11.04 · AI CODING × 3 / 具身智能 × 2
一格之内
全是真的
TRUE INSIDE ONE CELL
Revolut 把两千名工程师的日常编码换成自建模型,账单剩十分之一;小米的机器人在一个工位上跑满八小时。
五件事都成立,只是每一件都只在一格里——格子是验收划的,不是能力划的。
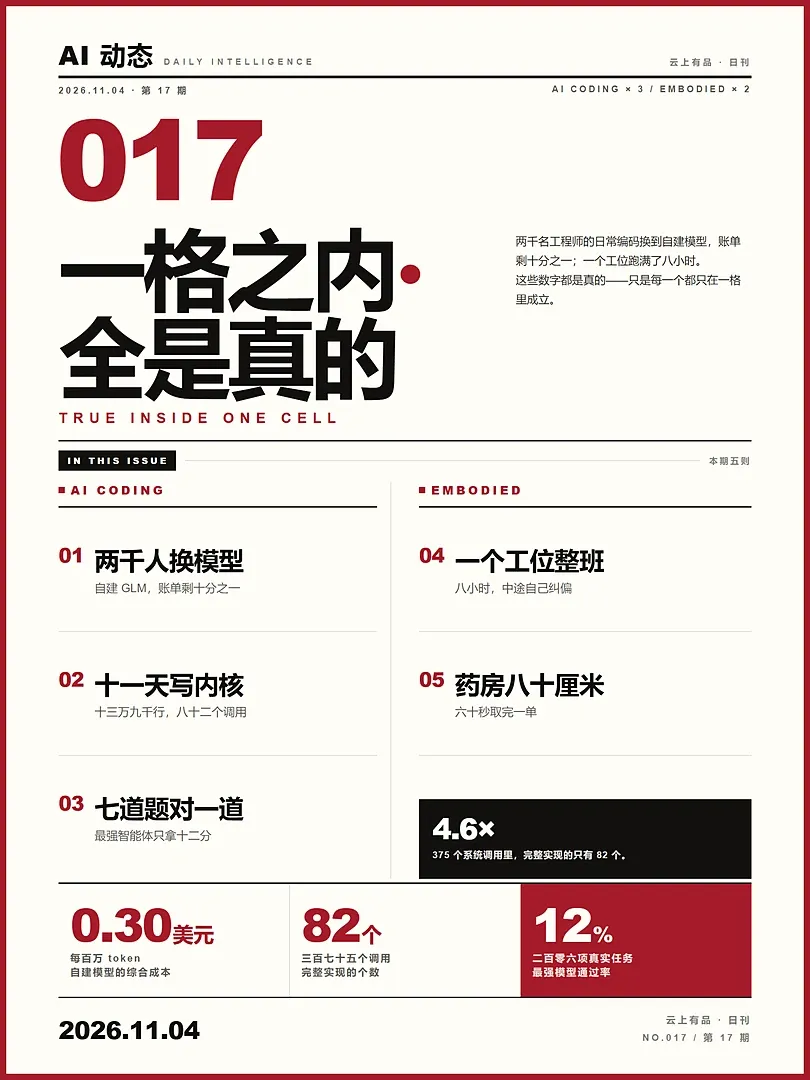
「格子是验收划的,不是能力划的。」
01 / AI CODING — 三则
账单剩一成
没人再省着用
同一批人,同一个模型,只是换了一种买法——结果连用法都变了。
11 月 3 日,Revolut 的 AI 运营负责人 David Abitbol 在 Hacker News 上摊开一笔账:这家欧洲估值最高的金融科技公司,把约 2,000 名工程师的默认编程模型,从 Claude Code 换成自建的智谱 GLM 5.3。
换之前是订阅制。每人每月 300 美元额度,公司给得克制,工程师用得更克制——额度是有限资源,谁都不会拿它去查文档。Abitbol 的说法是,这种额度对整体效率的帮助有限。
今年 4 月起,Revolut 在自己的机房跑 GLM。约 56 张英伟达 B200,折算下来每百万 token 的综合成本约 0.30 美元,账单降到此前的十分之一。额度取消,Token 不限量。
行为跟着变了。过去要省着花的那部分配额,现在被用来搜内部文档、处理 Jira 工单、翻 Slack 里的需求说明。公司内部统计:编码用时改善约 60%,从接手任务到交付的周期改善约 70%。
但真正被换掉的不是模型,是采购单位。从「每人每月多少美元」变成「多少张卡、多少电、多少运维」。按人计价时,成本随人数线性涨,于是公司必须限流;按卡计价时,边际成本接近零,限流就失去了意义。
这条线的边界也很清楚:Claude Code 和 Codex 没有退场,只是退成「例外」,留给最复杂的那部分任务。九成日常交给自建,一成难活留给前沿闭源——这个比例是公司自己划的,不是模型能力划的。
值得记的是因果方向。过去两年 AI 编程的提效一直不及预期,一个常被忽略的原因是配额制度本身在训练工程师「少用」。把计量单位换掉之后,同样的人、同样的模型,用法完全变了。
这一则的三条线
02 / AI CODING — 一份接口清单
十三万九千行
八十二个调用
代码写完了,接口没写完。这两句话之间,隔着一整个操作系统的距离。
10 月 27 日,CentOS 创始人、Rocky Linux 发起人 Gregory Kurtzer 公布了一个叫 Ginux 的项目:11 天,约 13.9 万行保留代码,1,037 次提交,261 个跟踪文件,63 个 Rust 源文件。
它不是 Linux 的分支。内存管理、调度器、进程模型、文件系统、网络和设备支持全部从头写;实现 Linux ABI,所以未经修改的 Linux 二进制可以直接跑。项目能构建成 GINUX.EFI,通过 UEFI 直接启动,不依赖宿主内核。
验收关卡是 systemd。Ginux 拉取并校验 OCI 镜像、用它组装「域」的根文件系统,把 Rocky Linux 10 启动到 multi-user.target。部分 Alpine 程序也能跑,比如 musl 和 BusyBox。
然后是那个不该被略过的数字。以 Linux 6.12 的 x86-64 接口为参照,375 个系统调用里,完整实现 82 个,部分实现 245 个,48 个被有意设为不可用。
性能也有一份对比:Apple Silicon 上的虚拟机,单核 2 GiB,启动到可登录 12.9 秒,Linux 是 42.6 秒;三项 sysbench 各测九次取中位数,差距在个位数到十几个百分点。但前一个数字不算数——Ginux 不用加载内核,文件系统还是现成缓存的。
方法论比结果更可复制。人的部分只有四件事:定架构、定约束、定验收关卡、解读故障。实现、构建、在 QEMU 里跑、测量、修订、回归,全交给一个持续运行的 Codex 任务,用的是 GPT-5.6 Sol。API 费用约 8,000 美元。
有个细节值得单独记:他对一些大块代码不满意,却刻意不亲手改,甚至关掉了 IDE——AI 做错时,他就只能重新给指令。他的说法是「关卡设得多」。没有引导的氛围编程不适合这个项目,因为很多故障会产生看起来很可信的输出,却违反 Linux 语义。
四根条量的是同一份清单:Linux 6.12 的 x86-64 系统调用。Ginux 只在 QEMU 里跑过,没有物理硬件、没有 GPU,也没有做过独立安全审计——项目自己的措辞是「研究原型,不主张可用于生产」。Kurtzer 给出的结论是,兼容性、硬件支持、标准、社区和长期维护才是护城河。13.9 万行证明的是能写,82/375 说明的是还差多远。
03 / AI CODING — 两笔账
判据换成交付物
用途换成陪伴
SEMIANALYSIS · 206 项,8 小时,12%
不要答案,要一份能过资深审阅者的文件。交付物是 XLSX、PPTX、DOCX、PDF,或者直接改一份现成的。
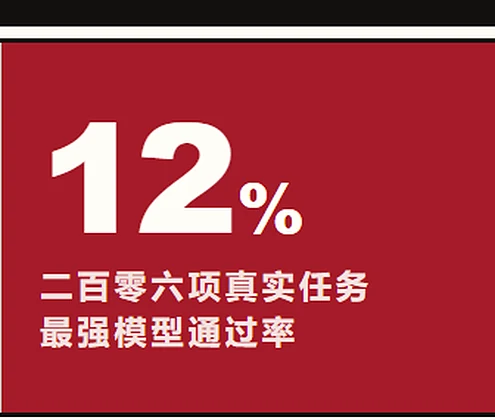
11 个领域、206 项任务,由 14 家专业伙伴分头供题:私募股权交易现场、真实零日漏洞、样本外每日盈亏。默认限时 8 小时。
原文口径是「即使最好的模型也只拿到 12%」,7 题里对 1 题。转述里排在最前的是 Claude Opus 5.5、Gemini 4 Carbon 与 GPT-6 Astra,成本分别约 51、16、54 美元一个任务。
12% 配 51 美元,等于每交付一件约 425 美元算力,还不含人工验收。便宜那条线约 147 美元,通过率只低一个点。
优必选 · 16.98 万,卖的是陪伴
U1 Pro,1:1 全尺寸,男款 1 米 83、女款 1 米 68。硅胶仿生皮肤加多自由度面部驱动,会眨眼、皱眉、微笑。
16.98 万元。同系列 6 月底在深圳发布时是 Lite、Pro、Ultra 三档,11.98 万到 99 万。
主打情感陪伴与对话交互,不是家务。展台前排队的人算的是另一笔账:十六万九千八,买回去能干什么。
工业侧按节拍算,一个工位一小时出多少件;消费侧按关系算,一个人愿意为「有人应声」付多少。同一个词底下是两种生意。
GDPx 把「答对题」换成「交得出资深审阅者认可的文件」,通过率立刻从七八十掉到 12%。优必选把「能干活」换成「能陪」,价格立刻从按台报价变成按情感定价。两件事都不是能力退步,是判据换了。
判据一换,之前所有漂亮的数字就自动失效。这不算坏消息——它说明这一行终于开始用收货方的尺子量自己。坏消息是,那把尺子目前只量到了一格。
04 / EMBODIED — 两则
一个工位
跑满八小时
8 小时不是续航指标,是排班指标——问的是能不能顶一个人的班。
11 月 3 日,乌镇。小米披露了人形机器人在汽车工厂的最新进展:在中控台侧盖板排序工站,机器人首次挑战 8 小时作业,满足该工站全天生产需求,作业过程中能自主纠偏,并与产线系统做系统级协同。
措辞是「初步完成产线级作业能力验证」。这句比 8 小时更值得读——它说的不是单次时长,是这个工位可以按正常排班用了。
把时间线拉出来,8 小时的重量才清楚。今年 3 月第一次进厂,在自攻螺母上件工站连续 3 小时,双侧安装成功率 90.2%,满足 76 秒节拍。7 月,同一工站成功率到 98%,同时新增中控台侧盖板排序和料箱折叠回收两个工站——盖板是柔性工件,尺寸大、形状不规则,和拧螺母不是一个量级。
同一天披露的还有家庭侧。具身基座模型 Xiaomi-Robotics-1 基于 10 万小时真实操作数据预训练,在小米青年公寓试运营:连续 30 分钟以上、覆盖 3 个房间、50 多项任务,从工具准备、沙发与桌面整理、垃圾清理到全屋复检。配套的大小脑混合 VLA,官方口径是消费级显卡可做到 80 毫秒推理。
两件事量的不是同一个东西:工厂量「同一件事重复多久不出错」,公寓量「不同的事连着做多久不崩」。前者单位是小时,后者是任务数。
三小时
3 月,自攻螺母上件,成功率 90.2%,卡在 76 秒节拍上。
九十八
7 月,同工站 98%,并新增两个柔性件工站。
八小时
11 月,侧盖板排序,整班,含自主纠偏与产线协同。
这三个数字的次序不能颠倒。先把单一动作做稳,再把成功率推上去、换更难的材料,最后才拉时长。反过来做——先拉时长再补精度——产线不会给这个机会。
同一天在乌镇,另一台机器给出的单位是「一条通道」。
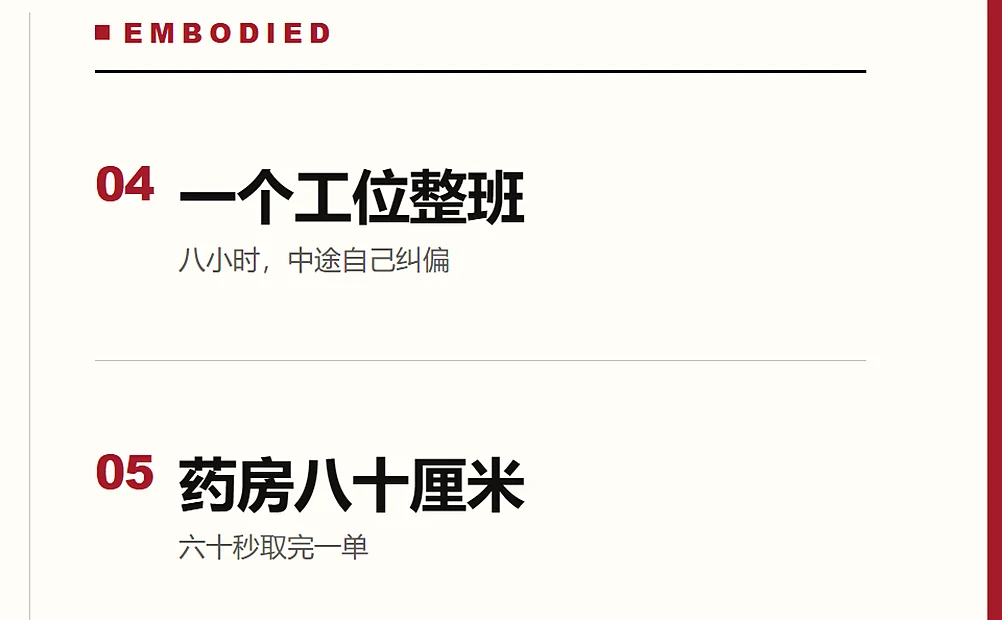
蚂蚁灵波与国大药房在互联网之光博览会搭了一个 1:1 的药房:药品密集摆放,通道只有 80 厘米宽。机器人在里面自主完成接单、识别药品、分拣、交付的全流程,取一次药不超过 60 秒。
关键的一句是「无需改造商品陈列或门店布局」。这句话决定了它是产品还是项目——存量门店不动货架、不动动线,机器去适应环境,才可能批量复制。目前这套方案已在上海国大药房多家门店常态化运营;现场举的例子是深夜两三点,你在外卖平台下单,拣药的可能是它。
背后的通用大脑适配 20 多个品牌、不同构型的机器人;跨本体基座模型开源后,LingBot 系列累计 3 万多个 Star、800 多次引用。首届具身大模型挑战赛初赛,来了 13 个国家、648 家高校与企业、1,855 支队伍。
80 厘米是这一格的全部。它不是技术指标的炫耀,是选址条件:国内多数社区药房的通道就在这个宽度附近。机器人能不能进去,决定了这个场景有没有市场。
05 / POSITIONS — 四把尺
四个数字
四种格子
美元 / 百万 token
自建模型的综合成本,账单剩一成。
个 / 系统调用
375 个里完整实现的数量。能开机,不等于能替代。
% / 交付
206 项真实任务,最强只过 12%。
小时 / 整班
一个工位,不是一座工厂。
CHAIN — 五环
从「一格」
到「全图」
五件事串成一条链,每一环都划小一点范围,也把结论钉得更死一点。
换计价
从每人每月 300 美元,到 56 张卡。Token 从配额变成水电。
换关卡
13.9 万行只对应 82 个系统调用。能启动不是能替代。
换判据
从答对题,到交出一份文件。通过率 12%。
换时长
从 3 小时演示到 8 小时整班。只在一个工位。
换宽度
80 厘米。机器人适应门店,不是门店适应机器人。
链上最容易被跳过的是第一环。它不改模型能力,只改计价方式,但它决定了后面四环能不能被验证——只有单位成本降下来,才有人愿意让 agent 在一个格子里反复试错。
BOUNDARIES — 三条边界
三个数字
还不能当定论
自体口径
Revolut 的 60% 与 70% 是公司内部统计,没有第三方复核;56 张卡的资本开支与折旧,也没有摊进 0.30 美元那个单价里。
只在仿真
Ginux 只在 QEMU 里跑过,没有物理硬件、没有 GPU、没有独立安全审计;12.9 秒对 42.6 秒不是同条件比较。
未点名
GDPx 原文没有点名 12% 是哪个模型,12.0 与 10.9 是转述汇总;小米的 8 小时是单工站单次披露,未公布连续天数与故障率。
CLOSING — 本期结论
这一期五件事,各自只在一格里成立。
两千人的日常编码、十三万九千行里的 82 个调用、206 项任务里的 12%、一个工位上的 8 小时、一条 80 厘米的通道。
这些数字都不假。但它们成立的半径,比标题小一圈。
而且那个半径不是模型能力画的,是验收画的——你能验多大,格子就有多大。Revolut 只把日常编码搬过去,因为只有那部分能被内部指标验证;Kurtzer 只敢说能开机,因为再往后没有可执行的关卡;小米只在一个工站跑满班,因为那是它唯一敢按排班用的地方。
所以真正该问的不是「它能不能」,是「这个结论覆盖到哪一格为止」。谁划格子,谁就掌握下一轮的解释权。
云上有品 · AI 动态 · NO.017