2026.11.08 · AI CODING × 3 / 具身智能 × 2
撤掉老师
让它自己学
NO MORE TEACHING
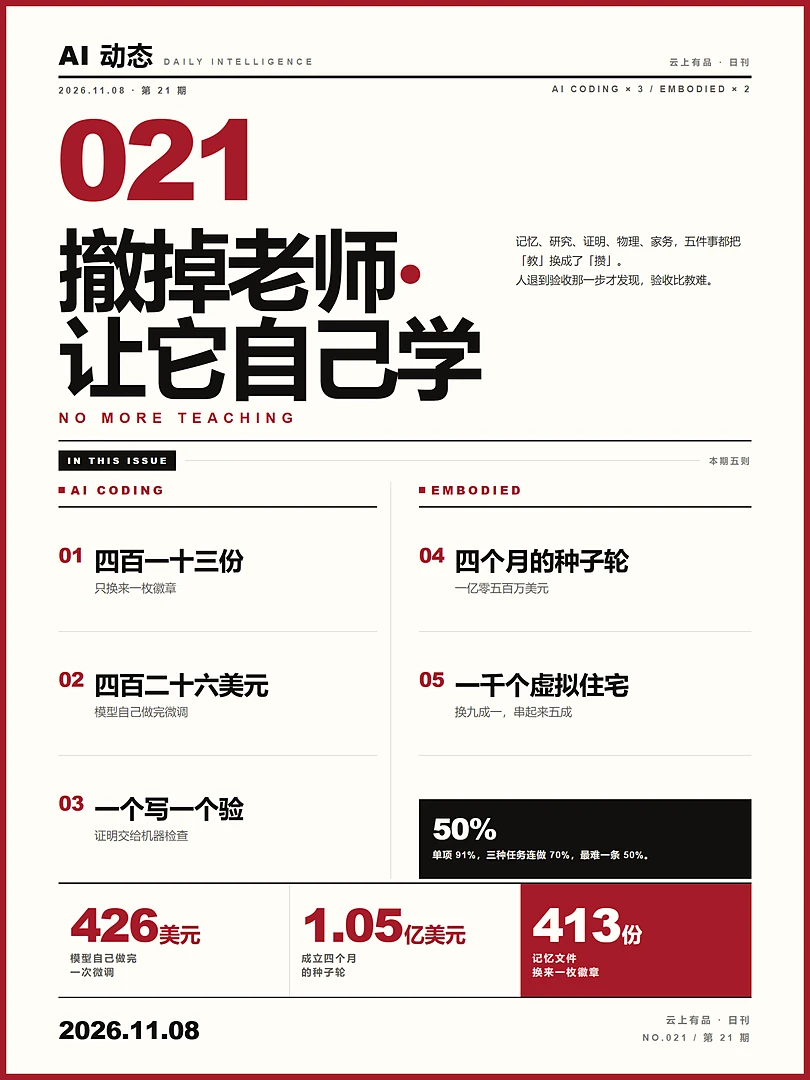
五件事都把「教」换成了「攒」:攒笔记、攒实验、攒证明、攒粒子轨迹、攒虚拟住宅。
人退到验收那一步才发现,验收比教难。
「记忆,是对未来的一次预测。」
01 / AI CODING — 三则
四百一十三份笔记
不如九份
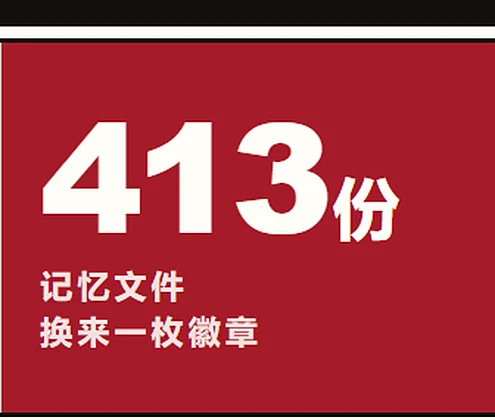
一个模型在游戏里写了 97.8 万字笔记,拿到一枚徽章;另一个只写 4.3 万字,拿到四枚。
11 月 6 日,Anthropic 工程团队发出一篇长文,第一次把「agent 的记忆」从产品话术里拆出来量。定义收得很窄:只算跨会话保留、能当上下文读回来的知识。权重更新不算,单次对话里的学习不算,compaction 也不算——那只是把旧轮次压成摘要。
评测用的是 Continual Learning Bench 1.0 的数据库题。每道题开一个新会话,两次之间唯一的线,就是那个记忆文件夹。Opus 5 从 0.564 抬到 0.828,Opus 5.5 从 0.655 到 0.838。Sonnet 4.6 只从 0.330 挪到 0.364。
最反直觉的是「只记失败」这条规则。听起来很合理,实测让 Opus 5 倒扣 0.234,Opus 4.7 倒扣 0.150。规则本身成了干扰:模型开始把注意力花在判断「刚才这算不算失败」,而不是判断什么会再来一次。
Pokémon Red 跑到约一万步,差距摊开了。Sonnet 3.7 建了 413 个文件、225 个文件夹、97.8 万字符,一枚徽章;Fable 5 只写 9 个文件、两个文件夹加一个 global.md,4.3 万字符,四枚徽章。前者记的都是屏幕上此刻看得见的东西,游戏状态一变,整座档案就过期。
真正让记忆能自我修正的是 dreaming:闲时重读自己的会话日志,改错、写笔记、建 wiki、决定下次预载什么。它不动输入存储,结果写到另一个输出存储——一次做坏的整理,不会毁掉原始记忆。
合同任务里,几个 agent 同时往一页 provisions.md 上写,57 条评分事实只剩 41 条;改成每份合同独立成页、条款逐字引用,57 条全在。
这一则的四条线
COMPARISON — 同一套记忆,同一个考场
强模型拿走大部分
弱模型几乎没动
四条都是同一套记忆、同一套题、每题新开会话。差别只有一个:模型会不会自己判断「哪条值得记下来」。数据由厂商自跑,部分任务为单次运行,引用请回到原文。
SIGNAL — 另外两则
一个先写评分器
一个先写证明
INKLING 2 SMALL
384 个专家里选 8 个,48 层,上下文 100 万。8.4 万亿 token 预训练只用 68 小时,GB300 NVL72,原生四位浮点。
1,075 步、超过 1,700 万次 rollout、2,048 张卡。训练集里有几十万条长程编码任务,包括让它自己去后训练网络、优化 kernel。
让它微调 Qwen3.5-4B 做时序预测:自己分析任务、自己写评估器、自己试配方、自己 debug。账单 426 美元,分数翻倍。
先在自家云上开放,外部安全测试与红队做完,下周按 Apache 2.0 放权重。定价每百万输入 0.30 美元、输出 1 美元。
DEEPMIND · RSA
11 月 6 日公布:一个生成、一个验证,代数在 Lean 4 里机器验算。人类密码学家定方向、做复核。
只控制 32 字节摘要时,新算法理论上比此前最好方法快约 1,600 倍。这一步没有端到端跑过。
沙箱里复现学界已解的一个 1024 位样本:首次求根 391 CPU 核年,比原计算少 3.5 倍,算力不到直接分解的千分之一。
一次预计算约等于一次分解的成本,之后每个 1024 位整数约为常规成本的 1/58。只影响已退役的 1024 位,2048 位不受影响。
Inkling 值得看的不是分数,是它先写评分器再动手。它被几十万条长程编码任务训练过,其中一类叫 autoresearch:给一个模糊目标,自己定义什么叫「更好」,然后反复试到收敛。研究的单价第一次被写出来——4.5 小时,426 美元。
DeepMind 那两篇给的是另一种证据。1,600 倍在论文的理论估计里,3.5 倍才是跑出来的。真正变短的是一句老问题:一个加密假设还能撑多久。答案从「几十年」变成了「几周」。
02 / EMBODIED — 两则
不造本体
先造物理直觉
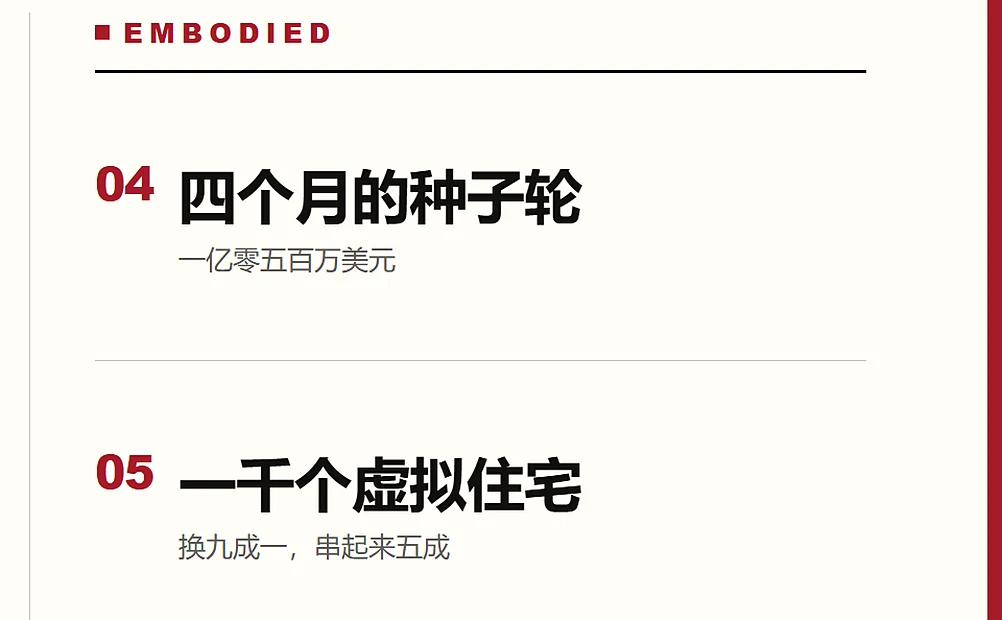
一家成立四个月的公司拿到 1.05 亿美元种子轮,十家机构同时进场。它卖的不是机器人。
11 月 5 日,北京物原科技在 X 上公开品牌 TensorWorld,同时披露这笔融资,约 7.05 亿元。凯辉、红杉中国、蚂蚁、和玉、美团、IDG、鼎晖 VGC、星连、达晨、蔚来资本十家一起投。
公司 7 月 1 日才注册。创始人吴海旭 1998 年生,清华软件学院博士,师从龙明盛,2022 年拿清华特等奖学金;之后在 MIT CSAIL 做博士后,跟 Wojciech Matusik 做计算设计与制造。代表工作 GeoPT 用合成动力学把静态几何「升维」到动态空间,拿了 ICLR 2026 科学基础模型研讨会最佳论文,物原现在的路线就接在这条线上。
它要换掉的是工业仿真的三笔账:划一个复杂装配体的网格要几周,求解要小时到天,湍流模型选哪个靠老师傅的经验。物理场直接学,1 亿网格点的解可以秒级出。
卡点一直在标签。真实的应力、流场、温度只能靠实验或高保真仿真拿,测一次贵、覆盖窄、样本少。GeoPT 的办法是合成动力学:给公开三维资产配上大量粒子,按简化规则演化轨迹,约 130 万次模拟就是训练集,不需要一个物理标签。代价是算力,收益是标签免费。
不给方程
只给观测与粒子轨迹。模型自己归纳「东西应该怎么动」,而不是把方程写进代码。
合成预训练
约 130 万次合成动力学模拟当训练集。同精度下,标注数据需求最多省 60%。
少量真机微调
迁到陌生任务与环境。真实物理标签买不到,只能用最少的量补最后一段。
这 7 亿元买的是方法积累和四个人:周俊昇是 Uni3D 一作,叶葳蕤是 EfficientZero 一作,郑文做过亿级用户产品、建过十万卡级算力。缺口同样清楚——物理世界模型目前没有公认的评测基准,所有数字都还是自家任务上的。
CASE — 苹果的一千个家
没造机器人
先造了一千个家
01数据
1,000 个程序生成的家庭场景,合成约 300 小时配对视频、语言与动作,共 162,698 个片段。250 张 H100 跑约 48 小时,把主训练数据攒出来。
02三层
视觉语言模型编排(Qwen3.6-35B-A3B,在机器人上的 Mac mini 本地跑,每 2 秒一次)→ 3Hz 动作生成(Qwen3.5-2B 冻结编码器加扩散解码器,规划未来 5 秒)→ 50Hz 跟踪器。
03成绩
部署在宇树 G1 上。6 个没扫描、没建图的真实房间,360 次单项任务,平均成功率 91%。
04折价
同一环境里三种组合任务各测 10 次,平均 70%;「俯身过障碍—走向目标—推箱子」只有 50%。新任务仍要人写提示词、设关键帧;只有视觉、没有触觉,物体一离开视野就会掉。
论文 11 月 4 日提交 arXiv,数据生成、训练与部署代码一并开源。这套管线最值钱的地方不是 91%:它把一个「家」的成本压到了 48 小时机时,而且可以批量重跑。
NUMBERS — 四个数字
攒下来的是什么
份笔记
给屏幕上每一格都建了档。状态一变,整座档案过期。
份笔记
只留规则与陷阱。四枚徽章,比四百多份更管用。
美元
一次自主微调的账单。研究这件慢活,开始有单价。
一条组合题
单项能到 91%,串起来只剩一半。验收在这里。
CHAIN — 五环
从「教」到「攒」
再到「验」
这五条线串在同一条链上:每一环都在把成本往下压,只有最后一环在往上涨,还看不到天花板。
判断
先判断哪条会再出现,再决定记不记。全存等于没存。
自评
先写评分器,再动手。模糊目标被拆成可测的实验。
互证
一个生成,一个验证,最后交给机器检查代数。
合成
从粒子轨迹与虚拟住宅里攒经验,绕开买不到的标签。
验收
单项 91%,串成任务 70%。多一种组合,就多一套题。
链上最脆的是第 5 环。前四环都能靠算力换成本,只有验收换不了——它要求所有人先同意一把尺子。
BOUNDARIES — 三条边界
读完要记住
三件事
口径
记忆与分数的评测由厂商自跑,部分为单次运行;1,600 倍是理论估计,不是端到端结果。所有数字都要回到原文再引。
时间
物原融资 11 月 5 日公开;苹果论文 11 月 4 日提交;Inkling 2 Small 11 月 5 日发布。三家中文报道都晚一到两天,别当成当日新闻。
缺口
物理世界模型没有公认基准;HALO 只有视觉、没有触觉。这两处空白,比任何分数都更值得盯。
CLOSING — 本期结论
这一期五件事,都在把「教」换成「攒」。
模型开始自己判断什么值得记,自己定义什么叫更好,自己生成证明,自己从粒子轨迹里学物理,自己在一千个虚拟住宅里攒经验。人的位置往后退了一格。
退到的那一格叫验收。而验收恰恰最不容易自动化——它要求先有人同意一把尺子。
苹果那份成绩单写得很老实:单项 91%,三种任务连做 70%,最难的一条 50%。同一台机器人,同一批技能,只是换了个考法。
所以「让它自己学」之后,真正要解决的不是它学得够不够快,是我们有没有一把对得上账的尺子。
云上有品 · AI 动态 · NO.021