2026.11.12 · AI CODING × 3 / 具身智能 × 2
证明可查
分数免谈
SHOW YOUR WORK
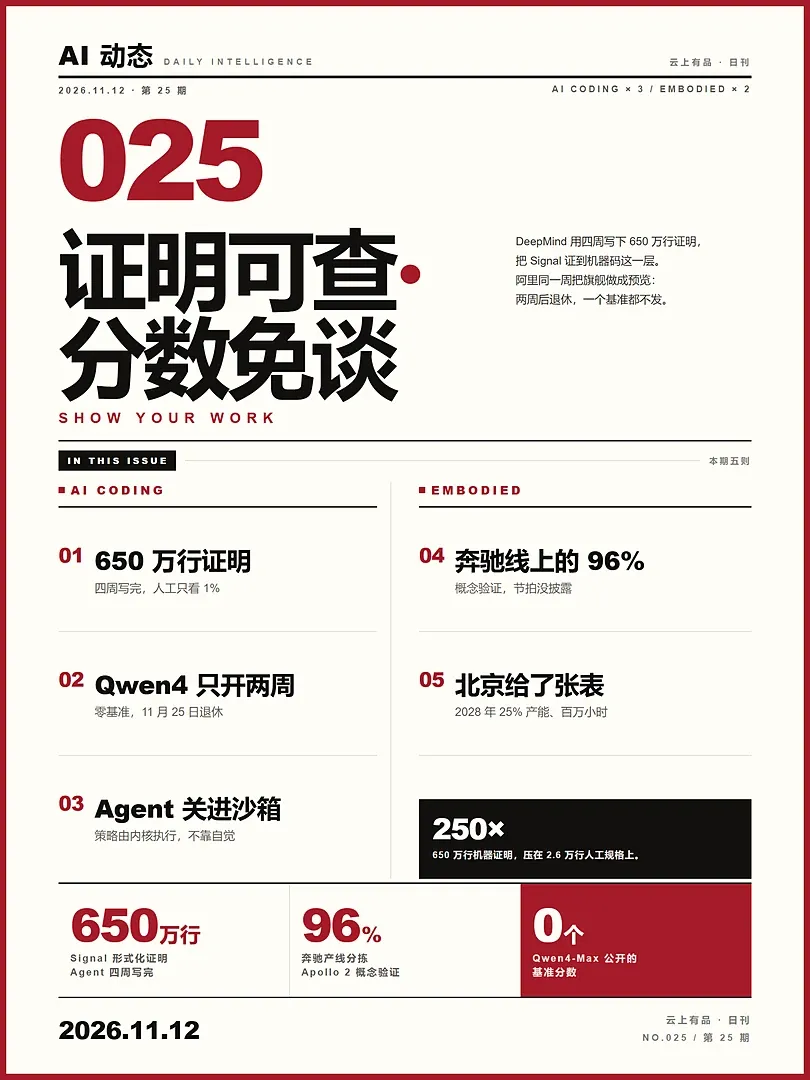
DeepMind 用四周、650 万行 Lean 证明,把 Signal 证到编译后的机器码,人工只复核 1%。
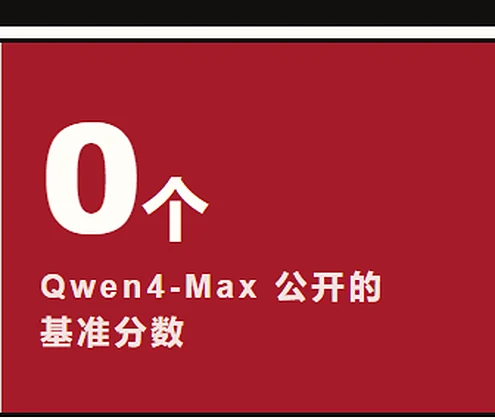
同一周,阿里把 Qwen4-Max 做成两周就退休的预览,一个基准都没发。
「能被人查的东西,才叫交付。」
01 / AI CODING — 三则
四周写完
证到机器码这一层
AI 会写代码,早就不是新闻。这一周的新东西是:它开始证明自己写的代码是对的。
11 月 10 日,DeepMind 公布 AlphaProof Code。它不生成代码,它验证代码——而且不看设计文档,直接看编译之后跑在设备上的 AArch64 机器码。
分工是三段。人先把 Signal 的安全目标写成 Lean 规格,逐条审核;Gemini Carbon 驱动的 agent 写证明;Lean 的内核逐条判,判不过就打回。判完 agent 再自查一遍,把拿不准的地方标出来——最后只有约 1% 的代码库需要人再看一眼。
规模是 650 万行 Lean 证明,压在 2.6 万行可信规格与处理器语义上。整个验证在 2026 年 10 月做完,用了四周。DeepMind 自己说,这类工作过去要专家团队做好几年。
覆盖的是 PQXDH 握手与 Triple Ratchet:设备短暂失陷之前与之后,消息是否还受保护。这两类性质难,是因为它要求证明跨过「设计」与「实现」之间那条缝。真实漏洞通常就藏在缝里——协议在纸面上是安全的,跑在机器上未必。
更值钱的是反例测试。团队把两个真实存在过、后来已修复的漏洞重新植进隔离版本的 Signal 代码,系统两次都生成了机器检查通过的「不安全」证明。能证对,也能证错——这才叫验证工具。只会说「通过」的,那是嘴。
边界要说清。证明只能保证代码满足已经写出来的属性;没写进规格的东西,证了也不算数。规格是人写的,所以人仍然站在最上游。DeepMind 说这是研究项目,不是产品,也没有第三方审计;Axios 说他们打算把这套东西接进 AI coding agent,以及 Project Zero、CodeMender 那条线。
这一则的四条线
SIGNAL — 另外两则
一个把成绩单撕了
一个把笼子交出去
QWEN4-MAX · 两周的窗口
上下文 100 万 token,最大输出 393,216。变化在细节里:从这代起 max_tokens 同时覆盖思考与答案,按答案长度设的限额会把输出截断。
只走 Token Plan 订阅,没有按量付费。新用户每月 3 美元起,只在新加坡区;个人版限定在 Claude Code、Cursor、Qwen Code、Qoder 这类交互式工具里用,禁止脚本、后端与批处理。
预览期信用点按标准价 20% 计,22 点到 8 点按 8%。11 月 25 日 24:00 结束,模型 ID 一并退休。
没有基准、没有参数量、没有模型卡、没有正式 API 价。Artificial Analysis 当天榜上没有 Qwen4 条目。官方只说在世界知识、代码生成、长任务持续性上超过 Qwen3.8,而 3.8-Max 的 86.6、67.7、93.0 是旧模型的数,不能当证据。
OPENSHELL · 交出去的那只笼子
11 月 10 日 KubeCon 上,NVIDIA 把 OpenShell 捐给 CNCF 做 Sandbox 项目,Apache 2.0。
沙箱独立、非特权、内核级系统调用过滤;策略证明器用形式化验证判策略有没有越界;网关管认证与凭据;监督器在沙箱外逐请求判策略,只在允许处注入凭据,全部留审计。
支持 Claude Code、Codex、GitHub Copilot CLI、OpenCode 等。官方称数百家组织在用,不到一年数万次贡献。
与 Google 主导的 Agent Substrate 做集成,agent 空闲时释放算力;同批开源的 Snapshot 让 Crusoe 上的模型就绪从约 8 分钟降到 31 秒,厂商口径。
这两件事是同一招用在两个位置。AlphaProof 证明「这段代码满足这条规格」,OpenShell 的策略证明器证明「这条策略没有多给权限」。一个管交付前,一个管运行时。
对做交付的人,验收标准要换。过去验收问「跑通了没有」,现在可以问「拿什么证明它跑对了」。规格谁写、谁审、谁签字,会比模型选型更靠前。
02 / EMBODIED — 两则
九十六个百分点
和一个没给的节拍
这是本期最硬的一个数,也是最不全的一个数。
11 月 10 日,DeepMind 发布 Gemini Robotics 2.5,称其为自家最强的视觉-语言-动作模型。评估覆盖 200 多项真实任务:用食品夹分餐、给礼盒系蝴蝶结、液体移液。共同点是工具、可变形物体、易碎品——没有一项是在抓方块。
相对上一代,成功率提高 30% 到 100%,看任务;速度提高 20% 到 30%。这些是实验室里的数。
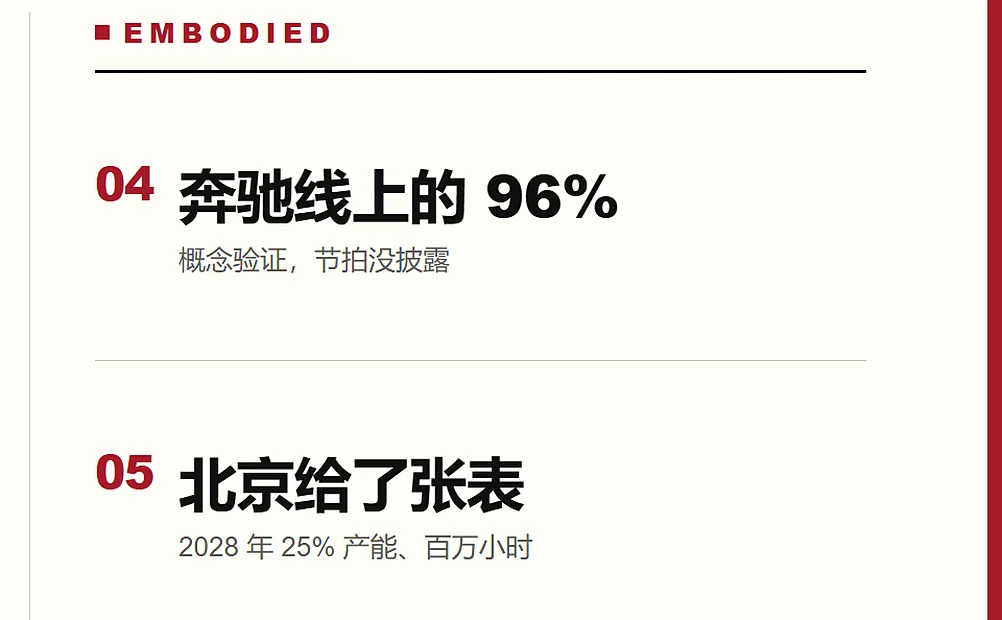
产线那一侧才是重点。DeepMind 与 Apptronik、梅赛德斯-奔驰合作,在匈牙利凯奇凯梅特与德国辛德尔芬根的在用产线上做概念验证:Apollo 2 从散装料箱里按产线顺序拣金属支架,放进对应的排序容器。这道工序叫 kitting,汽车厂里最琐碎、也最不能错的一道。
双模型分工:Gemini Robotics ER 跟踪整个流程,2.5 控制手臂与手部。这个任务的成功率是 96%。Apptronik 的 CEO 说,几周后训练就有明显提升,迁到真实产线后性能下降很小。
然后是缺口。任务时长、试验次数、产线节拍,一个都没披露。96% 是一个点,不是一个区间;它证明这套模型能做对,不证明它能连着做八个钟头。
实验室
200 多项任务,成功率较基线提高 30% 到 100%,速度提高 20% 到 30%。
产线
奔驰两座工厂做 kitting,Apollo 2 自主完成,96%。
缺口
节拍、时长、试验次数都没给,仍是概念验证。
安全侧同步开源了 ASIMOV-Jailbreak:数百条伪装成正常请求的提示词,覆盖数十类场景,用来测针对机器人的越狱。官方给的抗越狱率 99.5% 属于 Gemini 4 Argon,上一代 ER 2 是 82%——这组数字不属于 Robotics 2.5,引用时别接错。
POLICY — 第五则
一张能考核的表
写到了 2028 年
01整机
到 2028 年,培育不少于 5 家国际一流、10 家国内领先的人形机器人整机企业;具身模型、本体与关键技术都要到国际一流。
02产能
京津冀区域整机产能占全国 25%,关键零部件配套率超过 60%。这两个数会进采购与补贴口径。
03数据
建成国家级具身智能数据基础设施:不少于 100 个真实场景,采集超过 100 万小时高质量数据。
04算力
新增具身智能专用算力集群,总规模超过 50,000 PFlops;技术路线不押单注,VLA、世界模型、强化学习并重。
文件把「大脑」和「小脑」分开写:大脑要理解物理约束、识别人的动作与表情这类非语言指令;小脑要实时推理、跨本体迁移、自学习进化、快节拍、超精密操作。这是本期唯一一份能逐条打勾的清单——也正因如此,它是五条里唯一不靠形容词的那条。
NUMBERS — 四个数
四个数字
四把尺子
证明完成
650 万行证明,压 2.6 万行规格。
需要人看
其余由 Lean 内核逐条机器检查。
公开基准
Qwen4-Max 的参数、分数、价目,一样都没公开。
京津冀产能
2028 年目标,配套率超 60%。
CHAIN — 五环
从「生成」
到「证明」
这一期的五条线索串在一条链上:代码越来越便宜,判断对错越来越贵。
生成
写代码这一环已经便宜到可以批量产出,价值不在这一环。
规格
什么叫「对」,必须由人写成机器能读的句子。2.6 万行,是本期最贵的手写件。
证明
agent 写 650 万行,内核逐条判。留给人的那 1%,正是杠杆所在。
边界
同一招用到运行时:策略也做形式化验证,把 agent 关进内核级沙箱。
考核
当证明和边界都能查,采购只剩一件事:把要求写成可数指标。
链上最贵的是第 2 环。2.6 万行规格是人写的,650 万行证明是机器写的,比例 250 倍;但决定对错的,仍然是那 2.6 万行规格。
BOUNDARIES — 三条边界
读完要记住
三件事
口径
650 万行:DeepMind 博客写「超过 600 万」,Axios 写「超过 300 万」,两家没对齐。96% 是概念验证里的单任务成功率,不是产线均值。「零基准」指官方没公布、第三方当天也没收录,不等于它能力差。
时间
验证在 10 月完成、11 月 10 日公布;Qwen4-Max 预览从 11 月 11 日开到 11 月 25 日;OpenShell 11 月 10 日在 KubeCon 宣布;Gemini Robotics 2.5 当地 11 月 10 日;北京方案 11 月 11 日印发。
缺口
Signal 的证明没有独立审计;Gemini Robotics 没给节拍、时长、试验次数;北京方案是目标不是订单;Qwen4-Max 是预览,11 月 25 日之后模型 ID 一并作废。
CLOSING — 本期结论
这一周,行业开始给交付物分级。
DeepMind 交的是证明:650 万行 Lean,人工只留 1% 复核。
阿里交的是体验券:两周、零基准、夜间八分之一的价,到期模型 ID 作废。
奔驰产线那个 96% 是真的,但只是一个点:没有节拍、时长、试验次数。
北京交的是另一套东西:25%、60%、100 万小时、5 万 PFlops,写在文件里,可以被数、被查。
所以这一期只留一句:能被别人查的,才叫交付;只能被别人试的,那叫样品。
云上有品 · AI 动态 · NO.025