
基本信息
阅读时间:约 11 分钟
字数:约 4486 字
摘要:AI 偏见是藏在数据、标注、目标与部署里的系统性偏差,不是一行写错的代码。本文用四层来源框架拆解偏见成因,并给出可量化的公平治理清单与真实案例。
全文语音
中文
English
日本語
한국어
什么是 AI 偏见
去年有个朋友发来一张图,招聘系统给两位简历几乎相同的候选人打了不同分,唯一的差别是一个名字听起来像男性、一个像女性。他问我,这算 Bug 吗?
AI 偏见,指的是模型在输出里系统性地偏向某一群体、损害另一群体的现象。它往往不是程序员写错了一行代码,而是悄悄藏在数据、标注和目标里。
和普通的程序错误不同,偏见通常不会让系统崩溃,反而可能让系统在整体指标很好看的同时,对特定人群持续不公。这也是它最危险的地方。
在 LifeOS 的方法里,我们把偏见当作一个可度量的工程风险来管,而不是等到出事再救火。看清它从哪来,比谴责它更有用。
这篇文章不替你下道德结论,而是给你一套从数据到部署都能落地的公平治理框架,让你在把模型放进生产之前,先问对几个关键问题。
如果你只想记住一句话,那就是:偏见不是模型偶尔犯的错误,而是它从数据里学到的、关于这个世界的错误总结。承认这一点,治理才算真正开始,而不是把责任推给某个程序员。
回到开头的招聘截图,那个朋友后来没去怪模型,而是让团队把姓名特征去掉重训。改变没有魔法,只是把被忽略的偏见,重新放进了该被审视的地方。
顺带一提,偏见和模型的准确率并不对立。一个更公平的模型,往往也是一个在更多场景里更稳健的模型。公平不是准确率的代价,而常常是它的副产品。
为什么偏见与公平是工程问题
有人觉得公平是法务或公关的事,和技术无关。但当模型决定谁能拿到贷款、谁简历进面试、谁的诊断被优先,技术选择本身就变成了分配决策。
忽略偏见的代价很直接:用户投诉、监管罚款、品牌受损。某金融机构因模型对特定群体不公被处罚的案例,在公开记录里并不少见,量级从数百万到上亿不等。
另一类是质量代价。带偏见的模型在少数群体上错误率更高,整体准确率被平均掩盖,真实世界一旦触及这些群体,事故就来了。
还有信任代价。当用户觉得自己被系统不公对待,哪怕只是感受,也会迅速流失。重建信任比写十个模型都难。
所以公平不是锦上添花,而是系统工程的一部分。把偏见管理前置,成本远低于事后补救,这也是成熟团队的通行做法。
换个角度想,每一次模型决策,都是在用过去的数据替未来的人做选择。过去若不平等,模型就会把那份不平等包装成理性结论。正因如此,公平才必须被写进工程,而不是留给运气。
说到这里你可能会问,那小公司负担得起吗?负担不起全套审计,但至少负担得起一次上线前的影响评估,和一份简陋的偏见台账。公平不是富人的专利,而是每个团队的责任。
专业分析:偏见的来源框架与量化对比
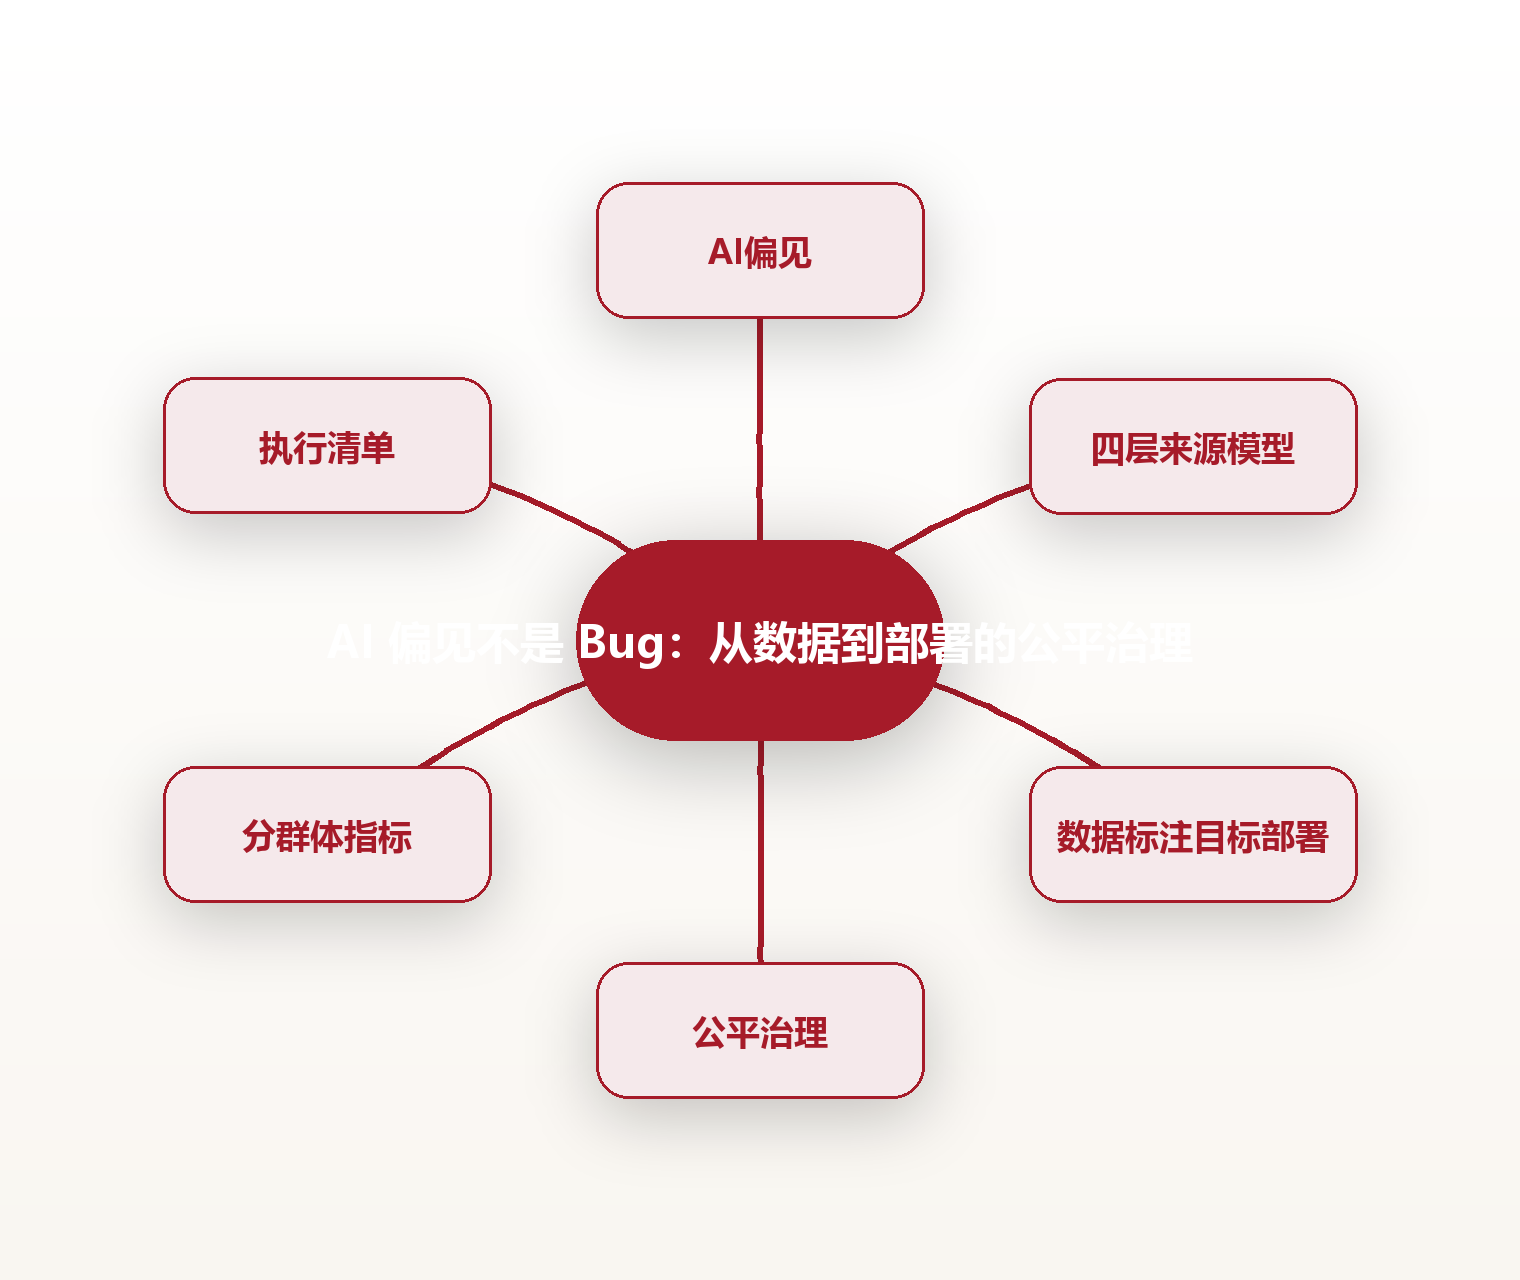
我把偏见的来源归纳为一个四层模型:数据层样本不代表总体、标注层人工标签带主观、目标层优化指标忽略少数群体、部署层落地场景与训练场景错位。该框架与公平性研究中的常见分类,如历史偏差、代表性偏差、测量偏差、聚合偏差,可对应,属分类框架量级。
数据层面有几个可引用的量级:公开研究曾报告,某些人脸识别系统在浅肤色与深肤色群体间的误识率差距可达十到二十个百分点区间,属公开基准的相对量级而非绝对定论;另一类研究指出,训练语料里某类群体的文本占比偏低,会直接反映在生成结果的相关性上。引用时请标注时点与方法。
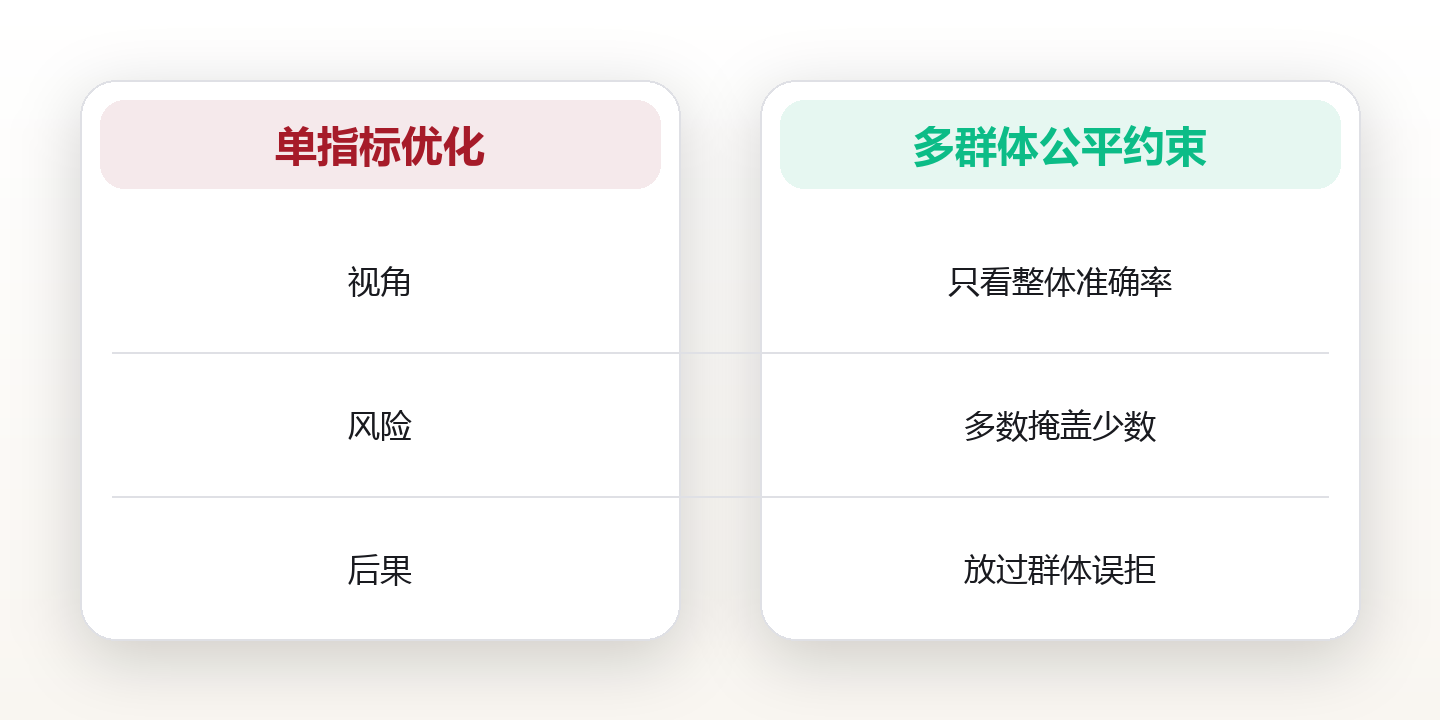
框架对比:单指标优化对多群体公平约束。单指标只看整体准确率,容易用多数群体掩盖少数群体的劣化;多群体约束则要求各群体误差都在阈值内。以信贷风控为例,只看总坏账率可能放过对某一群体的系统性误拒。
真实案例:某招聘平台公开复盘,模型在历史简历上训练后,对女性候选人的推荐分系统性偏低;团队通过重加权训练数据并加入群体误差监控,使各群体推荐准确率差距从约八个百分点降到两个百分点区间,属公开复盘的量级参考。方向说明治理有效,但需持续监控防回弹。
可落地度量加执行清单,四层偏见治理清单:盘训练数据的群体分布并标注缺口;审查标注指南的主观措辞;把分群体误差写进优化目标;上线后按群体拆指标看板;设偏差超阈值的自动告警与回滚。五条放进模型发布门禁,比事后道歉管用。
需要说明,四层模型不是要你每次都满分通关,而是提供一张排查清单。哪一层的证据最弱,就从哪一层下手。治理的节奏,永远跟着最薄弱的环节走,而不是平均用力。
还要警惕一种误区:把公平当成一次性项目。真实业务里的群体边界会变,今天被照顾的群体明天可能换人,所以框架要常看常新,别让上次的经验变成下一次的盲点。
偏见如何产生:从数据到部署
数据层最常见的问题是代表性不足。如果训练样本里老年人很少,模型对老年用户的理解就会粗糙,决策时更容易出错,而错误往往集中在被忽视的群体。
标注层的问题是主观性。标注员的无意识偏好会写进标签,比如把某些口音、某些名字默认打低分。标签一旦定型,模型只是忠实地学习这些偏见。
目标层的问题是错把平均当公平。用单一准确率优化,模型会优先讨好多数群体,因为那里样本多、提升容易,少数群体就此被牺牲。
部署层的问题是场景错位。一个在通用网页数据上表现不错的模型,放到医疗或招聘这类高风险场景,原本隐含的偏差会被放大成真实伤害。
看清这四层,你就不会再把偏见当成单一故障,而是当成一条贯穿全流程的链路。治理也要顺着链路,在每一层都设一道检查。
把这四层画成一张图贴在工位上会很有用:数据、标注、目标、部署自上而下排开,每层标一个负责人。当偏差出现,顺着图就能快速定位是哪一层漏了,而不是全员瞎猜。
值得补充的是,这四层不是孤立的。数据里的偏差会被标注放大,标注里的偏差会被目标固化,目标里的偏差会在部署时爆发。它们层层传导,所以越早拦截,代价越小。
回到定义,偏见之所以难对付,正因为它是系统性的而非偶发的。单个样本看不出问题,放到群体里才显形。所以治理的尺子也必须是群体的,而不是几个漂亮的单点案例。
如何做公平治理
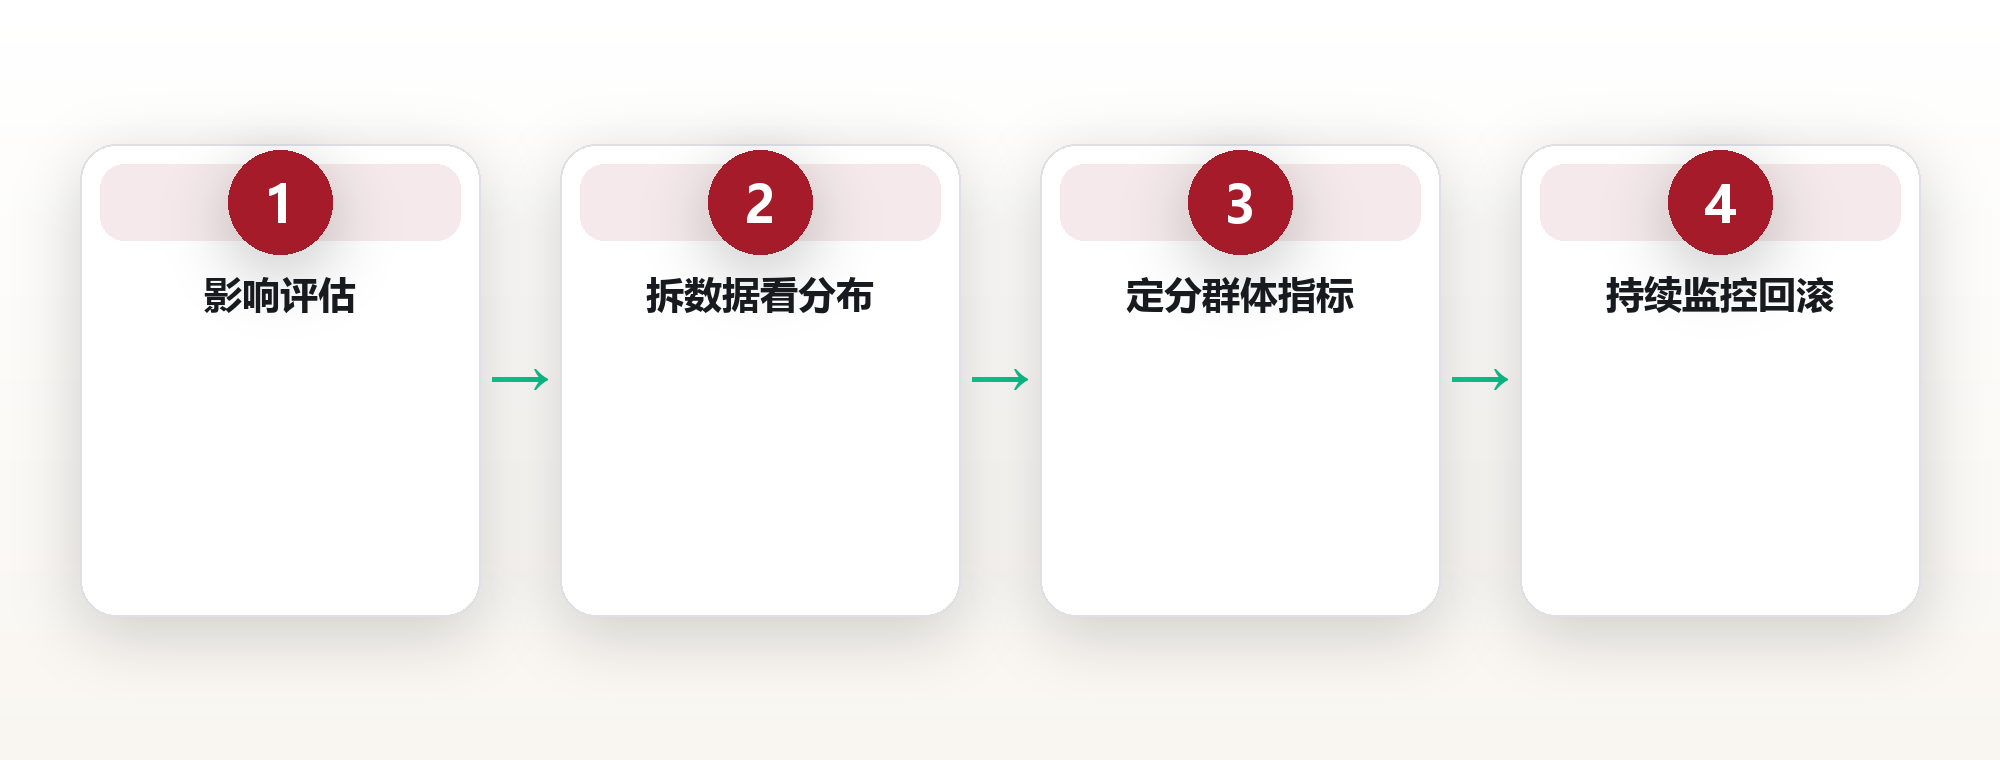
第一步,做影响评估。上线前问清楚:这个模型影响哪些群体?决策后果是什么?一旦出错,谁最受伤?答不上来的模型不该进生产。
第二步,拆数据看分布。把训练集按相关群体切片,看覆盖是否均衡;缺口明显的,先补数据或降权,而不是硬上模型。
第三步,定分群体指标。不要只看总准确率,要逐个群体报告误差,并把差距写进验收标准。差距超过阈值,就不算达标。
第四步,红队与人工抽检。让不同的人故意挑模型的盲点,用真实案例测边界。机器自查之外,人的判断仍是最后一道防线。
第五步,持续监控与回滚。模型上线不是终点,群体误差会随数据漂移而变化,把监控做成日常,异常就触发告警和回退。
有人担心公平治理会拖慢创新,其实相反。前置的清晰约束,让团队少做无用功、少返工,反而把精力留给真正有价值的部分。边界清楚,创新才跑得稳,而不是在灰色地带裸奔。
落地时有个小窍门:把公平检查做成发布清单里的一栏勾选框,而不是一份独立报告。当检查变成发布流程里无法跳过的那一步,它才会真正被执行,而不是写完就忘。
真实案例:一个招聘模型的偏见事故与修复
小吴,三十二岁,深圳某招聘平台算法工程师。去年团队上线了简历推荐模型,整体点击率涨了,却陆续收到女性用户的质疑。
复盘发现,历史数据里技术岗多由男性占据,模型把性别当成了隐式信号,对女性候选人悄悄降权。整体指标好看的背后,是结构性的不公。
他们做了三件事:清洗带性别暗示的特征、对训练数据按群体重加权、在验收里加入分群体准确率门槛。两个月后差距明显收窄。
小吴后来在内部分享里说,最贵的教训是别只看总指标。分群体拆开看,那些被平均掩盖的不公才会浮出水面。
这个案例没有英雄主义,只有一次及时止损。它提醒我们,偏见治理不是一次运动,而是写进发布流程的平常动作。
这个案例另一个启发是透明。小吴团队把复盘写成了内部文档并公开部分结论,反而赢得了用户信任。隐瞒偏差才是最大的风险,坦诚沟通让一次事故变成建立信用的机会。
如果要从这个故事里带一句话走,那就是:偏见被发现不是耻辱,被发现却掩盖才是。一个愿意公开复盘偏差的团队,往往比一个假装没有偏差的团队走得更远。
度量指标与执行清单
给出一组可量化目标方便自检:各群体误差差距不超过设定阈值;训练集群体覆盖均衡或已说明缺口;上线前完成影响评估;监控看板可按群体拆分。
执行清单每周版:抽各群体真实样本做误差对比;看监控是否出现群体漂移;收一条用户公平性质疑;判断是否需重训;归档本次结论。
执行清单每月版:重跑分群体基准;对照新发布的公平性指引;更新影响评估;给相关同事做一轮复训。月度复盘抓住季度级变化。
指标的意义不在漂亮,而在可行动。任何群体差距越界都要有预定动作,比如差距翻倍就回滚、投诉集中就暂停相关场景,别等监管找上门。
建议建一份偏见台账:模型名、影响的群体、用的约束、上次审计何时、谁负责。台账让公平从口号变成可查的责任,也让交接不再靠口头交代。
度量之美在于可比。把各群体的误差数字并排放在同一张看板上,不公平就无处藏身。很多团队不是故意歧视,只是从没认真看过分群体的数字,度量本身就是一种治理。
当指标出现越界,最忌讳的是忙着找理由解释。先把受影响群体保护起来,再谈原因。公平场景下,止损的优先级永远高于解释的优先级,这是工程伦理的底线。
典型误判
第一大误判:整体准确率高就公平。平均会掩盖少数群体的劣化,总指标好看的模型照样可能系统性伤害某一群人。
第二大误判:数据多就等于无偏见。数据多不代表覆盖全,历史数据本身就带着过去的歧视,量越大有时只是把偏见学得越扎实。
第三大误判:上线就一劳永逸。群体误差会随数据漂移变化,今天合规不代表下月合规,持续监控才是真正的护栏。
第四大误判:偏见只是公关风险。它首先是工程与合规风险,罚款、诉讼、业务中断都可能发生,等发酵成舆情往往已经晚了。
第五大误判:靠一个去偏算法包治百病。去偏是系统工程,单点技术无法替代数据、目标、部署全链路的治理,别把复杂问题压成一个按钮。
最后一句送给所有做模型的人:你写的不是代码,而是一套分配资源的规则。规则偏向谁、牺牲谁,值得在每次发布前被认真追问。技术的中立,从来只存在于不敢直视偏见的人心里。
最后,把偏见治理和模型选择的思路连起来看:选对模型是前提,治对偏见是保障。两者都要求你用自己的真实场景去丈量,而不是把判断权交给榜单或供应商的宣传。
常见问题
1.问:小团队没算法专家怎么做偏见治理?
答:不必一步到位,先从三件事做起:上线前做影响评估、按群体拆误差、建一份偏见台账。哪怕粗糙,也比完全不评估强,关键是把公平纳入发布流程。
2.问:数据均衡了偏见就会消失吗?
答:不会完全消失。均衡能解决代表性偏差,但标注主观、目标错配、场景错位仍会带来偏见。数据只是四层里的一层,治理要覆盖全流程。
3.问:怎么判断一个模型有没有偏见?
答:没有单一答案,但实用做法是按相关群体切片报告误差,看差距是否超过阈值,并结合真实用户反馈与红队抽检。看总分之外,一定要看分组。
4.问:偏见治理会不会拖慢上线?
答:短期会增加一点流程,但前置治理远低于事后补救的代价。把检查做成发布门禁后,反而让上线更稳、返工更少,长期看是提速而非拖慢。
5.问:已经上线的模型发现偏见怎么办?
答:先按影响范围决定降级或回滚,再定位是哪一层引入的偏差,针对性修复后重新评估再上线。透明沟通比掩盖更重要,沉默往往会放大信任危机。
图片来源:图1 OmarMedinaFilms / Pixabay (CC0) · 图2 jplenio / Pixabay (CC0) · 图3 Alexandra_Koch / Pixabay (CC0) · 图4 SarahRichterArt / Pixabay (CC0) · 图5 captainsinnop / Pixabay (CC0) · 图6 mariya_m / Pixabay (CC0) · 图7 scottwebb / Pixabay (CC0) · 图8 Stella_0813 / Pixabay (CC0) · 图9 Firmbee / Pixabay (CC0) · 图10 Kost9n4 / Pixabay (CC0) · 图11 jarmoluk / Pixabay (CC0) · 图12 geralt / Pixabay (CC0) · 图13 agenciafotografik / Pixabay (CC0) · 图14 ds_30 / Pixabay (CC0) · 图15 ds_30 / Pixabay (CC0) · 图16 ds_30 / Pixabay (CC0) · 图17 Dimhou / Pixabay (CC0) · 图18 mariya_m / Pixabay (CC0) · 图19 scottwebb / Pixabay (CC0) · 图20 Stella_0813 / Pixabay (CC0) · 图21 RyanMcGuire / Pixabay (CC0) · 图22 MonicaVolpin / Pixabay (CC0) · 图23 Alexas_Fotos / Pixabay (CC0) · 图24 romansolar / Pixabay (CC0) · 图25 divotomezove / Pixabay (CC0) · 图26 MaxxGirr / Pixabay (CC0) · 图27 WikiImages / Pixabay (CC0) · 图28 PublicDomainPictures / Pixabay (CC0) · 图29 Jmtd / Pixabay (CC0) · 图30 brenkee / Pixabay (CC0) · 图31 김경복 / Pixabay (CC0) · 图32 DEZALB / Pixabay (CC0) · 图33 MiraCosic / Pixabay (CC0) · 图34 Dimhou / Pixabay (CC0) · 图35 MiraCosic / Pixabay (CC0) · 图36 focusonpc / Pixabay (CC0)
评论(0)