
基本信息
阅读时间:约 13 分钟
字数:约 5128 字
摘要:数据不缺,缺的是流动。本文把集成链路拆成触发、取值、变换、投递四段,逐一说明每段的脆弱点与设计要点;对比托管型、自托管型、嵌入式三类连接器形态,以及轮询、事件推送、队列三种传输模式的取舍;给出四段可用度模型、五项可靠性指标与七步执行清单,并用一次订单通知链路改造的量级对照说明指标先行的价值。最后落到字段字典、重试与死信补偿、按需授权与数据驻留三项长期维护工作。
全文语音
中文
English
日本語
한국어
引言:为什么数据总卡在工具之间
多数人的工作流里,数据并不缺,缺的是流动。表单工具里躺着客户信息,表格里记着交付进度,聊天工具里散落着确认消息,而真正需要的动作——建档、通知、对账——往往还要人工搬运一遍。搬运本身不难,难的是它长期存在,而且没人知道哪天会漏掉一次。
集成平台解决的就是这件事:在两个系统之间搭一条自动通路,让数据按规则从 A 流向 B。听起来简单,实际落地时却常出现三类偏差:数据到了但字段对不上、任务跑了但没人知道失败、链路能用但没人说得清它依赖了什么。
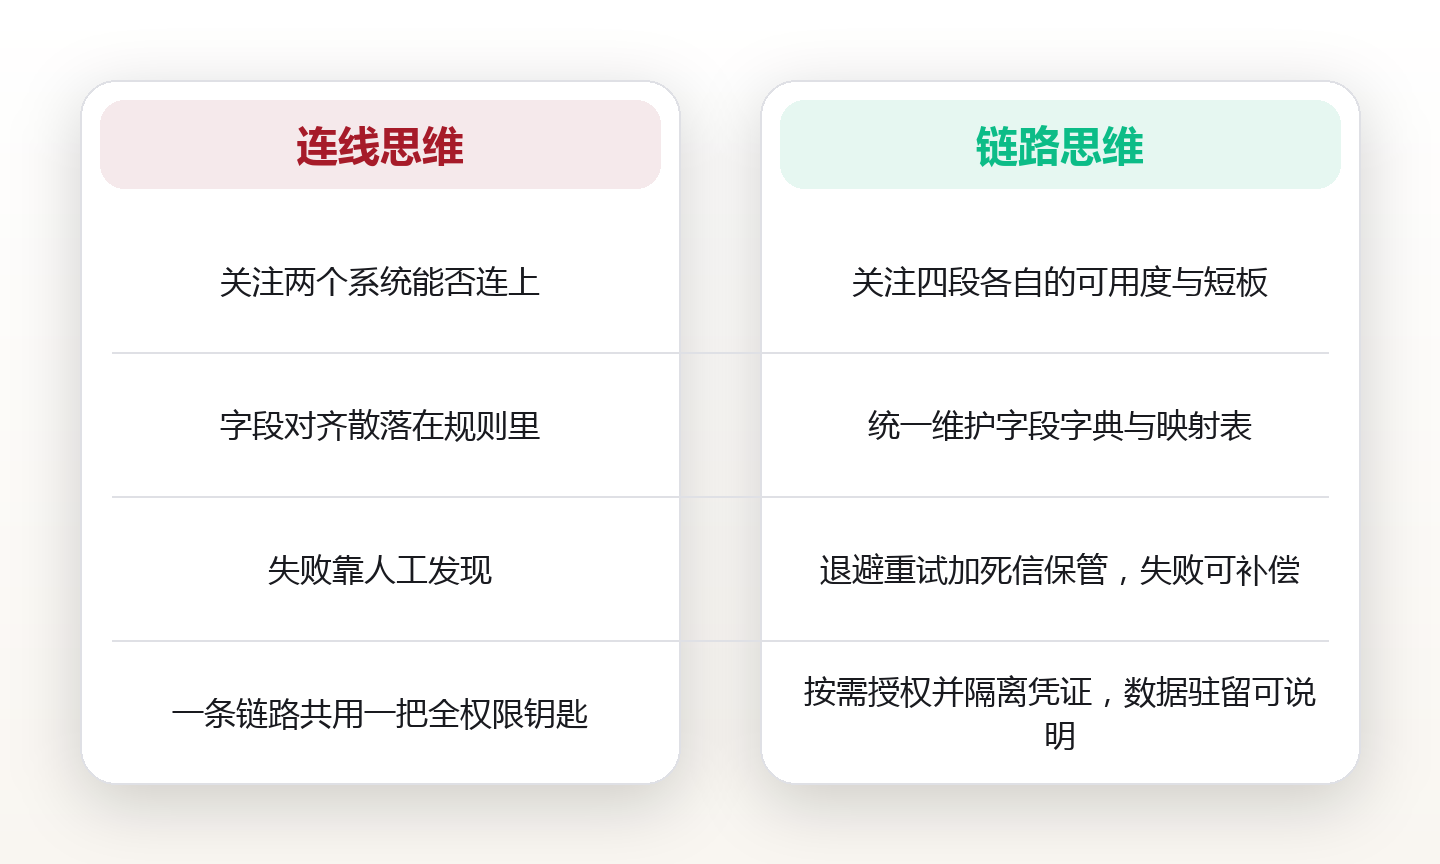
这三类偏差的共同根源,是把集成平台当成了一个「连线工具」,而不是一段需要维护的链路。连线只是开始,真正决定可用性的,是触发条件是否精确、取值是否完整、变换是否可逆、投递是否可验证。
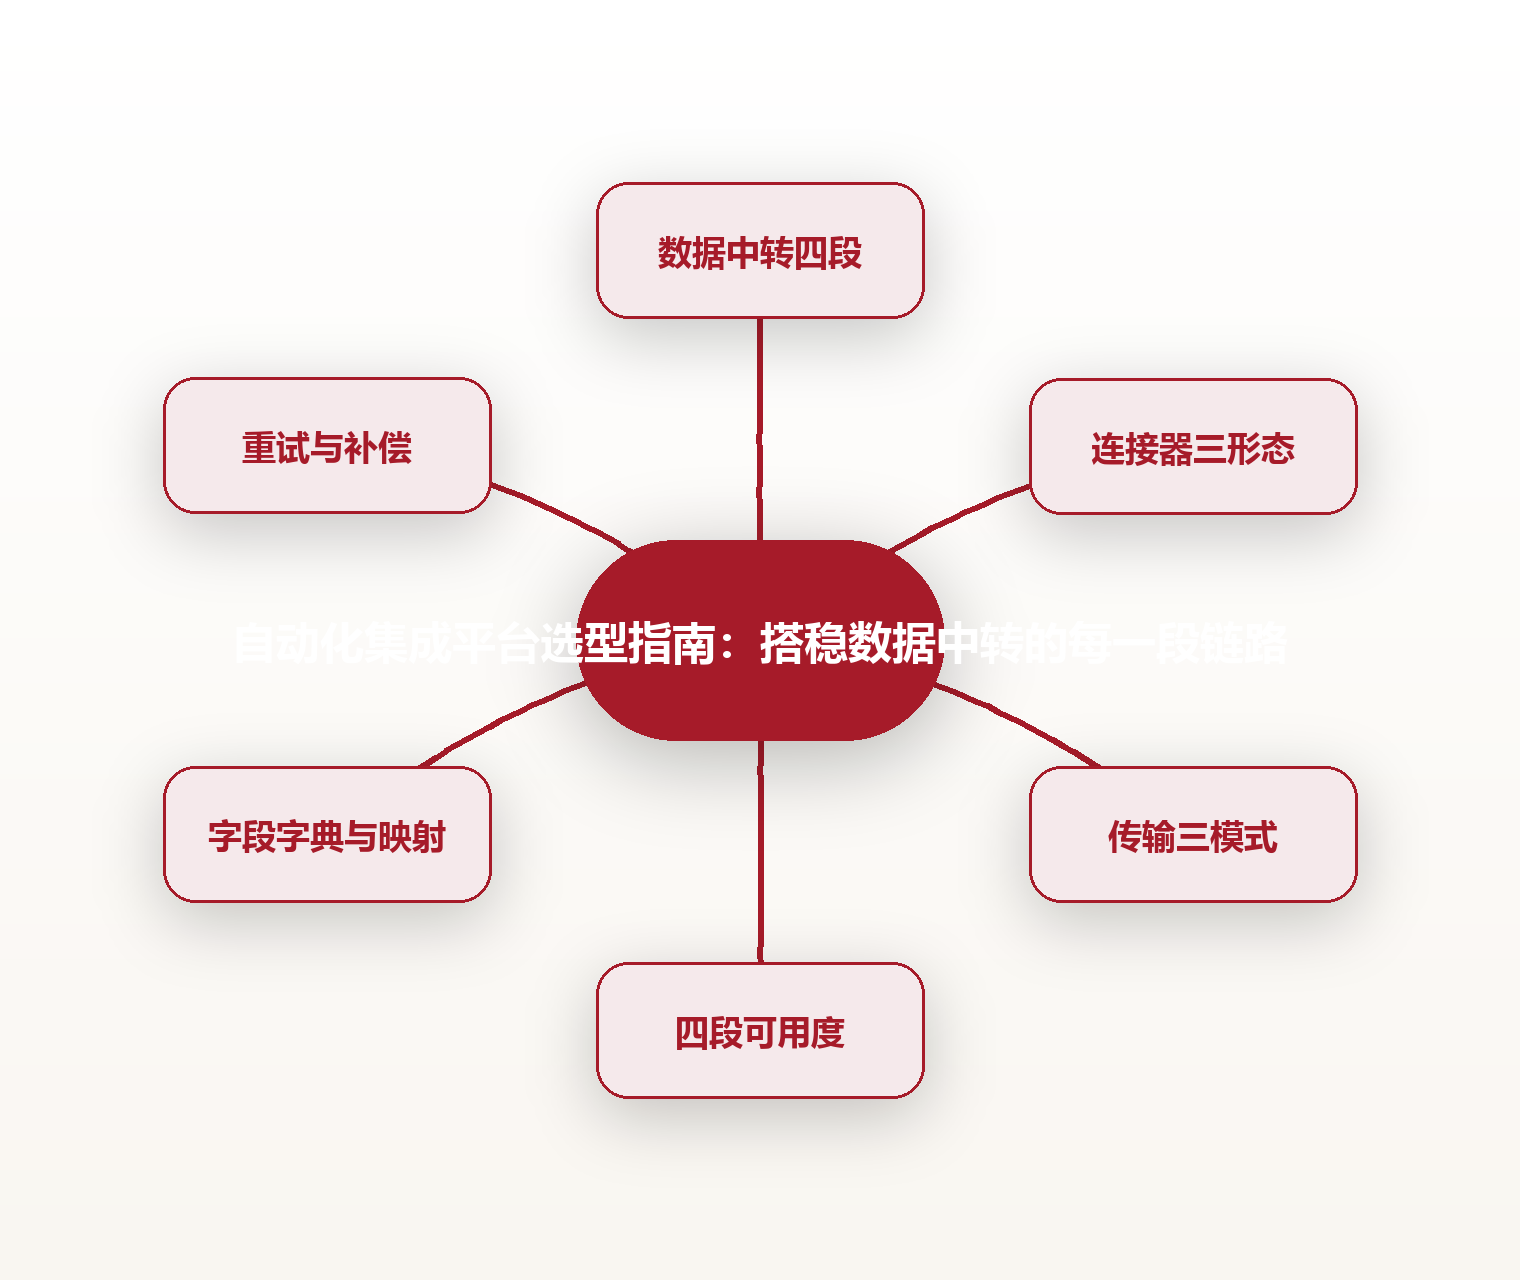
本文按四个环节拆开讲:先建立数据中转的通用模型,再对比三类连接器形态与三种传输模式,然后给出一套选型框架与可靠性指标,并落到字段映射、失败处理与权限边界这三项长期维护工作。
数据中转的四个环节:触发、取值、变换、投递
任何一条集成链路,都可以拆成四个环节。触发决定什么时候开始,取值决定拿到什么,变换决定格式如何对齐,投递决定结果落到哪里。把四段分开描述,问题定位会快很多,否则出故障时只能整体重跑。
第一环节是触发。常见的触发源有四类:定时、事件、轮询到的变化、人工按钮。定时触发实现简单但请求浪费,事件触发效率更高但对源系统的支持有要求,轮询是折中方案,人工按钮则适合低频且需要判断的场景。
第二环节是取值。取值要回答三个问题:取哪些字段、要不要带关联记录、增量还是全量。很多链路的隐患就埋在这里——只取了主表的五个字段,等下游需要联系人电话时才发现上游根本没传过来。
第三环节是变换。上游的日期格式、枚举值、金额单位往往和下游不一致,需要在中间层统一。变换规则要写成显式的映射表,而不是散落在若干条规则里的临时判断,后者在半年后基本无法维护。
第四环节是投递。投递要处理成功判定、失败重试与结果回写三件事。只做成功判定的链路,等于把失败留给人工发现;把结果回写到上游或日志系统,才能让下一次排查有据可依。
四个环节串起来看,会得到一个朴素但有用的结论:链路的脆弱点通常不在传输本身,而在取值不完整与变换不可逆。因此设计时的重心应该前移,把字段清单和映射表先固化下来。
连接器的三种形态:托管型、自托管型、嵌入式
连接器是集成平台与应用之间的适配层。按部署与维护方式,可以分成三种形态,各自适配不同的团队规模与合规要求。
第一种是托管型,由平台方统一维护连接器与运行环境。优点是开箱即用、更新及时、运维负担低;代价是数据要经过第三方网络,且可用性与定价受平台策略影响。适合中小团队与标准化程度高的场景。
第二种是自托管型,平台本身部署在自己的服务器或私有环境里。优点是数据留在自己的网络边界内,连接器可自行扩展;代价是要自己负责升级、备份、监控与故障处理,对运维能力有要求。
第三种是嵌入式,即应用自身对外开放集成能力,把集成入口做进产品内部。优点是体验统一、权限可控;代价是覆盖范围有限,通常只能连接该应用生态内的少量系统,跨生态仍要回到前两种形态。
三类形态并不是互斥的。常见做法是混合部署:涉及客户个人信息与财务数据的链路走自托管,营销与通知类的链路走托管,核心业务系统则用官方的嵌入式入口承接。
选择时的判断依据可以简化为两条:数据能离开自己的网络吗?运维投入能被现有团队消化吗?两条都答「能」,托管型通常更省事;任一答「不能」,就该考虑自托管或嵌入式。
传输模式:轮询、事件与队列
数据怎么从上游到下游,有三种典型模式。理解它们的差异,比记住产品名更有用,因为产品会变,模式不会。
轮询是平台按固定间隔向上游询问有无变化。实现简单、兼容性好,代价是延迟与请求量:间隔短则请求多、容易触发接口限流,间隔长则数据滞后。轮询适合变更不频繁、对实时性要求不高的场景。
事件推送是上游在发生变化时主动通知平台。延迟低、请求量少,但要求上游支持事件机制,且平台需要有一个可被访问的地址。事件推送的另一项要求是幂等:同一事件重复送达时,下游不应产生重复记录。
队列是在两者之间加一层缓冲。上游把消息写入队列,消费方按自己的节奏取走。队列的价值在于削峰与解耦:上游短暂不可用不会丢消息,下游处理能力不足时可以慢慢消费。代价是架构复杂度上升,需要额外的监控。
三种模式的选择有经验规则:变更频率低于每小时一次且实时性要求宽松,用轮询;上游支持事件、下游能承受并发,用事件推送;流量波动大、下游稳定性一般,加队列缓冲。
需要提醒的是,模式可以组合。一条链路完全可能用事件触发、用队列缓冲、再向下游做定时批量投递。组合的取舍标准是一致的:在不牺牲可观测性的前提下,把延迟压到业务可接受的范围内。
专业分析:链路可靠性模型与一次迁移复盘
先说明数据来源:下文引用的量级来自两类公开材料——主流集成平台公开的定价与配额文档中对任务数、轮询间隔、重试策略的说明,以及若干技术团队在近年间发布的集成架构复盘文章。数字用于说明量级关系,不宜当作精确值。
我用的模型叫「四段可用度」。把一次成功的传输拆成触发成功率、取值完整率、变换正确率、投递成功率四个概率,链路的整体成功率近似等于四者相乘。这个模型的作用不是算精确值,而是暴露短板:哪怕三段做到 99%,一段只有 90%,整体也会掉到 96% 附近。
量级参考:托管型平台的任务执行延迟,常见在秒级到分钟级;轮询间隔在免费或入门档位上通常是 5 到 15 分钟,付费档位可降到 1 分钟以内;单条链路的月任务量从几百到几十万不等,计价方式多按任务数分档。这些数字决定了选型时对配额的敏感度。
做一组对照。以某电商运营团队的订单通知链路为例,该案例见于该团队公开的技术分享:改造前用定时轮询,间隔 10 分钟,日均触发约 144 次,其中有效变更平均只有 20 余次,无效请求占比超过八成,且高峰期出现过接口限流导致的漏单。改造后改为事件推送加队列缓冲,日均请求降到 40 余次,端到端延迟从平均 5 分钟降到 20 秒以内,漏单问题消失。
这个案例的关键不是换了什么工具,而是先算清了无效请求占比。如果只看「链路能跑」,轮询方案完全合格;一旦把无效请求与限流风险计入,结论就变了。指标先行的价值正在于此。
可落地的度量指标有五项:链路整体成功率(成功任务数除以总任务数,按周统计);端到端延迟中位数(从上游变更到下游可见的时间);无效触发占比(未产生实际变更的触发次数占比);人工干预次数(每周需要手动补数据的次数);字段缺失率(下游记录中关键字段为空的比例)。五项每周记录一次,连续四周。
对应的执行清单是七步:列出全部在建链路并标注业务等级;给每条链路定义一条成功判据;核对取值字段清单与下游必需字段是否对齐;把变换规则写成映射表并存档;设定重试与告警阈值;给高等级链路加死信队列与补偿入口;每月做一次链路复审,删掉连续四周无触发的条目。
选型框架:五问打分与成本口径
选型时容易陷入参数对比,比来比去到头来靠印象决定。更可控的做法是先问五个定式问题,再按权重打分。五个问题是:连接器覆盖是否包含我现有的全部关键系统?传输模式是否满足实时性要求?失败后可观测性到什么程度?数据是否可以不出网?团队能否承担运维投入?
打分表建议按三个维度给分:能力契合度 1 到 5、运维负担 1 到 5(分高代表负担小)、成本可控度 1 到 5。三条链路以上的团队,建议给能力契合度更高权重;只有一两条链路的个人用户,运维负担的权重应该更高。
成本口径要算三层。第一层是显性的订阅费,按任务数或按月计费,注意超额部分的单价。第二层是隐性的人力成本,包括建链路、改字段、查故障的时间,自托管还要加上升级与备份。第三层是风险成本,即链路中断对业务的影响,这一层常被忽略。
一个实用的算法是:把三层成本都折算成每月小时数或金额,再除以月任务量,得到单任务的综合成本。这个数字不需要精确,只要能横向比较两条候选路径就够用,很多时候结论会和只看订阅费时相反。
还要留意退出成本。数据在平台上留存多久、能否完整导出、链路配置能否导出为文件,这三项决定了将来迁移的难度。选型时把它们写进评估表,避免三年后被锁定在一个不合适的平台上。
字段映射与数据变换:把对齐做在前置层
集成链路里很耗时的部分通常不是连线,而是字段对齐。上游叫「客户名称」,下游叫「公司全称」;上游用三位国家代码,下游要中文国家名;上游金额单位是分,下游要元。这些差异必须在中间层显式处理。
建议的做法是先建一份字段字典。字段字典记录三列:上游字段名与类型、下游字段名与类型、变换规则。字典用表格维护,每次上游改版时同步更新。没有字典,规则就只能藏在链路配置里,改一个字段要点开十几条规则去找。
变换规则要尽量保持可逆或可重放。所谓可重放,指的是同一份原始数据重复经过变换,结果一致且不会产生副作用。做到这一点,重跑历史数据时才不会写出重复记录,排查问题时也能放心地回放。
枚举值的处理要额外小心。上游新增一个枚举值时,如果映射表里没有对应项,默认行为可能是丢弃、置空或报错。三种行为里,置空较危险,因为它不报错却污染了数据。建议把未命中项显式路由到告警,宁可停下来也不要静默通过。
还有一类高频偏差是时间与时区。上游用 UTC,下游按本地时间展示,跨天统计就会错位。做法是在链路里统一用带时区的时间戳传输,只在展示层做本地化转换,并且把时区规则写进字段字典。
失败处理:重试、死信与补偿
链路难免失败,区别只在于失败后是自动恢复还是等人发现。失败处理分三层:重试、死信、补偿。三层都配置好,才能把人工干预降到可接受的水平。
重试是第一层,适用于瞬时故障,比如网络抖动或上游限流。要点是采用退避策略:间隔按倍数递增,而不是固定间隔猛冲,同时设定上限次数。对写操作还要保证幂等,否则重试会产生重复记录。
死信是第二层,指重试耗尽后把消息转入一个专门的存储,等待人工或定时批处理。死信队列的价值在于不丢数据:链路可以继续处理后续消息,失败的那几条被妥善保留,而不是悄悄消失。
补偿是第三层,指在失败修复后把数据补齐。补偿需要两个前提:原始数据可重放,且下游支持按唯一键更新而非盲目新增。因此建链路时就应当约定唯一键,比如订单号或客户编号,否则补偿只能靠人工比对。
告警策略同样要分层。单次失败不必立刻通知人,连续失败或死信堆积超过阈值才需要。通知渠道也要分级:高等级链路进值班通道,低等级链路汇总成日报。告警过多等于没有告警,阈值需要按链路等级分别设定。
还有一项是演练。每隔一段时间,可以主动停掉一条非关键链路的下游,观察重试、死信与告警是否按预期工作。演练的目的不是找故障,而是验证恢复路径真的存在,而不是只写在文档里。
权限与合规边界:按需授权与数据驻留
集成平台天然处在多个系统之间,权限范围往往比单个应用更大。因此权限设计的第一条原则是按需授权:每条链路只申请它真正需要的读写范围,宁可多开几条链路,也不要共用一把全权限的钥匙。
第二原则是凭证隔离。不同链路使用不同的令牌或账号,这样某条链路的凭证泄露时,影响范围可控,撤销时也只影响这一条。共用凭证一旦泄露,排查范围会扩大到所有链路,撤销时还会牵连正常业务。
第三原则是数据驻留可说明。需要能回答三个问题:数据在传输过程中经过了哪些网络?是否在平台侧留存、留存多久?能否按需删除?涉及个人信息或财务数据的链路,这三个问题应当有书面答案,而不是靠推测。
日志与审计同样属于合规边界的一部分。日志里不应记录完整的敏感字段,必要时做脱敏或截断;访问日志要能追溯谁在什么时候修改了链路配置。缺少审计记录,事后复盘就只能靠回忆。
合规要求较高的团队,还可以考虑把集成层做成数据闸门:所有跨系统的数据流动都必须经过它,任何绕过闸门的直连都被禁止。这样权限边界清晰,审计点集中,代价是对闸门本身的可用性要求更高。
常见问题
一条链路失败后,重跑会不会产生重复数据?取决于链路是否幂等。做法是用上游的唯一键在下游做更新而非新增,并保证同一条原始消息重复处理时结果一致。建链路时就把唯一键定下来,比事后清理重复记录省力得多。
轮询间隔设成多少合适?先看变更频率与实时性要求。变更集中在工作时段且容忍几分钟延迟,5 到 15 分钟的间隔通常够用;需要秒级响应且上游支持事件,就该改用事件推送,而不是把轮询压到一分钟内去触发限流。
个人用户有必要上自托管吗?多数情况下不必。自托管带来的是数据边界与可控性,代价是升级、备份、监控的持续投入。除非链路涉及不便外传的数据,或者已有现成的服务器与运维习惯,否则托管型的性价比更高。
连接器不支持我需要的应用怎么办?先看平台是否开放自定义请求能力,用通用接口调用来补位;其次看是否支持通过中间格式(如表格或对象存储)做中转;两条路都不通时,再考虑换平台或自研一个轻量适配器。
任务数超了怎么办?先算无效触发占比,把轮询改事件、把全量改增量,往往能直接降下来一大截。若压不下来,再对照单任务综合成本决定是否升档。单纯升档而不优化触发,成本会随业务量线性上升。
怎么判断一条链路该不该继续保留?看连续四周的触发次数与人工干预次数。触发为零的可以直接归档;触发正常但干预频繁的,说明设计有问题,应当回到四个环节逐段排查,而不是继续打补丁。
图片来源:图1 newtjitsu / Pixabay (CC0) · 图2 blickpixel / Pixabay (CC0) · 图3 Pexels / Pixabay (CC0) · 图4 花见花开788 / Pixabay (CC0) · 图5 zivica / Pixabay (CC0) · 图6 AlLes / Pixabay (CC0) · 图7 lin2015 / Pixabay (CC0) · 图8 ahmetyuksek / Pixabay (CC0) · 图9 Gabriela-Motta / Pixabay (CC0) · 图10 lecreusois / Pixabay (CC0) · 图11 congerdesign / Pixabay (CC0) · 图12 Gabriela-Motta / Pixabay (CC0) · 图13 Alexas_Fotos / Pixabay (CC0) · 图14 SvenKirsch / Pixabay (CC0) · 图15 divotomezove / Pixabay (CC0) · 图16 Alexas_Fotos / Pixabay (CC0) · 图17 jarmoluk / Pixabay (CC0) · 图18 MonicaVolpin / Pixabay (CC0) · 图19 garten-gg / Pixabay (CC0) · 图20 SirBuvex / Pixabay (CC0) · 图21 Gabriela-Motta / Pixabay (CC0) · 图22 stuffwithkids / Pixabay (CC0) · 图23 fernandozhiminaicela / Pixabay (CC0) · 图24 t_watanabe / Pixabay (CC0) · 图25 ogamiichiro3 / Pixabay (CC0) · 图26 pen_ash / Pixabay (CC0) · 图27 pen_ash / Pixabay (CC0) · 图28 mepsita / Pixabay (CC0) · 图29 gkgegk / Pixabay (CC0) · 图30 ddzphoto / Pixabay (CC0) · 图31 mostafa_meraji / Pixabay (CC0) · 图32 GrownDiamond / Pixabay (CC0) · 图33 MaxxGirr / Pixabay (CC0) · 图34 divotomezove / Pixabay (CC0) · 图35 Derks24 / Pixabay (CC0) · 图36 ds_30 / Pixabay (CC0) · 图37 MiraCosic / Pixabay (CC0) · 图38 Dimhou / Pixabay (CC0) · 图39 MiraCosic / Pixabay (CC0) · 图40 focusonpc / Pixabay (CC0)
本文为方法论与信息分享,具体实践请结合自身情况判断。
评论(0)