
基本信息
阅读时间:约 16 分钟
字数:约 6251 字
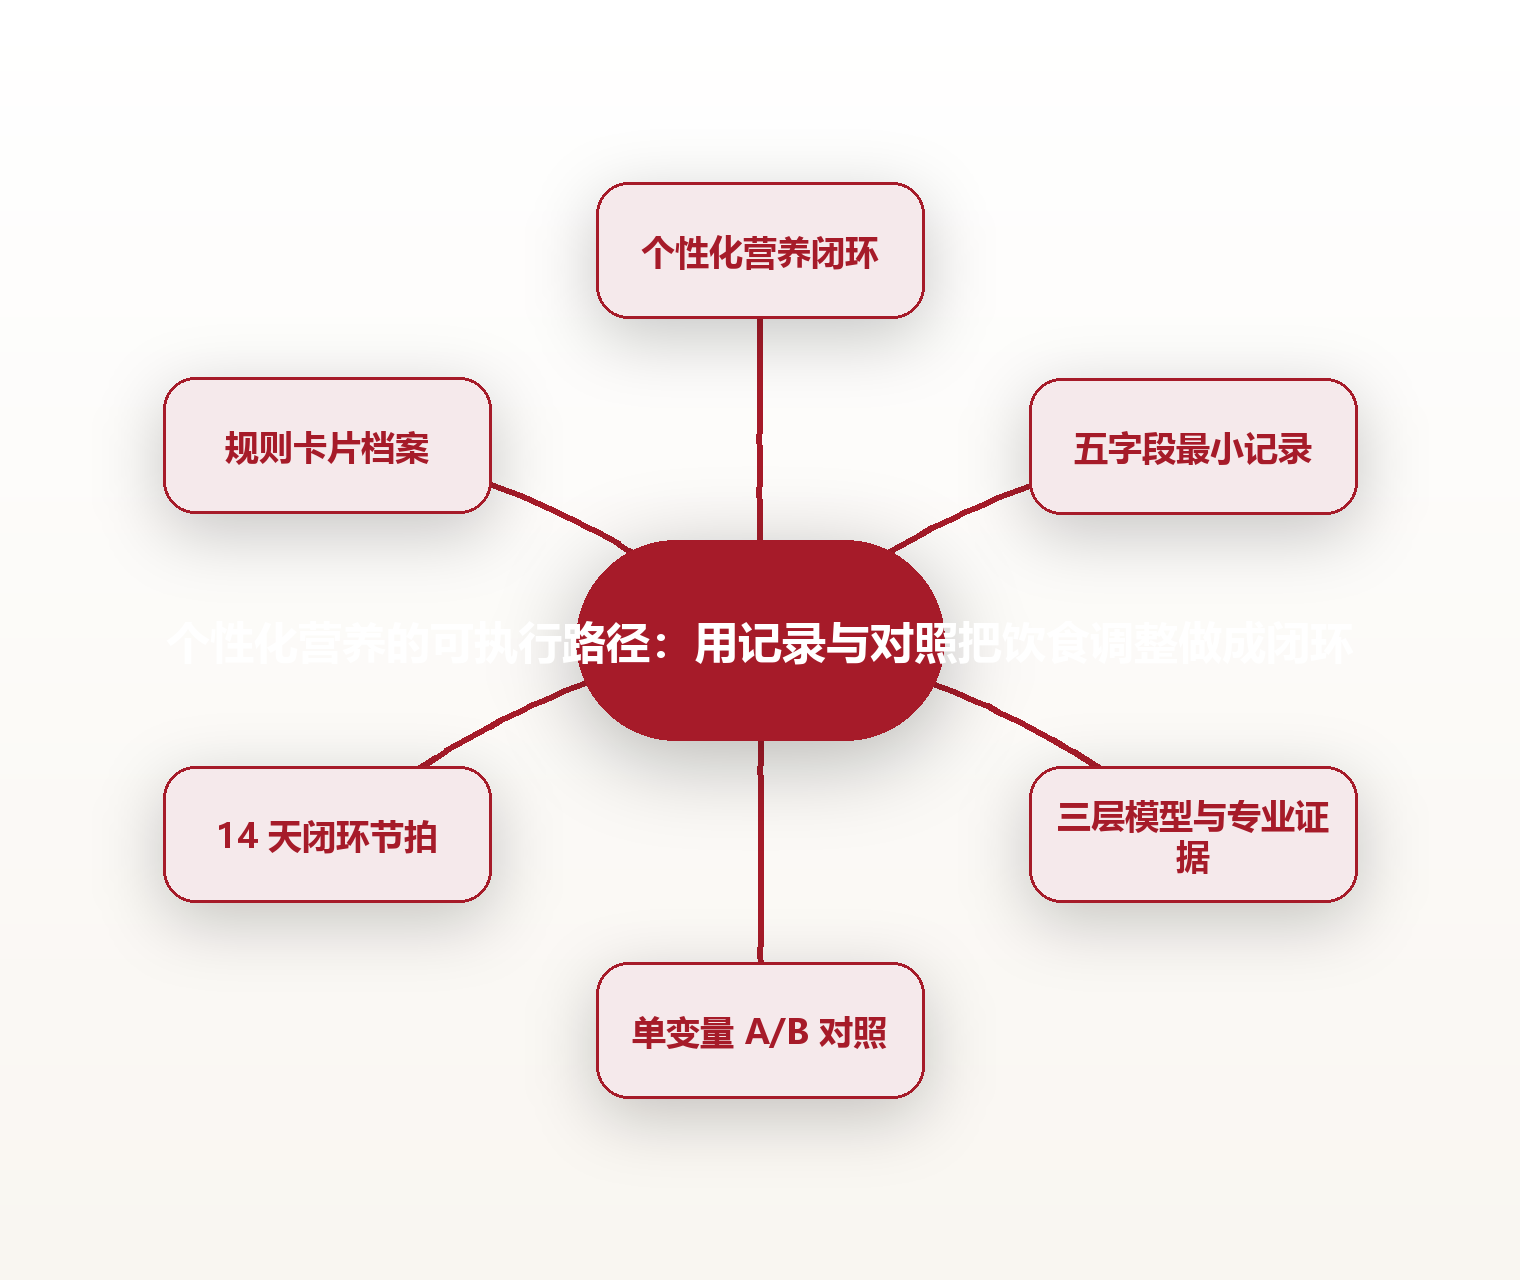
摘要:同样是早餐的一口饭团,在不同人身上引发的反应可能完全不同。本文用一套可执行的方法,把饮食调整从感觉变成数据:先用五个最小字段建立可坚持的记录,再用一次只动一件事的 A/B 对照验证每一次替换,最后把结论沉淀为带有效期与置信度的个人规则卡片。文中包含专业的证据对比、可度量指标与八项执行清单。
全文语音
中文
English
日本語
한국어
一顿反复「翻车」的早餐:多数人卡在哪里
早上 7 点 40 分,地铁 3 号线福田站,36 岁的周珩把一杯拿铁塞进背包的侧袋。他在深圳做产品经理,第 6 个年头。工位到会议室 28 米,他一天要走 11 趟。这些数字他记得很清楚,因为他用手机记了整整三个月。
「我那时候以为自己吃得挺讲究。」周珩说。他的早餐常年只有两种组合:便利店饭团配拿铁,或者公司楼下的肠粉加豆浆。他坚信自己在控制糖分,因为他从不吃甜点。直到一次体检报告上,空腹血糖那一栏从 5.3 变成 5.9,医生建议他三个月后复查一次。
真正让他困惑的不是这个数字本身,而是他答不出一个很朴素的问题:到底是哪一口东西造成的。早餐有那么多种组合,咖啡、饭团、肠粉、豆浆,哪一种对他的身体影响更大?他说不上来。「后来我才明白,我不是缺方法,我是缺记录。」
这个故事里藏着一个相当普遍的结构:绝大多数人对饮食的判断,来自记忆而不是记录。而记忆有一套被反复验证过的系统性偏差——人对近期、强烈、带情绪的事件记得清楚,对平淡重复的三餐几乎没有印象。营养流行病学文献长期提到,基于自我报告的能量摄入普遍存在低估,公开综述中常见的量级在 10% 到 20% 之间,这是群体层面的统计结论,不代表任何个人的实测结果。
于是形成了一处缺口:你会依据一个模糊的印象去调整饮食,调整之后,仍然用同一个模糊的印象去判断到底有没有用。缺的往往不是决心,是一次可观测、可回看的记录。
接下来要拆的,是怎么把「我好像吃了什么」变成「我确实吃了什么、身体给出了什么反馈」,再把这个反馈变成下一轮可以被验证的判断。这条路不需要昂贵的设备,也不需要医学背景,需要的是一套能长期坚持下去的记录与对照方法。
把饮食从感觉变成数据:记录的最小可行字段
记录之所以难坚持,绝大多数时候不是因为懒,而是因为字段太多。设想一张要填 20 项的表,第 3 天就会被扔在一边。可执行的第一步,是把字段压缩到 5 个:进食时间、食物条目、大致分量、进食时的饥饿评分、进食后的状态描述。
时间字段的意义在于锚点。写「8:12」而不是「早上」,前者可以和其它变量对齐。手机相册里的一张照片是成本最低的记录方式——拍照耗时约 8 秒,而且比打字更准,因为视觉信息天然包含了分量与搭配。
分量字段不需要精确到克。「一小碗」「半份」「两个掌心」这类相对单位就够用。真正重要的是口径一致:今天用「碗」,明天也用「碗」,跨天比较才成立。称重可以在需要精细对照的那一周临时启用,不必全年开启。
饥饿评分用 1 到 5 的整数。这不是为了追求精确,而是为了把「我是不是因为饿才吃的」这个变量单独拎出来。很多所谓「某种食物让我不舒服」的判断,真正的原因其实是吃得太快,或者在极度饥饿的状态下一口气吃完。
饭后状态字段建议切成两个时间窗口:餐后 60 分钟以内,餐后 2 到 4 小时。前者通常对应消化负担与明显的困倦感,后者对应更迟缓的精力变化。用一个词加一个评分即可,比如「困 3」「清醒 4」,不需要写成段落。
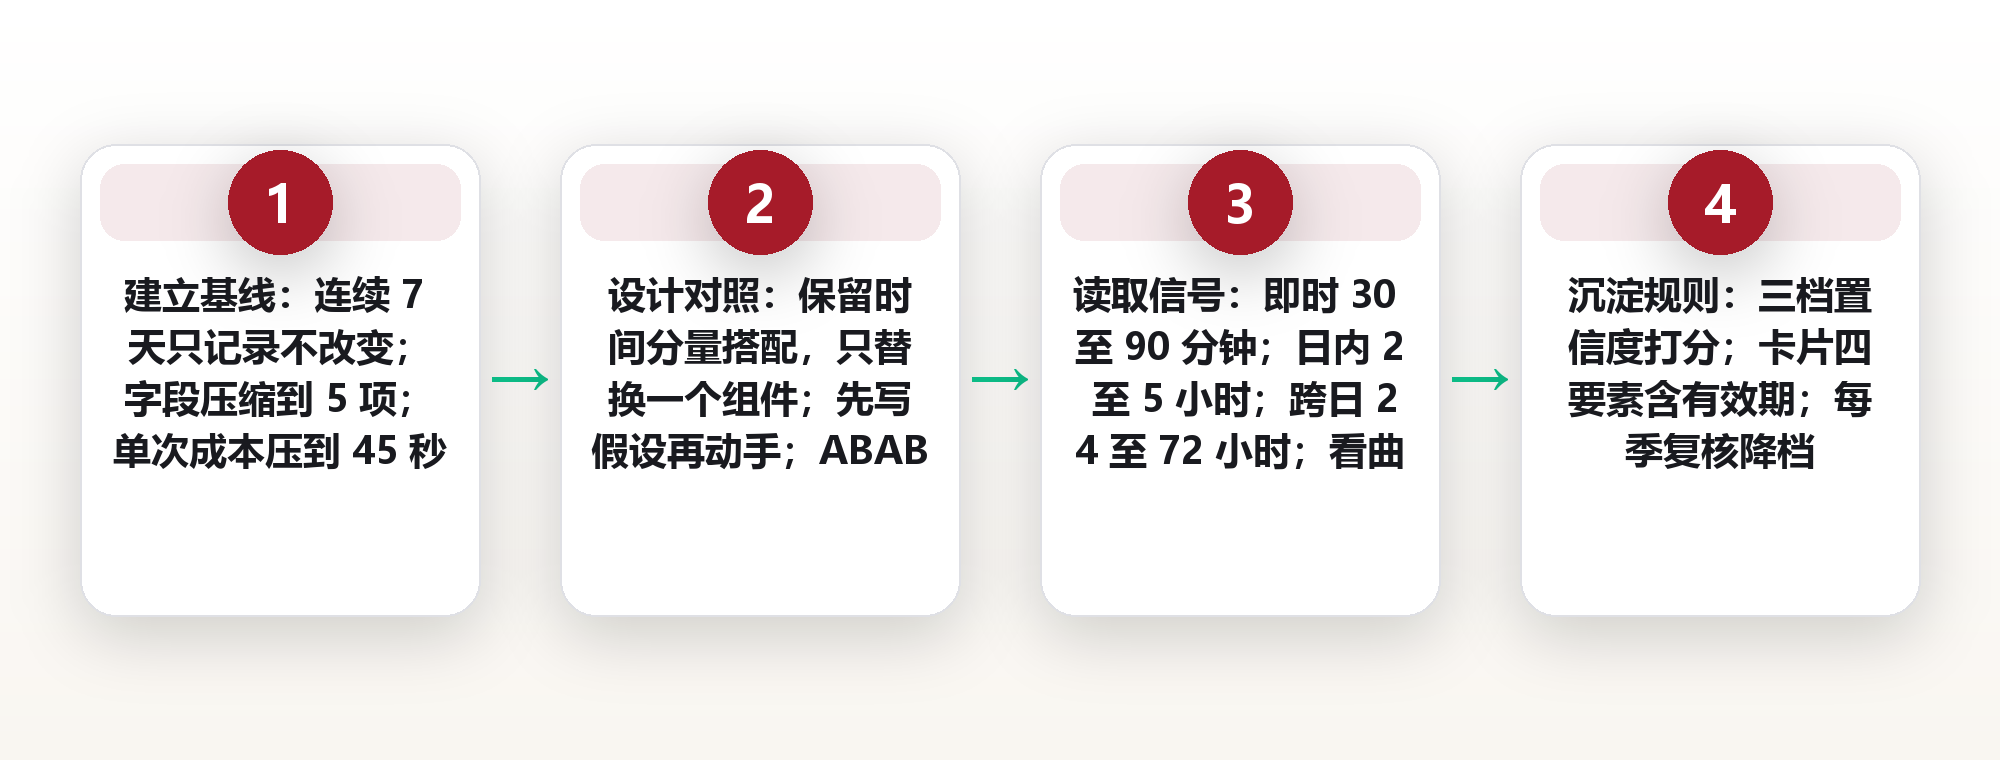
这 5 个字段加起来,单次记录成本大约 30 到 45 秒,一天 3 次不到 3 分钟。当记录成本压到这个阈值以下,它才有机会撑过第 3 周——而多数人恰好在第 3 周放弃,原因通常是表格太复杂,而不是意愿不足。
专业分析:群体均值为何解释不了你的个体反应
把「吃什么更好」当作一个统一答案来处理,本质上是把群体层面的结论直接套到个体身上。这个错位有三层证据值得放在一起对照着看。
第一层证据来自大型人群干预。2013 年发表于《新英格兰医学杂志》的 PREDIMED 研究,纳入约 7447 名心血管高风险参与者,地中海饮食组的主要心血管事件风险较对照组下降约 30%(风险比约 0.70,据公开研究报告的量级)。这是一条极强的群体结论,它证明了饮食模式在人群层面的价值。
第二层证据来自同一个蛋黄引发的两种反应。2015 年发表于《Cell》的一项研究,对约 800 人的队列累计记录了约 4.7 万餐次并连续监测血糖,发现同一种食物在不同人身上引起的餐后血糖反应差异极大,研究者据此建立了结合个人信息与肠道菌群特征的预测模型。2020 年发表于《Nature Medicine》的 PREDICT 1 研究,进一步在约 1102 名受试者中使用标准化餐食挑战,证实餐后血脂与血糖反应的个体差异远大于餐食本身的平均效应。
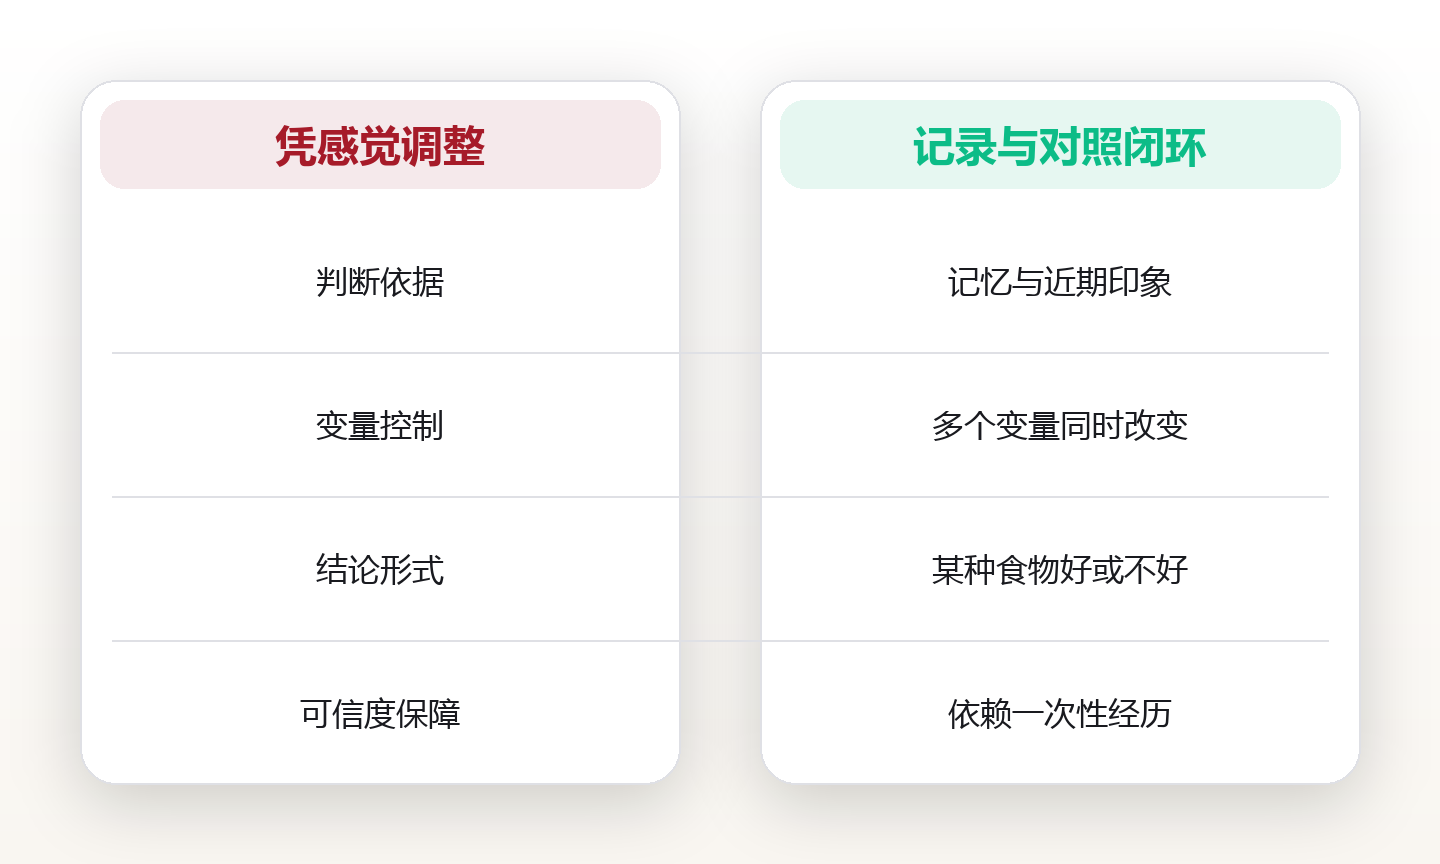
把这两层放在一起,会得到一条并不矛盾、但需要重新表述的结论:群体证据回答「什么方向更稳妥」,个体数据回答「对你而言具体到哪一口」。前者是导航仪,后者是方向盘,两者各管一段,互相不可替代。
这背后是三个可以命名并对比的模型。第一个是「群体均值模型」,代表形式是各国膳食指南与营养素推荐摄入量,输入来自全国性或全人群统计,输出通常设定在覆盖 97% 到 98% 人群的参考区间;优点是稳健,缺点是颗粒度粗、无法解释个体内的短期波动。
第二个是「N-of-1 交叉对照模型」,源自临床医学中的单一个案随机对照交叉设计(ABAB 相位设计),输入是同一个人在多个周期内交替执行的方案,输出是个人层面的效应方向;优点是贴合个体、成本可控,缺点是样本量仅为 1、外推性弱、对执行纪律要求高。
第三个是「预测建模模型」,代表作是前文提到的机器学习事前预测路径,输入是个人特征与微生物组等数据,输出是概率性预判;优点是省时间,缺点是需要专门的数据采集与专业解读条件。对个人执行者而言,最务实的做法不是三选一,而是分层使用:用群体均值模型确定大方向(膳食结构、蔬菜与全谷物的占比),用 N-of-1 交叉对照模型解决「这个具体替换对我有没有用」,预测建模模型暂时留在「有专业条件时再考虑」的那一层。
还有一个典型的可辨识实验,说明了「替换」这件事的力量。2019 年发表于《Cell Metabolism》的一项交叉对照研究,受试者在两个为期两周的周期内分别食用超加工膳食与未加工膳食,两种膳食在糖、盐、脂肪等标示营养成分上被刻意拉平;结果是能量摄入相差约每日 500 千卡,体重在两个周期内出现了约 0.9 千克的相反方向变化(据公开研究报告的量级)。这个实验的价值不在「超加工不好」这个结论本身,而在于它示范了什么叫做单一变量:把营养成分对齐,只改变加工程度。
落到可落地的度量,建议盯住四个指标。一是记录完整度,定义为有记录餐次除以总餐次,稳定执行的门槛设在 80%;二是变量单一率,定义为只改变一个变量的天数除以对照总天数,建议不低于 70%;三是效应一致性,指同一对照重复 3 次以上时结果同向的比例,建议达到三分之二以上才写进结论;四是观察窗口覆盖率,指餐后 60 分钟与 2 到 4 小时两段都填的比例,建议不低于 60%。这四个指标都不依赖任何设备,只依赖记录的纪律。
对应一份八项执行清单:先连续记录 7 天且不做任何改变以建立基线;每次只替换一个组件;同一变量的对照至少重复 3 次;把对照的日子安排在作息相近的两天;避免在节假日及邻近日子做对照;每条结论写成一句明天可以被推翻的话;给每条结论标注实际的样本天数;每季度把结论表中的失效条目清算一次。这份清单的作用不是提高效率,而是防止你把巧合当成规律。
一次只动一件事:个人饮食对照的设计原则
「一次只动一件事」说起来容易,执行时最常见的破口是同时动了好几件而自己没有察觉。把早餐从饭团换成燕麦,很可能同时改变了四样东西:碳水的类型、进食的时间、是否搭配咖啡、以及分量大小。四个变量一起变,无论结果好还是坏,你都无法知道是哪一件起了作用。
解决方法是用「替换」替代「重设」。保留时间、分量、搭配不变,只替换其中的一个组件:拿铁的奶换成另一个版本,其余不变;白米饭换成掺了杂豆的饭,菜量与时间不变。用这种写法,一次对照里就真的只有一个变量在动。
「A/B 对照」是这套方法的核心动作:同一个人在相邻的两组日子里执行两套方案,其它条件尽量保持一致,然后比较结果。它与严格的临床研发的最大差别在于样本只有你自己,因此它靠重复次数而不是靠一次性的结论来建立可信度。同一组对照建议重复 3 到 5 次。
顺序也要提前安排。ABAB 的相位——基线、方案、回到基线、再到方案——比单纯的 AB 更能抵挡「那天刚好睡得好」这类干扰。如果某一次出现了相反的结果,先不要急着下结论,把那天的睡眠时长、压力事件、运动量从记录里翻出来核对一遍。多数异常值的背后,都藏着一个被忽略的条件。
还需要提前说清楚什么情况下这组对照作废。若两条记录之间的跨度超过 10 天,若对照期内出现连续两餐没有记录,若期间发生了明显扰动作息的事件(出差、连续熬夜赶稿、身体不适),这组对照都应判为无效并重做。作废不是损失,作废是把噪声拦在结论之外。
最后一条原则最容易被跳过:先写假设,再动手。「把午餐的白米饭换成杂豆饭后,我预计餐后 60 分钟内的困倦评分会从 3 降到 2 以下」——先把这句写下来,然后才去执行。没有预先写下的假设,人总会在看到结果之后重新编一个解释,而那正是这套方法要尽力避免的事情。
14 天一个闭环:从基线到结论的完整节拍
很多人问这套方法要跑多久。答案取决于你要回答的问题有多难。一个可以直接照搬的默认节拍是 14 天:7 天基线加 7 天对照,恰好覆盖两个完整的作息周。
第 1 到第 7 天,只记录、不改变。这段时间的价值往往被低估——它既是基线,也是训练记录习惯的阶段。到了第 5 天左右,你会发现记录不再需要提醒,而这个状态本身比任何数据都重要。
第 8 天开始引入对照组。按 ABAB 的节奏安排:第 8、9 天执行新方案,第 10 天回到原方案,第 11、12 天再执行新方案。这样你在 5 天之内完成了一次带回归的交叉对照,并且让方案的重复次数达到 3 次。
第 13 天用来整理。把这段时间内的记录按日期排成一列,给每一天标出两项:餐后 60 分钟的评分,以及餐后 2 到 4 小时的评分。画成两条折线即可,不需要任何图表工具。人眼对折线方向的判断,往往比想象中可靠得多。
第 14 天写结论。标准的句式只有一种:在 X 条件下,把 A 换成 B,Y 指标向 Z 方向变化。举个例子:在保持作息与分量一致的条件下,把午餐饮料换成不含奶的版本,餐后 60 分钟的困倦评分平均下降 0.8 分。「条件下」这三个字必须写进去,因为脱离条件的结论无法迁移。
一轮 14 天,只回答了一个问题。一年 365 天,大约可以跑 26 轮。26 条回答了具体问题的句子,比任何一份通用食谱都更贴合你自己的身体。这就是把「调整饮食」变成「积累个人数据资产」的过程。
读得懂的信号:精力、消化与体重的三种滞后
对照之所以难判断,一个原因在于不同类别的反馈有着完全不同的时间尺度。把它们放在同一个窗口里比较,往往会得到互相矛盾的结论。
第一类是即时反馈,窗口在餐后 30 到 90 分钟。典型表现是困倦、腹胀、注意力涣散。这一类最容易归因,也最容易被误判——因为它同样受前一晚睡眠的影响。若前一晚睡眠时长不足 6 小时,当天的即时反馈建议整体作废。
第二类是日内延迟反馈,窗口在餐后 2 到 5 小时,体现为下午的精力曲线、加餐冲动、情绪波动。这一类与餐食的血糖波动趋势、蛋白质与脂肪的配比关系更强。判断方式是看曲线形状而不是看单点:中午到下午 3 点之间的下滑速度,比某一个时刻的评分更有说明力。
第三类是跨日延迟反馈,窗口在 24 到 72 小时。典型表现是次日晨起的体重波动、晨起的口干或水肿感、连续两天的睡眠深度变化。这一类最慢,也最容易被归因错误——人们习惯把今天的不舒服归给今天吃的最后一口,实际上它常常来自昨天。
因此记录表格至少要有跨日检索能力:能一键调出「昨天三餐加今天指标」。如果你的工具做不到这一点,最简单的办法是在每天第一条记录的上方留出一行「昨日备注」,把关键情况手写进去。
还有一个常被忽略的细节:体重是波动信号而不是趋势信号。同一天早晚的差异在普通人群中常见到 1 千克左右的浮动,主要受水分与进食影响,属于正常的生理波动范围。所以判断趋势要看 7 日移动平均,而不是某一次的读数。加一个滑窗把它平滑之后,你会立刻少掉一半的误判。
三类执行偏差与纠偏方法
第一类是「只记坏的」。人在不舒服的时候更愿意写记录,舒服的时候往往漏记。结果是对照样本系统性偏向负面,结论自然偏向悲观。纠偏的办法很直接:设定一条硬性规则——没有配套完整记录的日子,无论当时感觉多好,都不计入。
更省力的做法是分两次记:吃完当场记 A 段(时间、食物、分量、饥饿度),饭后 60 分钟与 2 到 4 小时各记一次 B 段。把记录拆成两个动作,比要求自己一次填完更容易坚持下去。
第二类可以称为「自我表演效应」——一旦意识到自己正在被观察(而观察者恰好是自己),行为就会轻微变形。记录的那几天,你会不自觉地少吃两口、多走一段路。这本身未必是坏事,但它让基线失真。纠偏的办法是:在建立基线的头 7 天里,明确告诉自己这段时间不做任何调整,并把这条写在表格的最顶端。
第三类是「结论先行」。先认定某种食物不适合自己,然后在记录中不自觉地寻找支持这条判断的证据。纠偏需要一个外部动作:把每条结论的反向证据也一并记下来。若某次吃了它却毫无异常,这一条必须写进同一份记录。
还有一种隐蔽的版本:把相关当成因果。周一的早餐总是相同,周一的精力总是偏低,于是判定早餐有害——可真正的变量很可能是周一的例会。避免这种误判的动作是把位置换一换:把这顿早餐挪到周三吃两次,看结论是否还成立。挪不动的结论,往往不是因果。
这三类偏差有一个共同的解药:让记录早于判断。只要先有完整的记录,判断可以在任何时刻重做;一旦判断先落定,记录就退化成替它找补的工具。顺序对了,方法就对了大半。
从记录到档案:把结论沉淀成个人规则
跑了三四轮之后,最容易发生的浪费是把结论丢在原处。真正的价值不在那一句「咖啡让我犯困」,而在十几句同类句子累积出来的模式。
建议在食谱之外,单独维护一份「规则卡片」。每张卡片写四段:适用条件、具体动作、观察指标、有效期。举例来说,一张卡片可能写着:工作日午餐、白米换成杂豆饭、饭后 60 分钟困倦评分、有效期至体重变化超过 3 千克为止。有效期这个字段最常被漏掉,但它恰恰是防止规则僵化的关键。
卡片按置信度分三档。绿档:重复 3 次以上且同向比例不低于三分之二。黄档:重复 2 次且方向一致。红档:只有一次记录,或者方向互相矛盾。只有绿档的规则才写进日常默认动作,黄档继续观察,红档仅作备忘。这个分层避免了多数人最常犯的错——把一次的经历当成长期规律。
身体会变,规则也要跟着变。建议每季度做一次 20 分钟的复核:把绿档卡片按写入时间排序,看最早几张是否还在起作用;把连续两轮都失效的卡片降档。一份静态的档案几乎没有价值,能自我修正的档案才有。
档案还有一个很少被提到的用途:它让你在面对外部建议时有判断依据。当有人推荐某种饮食法,你可以直接拿出自己的对照结论问一句:在我的条件下,这条建议里哪一项已经被我验证过?被验证过的才算属于你,其余的都只是别人的样本均值。
一句值得写在档案首页的话:不要追求找到那个唯一正确的饮食方案,要追求建立一套能持续产生新答案的机制。方案会过时,机制不会。
让这套闭环长期运转的几个支点
任何方法都会遇到第 3 周的衰减。下面几个支点的作用不是让执行更用力,而是让阻力更小。
第一个支点是降低启动成本。把记录入口放在手机首屏,或者干脆放在支付工具旁边——你每天都会多次打开它。把表格放在需要三次点击才能到达的位置,等同于默认放弃。
第二个支点是绑定既有习惯。把记录的触发动作绑到「吃完最后一口、放下筷子」这个动作上,而不是绑到某个时间点。动作触发器比时间触发器更稳,因为它不依赖当天行程是否被打乱。
第三个支点是周期性地删减字段。每跑完 3 轮,检查哪些字段你几乎从不回看,把它们删掉。表格越短,你越愿意打开它。理想的长度是:你能在一刻钟之内掌握全表,并在 15 秒内填完一次。
第四个支点是允许中断。中断一天不需要补记,也不需要重新计数。把规则写成「中断不超过连续 3 天视为有效延续」,比写成「必须连续」要现实得多。绝大多数放弃并不是因为中断本身,而是因为中断之后的自责。
第五个支点是把结论说出来。每跑完一轮,把那句结论讲给一个人听。讲述的过程会逼你把模糊的感觉压缩成清晰的句子,而清晰的句子才能在下一次被真正调用。这也是为什么很多人记了很久却仍然原地踏步——他们从来没有把记录翻译成语言。
回到周珩。第 9 周的时候,他的备忘录里已经有 11 张卡片,其中 4 张是绿档。最有用的一张写着:工作日早餐若在 9 点前吃完,午后第一次加餐冲动平均推迟约 2 小时。「我现在还是喝拿铁,」他说,「但我知道它该在哪一天出现。」
常见问题
1.问:没有血糖监测设备,这套方法还能跑起来吗?
答:可以。设备的价值是把连续数值接进来,而这套方法的核心是「记录加对照」的结构,主观评分同样能支撑这个结构。把精力、困倦、腹胀这三项做成 1 到 5 的整数评分,坚持两周,方向性结论通常就已经足够清晰。若之后有条件再引入设备,也只是把评分换成更细的刻度,方法本身不需要重来。
2.问:一天到底要花多少时间在记录上?
答:按 5 个字段、一日三餐计算,单次 30 到 45 秒,全天不到 3 分钟。真正耗时的是最初的 7 天,因为还不熟练;第 2 周起通常会降到 2 分钟以内。如果你超过了这个数字,多半是字段太多而不是执行不力,应当回过头去精简表格。
3.问:连续记录多久,才值得写下第一条结论?
答:建议的门槛是:7 天基线加至少 3 次同一变量的重复对照,合计约 14 天。低于这个样本量的结论,先标记为红档备忘,不要写进日常动作。急于在第 3 天就下判断,是这套方法最常见的失败方式。
4.问:出差或者作息被打乱的时候该怎么处理?
答:最直接的处理是把这些日子判为无效并从样本中剔除,回到规律作息后再补一轮。出差期间仍然建议记录,因为其中的对比价值不在于支持某个结论,而在于告诉你作息扰动对指标的影响幅度——这个幅度本身就是一条有用的规则。
5.问:如果两轮对照给出了相反的结果,该怎么办?
答:先不要修正结论,而是先检查三个地方:两轮的作息是否相近、变量是否真的只有一个、有没有被忽略的共同条件(睡眠、压力、运动)。三者都没问题时,说明这个变量对你可能并不敏感,那就把它降到黄档,换一个更可能有反应的变量去验证。得到「这条没差别」也是一个有价值的答案,它至少排除了一个方向。
图片来源:图1 modernseoul / Pixabay (CC0) · 图2 newtjitsu / Pixabay (CC0) · 图3 花见花开788 / Pixabay (CC0) · 图4 花见花开788 / Pixabay (CC0) · 图5 marcparraphoto / Pixabay (CC0) · 图6 Ri_Ya / Pixabay (CC0) · 图7 rupixen / Pixabay (CC0) · 图8 rupixen / Pixabay (CC0) · 图9 jarmoluk / Pixabay (CC0) · 图10 3345557 / Pixabay (CC0) · 图11 3345557 / Pixabay (CC0) · 图12 3345557 / Pixabay (CC0) · 图13 Kranich17 / Pixabay (CC0) · 图14 Bessi / Pixabay (CC0) · 图15 modernseoul / Pixabay (CC0) · 图16 x-readingman / Pixabay (CC0) · 图17 jplenio / Pixabay (CC0) · 图18 soap0119 / Pixabay (CC0) · 图19 Ralphs_Fotos / Pixabay (CC0) · 图20 Ralphs_Fotos / Pixabay (CC0) · 图21 Fxq19910504 / Pixabay (CC0) · 图22 hpgruesen / Pixabay (CC0) · 图23 Tumisu / Pixabay (CC0) · 图24 herb1979 / Pixabay (CC0) · 图25 MarcinZ83 / Pixabay (CC0) · 图26 pasja1000 / Pixabay (CC0) · 图27 JerzyGórecki / Pixabay (CC0) · 图28 berkemeyer / Pixabay (CC0) · 图29 webreiziger / Pixabay (CC0) · 图30 Pexels / Pixabay (CC0) · 图31 HeungSoon / Pixabay (CC0) · 图32 HeungSoon / Pixabay (CC0) · 图33 sjr4x4 / Pixabay (CC0) · 图34 Tama66 / Pixabay (CC0) · 图35 Pexels / Pixabay (CC0) · 图36 FoYu / Pixabay (CC0) · 图37 MiraCosic / Pixabay (CC0) · 图38 Dimhou / Pixabay (CC0) · 图39 MiraCosic / Pixabay (CC0) · 图40 focusonpc / Pixabay (CC0)
本文为健康科普信息,仅供参考,不构成医疗建议;如有健康问题请咨询专业医疗机构。
文中涉及的数值区间仅用于个人记录对照中的趋势观察,不可作为诊断依据或自我判断的依据;孕期、哺乳期、慢性病人群及正在服药者请先咨询专业人员。
评论(0)