
基本信息
阅读时间:约 18 分钟
字数:约 7021 字
摘要:本文拆解隐形糖的识别方法:先讲配料表的排序与三条隐藏规律,再给出 27 个糖的别名全清单与易混淆清单,接着读出营养成分表里的糖、单位与声称阈值。专业分析章提出三层标签解构模型,与红绿灯标签体系、别名计数法做对比,并附便利店货架抽样记录。最后用四组早餐搭配演算真实糖量,给出三项可落地指标与四步执行清单。
全文语音
中文
English
日本語
한국어
隐形糖从哪里来:一个被低估的日常变量
很多人在控糖时,第一反应是"我不吃甜的"。这句话听起来很有执行力,但在真实的食品货架上几乎不成立。因为甜度和糖量并不是同一件事:一款番茄味调味酱可能尝起来是咸的,一款全麦吐司可能几乎吃不出甜味,一款主打"轻盈"的谷物饮也可能含糖。糖在食品工业里并不只是甜味剂,它还是上色剂、保水剂、发酵底物和口感改良剂,因此在咸味食品、酱料、烘焙食品和冲调饮品里长期存在。

所谓"隐形糖",指的是那些没有被消费者当作糖、但在营养学口径上属于游离糖或添加糖的成分。这个定义很关键:世界卫生组织对游离糖的界定,包含食品与饮料中添加的单糖、双糖,以及天然存在于蜂蜜、糖浆、果汁和浓缩果汁中的糖;而完整水果、蔬菜和牛奶中天然自带的糖,因为被细胞结构或基质包裹,通常不计入这一口径。理解这一点,很多标签上的困惑会自动解开。
为什么这件事值得花时间?从摄入结构看,包装食品与饮料是城市人群添加糖的主要来源之一。据公开研究与行业报告的量级描述,饮料、烘焙食品、调味乳制品与酱料长期位居添加糖来源的前列。也就是说,真正决定一天糖摄入高低的,往往不是偶尔吃的那块蛋糕,而是每天都会出现的那瓶饮品、那勺酱和那碗冲调谷物。
从主观感受上判断糖量之所以不可靠,还有一个生理学原因:咸味、酸味、油脂和香精都会显著压制甜感。食品配方中常见的做法是"糖盐协同",即少量的糖可以中和酸度、圆润咸味、平衡涩感。所以"不甜"是一条几乎无效的筛选标准,真正有效的筛选标准写在配料表和营养成分表里。
本文的目标很朴素:把这两张表读透,把 27 个糖的别名认全,再把一顿早餐的糖量算清楚。你不需要记住所有化学名词,只需要掌握一套可重复的操作流程。读完这篇,你在货架前的判断时间可以从几分钟压缩到几十秒,而且判断依据是可复核的数字,不是感觉。
配料表的读法:排序、位置与三条隐藏规律
配料表的第一条原则是排序:按照相关预包装食品标签标准,配料通常按加入量的递减顺序排列,加入量不超过 2% 的配料可以在特定条件下不按顺序排列。这意味着,如果"白砂糖"出现在配料表前三位,它的存在感通常不低;如果它出现在最后几位,含量一般相对有限。但这条规律有一个重要例外,就是下面要说的"分散投放"。
第一条隐藏规律是"分散投放"。一份食品可以同时使用白砂糖、果葡糖浆、麦芽糊精和浓缩果汁,每一种在配料表中的位置都不算靠前,但加总起来的总糖量可能相当可观。这就是为什么只看第一位配料会漏判。识别方法很简单:不要只看某一个名字,而要把配料表中所有属于糖类的成分圈出来,作为一个整体去估算。
第二条隐藏规律是"位置靠后的功能性糖"。麦芽糊精、麦芽糖浆、葡萄糖浆这类成分往往不是为了提供甜味,而是为了改善质地、增强溶解性、帮助褐变或延长货架期。它们常出现在咸味饼干、肉制品、速溶汤料和固体饮料里。因为不甜,消费者几乎不会把它们与糖挂钩,但从代谢口径看,它们仍然是可被快速消化吸收的碳水化合物。
第三条隐藏规律是"健康光环掩蔽"。当包装正面写着"无蔗糖""添加膳食纤维""0 脂肪""儿童成长"这类字样时,消费者容易降低对糖的警惕。而"无蔗糖"仅仅说明没有使用蔗糖,并不排除使用了葡萄糖、麦芽糖浆或浓缩果汁。类似的,"0 脂肪"产品为了补偿口感,糖量有时反而更高。识别方法是把包装正面的营销语与背面的配料表、营养成分表分开看,只让后者参与判断。
还需要留意复合配料。当配料表中出现"某某酱""某某馅料""巧克力涂层""谷物脆粒"时,这些复合配料本身含有自己的配料表,标注方式是括注或单独展开。糖常常藏在这类复合配料的内部。如果一份食品有三四层复合配料,实际糖量的不确定性会明显上升,这时营养成分表里的数字比配料表更可靠。
27 个糖的别名全清单:从白砂糖到浓缩果汁
下面这份清单按来源和形态分为四组,合计 27 个名字。它们都属于在标签上出现时应计入添加糖或游离糖考量的成分。建议的做法不是背诵,而是把这份清单存进手机备忘录,在货架前直接对照搜索。第一组是结晶糖类,共 8 个:白砂糖、绵白糖、冰糖、赤砂糖(红糖)、黑糖、蔗糖、葡萄糖、果糖。
第二组是糖浆类,共 9 个:高果糖玉米糖浆、果葡糖浆、玉米糖浆、葡萄糖浆、麦芽糖浆、转化糖浆、米糖浆(糙米糖浆)、枫糖浆、糖蜜。这一组是加工食品中出现频率最高的部分,尤其在饮料、烘焙和糖果中。它们的共同特点是溶解快、成本低、能同时提供甜度和保湿性,因此在工业配方里极受欢迎。
第三组是天然甜味来源,共 5 个:蜂蜜、龙舌兰糖浆、椰子花糖、浓缩果汁(包括浓缩苹果汁、浓缩葡萄汁等)、大麦麦芽提取物。这一组最容易引发误解,因为"天然"两个字自带好感。但从游离糖的口径看,蜂蜜和浓缩果汁中的糖同样属于应当计入的部分;完整水果里的糖不算,一旦榨汁或浓缩,细胞结构被破坏,口径就变了。
第四组是工业转化与粉末形态,共 5 个:麦芽糊精、固体玉米糖浆、海藻糖、焦糖糖浆、葡萄糖浆粉。这一组几乎不提供明显甜味,主要起填充、增稠、抗结晶和稳定结构的作用。它们常见于冲调粉剂、运动补给品、调味粉和婴幼儿辅助食品中,是隐形糖里最容易被忽略的一支。
还需要单独列出一份"易混淆清单",它们不属于上述 27 个糖的别名,但经常出现在同一类产品的配料表里:赤藓糖醇、木糖醇、麦芽糖醇、山梨糖醇、三氯蔗糖、安赛蜜、阿斯巴甜、甜菊糖苷、罗汉果甜苷。前四种属于糖醇,后几种属于高倍甜味剂。它们通常不按糖的口径计量,但糖醇在较大摄入量时可能影响部分人群的肠道舒适度,因此同样值得留意,只是不要把它们和添加糖混为一谈。
营养成分表里的糖:数字、声称与"每份"陷阱
营养成分表的读法比配料表更直接,但需要看清三件事:计量单位、是否标注糖、以及"每份"的定义。需要说明的是,在现行预包装食品营养标签标准的营养素参考值体系中,碳水化合物有参考值,糖并未单独设置参考值百分比,因此你在标签上常常看不到糖对应的百分比。这并不代表糖不重要,只是标准设计上没有这一项。
计量单位是第一个坑。多数标签以"每 100 克"或"每 100 毫升"为基准,但也有不少产品以"每份"为基准。一份可以是一小袋、一块、一条,也可以是一瓶的二分之一。当基准是"每份"时,要先看清每份的克数或毫升数,再乘以实际食用份数。一瓶 500 毫升的饮品如果按"每份 250 毫升"标注,你喝完一整瓶,所有数字都要乘 2。
第二个坑是"0 糖"与"低糖"的声称阈值。按照现行标准,固体或液体食品中糖含量不超过每 100 克或每 100 毫升 0.5 克时,可以声称"无糖"或"0 糖";固体食品糖含量不超过每 100 克 5 克、液体食品不超过每 100 毫升 2.5 克时,可以声称"低糖"。这些是含量声称,不是字面意义上的"零"。理解阈值之后,"0 糖"就不该被读成"完全不含任何糖"。
第三个坑是碳水与糖的包含关系。营养成分表中的碳水化合物通常包含了淀粉、膳食纤维和糖。当标签上没有单独标出糖这一项时,可以用碳水化合物减去膳食纤维得到一个粗略的上界,但这个上界往往偏高,因为淀粉通常仍占大头。反过来,如果标签单独列出了"其中:糖",这是最理想的情形,直接用这一行即可。
把标签数字换算成日常参照,会让判断变得直观。一块标准方糖约为 4 克左右,一平勺白砂糖约为 4 到 5 克。因此一瓶标注每 100 毫升含糖 10 克的 500 毫升饮品,总糖约 50 克,大致相当于 12 块方糖。这个换算不追求精确,它的价值在于把抽象克数变成可以想象的画面,从而支撑更清楚的取舍。
专业分析:三层标签解构模型与同类识别框架对比
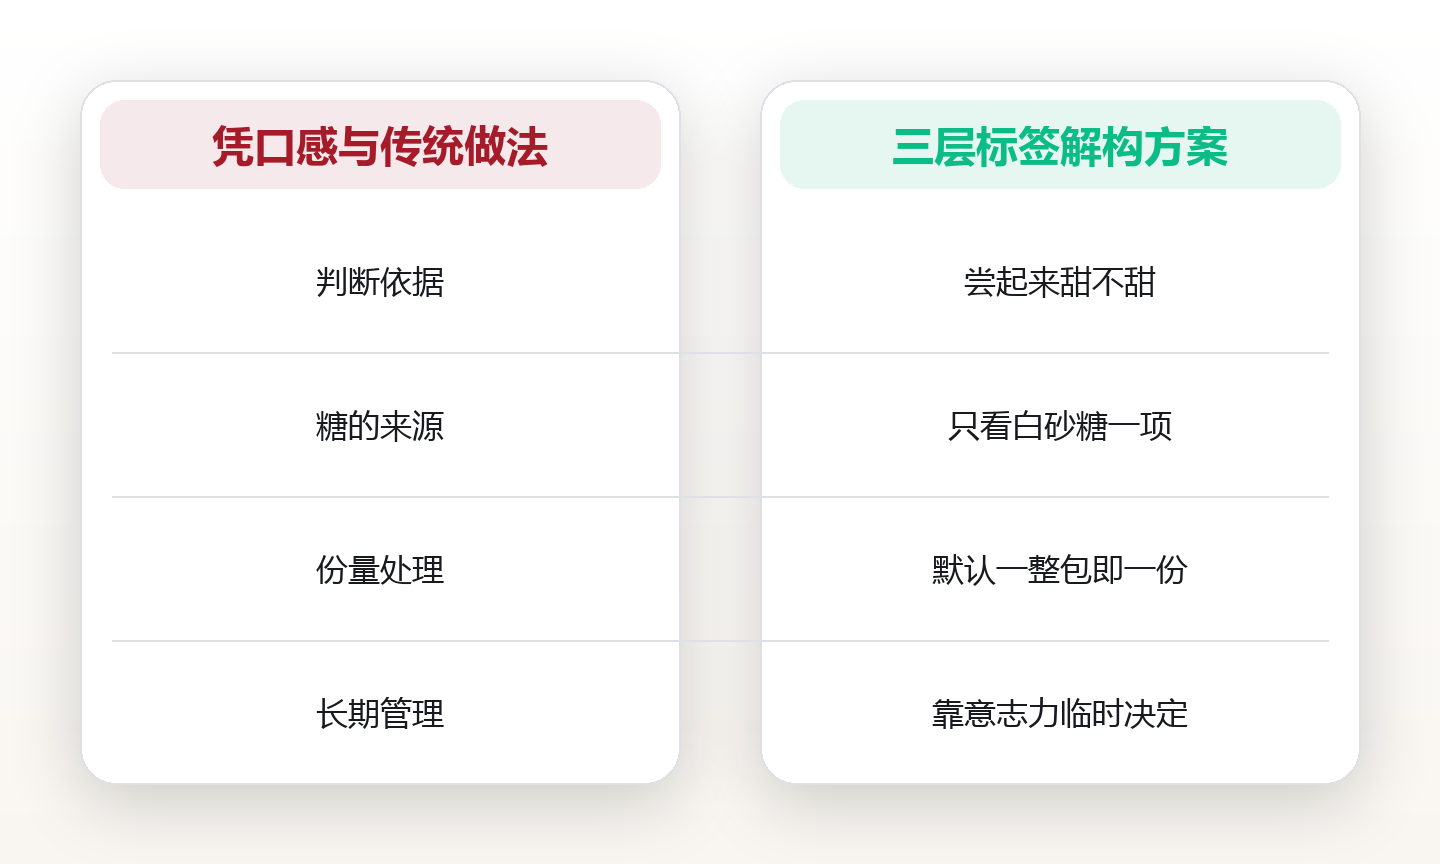
我们提出一个便于执行的识别框架,命名为"三层标签解构模型"(Tier-Label Deconstruction,简称 TLD)。第一层是"总量层",直接从营养成分表读出每 100 克或每 100 毫升的糖含量,并按实际食用量折算为实际克数;第二层是"结构层",把配料表中所有属于前述 27 类别名的成分计数,看总糖是由单一来源构成还是由四五个来源分散构成;第三层是"情境层",考察这份食品在日常饮食中的出现频率与替代难度,即它是一次性消费还是每天都会遇到的固定项。
为什么需要三层而不是只看一层?因为单一指标在真实场景中容易失效。只看总量,会高估那些偶尔食用的高糖食品,低估那些每天食用、单份糖量中等的食品;只看配料别名数量,会遇到麦芽糊精这类低甜度成分造成的误判;只看频率,则无法区分同为每日消费的两款产品谁的负担更大。三层叠加的意义在于把"总量数值""构成方式"和"暴露频率"三个维度同时纳入,形成一个可复核的判断。
作为对照,可以引入国际上广为人知的另一类框架:英国的"红绿灯"包装正面标签体系(Traffic Light Labelling)。它是一种阈值分级法,为脂肪、饱和脂肪、糖和盐分别设定高、中、低三档,并在包装正面用红、黄、绿三色标示。其优势是决策速度极快,消费者不需要计算即可做出粗筛;其局限在于它是基于每 100 克或每 100 毫升固定基准的分级,与实际食用份量的关联较弱,也难以反映糖的多来源构成。据公开行业报告量级描述,这类正面标签在提升消费者粗筛效率方面效果明显,但对份量控制行为的直接影响相对有限。
再引入一个更简易的对照框架:"别名计数法"。它只统计配料表中糖类别名的数量,超过两个即视为高糖风险。这种方法的优点是学习成本几乎为零,缺点是忽略了添加量,容易把添加了微量蜂蜜用于风味平衡的产品误判为高糖。相比之下,TLD 模型用总量层校正了这一偏差,用情境层补足了频率维度,代价是需要多花约 20 到 30 秒的阅读时间。三者的取舍关系可以概括为:红绿灯体系最快、别名计数法最省事、TLD 模型最稳。
下面给出一个可辨识的案例场景。笔者在一家连锁便利店做过一次货架抽样记录:选取早餐相关品类共 42 款产品,涵盖风味酸奶、谷物棒、冲调谷物、果汁饮品和烘焙面包,记录每款的每 100 克或每 100 毫升糖含量与配料表中的糖类别名数量。需要说明,这是自采的便利性样本,不是随机抽样,结果只能用于演示方法,不能外推为市场整体情况。在这批样本中,配料表糖类别名数不超过 1 个的产品里,仍有约四成的每 100 克糖含量超过 15 克;而别名数达到 3 个及以上的产品,其糖含量普遍落在 20 克以上区间。这个结果与"只看别名数量会漏判"的预期一致。
为了让框架可执行,我们给出三项度量指标。第一项是"日均添加糖暴露量",用连续 7 天的记录求平均,单位为克,目标值参考世界卫生组织对游离糖的建议量级,即占每日总能量的 10% 以下,进一步可考虑降至 5% 以下,对应成年人约 25 克量级。第二项是"高糖固定项数量",统计每天或几乎每天都会消费、且单份糖量超过 15 克的品类个数,目标是把这个数字降到 1 以内。第三项是"标签阅读覆盖率",即一周内购买的包装食品中实际读过配料表与糖含量的比例,目标是达到 80% 以上。
分组对照:一次便利店货架抽样的记录
为了让方法更具体,我们把上述抽样中的一个子集展开。选取同一货架上的四款风味酸奶,它们的包装正面分别标示了"0 脂肪""添加果粒""轻盈配方"和"原味"。按 TLD 三层逐条走一遍:先读每 100 克的糖含量,四款分别为 12.1 克、14.6 克、9.8 克和 4.6 克;再数配料表中的糖类别名,分别为 2 个、3 个、2 个和 1 个;最后看消费频率,前三者都是工作日早餐的常客,原味款则更多作为烹饪配料使用。
只看第一层,四款产品都在同一个数量级内,差异不算惊人。但把规格纳入计算后,结论就变了:这四款的单杯规格分别为 200 克、150 克、100 克和 200 克,折算成每杯总糖约为 24.2 克、21.9 克、9.8 克和 9.2 克。也就是说,糖含量最高的那款与最低的那款,单杯糖量相差约 15 克,接近 4 块方糖。而这个差距,从包装正面的宣传语上完全看不出来。
这个对照还揭示了一个容易被忽略的点:小规格不等于低负担。第三款"轻盈配方"因为规格只有 100 克,单杯糖量看起来最低,但如果按口感习惯一次喝两杯,摄入量立刻翻倍。因此 TLD 模型的总量层明确规定,必须按"实际一次的食用量"而不是"包装规格"折算,否则所有小包装产品都会在系统性地低估。
值得强调的是,这次抽样不构成对任何品牌的评价,样本量也远不足以支撑一般性结论。它的价值在于示范:同一品类内部的产品差异,往往大于品类之间的差异。把精力放在"选哪一瓶"上,通常比纠结"要不要喝这个品类"更具操作性,也更容易在短期内看到变化。
一顿早餐的真实糖量:四组典型搭配拆解
现在把镜头移到一顿具体的早餐上。我们设定四组常见的搭配,按公开食品成分数据的常见量级进行估算,并把结果折算成方糖数量。需要说明的是,不同品牌、不同配方的数据差异很大,以下数字用于演示计算方法,具体请以手边产品的标签为准。
搭配一是"风味酸奶 + 谷物脆 + 盒装果汁"。取风味酸奶 200 克、以每 100 克含糖 12 克计,约 24 克;谷物脆 40 克、以每 100 克含糖 20 克计,约 8 克;果汁 250 毫升、以每 100 毫升含糖 9 克计,约 22.5 克。合计约 54.5 克,接近 14 块方糖。这组搭配经常被当作清爽健康的选择,却是四组里糖量最高的一组。
搭配二是"全麦吐司两片 + 花生酱 + 黑咖啡"。吐司按每 100 克含糖 5 克、两片约 70 克计,约 3.5 克;花生酱 15 克、按每 100 克含糖 9 克计,约 1.4 克;黑咖啡不加糖,约 0 克。合计约 5 克,约 1 块方糖。这组搭配的价值不在于"零糖",而在于把糖压到了很低的水平,同时保留了蛋白质和脂肪带来的饱腹感。
搭配三是"即食燕麦片 + 牛奶 + 半根香蕉"。燕麦片 50 克,若为纯燕麦片,糖含量通常在 1 克以下;牛奶 250 毫升,乳糖按每 100 毫升约 4.8 克计,约 12 克;香蕉半根约 60 克,含糖约 7 克。这里要区分口径:牛奶中的乳糖和完整水果中的糖,通常不计入游离糖或添加糖的口径,因此按添加糖计这组约为 1 克以下,按总糖计约 20 克。这正是理解口径差异最直观的例子。
搭配四是"手抓饼 + 甜豆浆 + 一根香肠"。手抓饼约 100 克,含糖量通常在 2 到 4 克区间;甜豆浆 300 毫升,按每 100 毫升含糖 6 克计,约 18 克;加工肉制品约 50 克,可能含 1 到 2 克糖。合计约 22 到 24 克,约 6 块方糖。这组里最容易被忽略的是甜豆浆,它常被视为"咸食配饮",却是整餐糖量的主要贡献者。
把克数变成看得见的东西:分量参照与换算
数字本身很难驱动行为,画面可以。建立分量参照的办法很简单:先固定一个换算单位。可按一块方糖约 4 克计算,也可按一平勺白砂糖约 4 至 5 克计算。之后每次读到克数,直接除以 4,得到一个方糖数量的近似值。这个操作在心里几秒钟就能完成,比记住"多少克算高"要直观得多。
接下来是建立几个个人化的锚点。比如,你常喝的那瓶饮料,算一次就记住它等于几块方糖;你常吃的那款早餐谷物,算一次就记住它的单份糖量。锚点不需要多,五到六个就足以覆盖日常大部分选择。锚点的价值在于,它把每次的判断成本从"重新计算"降到"直接调取"。
第三个技巧是看液体的糖浓度而不是总量。对饮品而言,每 100 毫升含糖超过 10 克通常属于高浓度区间,5 到 10 克属于中等区间,低于 5 克属于较低区间。这个分段法的意义在于,它不受包装大小影响,可以在不同规格之间直接比较。一款 300 毫升、浓度 12 克的饮品,与一款 500 毫升、浓度 7 克的饮品,前者浓度更高但总量相近,选择时就可以按自己的饮用习惯取舍。
最后一个技巧是给"每日预算"留出余量。若以世界卫生组织建议的游离糖量级作为参照,成年人每日约 25 克的进一步目标量级,其实很容易被两三件包装食品用完。因此更实际的做法不是追求每天都不超标,而是把预算集中花在你真正在意的食物上,其余部分尽量选择低糖版本。这种取舍比全面禁止更容易长期维持。
不同人群的摄入参考与典型误区
关于摄入量,公开指引的量级大致一致:世界卫生组织建议游离糖摄入占每日总能量的 10% 以下,并指出进一步降至 5% 以下可能带来额外的健康收益;以成年人约 2000 千卡的能量摄入估算,10% 约相当于 50 克,5% 约相当于 25 克。中国居民膳食相关指引中对添加糖的限量建议也落在相近的量级。这些是人群层面的参考值,不是针对个人的处方。
儿童是需要特别留意的群体。按能量折算,儿童的参考量通常低于成年人,而他们对甜味的偏好又相对更强,加上包装食品和饮料在儿童消费场景中的占比不低,实际摄入容易超出参考量级。对家庭而言,可操作的做法是优先调整饮品结构,因为饮料往往是儿童糖摄入中弹性最大的部分。此处仅作一般性科普提示,儿童的具体膳食安排请咨询专业医疗机构或营养专业人员。
第一个典型误区是"用蜂蜜和红糖替代白砂糖就没事"。从游离糖的口径看,蜂蜜、红糖、黑糖、枫糖浆、椰子花糖都需要计入,它们的矿物质含量相对有限,不足以抵消糖本身带来的摄入量。换句话说,换一种糖来源可以改善风味层次,但不能改变糖的量级。
第二个典型误区是"水果可以随便吃,因为果糖是天然的"。完整水果中的糖通常不计入游离糖口径,这与水果中的膳食纤维、细胞结构和整体的饱腹感有关;但一旦榨成果汁,纤维保留程度下降,饮用速度又快,实际摄入量往往超过直接吃水果。把"吃水果"和"喝果汁"当作两件事来看待,是更贴近实际情况的做法。
第三个典型误区是"只要选无糖食品就能解决问题"。无糖通常意味着用糖醇或高倍甜味剂替代了糖,这对减少糖摄入有帮助,但并不意味着这份食品整体更健康,也不意味着可以无限量食用。部分糖醇在较大摄入量时可能导致一些人的腹部不适。把"无糖"理解为"糖这一项较低",而不是"整体负担较低",判断会清楚很多。
可落地的度量指标与执行清单
第一项指标是日均添加糖暴露量,建议用连续 7 天记录取平均。记录方式可以很轻量:拍下包装背面的营养成分表,或者用备忘录记下品类与克数。7 天的意义在于覆盖工作日与休息日的差异,避免用单日数据下结论。拿到均值后,与 25 克和 50 克这两个量级参照做对比,就能大致定位自己的位置。
第二项指标是高糖固定项数量。把每天或几乎每天都会消费、且单份糖量超过 15 克的品类列出来,逐项评估替代方案。处理顺序建议按"替代成本从低到高"排列:先换那些几乎不影响体验的,比如把风味酸奶换成原味酸奶加新鲜水果;再处理那些需要一段时间适应的,比如把含糖饮料换成无糖茶饮或气泡水。
第三项指标是标签阅读覆盖率。目标设为 80% 以上,衡量方式是一周结束时回看购物记录,看看有多少件包装食品在购买前读过配料表与糖含量。这个指标看似与糖无关,却是前两项能否改善的前提。很多人控糖失败不是因为缺乏意志,而是因为从未在货架前获得过准确信息。
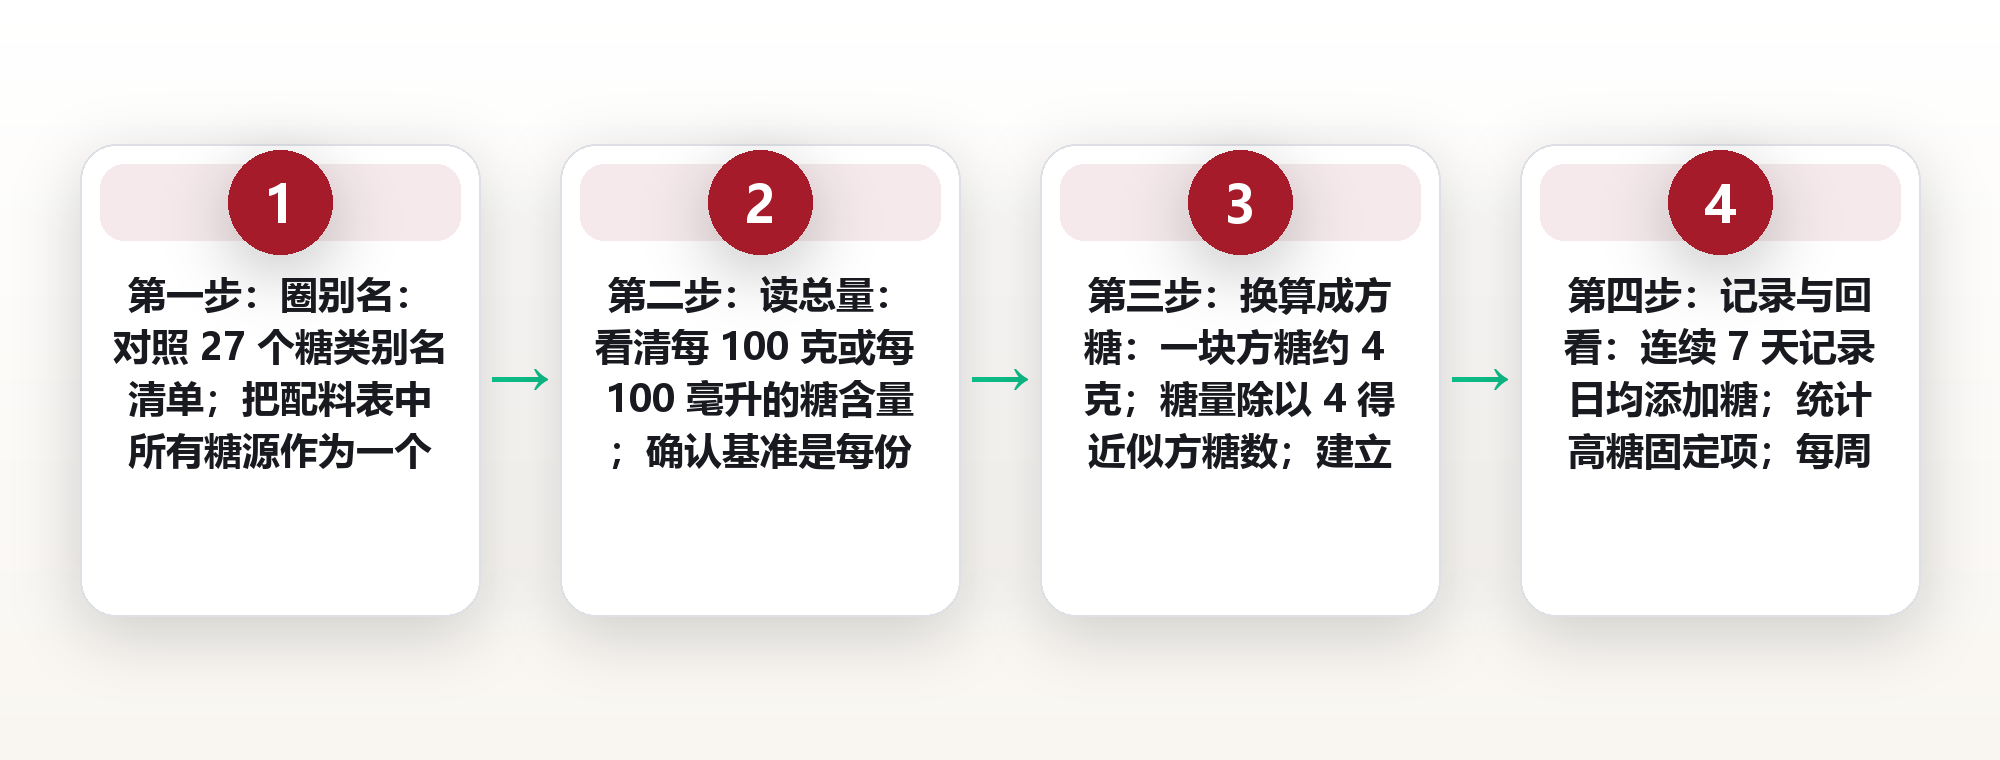
执行清单可以压缩成四步。第一步,把本文的 27 个别名清单存进手机,购物时直接对照;第二步,每次只看两项数据——每 100 克或每 100 毫升的糖含量、以及实际一次的食用量,把两者相乘;第三步,把结果除以 4 换算成方糖数,与自己的锚点做比较;第四步,每周回顾一次三项指标,只调整其中最偏离目标的一项。四步做完大约需要几十秒,长期坚持的门槛不高。
常见问题
1.问:标签上没有"糖"这一行,怎么判断糖含量?可以看碳水化合物一栏,用碳水减去膳食纤维得到一个粗略上界,但要注意这个上界通常偏高,因为淀粉仍占大头。更可靠的办法还是看配料表:如果前几位出现白砂糖、果葡糖浆、麦芽糊精等成分,糖含量一般会比较高。若产品标示了"0 糖"或"低糖"声称,也可以按相应的含量阈值反推大致区间。
2.问:"无蔗糖"等于"无糖"吗?不等于。"无蔗糖"只说明没有使用蔗糖这一类原料,产品中仍然可能含有葡萄糖、麦芽糖浆、蜂蜜、浓缩果汁等其它糖来源。判断是否低糖,要看营养成分表中的糖含量,或者看配料表里是否出现本文列出的 27 个糖类别名。这是货架上最常见的混淆点之一。
3.问:蜂蜜、红糖、枫糖浆算不算添加糖?在游离糖的口径下,它们通常都需要计入。它们的矿物质和风味物质含量相对有限,不足以改变糖本身的量级。可以把它们理解为"风味更好的糖",而不是"不算糖的糖"。如果目标是控制糖摄入,这些来源同样需要纳入记录。
4.问:果汁和完整水果的糖有什么区别?主要区别在于基质和摄入速度。完整水果中的糖被细胞结构包裹,同时伴随膳食纤维,通常不计入游离糖口径;榨汁后结构被破坏,纤维保留程度下降,饮用量又容易偏大,因此果汁中的糖一般计入游离糖。简单记法:能吃完整水果时优先吃完整的,喝果汁时把它的糖量计入当日预算。
5.问:糖醇和甜味剂需要和糖一样警惕吗?它们不属于本文列出的 27 个糖类别名,通常不按添加糖的口径计量,因此在控糖时优先级较低。但糖醇在较大摄入量时可能让部分人出现腹部不适,高倍甜味剂则涉及各自的使用规定与适宜人群。实际建议是:先看糖,再看甜味剂种类,两者都不过量。
图片来源:图1 Rianne_SchillerMclean / Pixabay (CC0) · 图2 Couleur / Pixabay (CC0) · 图3 TruongDinhAnh / Pixabay (CC0) · 图4 MartinHarry / Pixabay (CC0) · 图5 PeterDargatz / Pixabay (CC0) · 图6 Kranich17 / Pixabay (CC0) · 图7 freephotocc / Pixabay (CC0) · 图8 Couleur / Pixabay (CC0) · 图9 pasja1000 / Pixabay (CC0) · 图10 feelphotoz / Pixabay (CC0) · 图11 Couleur / Pixabay (CC0) · 图12 Hans / Pixabay (CC0) · 图13 monicore / Pixabay (CC0) · 图14 RemazteredStudio / Pixabay (CC0) · 图15 Pexels / Pixabay (CC0) · 图16 congerdesign / Pixabay (CC0) · 图17 jarmoluk / Pixabay (CC0) · 图18 MonicaVolpin / Pixabay (CC0) · 图19 romansolar / Pixabay (CC0) · 图20 Firmbee / Pixabay (CC0) · 图21 Pexels / Pixabay (CC0) · 图22 Maikolaquino / Pixabay (CC0) · 图23 Ralphs_Fotos / Pixabay (CC0) · 图24 stevepb / Pixabay (CC0) · 图25 Jmtd / Pixabay (CC0) · 图26 AlLes / Pixabay (CC0) · 图27 zivica / Pixabay (CC0) · 图28 modernseoul / Pixabay (CC0) · 图29 femava / Pixabay (CC0) · 图30 cocoparisienne / Pixabay (CC0) · 图31 coyot / Pixabay (CC0) · 图32 Peggy_Marco / Pixabay (CC0) · 图33 Jmtd / Pixabay (CC0) · 图34 stevepb / Pixabay (CC0) · 图35 DEZALB / Pixabay (CC0) · 图36 Mrdidg / Pixabay (CC0) · 图37 allybally4b / Pixabay (CC0) · 图38 Robert_C / Pixabay (CC0) · 图39 fatherfab / Pixabay (CC0) · 图40 Pexels / Pixabay (CC0) · 图41 MiraCosic / Pixabay (CC0) · 图42 Dimhou / Pixabay (CC0) · 图43 MiraCosic / Pixabay (CC0) · 图44 focusonpc / Pixabay (CC0)
本文为健康科普信息,仅供参考,不构成医疗建议;如有健康问题请咨询专业医疗机构。
文中涉及的标准阈值与摄入参考值均为人群层面的公开指引量级,不能替代营养专业人员或医生对个人情况的评估。
文中货架抽样为便利性样本,仅用于演示方法,不代表市场整体情况,也不构成对任何品牌的评价。
评论(0)