
基本信息
阅读时间:约 14 分钟
字数:约 5437 字
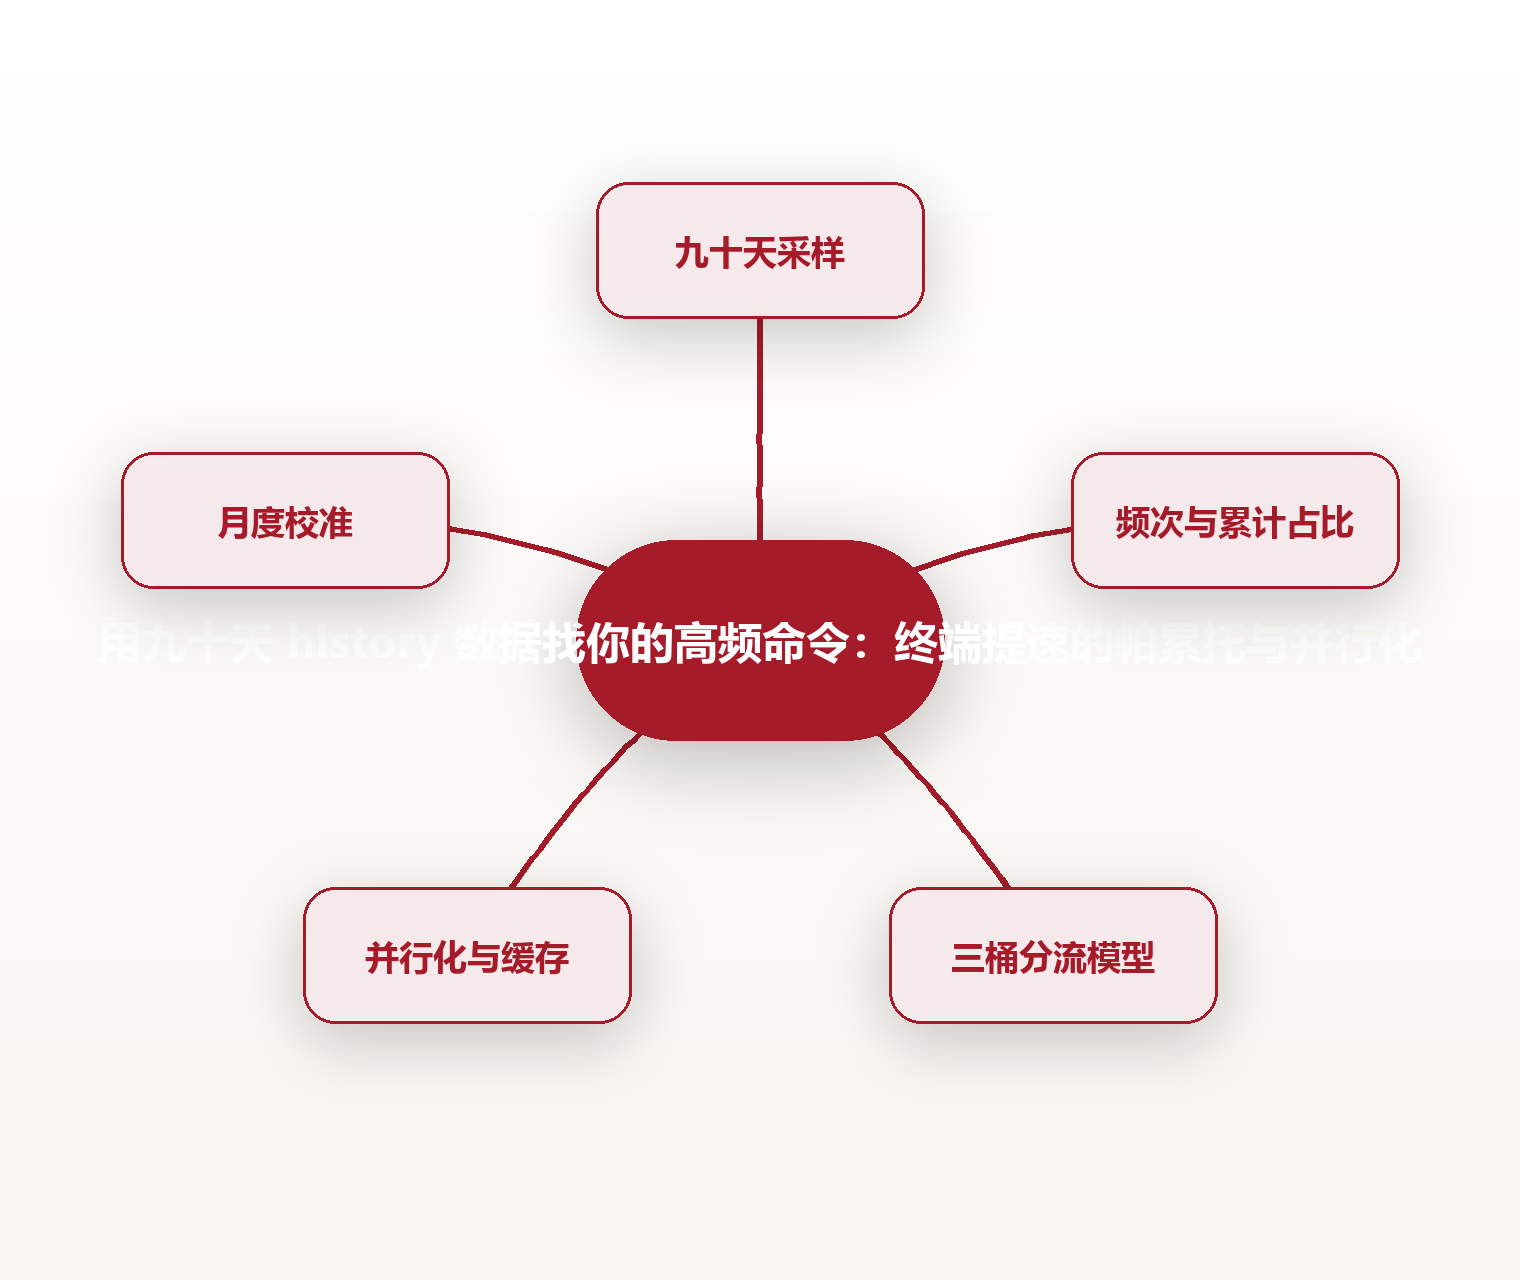
摘要:凭手感挑命令,往往挑错对象。本文用一个工程师九十天的一万两千条终端日志,给出四条分析命令、帕累托曲线与三桶分流模型,并拆解并行化与缓存的收益上限、四组度量指标和六步执行清单。
全文语音
中文
English
日本語
한국어
周四晚上十一点,一块被写满的 history 文件
杭州滨江,一间六十平米的公寓,靠窗那张一米四的升降桌上并排摆着两台显示器。晚上十一点零七分,空调外机在窗外嗡嗡地响,36 岁的数据平台工程师邵珩刚把一台跑了三年的开发机换掉。旧机器上唯一没能顺利迁过来的东西,是家目录下那个被写满的 history 文件。
「我不是舍不得那台机器,我是舍不得那一堆记录。」他把旧硬盘接到扩展坞上,用 wc -l 数了三遍:94113 行。三年前刚开始用终端的时候,他一天敲不到四十条命令;而最近这九十天,平均每天一百四十三条。
他做了一件在旁人看来很奇怪的事:不着急装新机器上的工具链,先把这九万多行倒进一个临时目录,用 awk 按时间切成九十天一段,一段一段地统计。第一天跑出来的表就让他愣住了——在此之前,他一直以为自己最费时间的是 docker compose up,因为每一次都要眼睁睁等上好几分钟。
可频次表讲的不是这个故事。排在第一位的是 ls,九十天里出现了 2116 次;第二位是 cd,1873 次;第三位才是 git,按子命令拆开之后 git status 独占 921 次。而真正吞掉他时间的,是另一批出现次数中等、但单次特别慢的命令,它们从来不在他的直觉清单上。
这个反差,就是本文要拆开的全部内容:为什么「我以为最慢的那批」和「数据里最贵的那批」从来不是同一批命令,以及拿到这张表之后,到底该往哪三处下手,顺序又该怎么排。
凭手感挑命令,为什么总是挑错
人对自己行为的记忆,是靠显著事件编码的,不是靠频次编码的。一次等了四分钟的构建,会在记忆里留下清晰的时长、姿势和情绪;而一天敲六十次的 ls,每次零点二秒,从来不会在大脑里留下任何痕迹。于是记忆给出的排序,天然偏向单次很慢的动作,并系统性地低估高频但很快的动作。
这就是可得性偏差在命令行上的具体形态。邵珩一开始凭手感列出来的清单是三样:docker compose、go build、pip install。这三样确实慢,一次几十秒到几分钟不等。可把它们全部加在一起,九十天里只被执行了 214 次,累计占用大约五小时四十分钟。
而 ls、cd、git status、vim 这四条,加起来被执行了五千七百多次。就算按每次零点六秒的保守口径估算,光是敲命令加等返回的手续费就是五十七分钟,这还不包括每次执行完之后他重新找回上下文的时间——那部分往往比命令本身更贵。
更麻烦的是,这两类命令的优化手段完全不同,用错方法就只能白费力气。慢命令要靠并行化与缓存去压缩单次墙钟时间;快命令要靠缩短输入长度、减少来回次数去压缩边际成本。拿对付构建的办法去对付 ls,一天下来省不到五秒钟。
所以第一件事不是动手改,而是把手感换成一本账。这本账必须同时看得见两个维度:一共出现过多少次,以及每一次花掉多久。只按其中一个维度排序,都会把你引到错误的地方去改错误的命令。
九十天数据怎么取:四条分析命令与它们的坑
默认配置下的 history 只有命令、没有时间戳,做不了任何时段分析。第一步得让 shell 把时间写进去:在家目录的 shell 配置里加上 export HISTTIMEFORMAT='%F %T ',再把 HISTSIZE 与 HISTFILESIZE 都设成 -1 取消条数上限,并用 shopt -s histappend 避免多个终端互相覆盖。
改完之后,history 的每一行会变成「序号 + 日期 + 时间 + 命令」四个字段。取首词做频次统计的基本写法是:history | awk '{print $4}' | sort | uniq -c | sort -rn | head -30。这里取第四列而不是第二列,正是因为前面多了两个时间字段;如果没有设 HISTTIMEFORMAT,同一条管道要改成取第二列。
只统计首词会漏掉一个很关键的层次:git status 和 git log 都会被归到 git 名下,但它们其实是两种完全不同的动作。想要两层粒度,就多取一列:history | awk '{print $4, $5}' | sort | uniq -c | sort -rn | head -40。这条对 git、docker、kubectl 这类带子命令的工具尤其有用,子命令层往往才是真正该优化的地方。
第三条命令用来算累计占比,也就是帕累托曲线本身:把首词统计的结果再接一层 awk,累加第一列并输出累计条数与累计百分比。看第几行越过百分之八十,那里就是你的帕累托拐点。邵珩的表上,拐点出现在第十二个命令附近——也就是说,他日常真正在用的命令,稳定在十来个。
第四条命令用来看时段分布:把时间字段按小时切出来计数。他跑出来的形状是两个明显的峰,上午十点和下午三点;晚上八点以后命令条数骤降,但平均耗时反而变长——那段不是他在敲命令,是他在等构建。这条曲线的实际用处,是决定并行化该加在哪一时段、缓存该预热在哪一时段。
三个坑必须提前说清楚。第一,history 只记录在交互 shell 里敲过的命令,写在脚本里的不算,因此它会低估那些已经被自动化掉的环节。第二,不小心带过令牌或口令的行会一起被写进去,统计前最好先脱敏再归档。第三,成功与失败混在一起统计,会掩盖反复重试的开销;要单独看,可以在 PROMPT_COMMAND 里把上一条命令的退出码一并记进日志。
专业分析:命令耗时的帕累托结构与三桶分流模型
先把数据规模交代清楚,避免被当成实证结论误读:以下为邵珩自建采样的示例数据,来源类型是个人终端日志而非公开统计,样本为九十天共 12847 条交互命令,覆盖 41 个不同的首词命令,采集方式就是上一节那四条命令。这里的数字,量级比精确值更有参考意义。
分布长这样:前五个命令占 52.3%,前十二个占 71.6%,前二十个占 84.1%,剩下的二十一个命令合计只占 15.9%。这是一条相当标准的帕累托曲线——八二法则作为经验法则,在命令行场景里同样成立,甚至还要更陡一些。换句话说,把精力平均摊到四十一个命令上,是效率最低的一种做法。
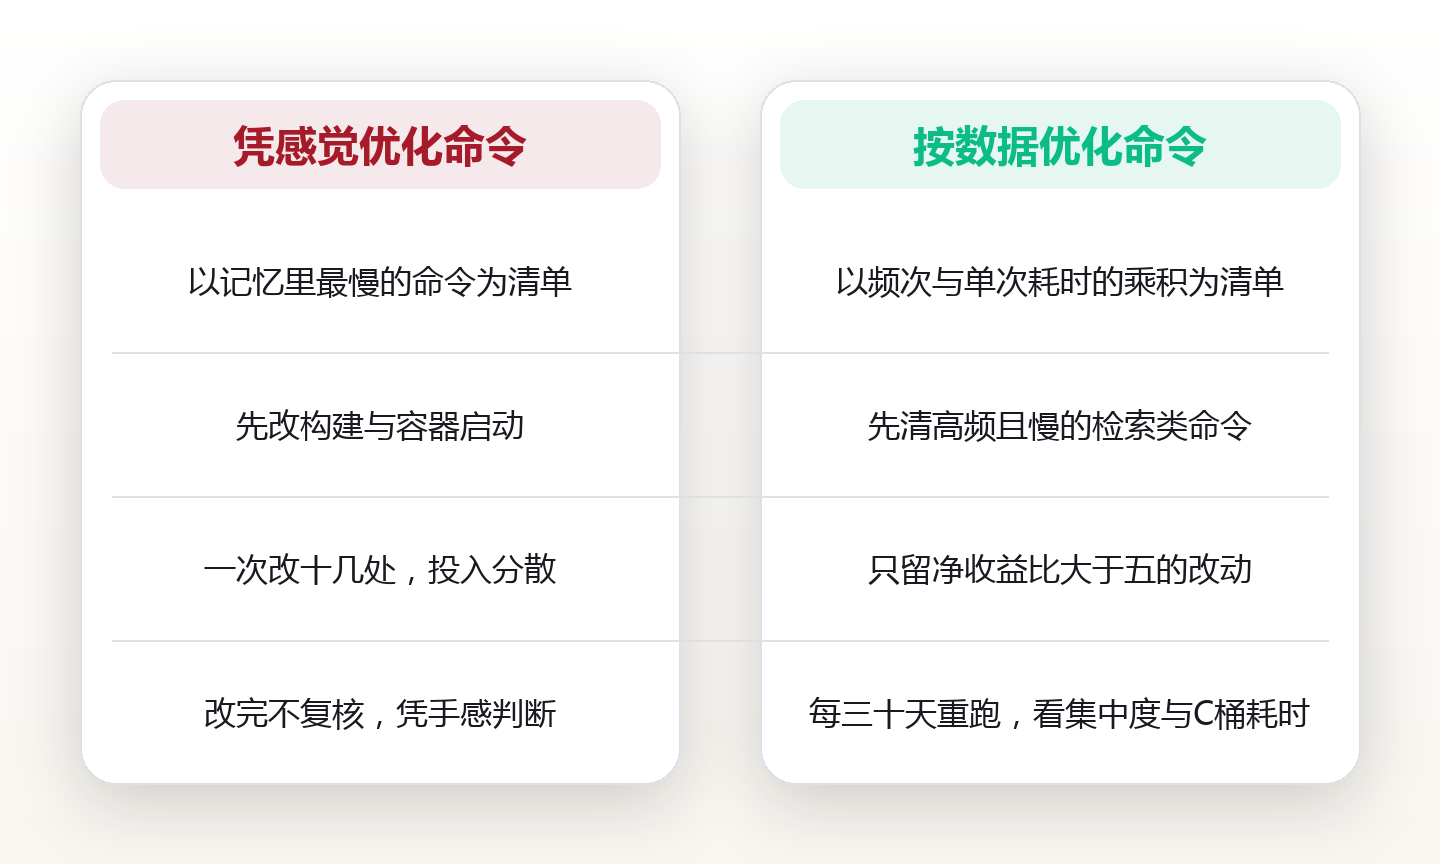
但只按频次排序,会掉进上一节说的那个陷阱:频次高不等于总耗时高。这里给出本文的命名框架——三桶分流模型:把每个命令按频次与单次墙钟耗时两个轴打分,落进三个桶。A 桶是高频且快,比如 ls、cd、git status,优化手段是缩短输入与合并步骤;B 桶是低频但慢,比如构建、容器启动、依赖安装,优化手段是并行化与缓存;C 桶是高频且慢,比如大仓库里的全量检索,这是真正的金矿,也是最容易被忽略的一桶,优化手段是换更快的工具加索引。
与它对照的是另一种更常见的做法——纯频次排序法,也就是把上一节第一条命令的输出直接当成优化清单,从第一名开始一路往下改。两者的差别很实在:纯频次排序会把你牢牢按在 A 桶上,因为 A 桶天然占据榜单前排;可 A 桶的单次成本只有零点二到一秒,就算压缩掉一半,一天省下来的也是几十秒的量级。三桶分流会先把 C 桶挑出来。邵珩的数据里 C 桶只有三个命令:换工具之前的递归 grep、仓库内的 find、以及带时间范围参数的 git log,九十天共 1309 次,累计四小时十二分——比 A 桶全部加起来还多。
案例落到具体动作上。C 桶里那个递归 grep 换成 ripgrep 之后,同一个仓库的全量检索从 6.8 秒降到 0.9 秒;find 换成 fd 之后,从 2.4 秒降到 0.3 秒。这两处改动他花了不到二十分钟,按九十天折算下来省掉约两小时五十分钟。换工具之所以能带来量级差异,是因为它们默认并行遍历目录树、自动跳过版本忽略文件里声明的路径,并且不做不必要的回溯匹配。
度量指标给四组,用来判断优化到底有没有真的生效。一是集中度 CR10,即前十个命令占总条数的比例,帕累托式优化之后它应该上升,说明动作更集中而不是更散。二是 C 桶累计耗时,按周统计,这是本文最关注的一项。三是日均命令条数,下降说明合并动作生效了,反常上升则要查是不是在做无效重试。四是失败重试率,用上一节的退出码日志来算,定义为同一命令在六十秒内重复出现且退出码非零的比例。
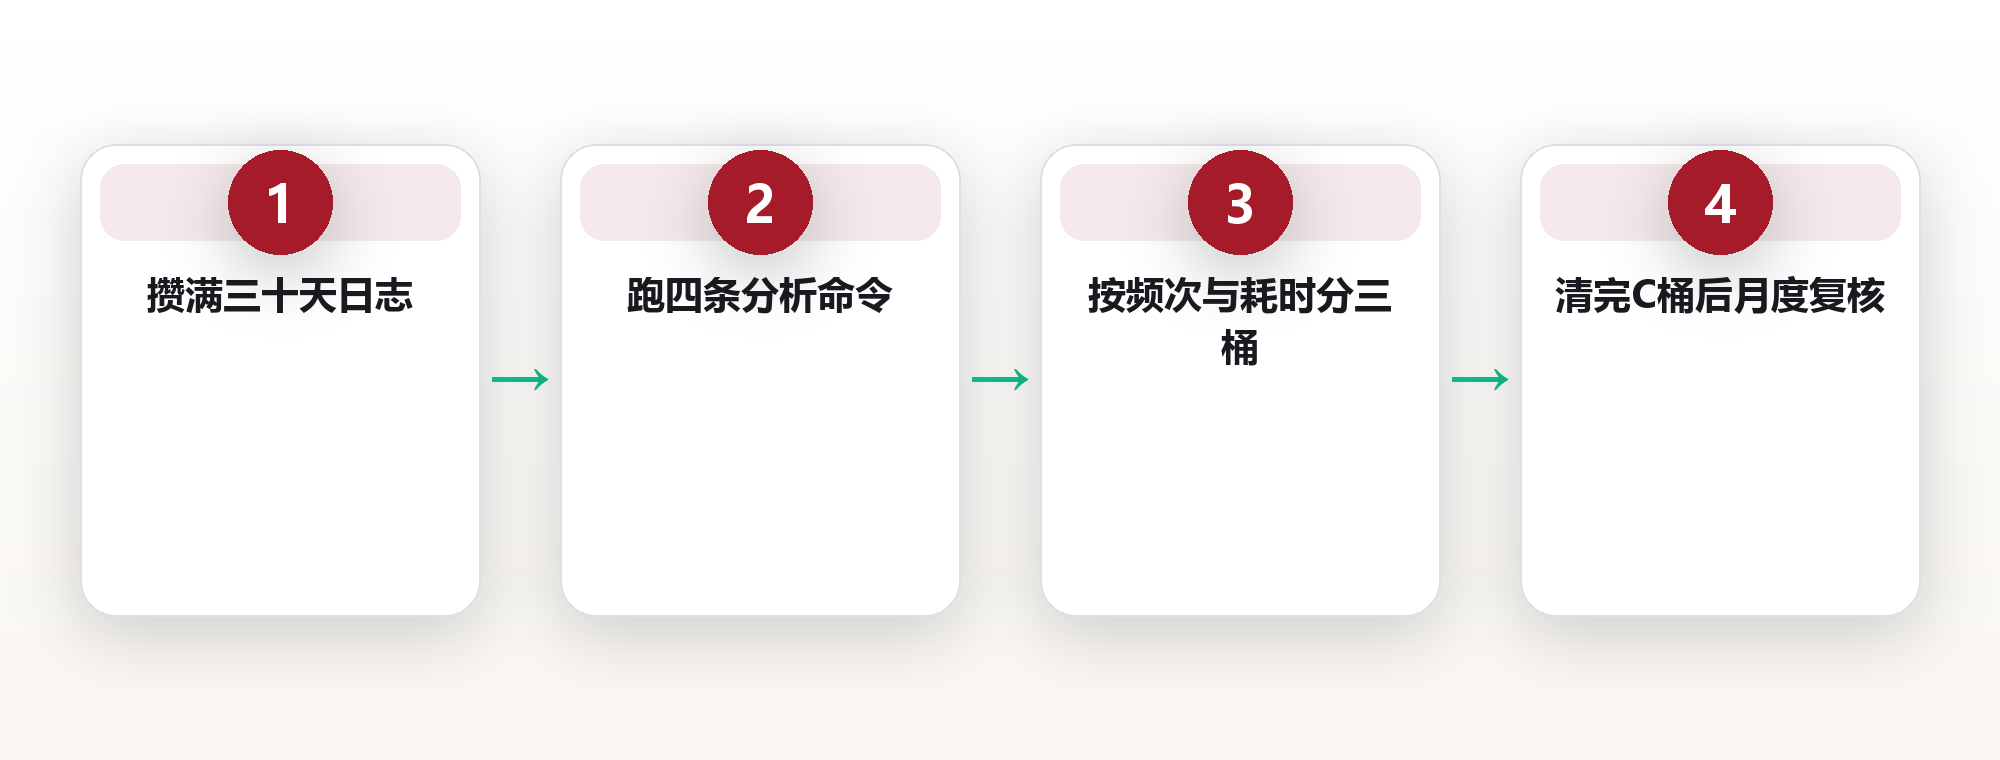
执行清单六步。一,设好时间格式并取消条数上限,先攒满三十天再动刀。二,跑四条分析命令,导出频次表与时段表。三,按频次与单次耗时把命令分进 A、B、C 三个桶。四,只优先处理 C 桶,投入顺序按频次与单次耗时的乘积从大到小排。五,C 桶清空之后,再回头用别名与目录跳转工具处理 A 桶。六,每三十天重跑一次,观察集中度与 C 桶耗时的变化方向。
并行化:把串行等待换成并发吞吐
并行化的前提是任务之间没有依赖。终端里绝大多数批量动作天然满足这一点:批量压缩日志、批量转码、批量拉取远端仓库、批量跑静态扫描。判断方法也很简单——如果这些任务的执行顺序可以任意打乱而结果不变,那就可以并发;只要存在前后依赖或共享写,就得先拆开。
最轻量的工具是 xargs 的 -P 参数:ls *.log | xargs -P 8 -I{} sh -c 'gzip -9 "{}"'。这里的 -P 8 表示同时跑八个进程。邵珩在一台八核开发机上把两百四十个日志文件做压缩,串行耗时三分十二秒,改成 -P 8 之后是四十一秒,加速比约四点七倍。要注意的是 -I{} 后面那段 sh -c 必须正确加引号,否则带空格的文件名会被拆成两个参数。
需要更细的控制时用 GNU parallel:parallel -j 8 --eta gzip -9 ::: *.log。它比 xargs -P 多出三样东西——进度估计、把每个任务的成败写进日志文件的 --joblog,以及只重跑上次失败任务的 --resume。对一次要跑几十分钟的批处理来说,这三样能省掉整段的重复执行时间,而不是只省下正常跑完的那一次。
并发度不是越高越好。CPU 密集型的任务,并发度贴近核数就够了,再往上加只会徒增上下文切换;I/O 密集型的任务,比如批量拉远端资源,可以适当超发到核数的两到三倍。一个稳妥的起点是 nproc 命令的输出值,跑一次计时,再往上调一档看是否还变快,变快就留,不变就退回。
输出顺序是没有保证的,这是并行化最常见的踩坑点。需要保序时给 parallel 加 -k 参数,或者让每个任务写进自己的临时文件,最后按文件名排序再合并。另一类坑是共享写:多个进程同时往同一个日志追加内容,会造成行与行交错,正确做法是各写各的、跑完统一合并,而不是抢同一个文件句柄。
还有一味容易被忘掉的药:把等待本身从主流程里挪走。构建、同步、批量导出这类动作,如果不需要立刻看结果,就挂到后台并在完成时通知自己,比盯着进度条更符合深度工作的节奏。这样省下来的不只是墙钟时间,还有一次次被拉走的注意力——后者通常比前者贵得多。
缓存:让第二次几乎不花时间
缓存的思路和并行化是正交的:并行化压缩的是单次执行的墙钟时间,缓存压缩的是执行次数。判断一条命令值不值得上缓存,只看一件事——同样的输入,在短期内会不会重复出现。会,就值得;不会,上了也白上。
编译类最典型。ccache 与 sccache 会把编译产物按源文件的哈希存起来,命中时直接返回产物,未命中时才真正编译。它们不是某一种语言的专属,只要走标准编译器的流程都能挂上去。命中率是最直接的观察指标,一条 ccache -s 就能看到缓存命中率这一项,稳定在百分之六十以上,通常意味着收益已经超过维护成本。
依赖安装同样适合。容器构建里把依赖层与代码层分开,代码改了只有代码层重建,依赖层直接命中缓存;包管理器一侧则开启本地缓存目录,并把它放在持久卷上,换机器时不至于从头下载一遍。这里的关键不是单纯的快,而是避免把时间花在那些根本没有变化的输入上。
检索类可以自建一层轻量缓存。把一次全量检索的结果落进一个带时间戳的索引文件,只在源码目录里存在比它更新的文件时才重跑——一句 find src -newer .idx 就能判断是否需要重建。邵珩用这个办法,把一个每天要跑十几次的项目级检索,变成每天只在首次触发时真正执行一次。
缓存的代价是失效。任何缓存都必须回答一个问题:什么时候它不再正确。答不上来的缓存,比没有缓存更危险,因为你会拿着过期的检索结果去做判断,而且毫不知情。一条实用规则是:给每份缓存写上生成时间与来源命令,过期阈值按来源的变化频率来定,变化快的数据源宁可只缓存五分钟,也不要图省事缓存一整天。
四条提速路径的收益上限与代价
把手段归拢一下,终端提速其实只有四条路径,各有各的天花板。缩短输入,包括别名、目录跳转工具、模糊查找器,单次省零点五到三秒,靠频次乘出来,天花板是每天几分钟这个量级。换更快的工具,也就是 C 桶那一类,单次省一到十秒,是四条里投入产出比最高的一条。
并行化对可并行的批处理,加速比通常落在核数的零点五到零点九倍之间,任务数越多、单任务耗时越均匀,就越接近上限。缓存则完全由命中率决定,命中率八成就相当于把这类命令的执行次数砍到五分之一,但它只对重复输入有效,对每次输入都变的任务毫无作用。
代价同样要算进去。别名与自定义函数会抬高换机器的成本,因为它们往往不在版本控制里,新环境要重新配一遍;更快的外部工具要装、要更新、还要求在别人的机器上也有;并行化会让输出乱序、让错误定位变难;缓存则要求你写清楚失效规则。每一项收益背后,都挂着一串维护事项。
所以排序要按净收益而不是毛收益。一个粗略但好用的判据:预计一年节省的小时数,除以维护投入的小时数,比值大于五才值得做,小于二还不如不动。按这个口径,邵珩最终只保留了六项改动,砍掉了原本打算做的十一项——被砍掉的,多半是 A 桶里那些每次省一秒、但一年也省不回半小时的微调。
三十天后的三个数字与校准节奏
三十天后他重跑了同一套命令。第一个数字:日均命令条数从一百四十三降到一百一十八,降幅百分之十七,主要来自目录跳转与状态查看这两类动作的合并。第二个数字:C 桶累计耗时从每周三十九分钟降到每周十一分钟,降幅百分之七十二。第三个数字:集中度 CR10 从 71.6% 升到 76.9%,说明他的动作变得更集中了。
变化并不是线性的。头七天几乎看不出差别,因为新工具的肌肉记忆还没建立起来,他有一半时间还在下意识敲旧命令;第十天之后曲线才开始稳定向下。这个滞后很重要——如果在第一周就急着下结论,很容易把它误判成没用,然后把一件正确的事半途放下。
校准节奏建议按月来。每月固定一天跑一次那四条分析命令,把频次表、时段表、C 桶耗时这三个结果存进同一个文件,和上个月并排看。要看趋势而不是看单点,尤其要盯有没有新的命令悄悄爬进 C 桶——那通常意味着工作负载变了,比如接手了一个更大的仓库,或者开始频繁处理二进制资源。
「我以前以为效率就是把命令敲得更快。」他把那块旧硬盘收进抽屉的时候说,「后来才知道,效率是先弄清楚自己到底在敲什么。」这句话他抄在工位隔板的一张便签上,就压在那只玻璃杯留下的圆形水渍旁边。
常见问题
1.问:history 里的命令太杂,统计出来全是噪声怎么办?答:先做两层过滤。第一层按首词归组,只看前三十个,长尾直接忽略,它们对总耗时的贡献通常不足百分之五。第二层把查看类命令单独归为一类,比如 ls、cat、head、tail 这类,它们的高频属于正常浏览行为,不代表存在优化空间。过滤后剩下的才是候选清单。如果还是杂,说明统计窗口里混了多种工作负载,那就把九十天按项目或按目录拆成几段分别统计。
2.问:并行化之后任务报错,怎么知道是哪个失败了?答:用 GNU parallel 的 --joblog 参数,把每个任务的序号、开始时间、耗时与退出码写进一个文件,跑完用一条 awk 把退出码非零的行挑出来即可。如果用的是 xargs -P,它没有这个能力,可以让每个任务把自身标识写进一个单独的错误文件。更省事的做法是让每个任务输出到独立的结果文件,事后按文件大小或退出码批量筛一遍。
3.问:缓存命中率一直上不去,是什么原因?答:常见的有三个。一是缓存键里包含了时间戳或绝对路径,导致每次输入都不同,自然命中不了,应该把键改成只依赖真正影响结果的内容。二是缓存目录被清理或没有持久化,在容器里尤其常见,需要挂到持久卷上。三是输入本身就每次都变,这种情况下缓存根本不适用,应该改看并行化或者换更快的工具。先用一次手工统计确认同一输入一天内出现的次数,再决定要不要上缓存。
4.问:我同时开着好几个终端,history 会不会漏记?答:会,而且这是默认行为。每个 shell 在退出时才把内存里的历史写回文件,后退出的会覆盖先退出的那一份。解决办法是用 shopt -s histappend 允许追加,再配一条 PROMPT_COMMAND,让每条命令执行后立即追加到文件并从文件读回新内容,多个终端之间就能基本保持同步。
5.问:换机器之后,这套分析和这些改动还能用吗?答:分析命令本身只依赖 shell 的内置能力,换机器可以直接跑。真正需要迁移的是配置与工具,建议把 shell 配置、别名文件、工具清单放进一个版本库,新机器克隆之后一条命令装载完成。另外提醒一点:不同机器上的历史文件是分开的,跨机器做汇总统计时记得先合并再去重,否则同一条命令会被重复计数,把频次表整体抬高一截。
图片来源:图1 danielkirsch / Pixabay (CC0) · 图2 FotoKacper / Pixabay (CC0) · 图3 Pexels / Pixabay (CC0) · 图4 JuergenPM / Pixabay (CC0) · 图5 ATDSPHOTO / Pixabay (CC0) · 图6 WOKANDAPIX / Pixabay (CC0) · 图7 Mbragion / Pixabay (CC0) · 图8 sweetlouise / Pixabay (CC0) · 图9 jplenio / Pixabay (CC0) · 图10 jarmoluk / Pixabay (CC0) · 图11 wal_172619 / Pixabay (CC0) · 图12 3844328 / Pixabay (CC0) · 图13 jarmoluk / Pixabay (CC0) · 图14 MonicaVolpin / Pixabay (CC0) · 图15 geralt / Pixabay (CC0) · 图16 romansolar / Pixabay (CC0) · 图17 johnNaturePhotos / Pixabay (CC0) · 图18 moerschy / Pixabay (CC0) · 图19 planet_fox / Pixabay (CC0) · 图20 TheUjulala / Pixabay (CC0) · 图21 stevepb / Pixabay (CC0) · 图22 TMteaching / Pixabay (CC0) · 图23 kenny / Pixabay (CC0) · 图24 erikharberg / Pixabay (CC0) · 图25 SoyKhaler / Pixabay (CC0) · 图26 Pexels / Pixabay (CC0) · 图27 Ludo-Photos / Pixabay (CC0) · 图28 Tama66 / Pixabay (CC0) · 图29 Pok_Rie / Pixabay (CC0) · 图30 dimitrisvetsikas1969 / Pixabay (CC0) · 图31 analogicus / Pixabay (CC0) · 图32 TMDaub / Pixabay (CC0) · 图33 MiraCosic / Pixabay (CC0) · 图34 Dimhou / Pixabay (CC0) · 图35 MiraCosic / Pixabay (CC0) · 图36 focusonpc / Pixabay (CC0)
本文为认知与方法论科普,不构成任何投资建议。
评论(0)