
基本信息
阅读时间:约 17 分钟
字数:约 6830 字
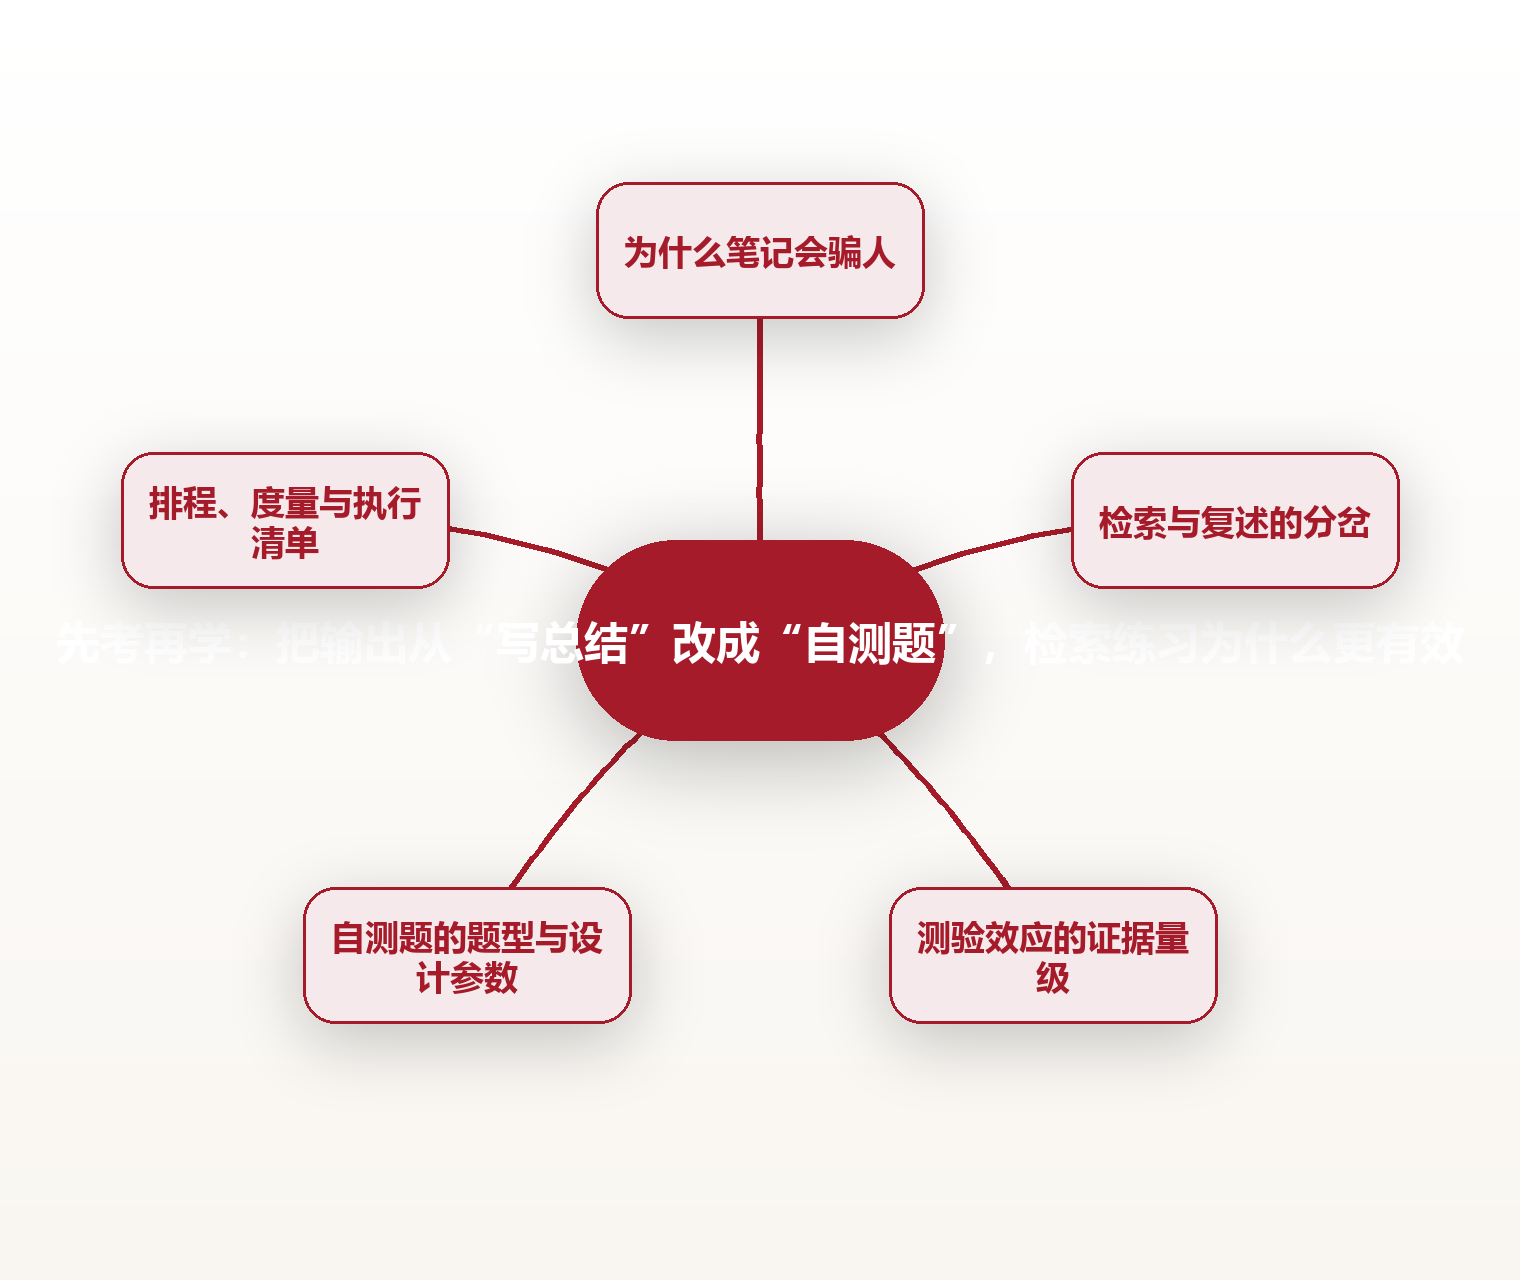
摘要:重复阅读只增加熟悉感,合上书自测才加固检索通路。本文用测验效应的文献证据、Q-R-R-R 先问后读排程、五种自测题型与四个度量指标,说明把笔记总结改写成题库的具体做法。
全文语音
中文
English
日本語
한국어
二十七万字笔记,开口却卡在第一句
林知远,31 岁,在南京一家医疗器械公司做临床数据管理员。去年十月,主管让他给新同事讲一遍数据核查的二十三条红线。他从抽屉里翻出那本两年零七个月、写满四百多页的活页本——划线的地方比没划的地方还多——然后抱着它站到了会议室的白板前。他当时的判断是:这二十三条,我闭着眼都能顺下来。
真正开口的那三十秒他记得很清楚。"第七条第三款,我一张嘴就停住了,"他后来这么讲,"脑子里有一幅特别清楚的画面,我知道它在哪一页、旁边还画了个红圈,但就是拼不出那句话。我甚至在想要不要用'那个什么'把它糊过去。"二十三条里,他当场说完整的只有九条,剩下十四条,全部停在了半句上。
那本笔记没有骗他。四百多页确实是被认真读过、抄过、整理过的,问题出在编写方式——它一直是"把别人的话搬到自己的本子上"。搬的过程中,大脑做的是再认和抄写,不是提取。等到站在台上必须不看本子复述时,两年零七个月的输入,才发现几乎没有经过一次真正的输出。
转折发生在一个很小的动作上。同事提醒他,下次读完一章先合上书,把这一章能问出口的问题写在便签上,答完再去对照原文。他照做了四周:二十三条红线被改写成 46 道题,每天下班地铁上答 6 道。第四次复述的时候,他说完整了 19 条。他的原话是:"我第一次觉得,笔记不是为了收着好看,是为了被翻出来用。"
写总结和出题目,看起来都是输出,方向其实是相反的。总结是把已经看到的材料再整理一遍,成本发生在输入侧;自测题是先把答案挡住,逼自己从内部调用一次,成本发生在调用侧。前者让你对材料更熟,后者让你长出能被随时调用的能力。这两件事经常被混为一谈,但它们从来不是一回事。
看得懂和说得出之间,隔着一条叫检索的河
几乎所有被"学过"骗过的人,都踩在同一块踏板上:翻开书,每一行都认识,每个结论都显得理所当然,于是大脑把这种顺利的感觉读成了"我已经会了"。认知心理学把这种误判叫流畅性错觉——材料处理起来越顺滑,我们越容易高估自己的掌握程度,而顺滑本身可能只是因为信息刚刚还在眼前。
要解释这种现象,最常被引用的是比约克夫妇提出的双强度框架。他们把记忆拆成两条线的乘积:一条是存储强度,指痕迹在记忆系统里扎得多深;另一条是提取强度,指此刻能不能把它调出来。这两条线并不总是同向。反复阅读主要增加的是熟悉感,也就是让再次看到时更好认;而只有主动回忆,才是在真正加固那条从线索到答案的路。
这个差别不是现代才被发现的。早在 1917 年,盖茨就做过一组关于时间分配的实验:让学习者读一段材料,然后改变"出声背诵"在总时间里占的比例。结果是,用于背诵的时间占比越高,之后的回忆成绩越好,而且不同年龄段都有这个倾向。换句话说,把手上的时间从"再看一遍"挪一部分给"试着说一遍",收益最早在一个世纪前就被记录下来了。
代价在于体感。主动回忆的过程是不顺的,会卡顿、会脸热、会想不起来。比约克把这类当下费力、长期有利的条件称作"合意的困难"。它的判断标准很简单:这个困难是不是直接作用在你想要变强的那条通路上。冻结住的检索线索当然是困难的,但它没有落在通路上,因此不算;只有"想不起来所以拼命想"这种困难才算。
顺着这个标准重新审视自己的学习习惯,会发现出于勤奋感的重复其实完全无关:划了三色的重点、抄了两遍的公式、整理了六个小时的思维导图。它们让过程很顺,也让下一次上手依旧陌生。真正决定能不能用出来的,是这条路在此之前被独自走过几次。这也解释了为什么看起来最努力的那个人,常常不是上手最快的那个人。
专业分析:测验效应的证据量级,与两套排程框架的对比
进入具体数据之前先说明来源口径:下面引用的都是实验心理学领域的公开研究——包括实验室对照实验、综述和元分析三类。给出的数值一律标注为"量级区间",因为不同材料、不同被试和不同保留间隔下,具体百分比会有明显浮动,把区间当成精确点数使用是不严谨的。
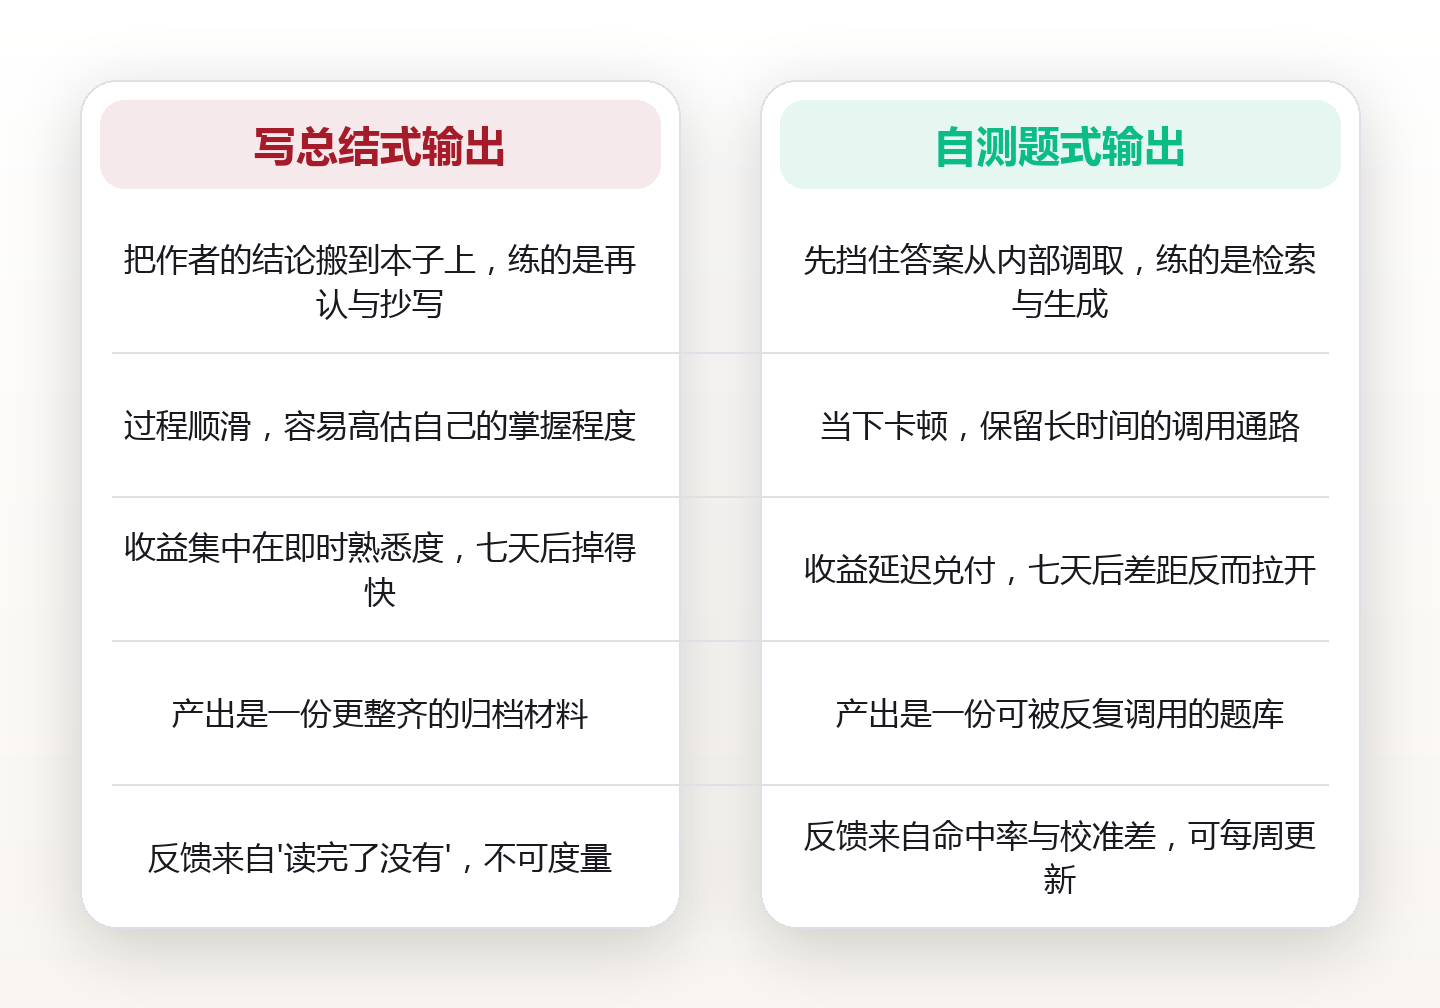
最常被引用的一项,是罗迪格与卡皮克 2006 年发表在《心理科学》上的实验,类型是实验室对照实验。他们让一组人反复阅读材料,另一组人读一遍后反复自测,然后在两个时间点做回忆。五分钟即时回忆时,反复阅读组反而略占上风,能多答出一成上下;等到七天后重测,情况完全翻转:反复自测的一组基本没怎么掉,反复阅读的一组掉得厉害,两组差距被拉到二三十个百分点以上。也就是说,自测的收益有一部分是"延迟兑付"的,它恰恰在你需要长期记住的地方才显现。
另外两项证据决定了这件事值不值得做成系统。其一是邓洛斯基等人 2013 年发表的策略综述,类型是学术综述,它把常见学习策略按经得起检验的程度分档:自测式练习与分散练习被归入高收益档,而反复阅读和划线标注被归入低收益档——后两者的支持证据薄弱到几乎无法推荐。其二是罗兰 2014 年发表的元分析,覆盖上百项实验,汇总后的平均效应量在中等水平(0.5 这个量级),且随着保留间隔拉长而变大。综合看,这不是一个边缘技巧,而是学习科学里少数反复复现的主效应。
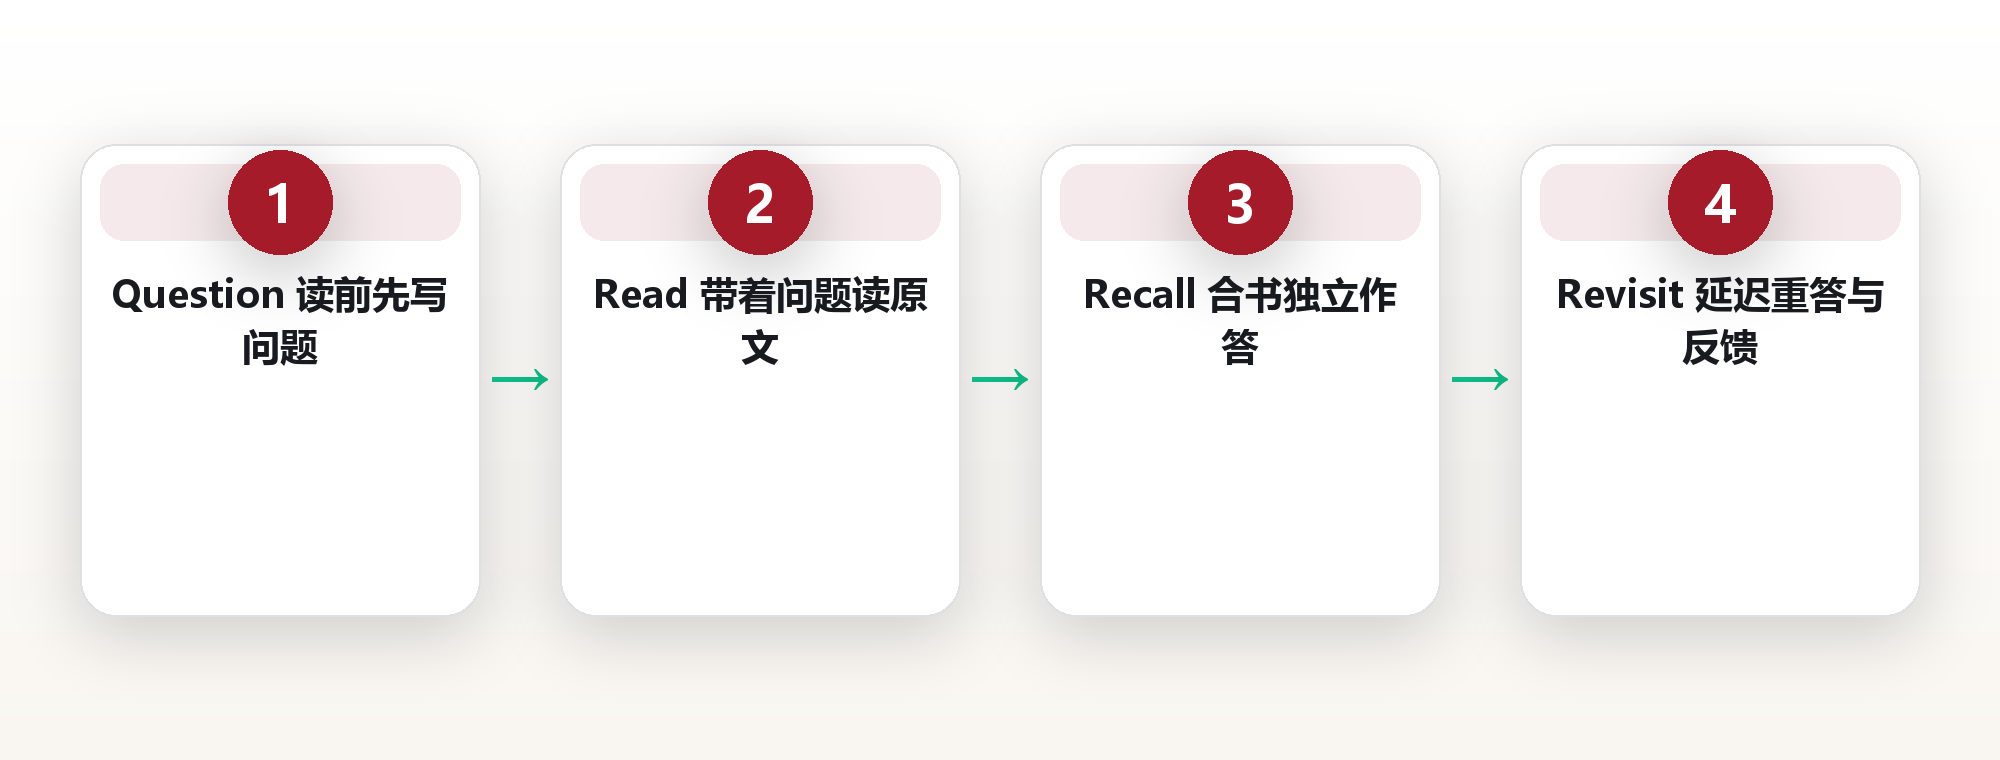
框架层面,可以把两条路线摆在一起对比。第一条叫"输入优先的三段式":通读—标注—复习,它的隐含假设是知识会被完整地装进来,用时才取;第二条叫"先问后读的四段式",我把它命名为 Q-R-R-R 排程:Question(读前先把问题写下来)、Read(带着问题读原文)、Recall(合上书独立作答)、Revisit(按天延迟重答并重看反馈)。两条路线在即时体感上,前者更顺;在七天后的调用表现上,后者更稳;把后者套用在一个孤岛式的知识点上时优势有限,套在一门需要长期调用的体系上时优势最大。
为什么会有这个差别,机制上可以这样看:写下问题时你激活的是"我不知道什么",这会让随后的阅读变成一次有方向的搜寻;合书作答时你加固的是线索到答案的通路;延迟重答时你利用的是快要忘记时的再巩固。三段式把力气花在了"往里装",四段式把力气花在了"往外调",而所有真实场景——会议发言、客户追问、考试、应急处理——考的都是往外调。
要让这件事可管理,需要四个度量指标:一是首答命中率,即不看答案第一次作答的正确比例,用来判断题面难度是否合适;二是延迟回忆率,分别在七天后和二十一天后各测一次,差值就是遗忘速度;三是信心校准差,做法是先给每道题的把握度打分(0 到 1),再用平均把握度减去实际命中率,差值越大说明自我评估越失真;四是再学时长下降率,同一批内容重新学到同一水平需要的时间,它衡量的是累积成本。
最后是本章的落地清单,可以直接抄走:第一,选一门你今年必须长期用得上的内容,不要选碎片资讯;第二,按 Q-R-R-R 排程把它切成二十到三十个知识单元,每单元配三到五题;第三,题目必须自带答案和一句"为什么",没有解释的题目等于把错误固化;第四,每天固定十二分钟,只做延迟重答和错题;第五,四周后统计上述四个指标,先只看校准差,它下降多少,说明你的自我判断修正了多少。
自测题不是把知识点挖空:五种题型与设计参数
很多人尝试自测失败,不是因为方向错,而是因为题目出得太糊。最常见的做法是把句子里的关键词挖掉,做成填空题。这种题考的是邻近词汇的联想,不是概念本身,做完满满一百道,遇到真实问题依旧不会调用。好的题目必须让你在几种可能之间做一次选择或一次生成,而不是顺着词流滑下去。
第一种是概念辨析题,专门用来区分两个容易混的概念。比如知识管理这个领域里,"再认"和"回忆"的区别是什么、"存储强度"和"提取强度"各自对应什么现象。这类题的价值在于逼你把边界画出来,边界一旦清晰,混用就消失了。第二种是反向提问:不问"它是什么",而问"什么情况下它会失效"。正向定义的答案往往是背下来的,失效条件的答案必须是推理出来的。
第三种是情境迁移题,把同一个原理搬到一个没见过的场景里。比如把"合意的困难"这条标准,放到一个具体的例子上去判断:每天把一个网页操作的常用步骤手抄一遍,算不算合意的困难?这类题直接检验你的迁移能力,也是最接近真实使用的一类。第四种是程序排序题,把打乱的步骤按正确顺序排出来,它适合流程类和操作类的内容,比如数据核查的二十三条红线,抽出其中五步打乱让你排。
第五种是边界条件题,专门考数值、阈值和例外。任何带有"通常在某某范围内成立"的知识,都应该配一道边界题,否则你会把它当成无条件成立。五类题型组合起来覆盖的面,远比同一知识点的十道填空题大,同样的题量,收获的调用路径多出好几条,这四类加上辨析题,基本可以覆盖一份总结里所有值得出的点。
题型之外还有四个设计参数。第一是干扰项强度:选择题的错误选项要"半真",也就是包含部分正确信息但错在关键处,太假的干扰项等于把答案送到嘴边。第二是延迟间隔:同一道题第二次出现最好隔一到三天,当天连答三次意义不大。第三是题面粒度:一道题只考一个知识点,把两个概念塞进一道题,反馈就无法精确。第四是反馈颗粒度:答案下面必须有一两句"为什么错",这是自测区别于考核的地方——考核要分数,自测要修正。
先考再学:预测验效应,以及它成立的两个前提
比"学完再考"更反直觉的,是"先考再学"。这个现象在文献里叫预测验效应,最常被引用的是科内尔、海斯与比约克在 2009 年发表的一组实验,类型是实验室对照实验。他们让学习者在正式学习之前先接触一轮会答错的题目,结果是先答错、再学习的那一组,在最终的考查中成绩明显好于用同样时间预习的那一组,量级在一成上下。答错并没有浪费时间,它改写了随后的注意力分配。
这个效应成立的第一个前提是必须有反馈。预测验效应的机制之一是"被预处理过的错误概念"在随后的学习中更容易被同化——当正确答案出现时,你已经有一次失败的检索经历挂在那里,它会自动被比对、被修正。但如果没人告诉你正确答案是什么,那次失败的检索经历就会被空置,甚至在多次重复后变得顽固。顺序不能乱,完整的形态是"先错—反馈—修正"三步,缺第二步就不要做。
第二个前提是对错误的态度。这里有个非常值得记住的现象:高把握度答错之后得到的修正,比低把握度答错的修正更容易被记住,这被称为过度修正效应(巴特菲尔德与梅特卡夫 2001 年的实验)。它的启发有两层:一是不要回避那些"你很有把握却答错"的题目,它们是收益最高的;二是体现出把握度打分的价值——没有把握度,你就识别不出这一类黄金错题。
放到日常里,"先考再学"的落地形态很轻:读一本书之前先花十分钟写下五个你觉得自己应该答得上的题目,不用查资料,直接写答案;开会前先写三条你准备怎么解释这个方案,再去看材料;学一门新工具之前先试着凭感觉说出它的三个核心动作。这些动作的当下体感是"我在乱答",但它们把随后的输入从被动接收改成了定向搜寻。
把一份总结改写成题库:四步改写流水线
从已经有的那一大摞笔记出发,不需要推倒重来,只需要一次格式转换。我把这个过程拆成四步:切单元、挑考点、改装题型、配上解释。每一步都有明确的产出物,一轮下来,一份三千字的总结大约可以变成二十到二十五道题,并且题目天然带有层次感。整个过程不需要额外的时间,它替换掉的本来就是你要去重读的那部分时间。
第一步切单元。先把总结按"可以独立讲清楚"的标准切成若干小块,通常每块两百到四百字。判断标准是:这一块能不能在一分钟之内讲完,听众听完之后能不能复述。切得太大,题目会松;切得太小,题目会碎。林知远的二十三条红线,最终切成了二十三个单元,每条一个。
第二步挑考点。不是每个句子都值得出题,一句话的出题价值取决于它是不是"关键区分点"。有三种句子几乎必挑:定义句(它规定了是什么)、因果句(它解释了为什么)、对比句(它划出了与别的东西的分界)。描述性的例子和重复的强调可以跳过,它们的存在是为了服务前三类句子,本身不构成考点。
第三步改装题型,这里有三种固定改法可以把陈述句直接翻成题目。定义句改成边界题:把"某某是指……"改成"下面哪一种情况不属于某某"。因果句改成反事实题:把"因为 A 所以 B"改成"如果 A 不成立,B 会怎么变,为什么"。清单句改成排序题:把"需要做甲、乙、丙"改成"把下列步骤排成正确顺序,并说明乙为什么不能提前"。三种改法覆盖了总结里绝大多数句子。
第四步配解释,这是最容易被跳过、也最不能跳过的一步。每题的答案下面必须写一句"为什么",解释的方向不是复述答案,而是说明错答为什么错、在什么条件下会错。这一步同时解决两件事:它为以后的修正提供了参照,也逼出题人把自己真正没弄懂的地方暴露出来——很多题目写到解释那一步就会卡住,那恰恰说明这一处并没有真懂。
间隔与交错:同一道题,排在什么时候最值钱
题出好之后,剩下的变量是时间。关于间隔,最常被引用的是塞佩达等人在 2006 年发表的元分析,类型是元分析。他们的结论给了一个可用的经验法则:最优复习间隔大致落在你期望保留时长的一到两成之间。想要七天之后还记得,第一次重答放在一天左右;想要三个月之后还记得,第一次重答放在一周左右。这个法则不精确,但它把"什么时候复习"从拍脑袋变成按目标倒推。
具体到执行上,一套简单的 1-3-7-21 排程就够用:新题当天答一次;隔一天答第二次;第七天第三次;第二十一天第四次。四次答对即刻进入季度库,中途答错就从头再来一轮。这个排程的意义在于把每道题的成本摊到四次短暂接触上,而不是一次性投入三十分钟。它的另一个好处是可废弃——只要某个间隔没赶上,跳过即可,不需要补偿。
比间隔更容易被忽略的是交错。所谓交错,指的是同一轮学习中混合不同单元的题目,而不是把同一单元的题目一口气做完。这个做法比"集中刷题"更难受,因为它强迫你在每个题目上都重新判断该用哪个原理。实际效果上,混合练习在最终考查中的表现通常优于按单元分区练习——代价依旧是体感更挫,收益依旧是延迟兑付。
有一个常见顾虑是:混着答会把人搞混。确实会,但这里的"混"恰恰是学习信号的来源。把二十三条红线的题目打乱随机抽,你每一次答之前都要先判断这条属于哪一类判断依据,这个判断动作在真实场景里才是必需的——真实的核查表不会贴心地把同类项排在一起。所以日常训练里刻意制造这种不便,等于提前支付了一部分现场的混乱成本。
度量:别靠感觉判断自己会不会,用四个数字
感觉是最不可靠的反馈通道。它受最近一次表现、材料长短、字体清晰度、当天状态影响,而且总是偏向乐观。要让自测真正闭环,必须把"我好像会了"这种含糊的判断,换成四个可以记下来的数字,而且这四个数字要每周更新一次,不需要复杂的工具,一张纸或者一个表格就够。
第一个是首答命中率:不看答案第一次作答的正确比例。它的作用不是追求高分,而是校准难度。命中率长期在九成以上,说明题目出得太浅,信息量不足以产生学习;长期低于五成,说明题面太深或者材料还没消化,会消耗掉坚持的动力。把整体控制六成到八成之间,通常是最不舒服也最有效的区间。
第二个是延迟回忆率,分别在答完七天后和第二十一天后测。真正有用的是这两次之间的差值——差值小,说明进入了长期记忆;差值大,说明前一次取得的进展只是缓存。很多人的学习策略在这里露馅:当天答得漂亮,二十一天后归零,于是每一轮都像从零开始,时间全部沉没在重复的起跑上。
第三个是信心校准差,做法是在每道题答完后先写下把握度,取值 0 到 1。用平均把握度减去实际命中率,就得到校准差。一个健康的区间是正负 0.1 以内;长期为正且偏大,说明你系统性高估自己,这正是"看着全会、一上手全废"的量化版本。这个指标不需要天天看,但它是四个指标里最能反映自我认知变化的那一个。
第四个是再学时长下降率:把一批搁置过的内容重新学到同一水平需要多长时间,与第一次相比降了多少。它衡量的是累积成本,也是唯一一个能回答"这套方法到底省不省时间"的指标。三个月之后,如果这个数字没有明显下降,说明前面的三个指标都只是在过程里打转,方法本身需要重构,而不是继续加次数。
执行清单:三十天,把一套笔记换成一套题库
最后给一套可以直接照做的三十天计划,前提是你手上已经有一批看得见成果的"写了但没真正用起来"的笔记。全部动作加起来每天大约十二分钟,不需要挤出整块的时间,也不依赖任何付费的工具——一张表格加一个计时器就能跑完。如果连三十天都拆不成能坚持的颗粒度,那就先把目标压到两周。
第一周:选定范围,只加工最贵的那份材料。挑的标准是"未来一年你必须反复调用",而不是"你最感兴趣"。把它切成二十到三十个知识单元,每单元写三到五题,其中至少一道必须是反向提问或者情境迁移题。第一周的目标不是答对,是把题库建起来,允许答不上来。
第二周:开始 1-3-7-21 排程,每天答六道旧题、出三道新题。所有答错的题目标注错因,只写三个字以内的标签,比如"边界""顺序""漏条件"。这一步的目标是把错误归类,当你发现某一类标签反复出现,你就找到了这份材料真正的难点位置,而不是你以为的难点位置。
第三周:加入交错和失败成本控制。把不同单元的题目打乱抽取,每天至少三分之一来自随机打乱;同时把每天的时间上限钉死在十二分钟,到点就停——这套方法最怕的不是效果差,而是热情过剩时一次性投入四十分钟,第二天直接放弃。这一周还需要在最后一天做一次本周统计,算出四个度量指标的第一次读数。
第四周:回收与判废。把首答命中率低于四成的题目整批复盘,判断是题面问题还是知识问题;把首答命中率长期在九成以上的题目降级进季度库,只保留抽查。三十天结束时,你手上应该有:二十到三十个单元、一百二十道左右的题目、四个指标的第一次读数,以及一份明显变薄的"需要重看"清单。这四样东西加起来,才是被真正用起来的一份笔记。
常见问题
1.问:我已经做了好几本笔记,推倒重来是不是太可惜?
答:不需要重来,只需要一次格式转换。按第四章的流水线走一遍:先把已有笔记切成能独立讲清楚的小块,再从每块里挑出定义句、因果句、对比句,按三种改法翻成题目。旧笔记的文字全部保留,题目是叠加在上面的第二层结构,或者说是一份可以被"调用"的索引。
2.问:自测题要出多少才算够?
答:按单元算不按总量算。一个能在一分钟内讲完的知识单元配三到五题就够了,其中至少一道要是反向提问或情境迁移题。二十三个单元配一百道左右是合理的规模。关键不在于多,而在于每道题都自带答案和一句解释——没有解释的题目只是在确认你已经会的部分。
3.问:答不出来的时候,要不要立刻翻答案?
答:给一个固定窗口。闭卷思考三十秒到六十秒,超过这个时间还没头绪,立刻看答案并记录为错因,不要硬耗。硬耗的价值不大,因为它已经不再是检索,而是无效的白噪声。记录下来的错因才是下一轮要重答的重点。
4.问:为什么我当天答得很顺,一周后又忘得差不多?
答:先看延迟回忆率,再看排程。如果第七天掉到很低的水平,通常是因为所有练习都挤在同一天完成,间隔没有真正拉开。把第二次重答固定在一到三天后、第三次放在七天后,并且混合不同单元的题目,这个问题通常会在两三周内改善。
5.问:这套方法适合所有内容吗?
答:不适合。它最适合需要长期调用、能切成清晰单元的知识,比如规则、原理、流程、概念体系。对于碎片资讯和纯操作类技巧,投入产出比不高。判断方法很简单:问自己"这件事我明年还需要不看资料就说清楚吗",答案是需要,就值得做成题库。
图片来源:图1 newtjitsu / Pixabay (CC0) · 图2 花见花开788 / Pixabay (CC0) · 图3 花见花开788 / Pixabay (CC0) · 图4 花见花开788 / Pixabay (CC0) · 图5 cjy500 / Pixabay (CC0) · 图6 mikuratv / Pixabay (CC0) · 图7 jplenio / Pixabay (CC0) · 图8 tfrdic / Pixabay (CC0) · 图9 geralt / Pixabay (CC0) · 图10 Kost9n4 / Pixabay (CC0) · 图11 fleglsebastian7 / Pixabay (CC0) · 图12 jarmoluk / Pixabay (CC0) · 图13 rihaij / Pixabay (CC0) · 图14 daschorsch / Pixabay (CC0) · 图15 Gabriela-Motta / Pixabay (CC0) · 图16 dendoktoor / Pixabay (CC0) · 图17 asundermeier / Pixabay (CC0) · 图18 DavidClode / Pixabay (CC0) · 图19 qimono / Pixabay (CC0) · 图20 PublicDomainPictures / Pixabay (CC0) · 图21 Pexels / Pixabay (CC0) · 图22 29277261 / Pixabay (CC0) · 图23 Nowaja / Pixabay (CC0) · 图24 3503898 / Pixabay (CC0) · 图25 JillWellington / Pixabay (CC0) · 图26 MartinHarry / Pixabay (CC0) · 图27 DavidClode / Pixabay (CC0) · 图28 RheaHoldstock / Pixabay (CC0) · 图29 zivica / Pixabay (CC0) · 图30 geralt / Pixabay (CC0) · 图31 AnnaER / Pixabay (CC0) · 图32 valentinsimon0 / Pixabay (CC0) · 图33 soap0119 / Pixabay (CC0) · 图34 Ralphs_Fotos / Pixabay (CC0) · 图35 Ralphs_Fotos / Pixabay (CC0) · 图36 rkarkowski / Pixabay (CC0) · 图37 MiraCosic / Pixabay (CC0) · 图38 Dimhou / Pixabay (CC0) · 图39 MiraCosic / Pixabay (CC0) · 图40 focusonpc / Pixabay (CC0)
本文为认知与方法论科普,不构成任何投资建议。
评论(0)