
基本信息
阅读时间:约 15 分钟
字数:约 5903 字
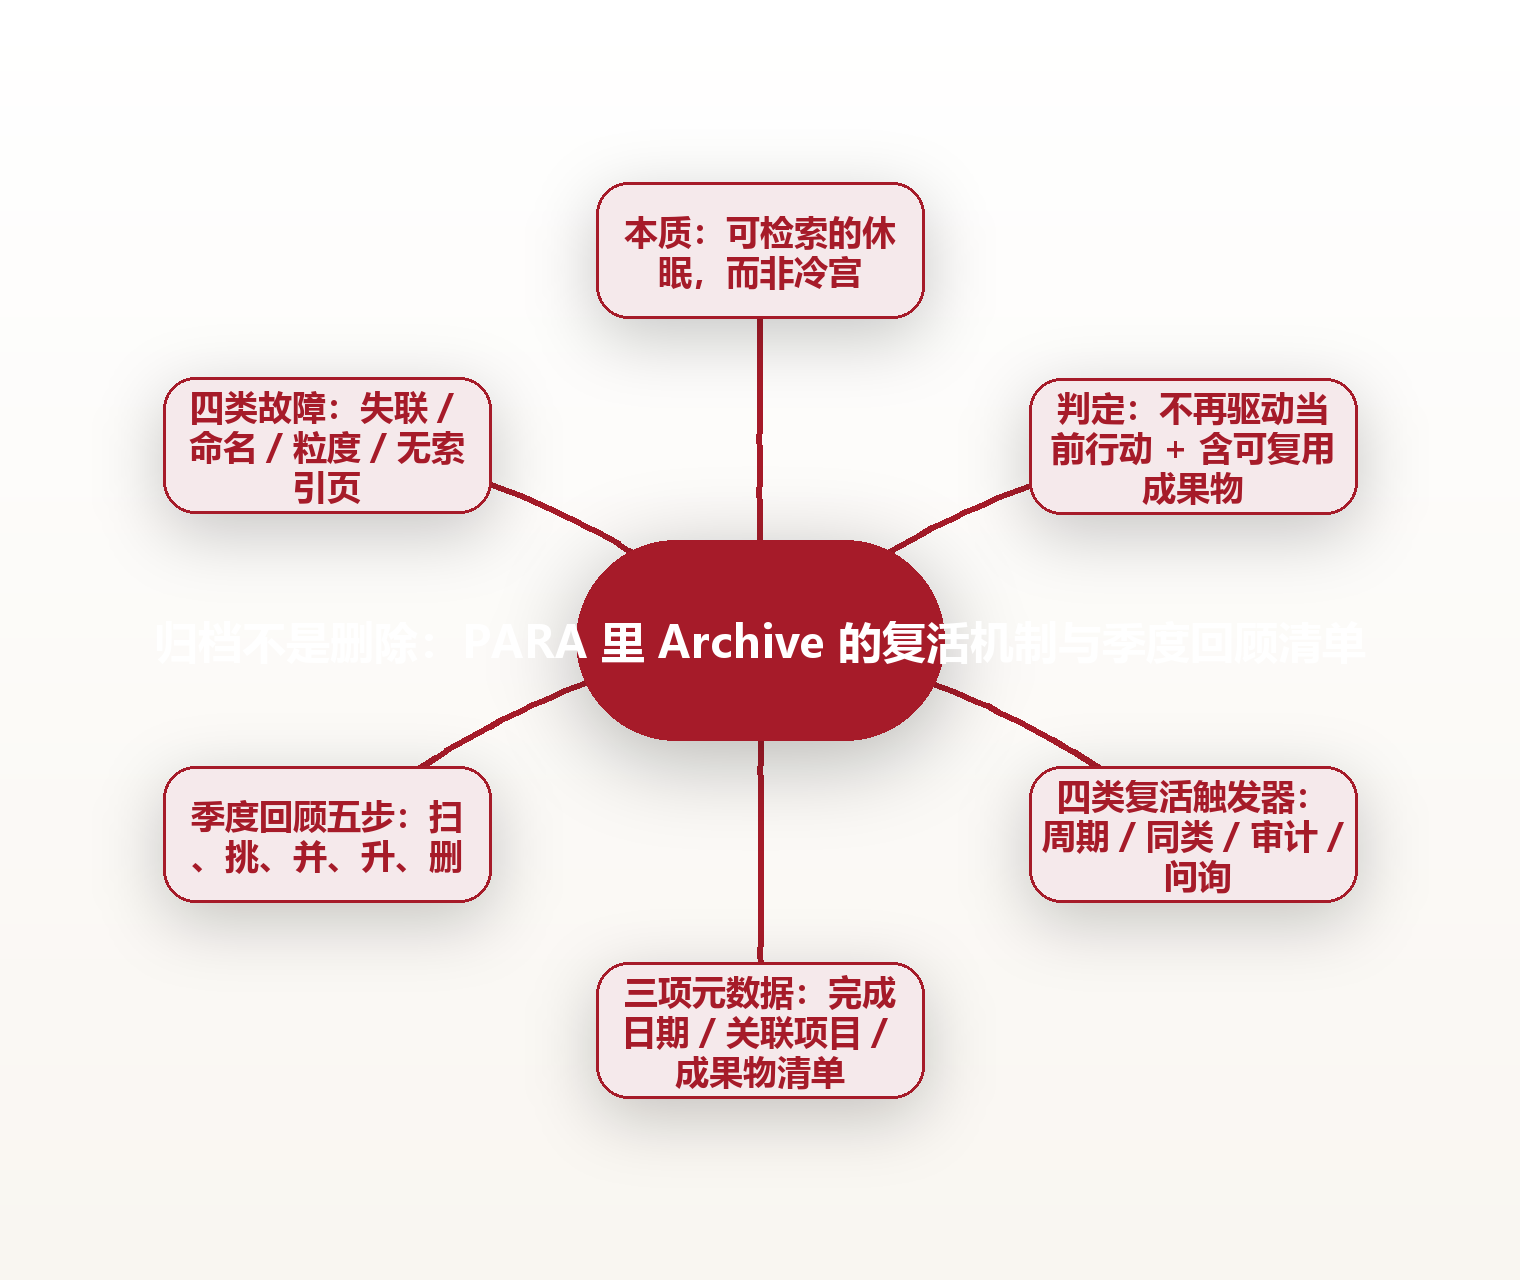
摘要:深圳咨询顾问周牧言一次删掉 1,225 条旧笔记,第二年被迫花四个晚上重做一份诊断表。本文专攻 PARA 里最被忽略的一格:归档的判定标准、四类复活触发器、三项必备元数据、季度回顾五步清单,以及四类失效故障的修法。
全文语音
中文
English
日本語
한국어
那个清空了三年的下午:一次整理如何变成一场事故
周牧言是深圳的一名独立咨询顾问,36 岁,做了十一年组织流程改造。去年十一月的某个周日下午,他坐在城中村一间 34 平米的公寓里,对着笔记软件里 1,842 条记录发呆。他的做法是开一个新的筛选视图,按修改时间从旧到新排,凡是一年以上没动的,全选,删除。
两个小时之后,列表剩下 617 条。他当时的原话是:“我以为我在做大扫除,后来才发现我把仓库拆了。”
麻烦出现在第二年三月。一个新客户要做门店排班改造,而他清楚地记得,2022 年他给过另一家连锁做过一模一样的诊断表。那份表的字段逻辑、权重口径、甚至客户反驳他的三句话,他都能背出来。可它不见了。
他花了四个晚上重做,做出来的版本比原来那版少了两个字段——那两个字段是当年被客户现场怼过之后补上去的。补不回来了。他说:“我不是丢了一份文件,我是丢了一次被现实修正过的判断。”
这件事后来逼他把整个知识系统重做了一遍。他现在的原则只有一句话:归档不是把东西扔远,而是给它换一个能被叫回来的位置。
PARA 里的 Archive 这一格,长期被当成系统的垃圾桶,或者干脆没人用。它其实是整个结构里最需要设计的一格,因为它决定了你过去五年的劳动,在未来五年还能不能被调用。
归档的本质:可检索的休眠,而不是冷宫
先把概念掰正:删除是切断检索路径,归档是保留检索路径、只是降低它在日常视野里的权重。两者在物理上可能只差一个字段,在效果上差一个数量级。
一个真正的归档条目,应该同时满足三个条件:不出现在任何当前行动的待办列表里;不占用每日打开频率最高的目录层级;在被关键词、项目名或时间范围命中时,能以三秒内的速度被打开。
我把它叫作“可检索的休眠”。休眠的意思是它不再消耗你的注意力预算,可检索的意思是它随时可以被唤醒。缺了后半句,归档就退化成冷宫——东西还在,但你再也叫不动它。
据麦肯锡 2012 年一份公开行业调研的量级数据,知识工作者平均每个工作日约有 1.8 小时花在搜索与汇集信息上,占工作时间的近两成。这类公开调研的量级只能作为背景参考,落到个人身上的比例差异很大,但它指向一件事:检索能力本身就是产能。
从这个角度看,Archive 不是系统的末端,而是系统的外存。你今天的判断、模板、清单、复盘,本质上都是给未来某个具体场景准备的弹药库。归档做得好,你的历史会持续复利;做得不好,你每年都在重新发明轮子,而且往往发明出更差的那个版本。
判定标准:不再驱动当前行动,但留有未来可复用的成果物
最难的从来不是归档动作,是判定。什么时候该把一条内容从 Projects 挪进 Archive?周牧言后来给自己定了三条硬标准,命中任意两条就归。
第一条:它是否还在驱动当前行动。项目类内容的判据非常直白——这一周有没有任何一件具体的事,需要打开它才能推进?如果连续两周答案为否,它就不再是项目,而是历史。
第二条:它是否含有可复用的成果物。成果物包括最终交付的文档、模板表、决策记录、以及被现实修正过的判断痕迹。纯流程性的东西,比如一次性的会议通知、临时导出的日志,复用价值很低,可以不入档直接清掉。
第三条:它是否含有决策痕迹。这是最容易被忽略的一条。一份排班诊断表之所以值钱,不在于它的格式,而在于那两个被客户怼出来的字段——那是“为什么这么设计”的答案。没有决策痕迹的成品,往往只是空壳。
三条里最容易误判的是第二条和第三条的关系。很多人归档只留成品,不留过程。等到复用时才发现,自己复制了一个漂亮的结构,却完全不知道当初为什么这么切分,于是在新场景里用错。
周牧言现在的做法是:归档时同时保留成品与一份不超过 200 字的决策说明。他说:“两百字贵在时间,便宜在以后不用猜。”
四类复活触发器:归档什么时候会自己敲门
归档条目不会自己跳出来,它需要触发器。周牧言总结了他自己系统里四类高频的复活场景,几乎覆盖了归档被调用的全部情形。
第一类,周期性项目。年报、季度复盘、年度体检、换季衣橱整理,这类事一年出现一到四次,每次都需要去年的版本做底稿。它们的复活节奏是可预测的,你甚至可以提前把去年那份挂到今年的待办上。
第二类,同类新项目启动。新客户要做门店排班,就去找上一次的排班诊断;新房要装修,就去找上一套房的水电验收清单。这类复活的特征是“结构相似”,触发信号是关键词与项目类型,而不是时间。
第三类,审计与复盘需求。年底做能力盘点、团队做流程审计、个人做年度总结时,你需要的是过去一年全部成果物的清单,而不是某一份具体文件。这类复活查的是归档的元数据结构,而不是内容本身。
第四类,他人问询。同事问你去年那个报价模板怎么做的,朋友问你上次搬家用的哪家公司。这类复活最随机,也最依赖检索质量——因为提问的人不会用你当初归档时用的词。
四类触发器对应四种检索路径:时间路径、类型路径、结构路径、语义路径。你的归档系统只要覆盖了这四条路径,绝大多数条目都能被叫回来;缺任何一条,都会出现明明记得有、就是找不到的情况。
三项元数据:完成日期、关联项目、成果物清单
让复活真正发生的是元数据,而不是目录层级。周牧言给每条归档内容强制写三项,缺一项就不允许归档。他把这个做法叫“三锁归档”。
第一把锁是完成日期,格式统一为 YYYY-MM。写月份而不是精确日期,是因为人在回忆时想起的是“去年秋天”而不是“去年十月十七号”。月份粒度既够用,又不会因为记不准而检索失败。
第二把锁是关联项目,即这条内容的来源项目名,以及它的上一个同类型项目。填两项的原因是:同类型项目名提供了第二条检索路径,当你记不清某个归档来自哪一年哪一家客户时,从类型这一侧也能摸过去。
第三把锁是成果物清单,用一句话列出这条归档里到底有什么,比如“诊断表 + 权重口径说明 + 200 字决策备注”。清单的作用是让你在搜索结果里不用点开就知道要不要它。
“我以前觉得写元数据是浪费时间。”周牧言说,“后来算了一笔账:一条写元数据花 40 秒,一次找不到重做花 4 小时。只要一条归档被复用超过 0.003 次,这事就划算了。”
这三项元数据后来还给他带来了意外收益:年度总结时,他只需要按完成日期排一遍归档,一年做过什么、产出过什么,十分钟就能列完,不用再靠记忆拼。
专业分析:归档复活率怎么算,与两套命名框架的对比
本节的度量指标为本文提出的自建口径,用于个人系统体检,非公开统计。下面的量级数据分别标注了来源类型,读者可直接套用,也可按自己的记录习惯调整分母。
核心指标叫归档复活率:在一个统计周期内,被重新打开并产生实际使用行为的归档条目数,除以该周期内的归档条目总数。周牧言用 12 个月做周期,他 2025 年的数字是 31%,即 100 条归档里约有 31 条在一年里被再次打开过。
这个指标的意义在于校准系统。复活率长期低于 10%,通常意味着归档了太多低价值内容,判定标准过松,垃圾稀释了仓库;长期高于 60%,则说明你归档得太保守,很多仍有复用价值的内容被留在了活跃区,占用日常视野。
两个配套指标同样重要。其一是检索一次命中率:在检索归档时,第一次搜索就找到目标的比例,健康的个人系统通常在七成上下。其二是季度回顾耗时,即走完一遍完整季度回顾流程所需的分钟数,周牧言从最初的 240 分钟压到了 90 分钟。
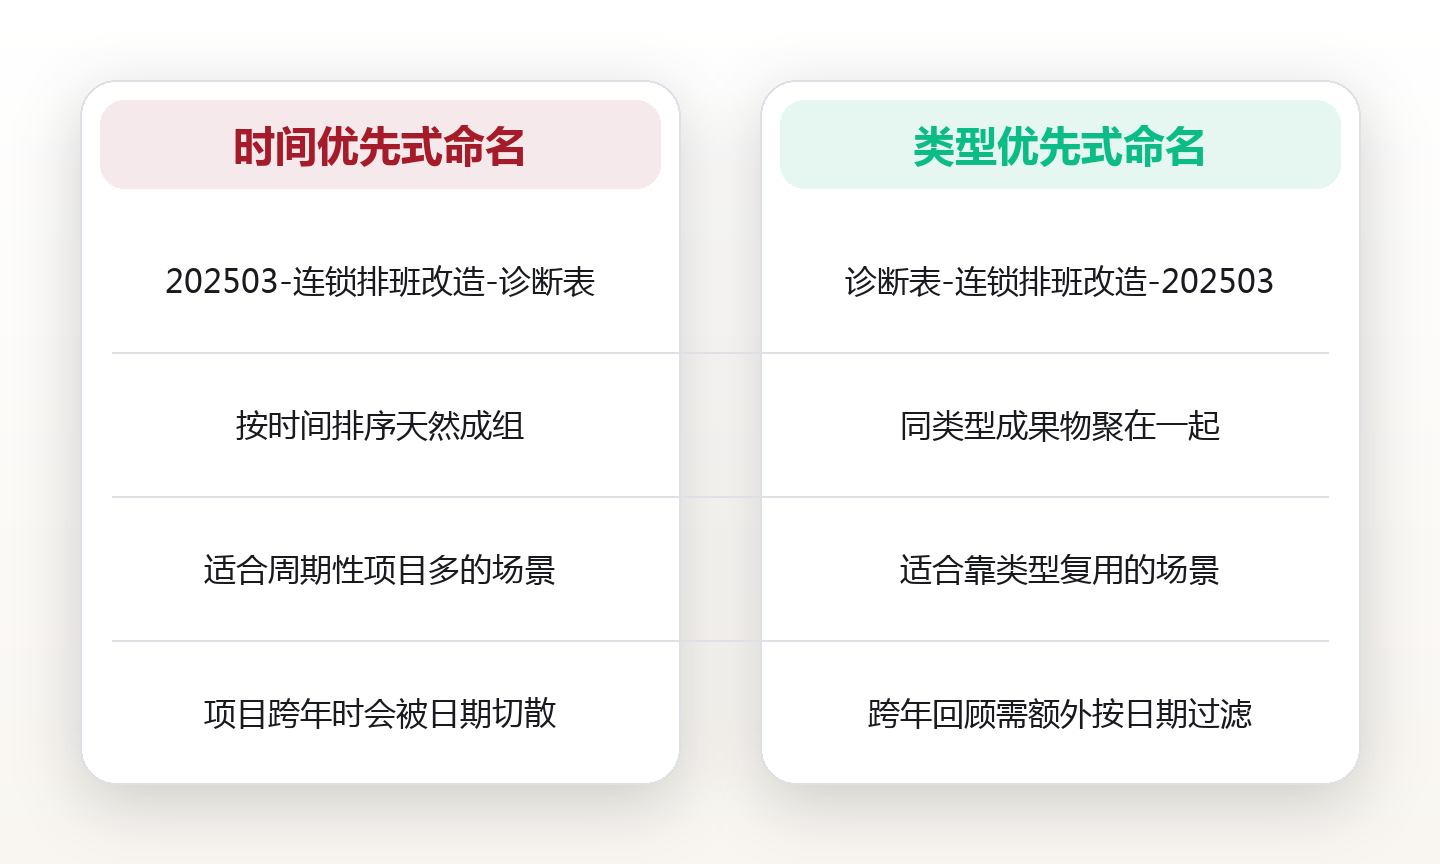
命名框架这里给出两套做对比。第一套是时间优先式,结构为“YYYYMM-项目名-成果物类型”,例如“202503-连锁排班改造-诊断表”。它的优势是按时间排序天然成组,适合周期性项目多的场景;劣势是当同一项目跨年存在时,相关内容会被时间切散。
第二套是类型优先式,结构为“成果物类型-项目名-YYYYMM”,例如“诊断表-连锁排班改造-202503”。它的优势是同类成果物聚在一起,适合靠类型复用的场景,比如你经常需要翻出所有模板;劣势是跨年回顾时需要额外按日期过滤。
真实可辨识的案例参照:PARA 方法由 Tiago Forte 在《Building a Second Brain》中提出,其原始表述里 Archive 的定义是“来自项目与领域、已完成且不再活跃、但你想保留的内容”——注意它强调的是“不再活跃”,并未规定任何元数据要求。这正是大部分人把 Archive 用成冷宫的原因:方法给了位置,没给索引。
与之对比,David Allen 在 GTD 体系里用的是“参考资料”与“归档”二分,并强调索引(Index)是独立于存储的存在。两套体系的差异很清晰:PARA 给出层级,GTD 给出检索约定。把两者拼起来,才是一个能复活的归档系统。
落地执行清单如下:一,给每条归档补齐三项元数据;二,选定一套命名框架并全量重命名存量内容;三,建立一张归档索引页,按类型分组、每项带一行摘要;四,记录本季度复活率与回顾耗时两个数;五,每季度末用五步清单跑一遍。五步做完,归档就从仓库变成了资产。
季度回顾五步清单:扫、挑、并、升、删
季度回顾是让归档系统不腐烂的唯一机制。周牧言把它压成五个动作,每个动作都有明确的输入、输出与耗时上限。
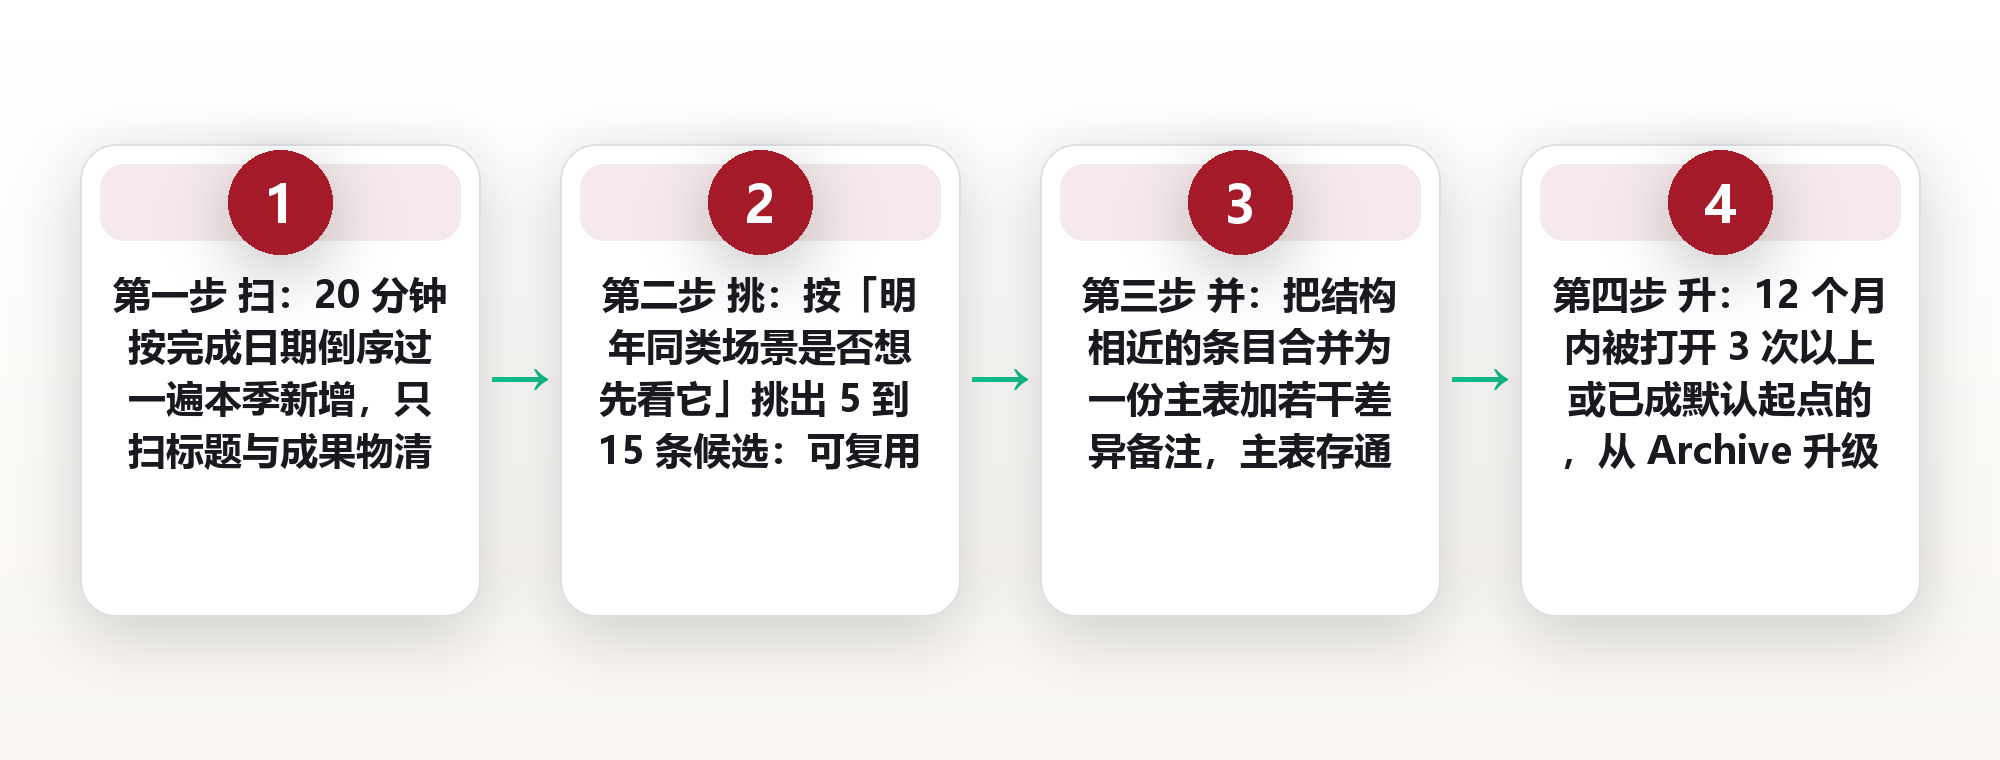
第一步,扫。用归档索引页按完成日期倒序过一遍本季新增的全部条目,只扫标题与成果物清单,不点开正文。目标是在 20 分钟内对本季产出建立整体印象,输出是一个“本季成果物总表”。
第二步,挑。从总表里挑出三类内容:可复用为模板的、含高质量决策痕迹的、以及被反复引用过的。挑出的标准只有一条——如果明年再遇到同类场景,我会不会想先看它。输出是一个 5 到 15 条的候选清单。
第三步,并。把候选清单里结构高度相近的条目合并。周牧言去年把 7 份不同客户的排班诊断表并成 1 份主表加 6 份差异备注,主表保留通用字段,差异备注记录各家客户的特殊约束。合并后他每次只需打开 1 份。
第四步,升。把合并后的主表从 Archive 升级进 Resources,成为长期维护的常备资源。升级的判据是:它在过去 12 个月被打开过 3 次以上,或者它已经成为某类工作的默认起点。升级之后它就有了维护责任人——你自己。
第五步,删。对剩余条目做一次诚实判断:一年来从未被打开、且不含任何决策痕迹的,删掉。周牧言 2025 年第四季度删掉了 118 条,占当季归档的 22%。他说删的时候并不难受,因为留下的每一条他都知道自己为什么留。
五步的总耗时控制在 90 分钟以内,超过就说明扫的范围太大,需要拆成两次。回顾本身也应该归档——把每季的回顾记录存进一个固定条目,明年这个时候你就有了一条纵向的时间线。
四类故障:归档即失联、命名无意义、粒度过大、没有索引页
归档系统的失效几乎都落在四种模式里,它们有各自不同的症状与修法,混在一起处理往往越修越乱。
第一种是归档即失联。症状是搜不到——你记得有这份东西,用三个关键词都搜不出来。根因通常是归档时改了名字或换了目录,导致原始关键词丢失。修法是保留原文件名,只追加元数据前缀,不替换。
第二种是命名无意义。症状是搜索结果里出现一堆“新建文档 3”“未命名 copy”“最终版最终版”。根因是归档动作发生在任务刚结束、注意力已经耗尽的时候。修法是把命名放在归档流程的第一步,而不是最后一步。

第三种是粒度过大。症状是你知道东西在某一大包里,但要花十分钟翻。典型形态是把一个项目的几十份文件压成一个总文件夹丢进归档,没有内部清单。修法是每条归档单元不超过 5 份文件,超过就拆,并配一张清单页。
第四种是没有索引页。症状是系统里东西都在,但你不知道自己到底有什么,于是每次都重新做。修法是建一张单页索引,按成果物类型分组,每条目一行摘要加一个链接。这张页是归档系统唯一需要常驻视野的东西。
四类故障里,第四种的破坏力最大,也最容易被忽视。前三种只是让你多花时间,第四种会让你彻底忘记自己已有的能力,直接导致重复劳动。
把归档养成节奏:每周 10 分钟 + 每季 90 分钟
归档系统的成本不在搭建,在维护。周牧言把它拆成两种节奏,加起来一年不到 10 小时。
每周 10 分钟只做一件事:把本周已经确定结束的项目条目挪进归档,并补齐三项元数据。不做判断、不做合并、不做删除——那些留给季度。这个动作的关键是固定在同一个时间点,他选的是周五下午五点半,一周里注意力最低、也最接近收尾的时刻。
每季 90 分钟跑一遍五步清单,并且只在本季范围内操作。跨季的内容不在这次回顾里碰,否则范围会不断膨胀,最终变成一场不可能完成的整理运动。
他还给自己留了一条缓冲规则:任何拿不准要不要删的内容,先打上“待定”标记,放进下一季再看。连续两季都没被打开且没被想起的,就删。他说:“犹豫本身也是一种数据,只是需要两个季度才读得出来。”
这个节奏跑满一年之后,他的归档条目从 1,842 条变成了 2,300 多条,但检索一次命中率从不到四成提到了七成五。数量在涨,系统在变轻,因为每一条都有名字、有路径、有理由。
常见问题
1.问:归档和删除到底该怎么选,有没有一句话的判断标准?
答:有。问自己一句——明年遇到同类场景时,我愿不愿意先看它。愿意就归档,不愿意就删,犹豫就先打待定标记,下一季再判一次。把这个判断写成笔记软件里的一个复选框字段,每次归档时勾一下,三个月后你会得到一份真实的取舍记录。
2.问:归档越攒越多,会不会反而拖慢检索速度?
答:会,但拖慢的原因通常不是数量,而是命名与索引。先给最近 20 条归档补齐三项元数据并统一命名格式,再建一张按类型分组的索引页。做完这两步,多数人的检索体验会明显改善,不必急着清理存量。
3.问:归档之后还需要继续维护吗?
答:需要,但很轻。每周花 10 分钟做归档与补元数据,每季度花 90 分钟跑一遍扫挑并升删五步。除此之外不用再碰它。维护的重点放在索引页上——它是唯一需要保持新鲜的归档内容。
4.问:我的归档复活率很低,是不是说明归档习惯有问题?
答:未必。复活率低先看两个方向:一是判定标准过松,把大量一次性内容也归了进来,这时收紧归档口径;二是检索路径不全,东西在但找不到,这时补齐时间、类型、结构、语义四条路径。先查第二个,它更常见也更便宜。
5.问:纸质资料怎么套用这套归档机制?
答:用同样的三项元数据,只是载体换成标签。给每个文件盒贴一张卡,写完成月份、来源项目、盒内清单三行,并把这张卡的内容同步抄进数字索引页。这样你在手机里搜关键词时,能直接定位到某个盒子的某一层,不用把柜子翻一遍。
图片来源:图1 modernseoul / Pixabay (CC0) · 图2 Bessi / Pixabay (CC0) · 图3 theharpreetbatish / Pixabay (CC0) · 图4 Kranich17 / Pixabay (CC0) · 图5 chico明 / Pixabay (CC0) · 图6 austinschrock / Pixabay (CC0) · 图7 Makalu / Pixabay (CC0) · 图8 oljamu / Pixabay (CC0) · 图9 qimono / Pixabay (CC0) · 图10 Pexels / Pixabay (CC0) · 图11 652234 / Pixabay (CC0) · 图12 erikawahirolu / Pixabay (CC0) · 图13 geralt / Pixabay (CC0) · 图14 zivica / Pixabay (CC0) · 图15 lin2015 / Pixabay (CC0) · 图16 Istvan_Karoly_Bocs / Pixabay (CC0) · 图17 NguyenHoangThach / Pixabay (CC0) · 图18 TheFealdoProject / Pixabay (CC0) · 图19 Minhsang92 / Pixabay (CC0) · 图20 AFOKU_ART / Pixabay (CC0) · 图21 rainerh11 / Pixabay (CC0) · 图22 analogicus / Pixabay (CC0) · 图23 mystraysoul / Pixabay (CC0) · 图24 Kost9n4 / Pixabay (CC0) · 图25 nabe456 / Pixabay (CC0) · 图26 Leonhard_Niederwimmer / Pixabay (CC0) · 图27 WikiImages / Pixabay (CC0) · 图28 Oldiefan / Pixabay (CC0) · 图29 It_was_a_pleasure / Pixabay (CC0) · 图30 sasint / Pixabay (CC0) · 图31 zivica / Pixabay (CC0) · 图32 ka_re / Pixabay (CC0) · 图33 SplitShire / Pixabay (CC0) · 图34 qimono / Pixabay (CC0) · 图35 ligielis / Pixabay (CC0) · 图36 Couleur / Pixabay (CC0) · 图37 MiraCosic / Pixabay (CC0) · 图38 Dimhou / Pixabay (CC0) · 图39 MiraCosic / Pixabay (CC0) · 图40 focusonpc / Pixabay (CC0)
评论(0)