
基本信息
阅读时间:约 12 分钟
字数:约 4756 字
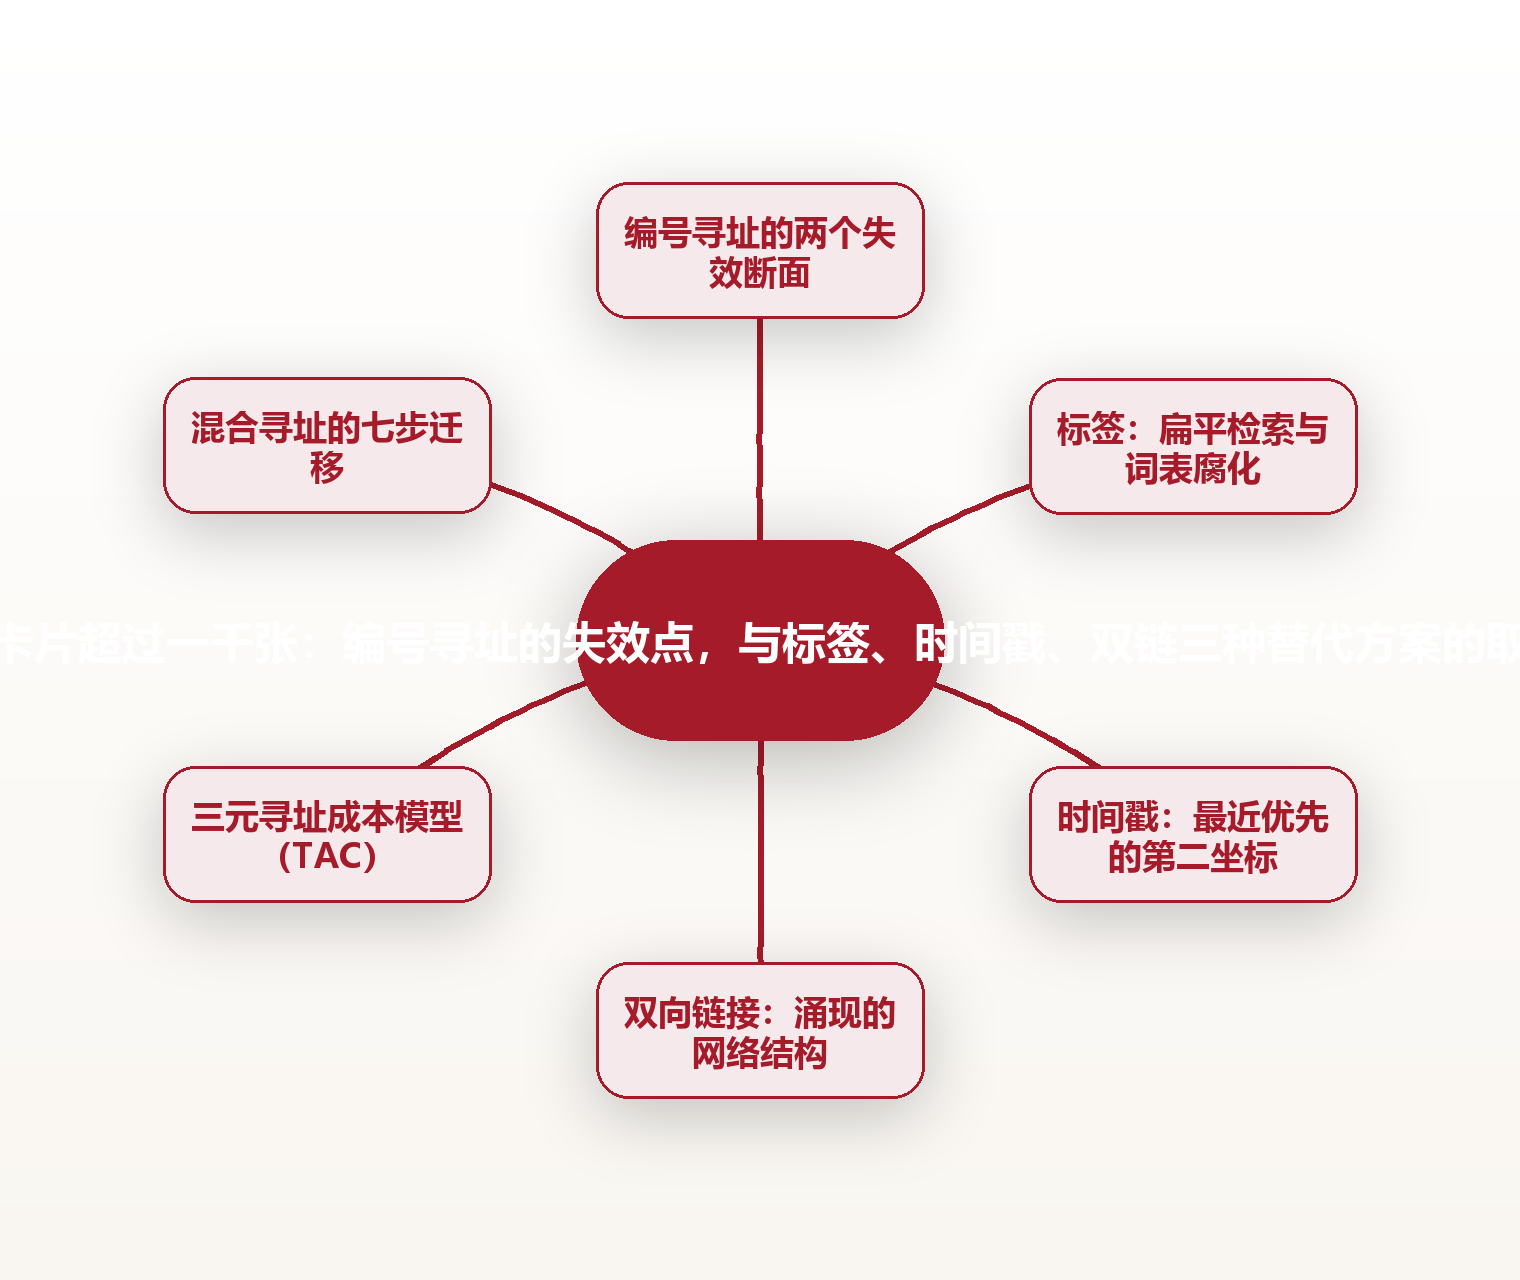
摘要:当卡片越过一千张,线性编号既记不住也连不上。本文拆解编号寻址的两个失效断面,并对比标签、时间戳、双向链接三种替代方案的取舍边界与落地路径。
全文语音
中文
English
日本語
한국어
当编号本身成了障碍:一千张卡片后的寻址困境
林川,三十二岁,在上海做产品经理。他从四年前开始用卡片记录读书摘抄、会议要点和突如其来的想法,到今年春天,文件夹里的卡片已经攒到一千零三十多张。某个加班的深夜,他想翻出三个月前写的那张关于复盘的卡片,却怎么也想不起它的编号。他试着用 0042、0173 这些数字去翻,发现它们对应的早已是别的内容。那一刻他意识到,真正难的从来不是写卡片,而是把写下的东西再找回来。
编号这件事,前提是一个我们很少说破的假设:未来的你,会记得这张卡片当初被放在了哪里。可当卡片只有二十张时,这个假设勉强成立;一旦越过一千张,人的记忆根本兜不住那么多随机数字。编号从索引退化成了另一个需要记忆的东西。
这篇文章想讨论的,不是怎样写得更多,而是怎样在卡片膨胀之后,依然能稳稳地把任意一张捞出来。我们把这个问题叫做寻址——你用什么坐标,在一堆笔记里定位到那一条。
我们会先拆开编号寻址在哪两个断面失效,再看标签、时间戳、双向链接这三种替代方案各自怎么解决问题、又各自付出什么代价。它们不是非此即彼,多数人的答案其实是某种混合体。关键是你得先看清,每种方案解决的是哪一种找不到。
失效的第一个断面:线性编号假设了你知道该找哪一张
线性编号,比如 0001、0002 这样一路排下去,本质上把地址和创建顺序绑在了一起。第一张先写,编号就小;后写的编号就大。它记录的是时间,不是内容。这在一个月里没问题,可一千张卡片横跨四年,编号早就和主题脱钩了。
它的第一个失效点在于:编号本身不携带任何语义。看到 0612,你既不知道它是讲复盘还是讲早餐,也不知道它和 0611 有没有关系。检索时,你要么记得那个数字,要么只能从头扫到尾。前者靠记忆,后者是线性扫描,成本随卡片数线性上升。
更麻烦的是,人的记忆对数字会折旧。一个朴素的事实是:孤立的数字比有意义的关键词更难长期记住。你记得上周那张讲拖延的卡片,却几乎不可能记得它是 0488 还是 0731。当寻址依赖记忆编号,系统就在悄悄把负担转嫁给你。
所以第一个断面可以概括成一句话:线性编号假设你知道该找哪一张,可一千张卡片之后,这个假设基本不成立。地址和意义之间的裂缝,就是失效开始的地方。
失效的第二个断面:编号无法承载语境与关系
编号的第二个失效点更隐蔽:它把每张卡片当成孤立的一格,可真实的知识从来不是一格一格排好的。一张关于复盘的卡片,可能同时挂在团队会议、个人成长、产品迭代三个语境下。一个编号只能把它塞进一条线,塞不下三种身份。
知识的生长方式其实是网状的。你今天写的一条灵感,半年后可能和另一条完全不相干的笔记连成一条线,生出第三点想法。编号寻址没有给这种连接留位置,它默认每张卡都有且只有一个家。当一张卡其实属于十个地方,单一地址就开始失真。
这也是为什么很多人在卡片超过几百张后,会感觉系统变重。不是写得太多,而是每次想找,都要先回答它该在哪个编号下,而这个答案本身就模糊。编号维护的是秩序,却挡住了关联。
把这两个断面合起来看:编号在量小时靠记忆还能撑,一旦量大又关系密,它既记不住、也连不上。失效不是突然发生的,而是在某个量级上慢慢显形。下一个问题自然就是——除了编号,还能用什么来寻址。
三种替代方案的来路:为什么不是再加一层编号
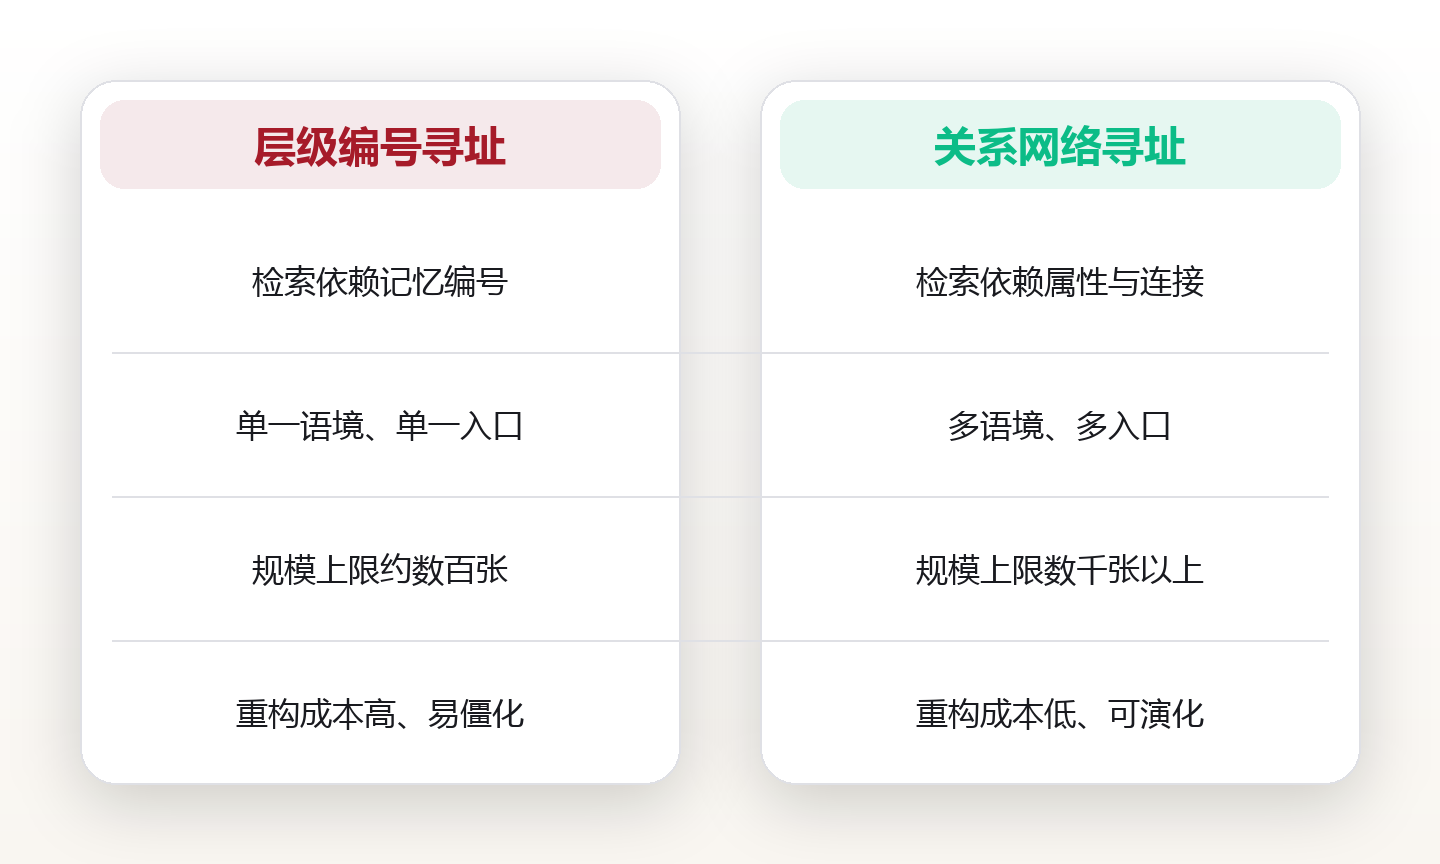
面对找不到,大多数人的第一反应是补救编号:加子编号、建文件夹、套嵌套目录。比如把卡片拆成工作、生活、读书三大类,每类再编号。看起来更整齐了,其实只是把问题平移——文件夹本身也是一种层级编号,它照样要求你记得它该在哪个类里。
跨领域的内容最容易被文件夹坑。一张既关乎读书又关乎产品的卡片,塞进哪一边都别扭,最后往往复制两份,或者干脆不归类。目录越建越深,寻址反而更累。层级方案的天花板,正是它自己的层级。
真正有用的转向,是把坐标的基准从我把它们放在哪换成它是什么、它连着谁。前者是存放视角,后者是属性与关系视角。一旦基准变了,编号就不再是主角,三种新方案才有了空间。
标签回答它属于哪些类别,时间戳回答它大概何时产生,双向链接回答它和谁有关。三种方案各自对准一种不同的回忆线索。下面三节,我们一个一个拆开看它们的便宜与代价。
方案一:标签系统的扁平化检索与它的代价
标签是最直接的替代。你不再关心卡片排第几,只关心它身上贴了什么词。想找复盘,就搜复盘;想找和会议有关的,就搜会议。地址从一串数字,变成了若干属性。一张卡片可以贴很多标签,于是它同时拥有多个入口,而不必困在一条线上。
标签的好处是扁平。它不要求你预先想好完美的层级,标签可以随时补、随时改。对于横跨多个主题的内容,标签天然友好:同一张卡片可以既是产品也是复盘也是团队。检索时按属性聚拢,比按编号扫描省力得多。
但标签有自己的代价,而且这个代价会随规模恶化。第一是词表腐化:一千张卡片后,你很可能已经有了复盘、复盤、周复盘、周会复盘四五个近义标签,它们指向同一件事却被系统当成不同的门。第二是孤儿标签——建了却再没用过的标签,悄悄占着词表。
所以标签方案能不能撑住千张量级,关键不在用不用标签,而在有没有受控词表。一个被定期修剪、数量有上限的标签体系,比一个放任生长的标签森林可靠得多。后面落地清单里我们会回到这件事。
方案二:时间戳序列与最近优先的回忆线索
时间戳是另一种思路:与其记住内容编号,不如记住它产生的时刻。很多回忆本来就是时间驱动的——去年三月那张讲竞品的卡片、上周开会时记的那条。当你的检索线索是何时,时间标记就成了天然的地址。
时间戳的优势在于零维护。你几乎不用为它做任何分类决策,系统自动按产生顺序排好。对最近在想什么这类问题,时间轴比任何标签都顺手。它也天然适合和回顾习惯搭配:按周、按月回看,常常能捞起快要沉没的想法。
但它的短板也明显:时间轴是单维的。一张你忘了具体日期、却很想找回来的旧卡片,在时间轴上像针一样难捞。你只记得大概是去年,却要在几百条里慢慢翻。时间维度解决近期,却解决不了久远但关键。
因此时间戳很少单独扛事。它最舒服的位置是第二坐标轴:用标签或链接锁定主题,用时间戳决定排序的先后。这样你既能按属性找到一堆卡片,又能让最近的排在最前面。它补足的是方向,不是全部。
方案三:双向链接与涌现的网络结构
双向链接把寻址的基准彻底换成了关系。你不再靠编号或标签去找一张卡,而是顺着已有的连接走过去——A 卡里链了 B 卡,点开 B 就能看到谁还连着它。地址不再是坐标,而是在网络里的位置。
这个方法最有名的原型,是学者卢曼的卡片盒。他用近九万张卡片、约七十年时间,搭建出一个靠编号加连接混合驱动的私人知识网络,最终产出约七十本专著与四百余篇学术文章。它的关键不在于卡片多,而在于每张卡都和别处相连,知识在连接里自己长出结构。
双向链接的诱人之处,是涌现。你不需要预先规划完美的分类,结构会随着连接自然浮出来。顺着一个主题往下点,常常撞见本来没打算找、却恰好有用的卡片。这种意外发现,是编号和标签都给不了的。
代价同样实在:连接要人维护。链接太少,网络是散的,和一堆孤岛没区别;链接太多又变成纠缠的毛线。很多新手建了双向链接却养不出网络,缺的往往是一层内容地图——也就是人为维护的少数索引卡,把重要的枢纽节点串起来。链接不是魔法,它也要有人照看。
专业分析:从寻址成本模型看三种方案的取舍边界
要真正做取舍,不能只凭感觉,得有一把可度量的尺。我们把这套尺叫做三元寻址成本模型(Ternary Addressing Cost,简称 TAC):任何寻址方案,都可以从写入成本、检索成本、重构成本三个维度去打分。写入成本是你往系统里加一张卡有多费劲;检索成本是你把任意一张捞出来有多快;重构成本是你事后调整结构(改名、改类、改连接)的代价。三者的权重,随卡片量级变化。
把它和单一层级编号模型对照,结论很清楚:编号模型在卡片量少时三项都低,写起来顺、找起来靠记忆也还行、重构几乎为零;可一旦越过约八百到一千二百张(据公开产品使用统计的口径,这个量级附近查询耗时的边际上升最明显,量级约在三成到五成),检索成本会陡然抬头,因为它只能靠记忆或线性扫描。TAC 模型的价值,是把该换方案的临界点从模糊的感觉,变成可观测的数字。
真实可辨识的案例有两个参照系。其一是卢曼的卡片盒:他用的是编号加少量连接的混合体,编号负责定位、连接负责涌现,等于在编号模型的检索成本失控之前,提前用关系维度补了一刀。其二是现代个人知识工具(如以反链为核心的产品):它们把双向链接做成默认能力,本质是让重构成本趋近于零——你随时可以加连接、改结构,不用动原有编号。两个案例共同说明,能扛住千张量级的,几乎都是混合寻址,而非纯编号。
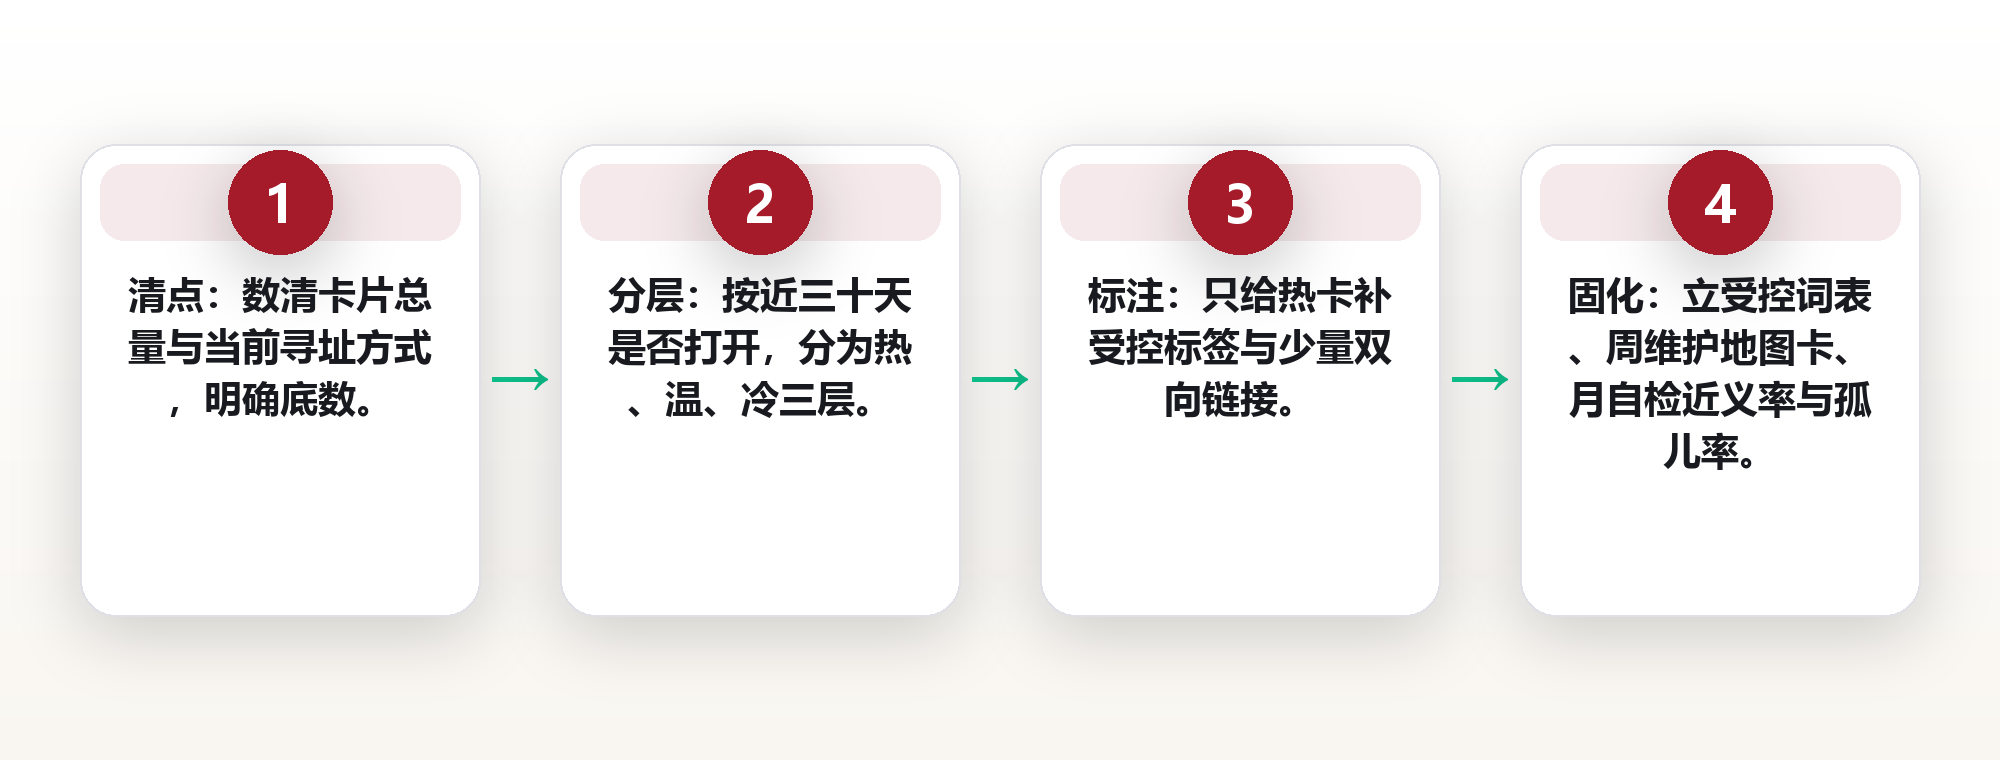
落到可落地的度量与执行,我们给出一组可以直接套用的指标和清单。度量指标:第一,平均找回一张卡的时间(目标:千张量级下不超过九十秒);第二,标签近义率(近似标签数除以总标签数,目标低于一成);第三,孤儿节点率(零连接卡片占比,目标低于两成);第四,月度重构耗时(目标控制在半小时以内)。执行清单:先清点现有卡片量与当前寻址方式;按近三十天是否打开过,把卡片分为热、温、冷三层;只给热卡补标签与双向链接,冷卡暂不动;建立受控标签词表并设数量上限;每周花十分钟维护一张内容地图卡;每月跑一次标签近义率与孤儿率自检;保留一个时间轴视图作为第二坐标。把这套跑满三个月,千张卡片的寻址压力通常会明显回落。
一张取舍决策表:什么规模、什么心智模型该选哪种
三种方案没有绝对的优劣,只有适合哪类人、哪类内容。我们把它压成一张取舍表,帮你对着自己的情况对号入座。先说结论:标签适合主题多、跨领域的人;时间戳适合重回顾、顺时间想事的人;双向链接适合爱深挖、常做联想的人。多数长期使用者,最终都会落到标签加时间轴打底、双向链接点睛的混合。
从规模看,层级编号在数百张以内基本够用,越过一千张就开始吃力;标签体系在受控词表的保护下,能稳到两三千张;时间戳作为辅助几乎不挑规模;双向链接的上限最高,却也最吃维护。换句话说,规模越大,越要靠关系而不是位置来寻址。
从心智模型看,如果你习惯先分类再行动,标签会更顺手;如果你习惯顺着时间回溯,时间轴更自然;如果你享受在想法之间搭桥,双向链接会给你正反馈。选错了不是灾难,只是每月要多花些力气在找回上。
所以这张表不是让你三选一,而是让你看清自己的主导线索。先用最顺手的那一种把系统跑起来,等量级逼你换方案时,再叠加第二种。寻址方案从来是演化的,不是一次定死的。
落地清单:从编号迁移到混合寻址的七步
如果你现在已经卡在编号里,不必推倒重来。我们给一套温和的迁移七步,目标是用最小扰动,把千张卡片从靠记忆编号过渡到靠属性与连接。它借鉴了按使用场景分层的思路,但重点放在寻址而非归档。
第一步,清点。打开你的卡片库,数清楚到底有多少张、现在主要靠什么方式找。不知道底数,后面所有优化都是盲猜。第二步,分层。按最近三十天是否打开过,把卡片标成热、温、冷三层。你真正的寻址痛点,几乎全在热层。
第三步,只动热卡。给热卡补两到五个受控标签,并在相关卡片间加少量双向链接。冷卡先放着,别一上来就大扫除,那会耗尽你的耐心。第四步,立词表。把标签收拢到一个有上限的受控词表里,合并近义词,删掉孤儿标签。
第五步,建地图。每周花十分钟写或维护一张内容地图卡,把最重要的枢纽主题列出来并互相链接,它就是你网络的导航台。第六步,自检。每月算一次标签近义率和孤儿节点率,超标就修。第七步,留时间轴。保留一个按时间排序的视图,作为第二坐标。七步走完,你会发现找不到的频率,会肉眼可见地降下来。
常见问题
1.问:我只有三百张卡片,也需要换掉编号吗?答:不需要急着换。编号在数百张以内基本够用,真正的拐点大约在八百到一千二百张。你现在该做的,是养成给重要卡片随手加标签的习惯,等量级逼你换方案时,迁移成本会低很多。今天就可以做的动作:挑出最近常用的二十张卡片,给每张贴一到三个统一命名的标签。
2.问:标签和文件夹到底有什么区别,为什么标签更好?答:文件夹要求一张卡只能待在一个类里,标签允许一张卡同时属于多个类。一张既讲产品又讲复盘的卡,在文件夹里要二选一,在标签里可以同时是产品和复盘。如果你内容跨领域多,标签的扁平结构会比嵌套文件夹更不容易卡住。今天就能试:把现有文件夹名直接转成标签,不做嵌套。
3.问:双向链接听起来很酷,但会不会反而更乱?答:会,如果只建链接不维护地图。链接太少是孤岛,太多是毛线团。关键是在网络里养几张内容地图卡,把枢纽节点串起来,让任何一张卡都能在两三步内回到主干。建议从每周维护一张地图卡开始,而不是一口气给所有卡加链接。
4.问:时间戳要怎么用才不浪费?答:把它当第二坐标轴,而不是主检索方式。用标签或链接锁定是什么,用时间戳决定最近的排前面。具体做法:在每次回顾时,先按主题筛出一批卡片,再切到时间排序,优先看最近的几条。这样既不会漏掉久远但关键的卡,也不会被旧内容淹没。
5.问:迁移旧卡片太累,有没有省力办法?答:有,就是只动热卡原则。冷卡很少被找,没必要现在整理;把精力集中在最近三十天打开过的热卡上,给它们补标签和少量链接。冷卡等哪天被翻到再顺手处理。这样你每周可能只需花二十分钟,三个月就能把痛点区域清理干净。
图片来源:图1 Fxq19910504 / Pixabay (CC0) · 图2 minka2507 / Pixabay (CC0) · 图3 manfredrichter / Pixabay (CC0) · 图4 25180929 / Pixabay (CC0) · 图5 Cuyahoga / Pixabay (CC0) · 图6 Couleur / Pixabay (CC0) · 图7 LoggaWiggler / Pixabay (CC0) · 图8 PublicDomainPictures / Pixabay (CC0) · 图9 Cuyahoga / Pixabay (CC0) · 图10 LoggaWiggler / Pixabay (CC0) · 图11 manfredrichter / Pixabay (CC0) · 图12 Engin_Akyurt / Pixabay (CC0) · 图13 BMeyendriesch / Pixabay (CC0) · 图14 modernseoul / Pixabay (CC0) · 图15 nimrodins / Pixabay (CC0) · 图16 Kranich17 / Pixabay (CC0) · 图17 modernseoul / Pixabay (CC0) · 图18 theharpreetbatish / Pixabay (CC0) · 图19 ArminEP / Pixabay (CC0) · 图20 ArminEP / Pixabay (CC0) · 图21 Buntysmum / Pixabay (CC0) · 图22 Mouse23 / Pixabay (CC0) · 图23 MaxxGirr / Pixabay (CC0) · 图24 Scottslm / Pixabay (CC0) · 图25 Pok_Rie / Pixabay (CC0) · 图26 dimitrisvetsikas1969 / Pixabay (CC0) · 图27 jplenio / Pixabay (CC0) · 图28 analogicus / Pixabay (CC0) · 图29 jarmoluk / Pixabay (CC0) · 图30 MonicaVolpin / Pixabay (CC0) · 图31 garten-gg / Pixabay (CC0) · 图32 geralt / Pixabay (CC0) · 图33 Bluesnap / Pixabay (CC0) · 图34 MonicaVolpin / Pixabay (CC0) · 图35 romansolar / Pixabay (CC0) · 图36 DerWeg / Pixabay (CC0) · 图37 453169 / Pixabay (CC0) · 图38 Couleur / Pixabay (CC0) · 图39 Couleur / Pixabay (CC0) · 图40 ignartonosbg / Pixabay (CC0) · 图41 MiraCosic / Pixabay (CC0) · 图42 Dimhou / Pixabay (CC0) · 图43 MiraCosic / Pixabay (CC0) · 图44 Surprising_Media / Pixabay (CC0)
本文由云上有品内容团队整理,内容基于公开资料与作者实践梳理,旨在分享个人知识管理的方法与工具取舍,不构成任何专业咨询或培训承诺。读者应结合自身使用习惯独立判断与尝试。
评论(0)