
基本信息
阅读时间:约 14 分钟
字数:约 6,681 字
摘要:市场担心:文献管理是一项被夹在数据库与写作软件之间的低价值工作——谁都能做,因此只能靠免费或低价竞争。
| — | 摘要与核心预期差 |
| 01 | 产品界定与使用场景 |
| 02 | 库存结构与流动性 |
| 03 | 格式校对:唯一的硬需求 |
| 04 | 互通性与工具碎片化 |
| 05 | 协作与团队文献库 |
| 06 | 商业模式与转化 |
| 07 | 量化测算与三情景 |
| 08 | 风险提示 |
| 09 | 结论与观察指标 |
| A | 附录 A · 数据来源与证据表 |
| B | 附录 B · 可证伪链台账 |
| C | 附录 C · 数据档次说明 |
摘要与核心预期差
市场担心:文献管理是一项被夹在数据库与写作软件之间的低价值工作——谁都能做,因此只能靠免费或低价竞争。
我们认为:文献管理的价值不在存储,而在校对。引用格式错误的返工成本由研究者承担,而格式规则的维护成本极高且持续变化。因格式问题产生返工的研究者比例约 42%(测算),这个比重说明「格式正确性」才是这项产品真正的卖点 [4]。
- 渗透不低:使用专用文献管理软件的研究者比重约 61%(测算),这不是一个小众市场 [1];
- 库存高但流动性低:累计管理文献量中位数约 340 篇(测算),而每月的导入导出动作约 7.4 次 [2];
- 返工才是痛点:约 42% 的研究者经历过引用格式造成的返工 [4];
- 工具分散:研究者平均同时使用约 2.6 个工具(测算),互通性因此比功能多寡更重要 [12]。
| 动作 | 月频次 | 是否产生价值 | 产品责任 |
|---|---|---|---|
| 检索并导入 | 高 | 中 | 提高导入准确率 |
| 插入与排版 | 高 | 高 | 保证格式正确 |
| 导出与投稿 | 中 | 高 | 覆盖目标期刊格式 |
| 协作共享 | 低 | 中 | 控制权限与版本 |
01产品界定与使用场景
本报告把「文献引用管理」界定为:以支持文献元数据采集、去重、标注、并在写作过程中自动插入与校对引用为特征的软件能力。
| 场景 | 主要动作 | 停留时长 | 本报告是否采用 |
|---|---|---|---|
| 学位论文 | 长期积累与反复校对 | 长 | 主口径 |
| 期刊投稿 | 格式适配与导出 | 短 | 主口径 |
| 课题组协作 | 共享与分工 | 中 | 主口径 |
| 阅读摘录 | 批注与引文摘录 | 中 | 作对照 |
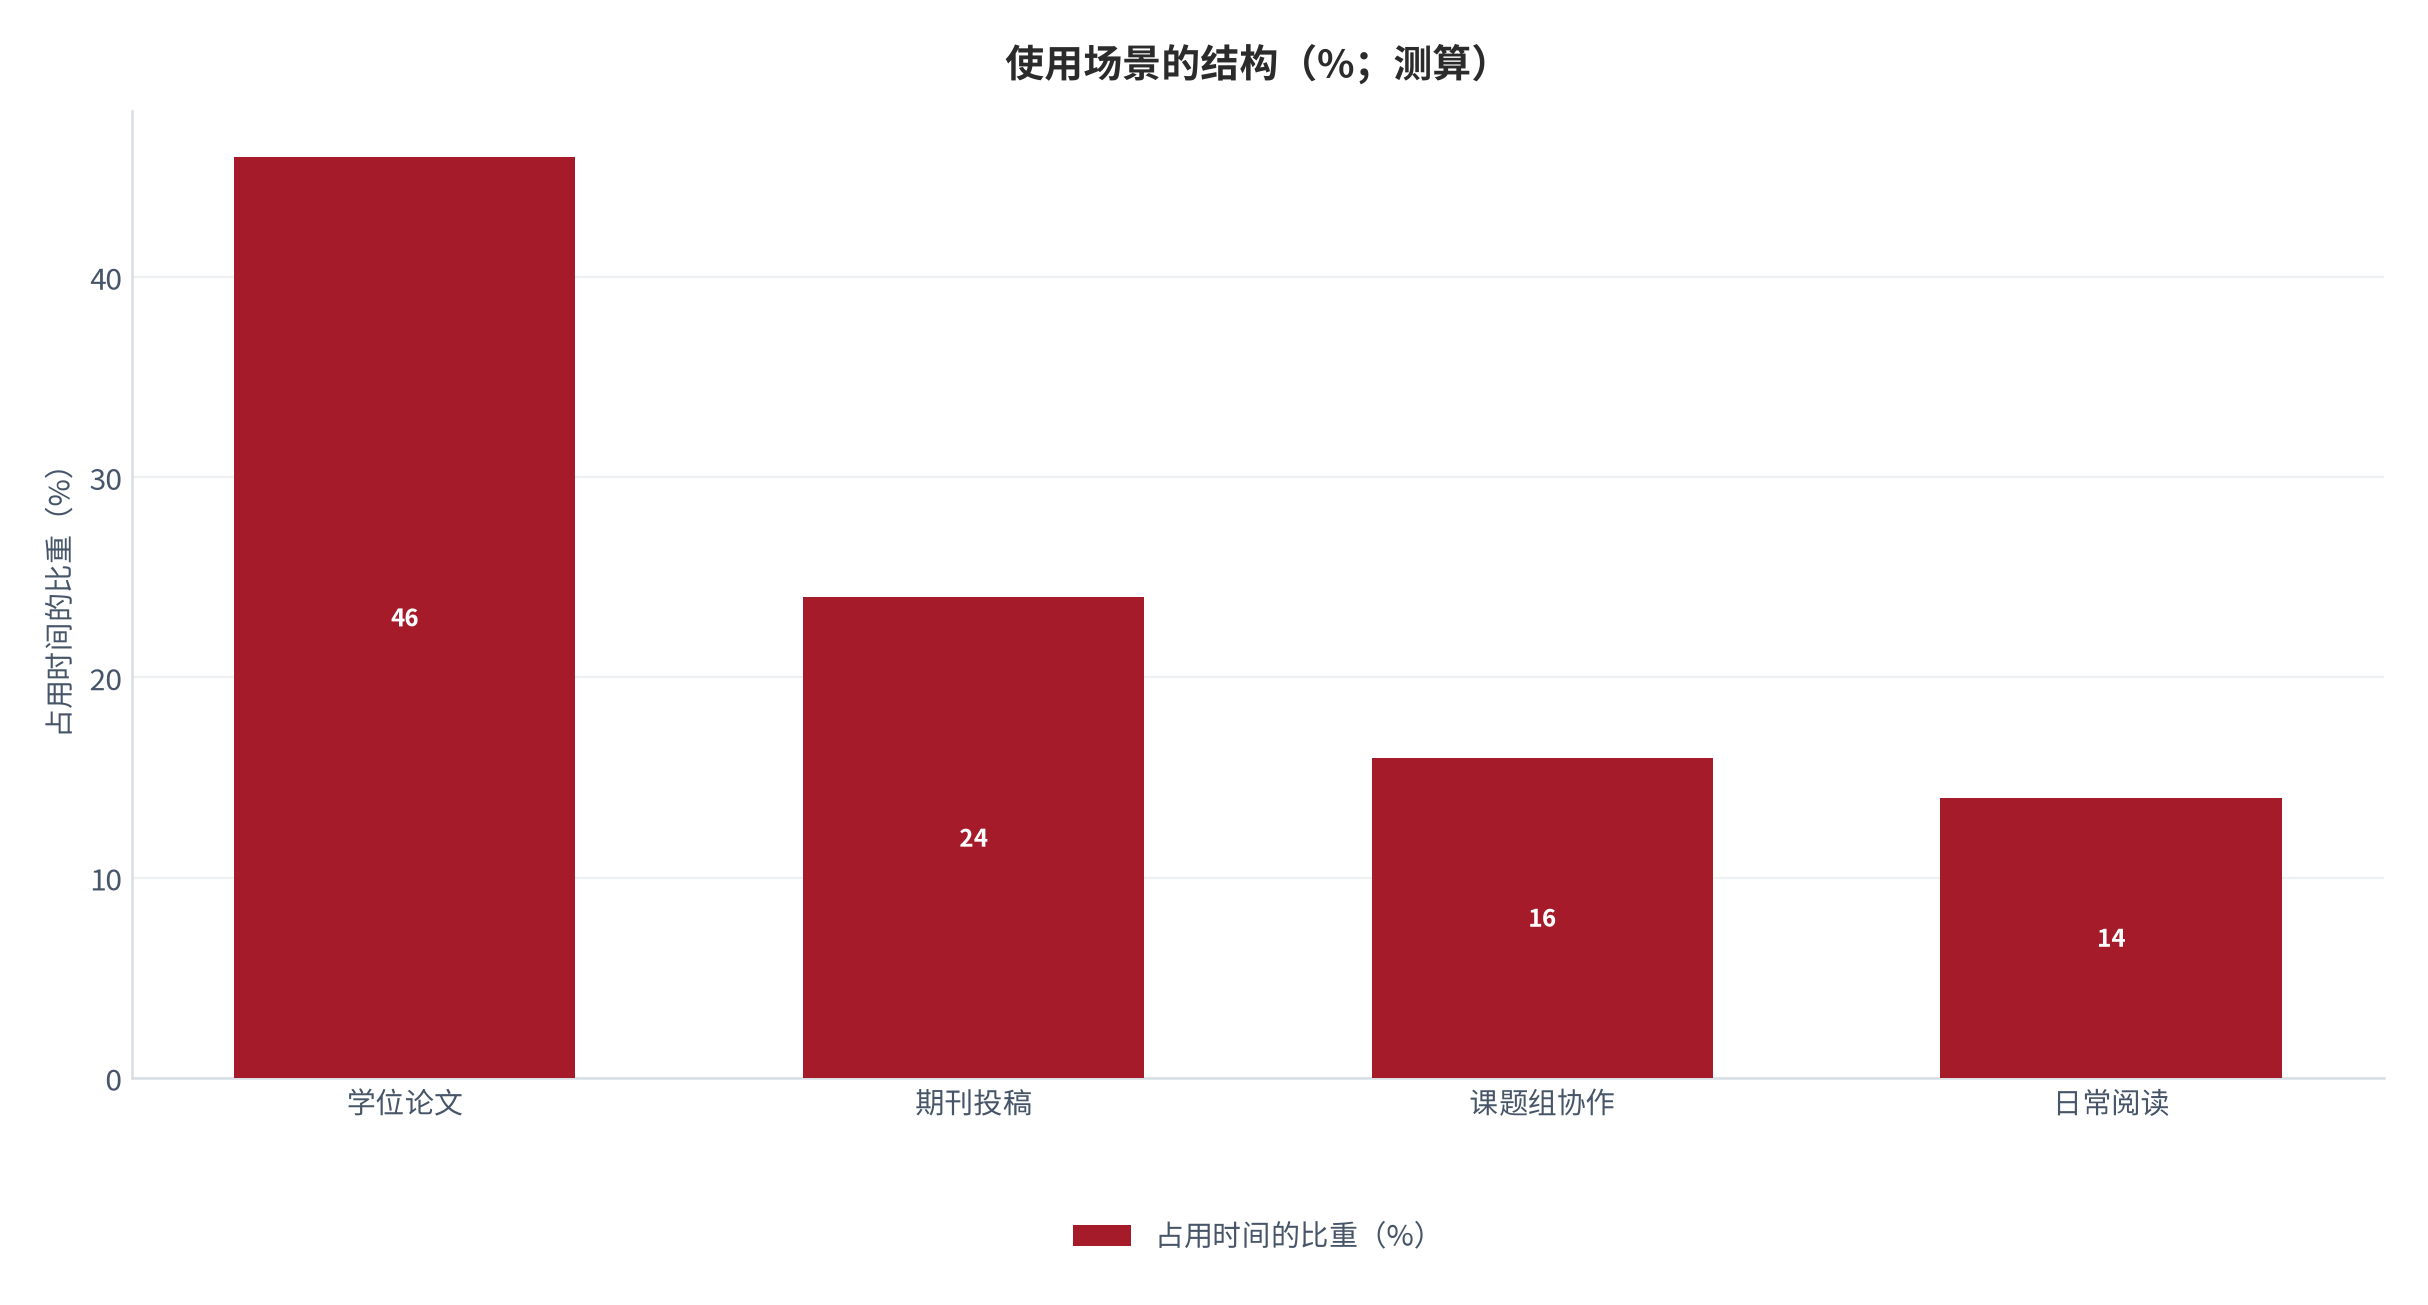
把场景切开之后,一个规律清晰起来:用时最长的场景恰恰是对格式正确性要求最极端的场景。学位论文的引用格式一旦出错,通常要在送审前集中返工。
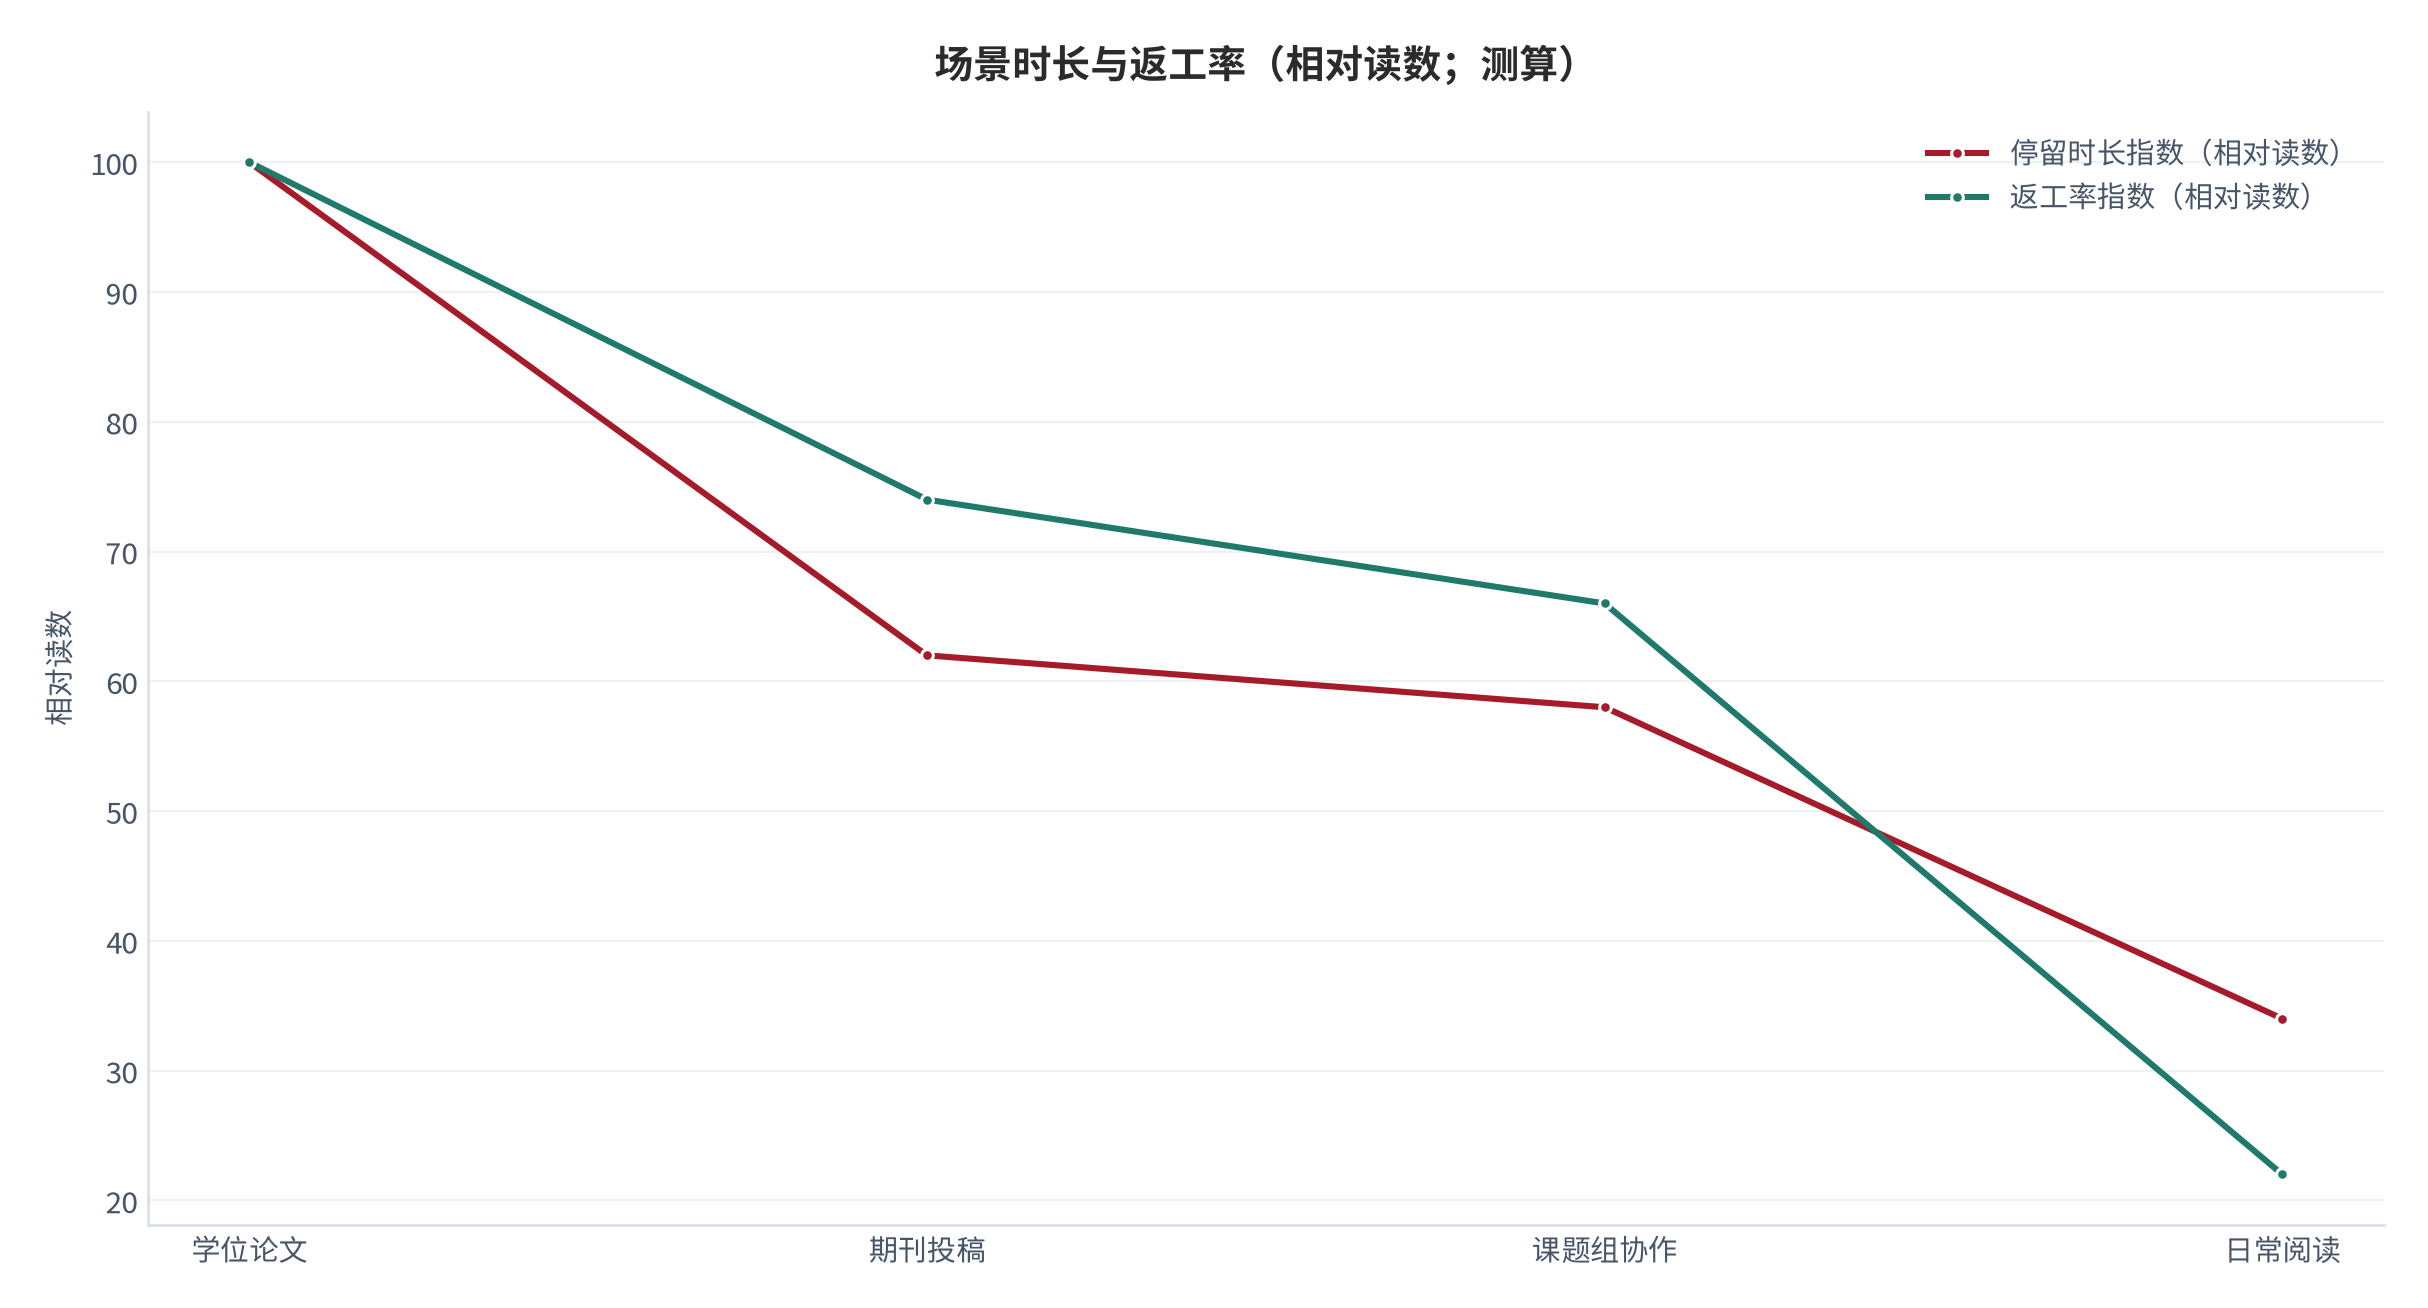
这直接给出了产品的价值排序:与其做一个更全的阅读器,不如把投稿环节的格式覆盖做宽。覆盖不到的格式,就是流失点 [3]。
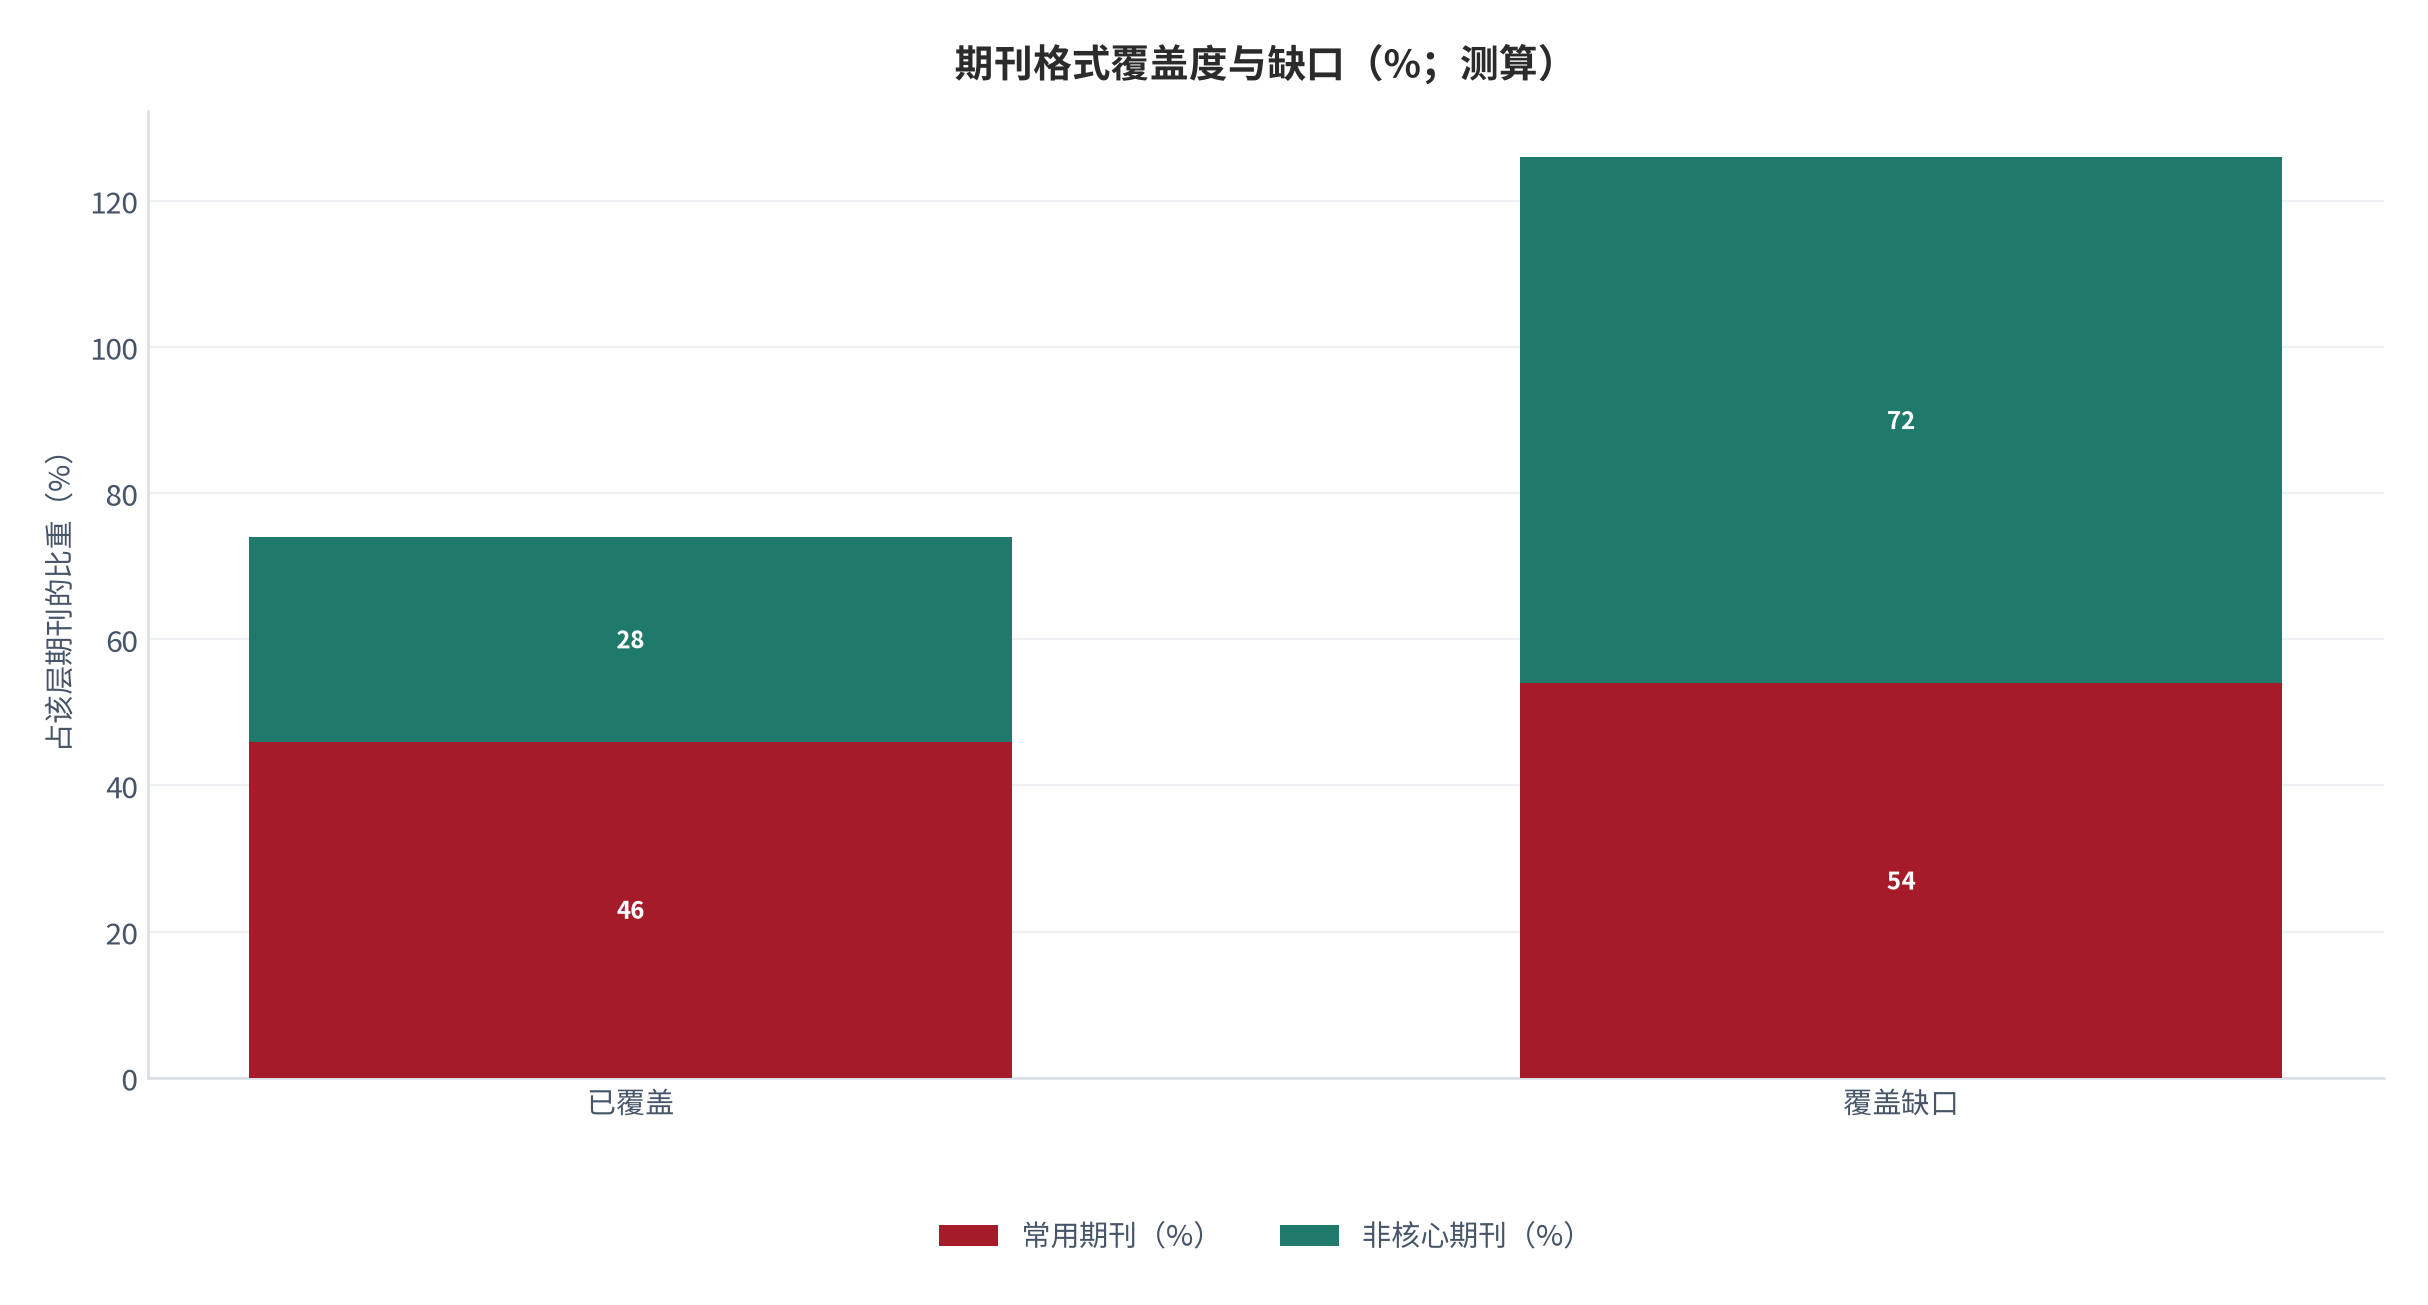
覆盖缺口是流失点最集中的地方:一种期刊的引用格式要被正确生成,需要作者信息、出处信息与编号规则三者同时到位,任一环缺失都会让用户退回手工整理 [7]。
02库存结构与流动性
研究者累计管理的文献量中位数约 340 篇(测算),但这个数字在不同人群之间差异极大。重要的是库存结构与流动性之间的关系。
| 分层 | 文献量 | 占研究者比重 | 活跃度 |
|---|---|---|---|
| 轻度用户 | 不足 100 篇 | 约 34% | 低 |
| 中度用户 | 100–500 篇 | 约 41% | 中 |
| 重度用户 | 500 篇以上 | 约 25% | 高 |
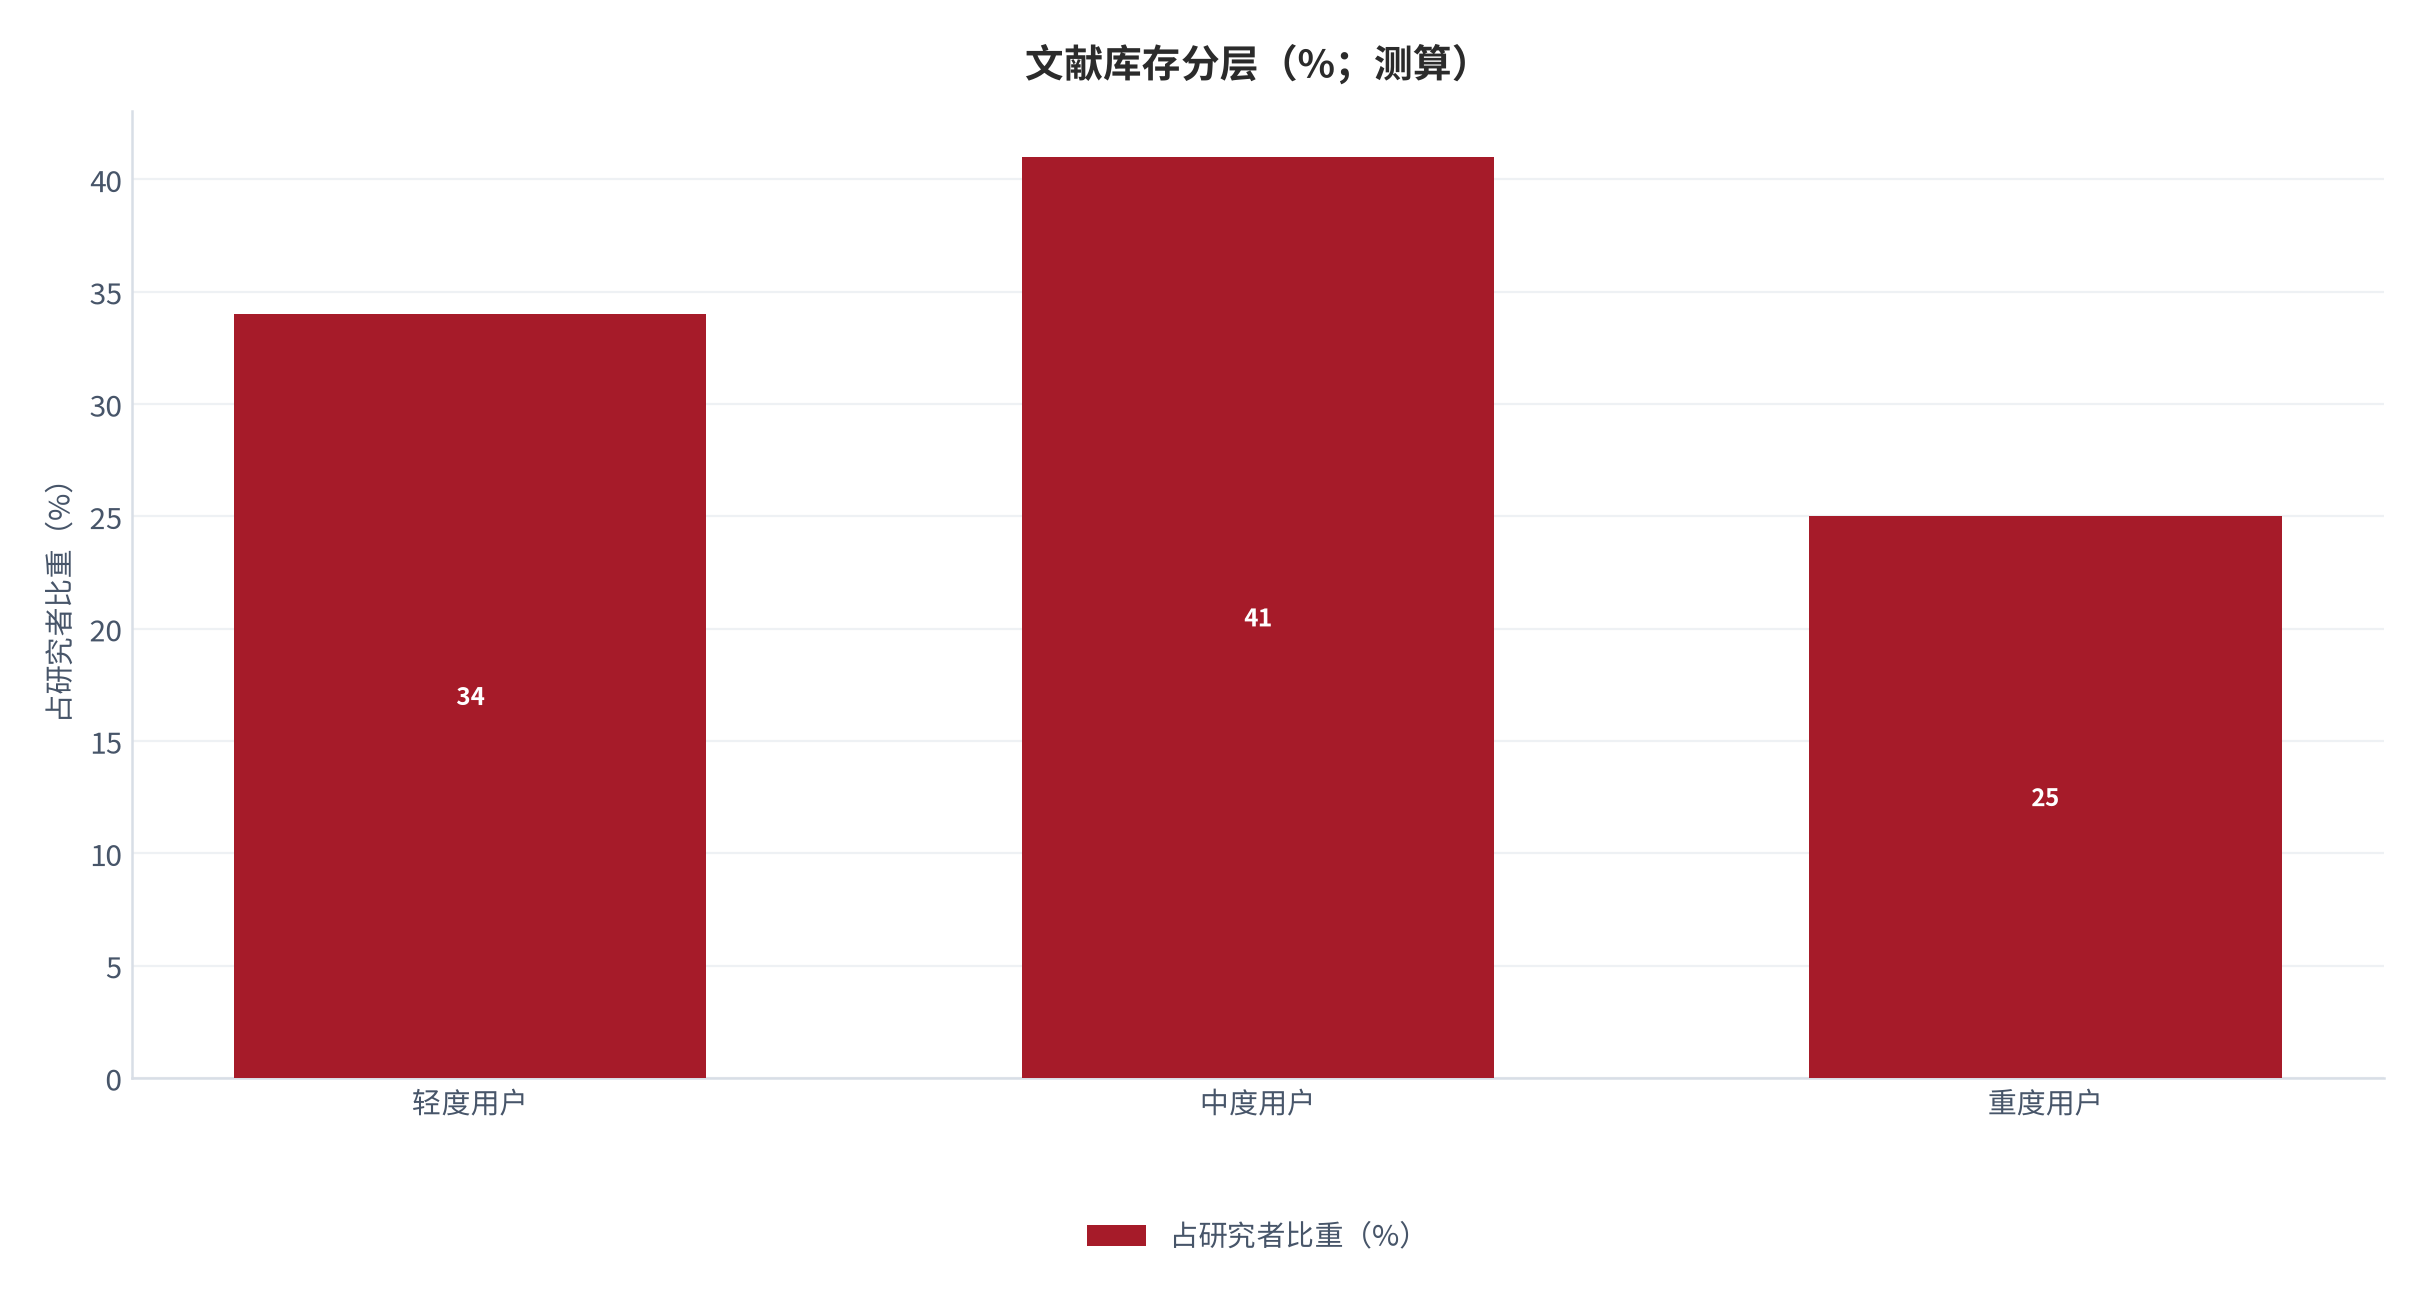
这里有一个容易被忽略的结构:库存最大的那部分文献几乎不再被打开。一个中度用户的三百多篇文献里,真正频繁被引用的通常不足两成。
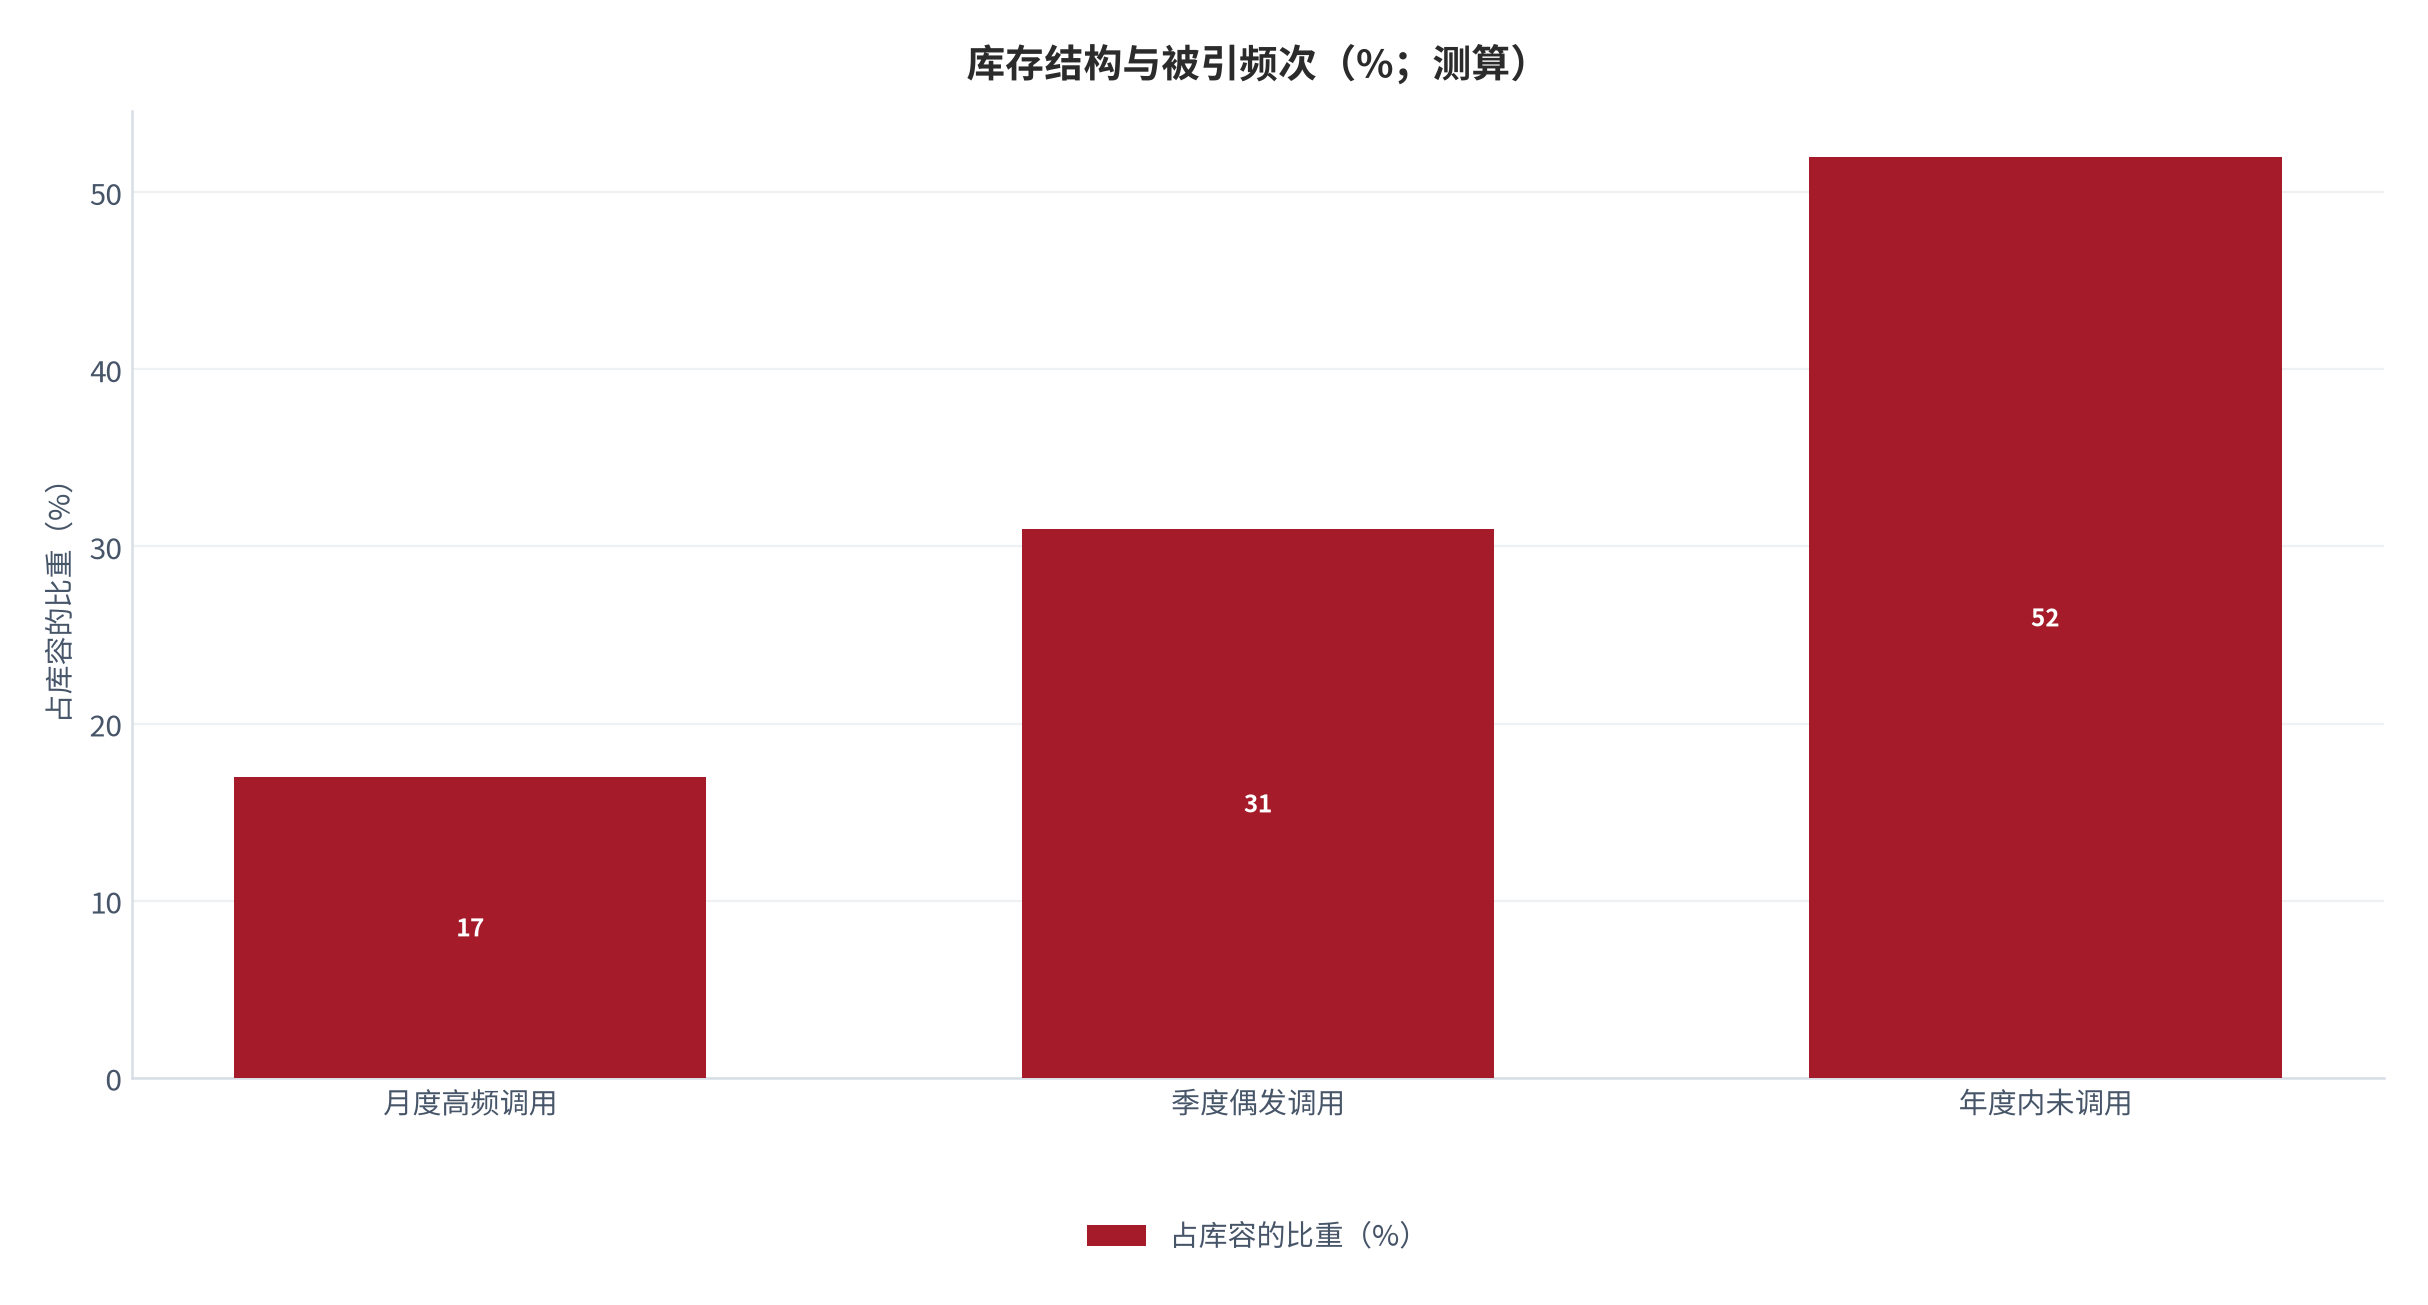
这个结构直接决定了产品该怎么投入:把资源投在全库检索上的回报很低,而投在「最近在读的二十篇」上的回报明显更高。文献库存主要来自自动采集,手动录入的比例很低 [6]。
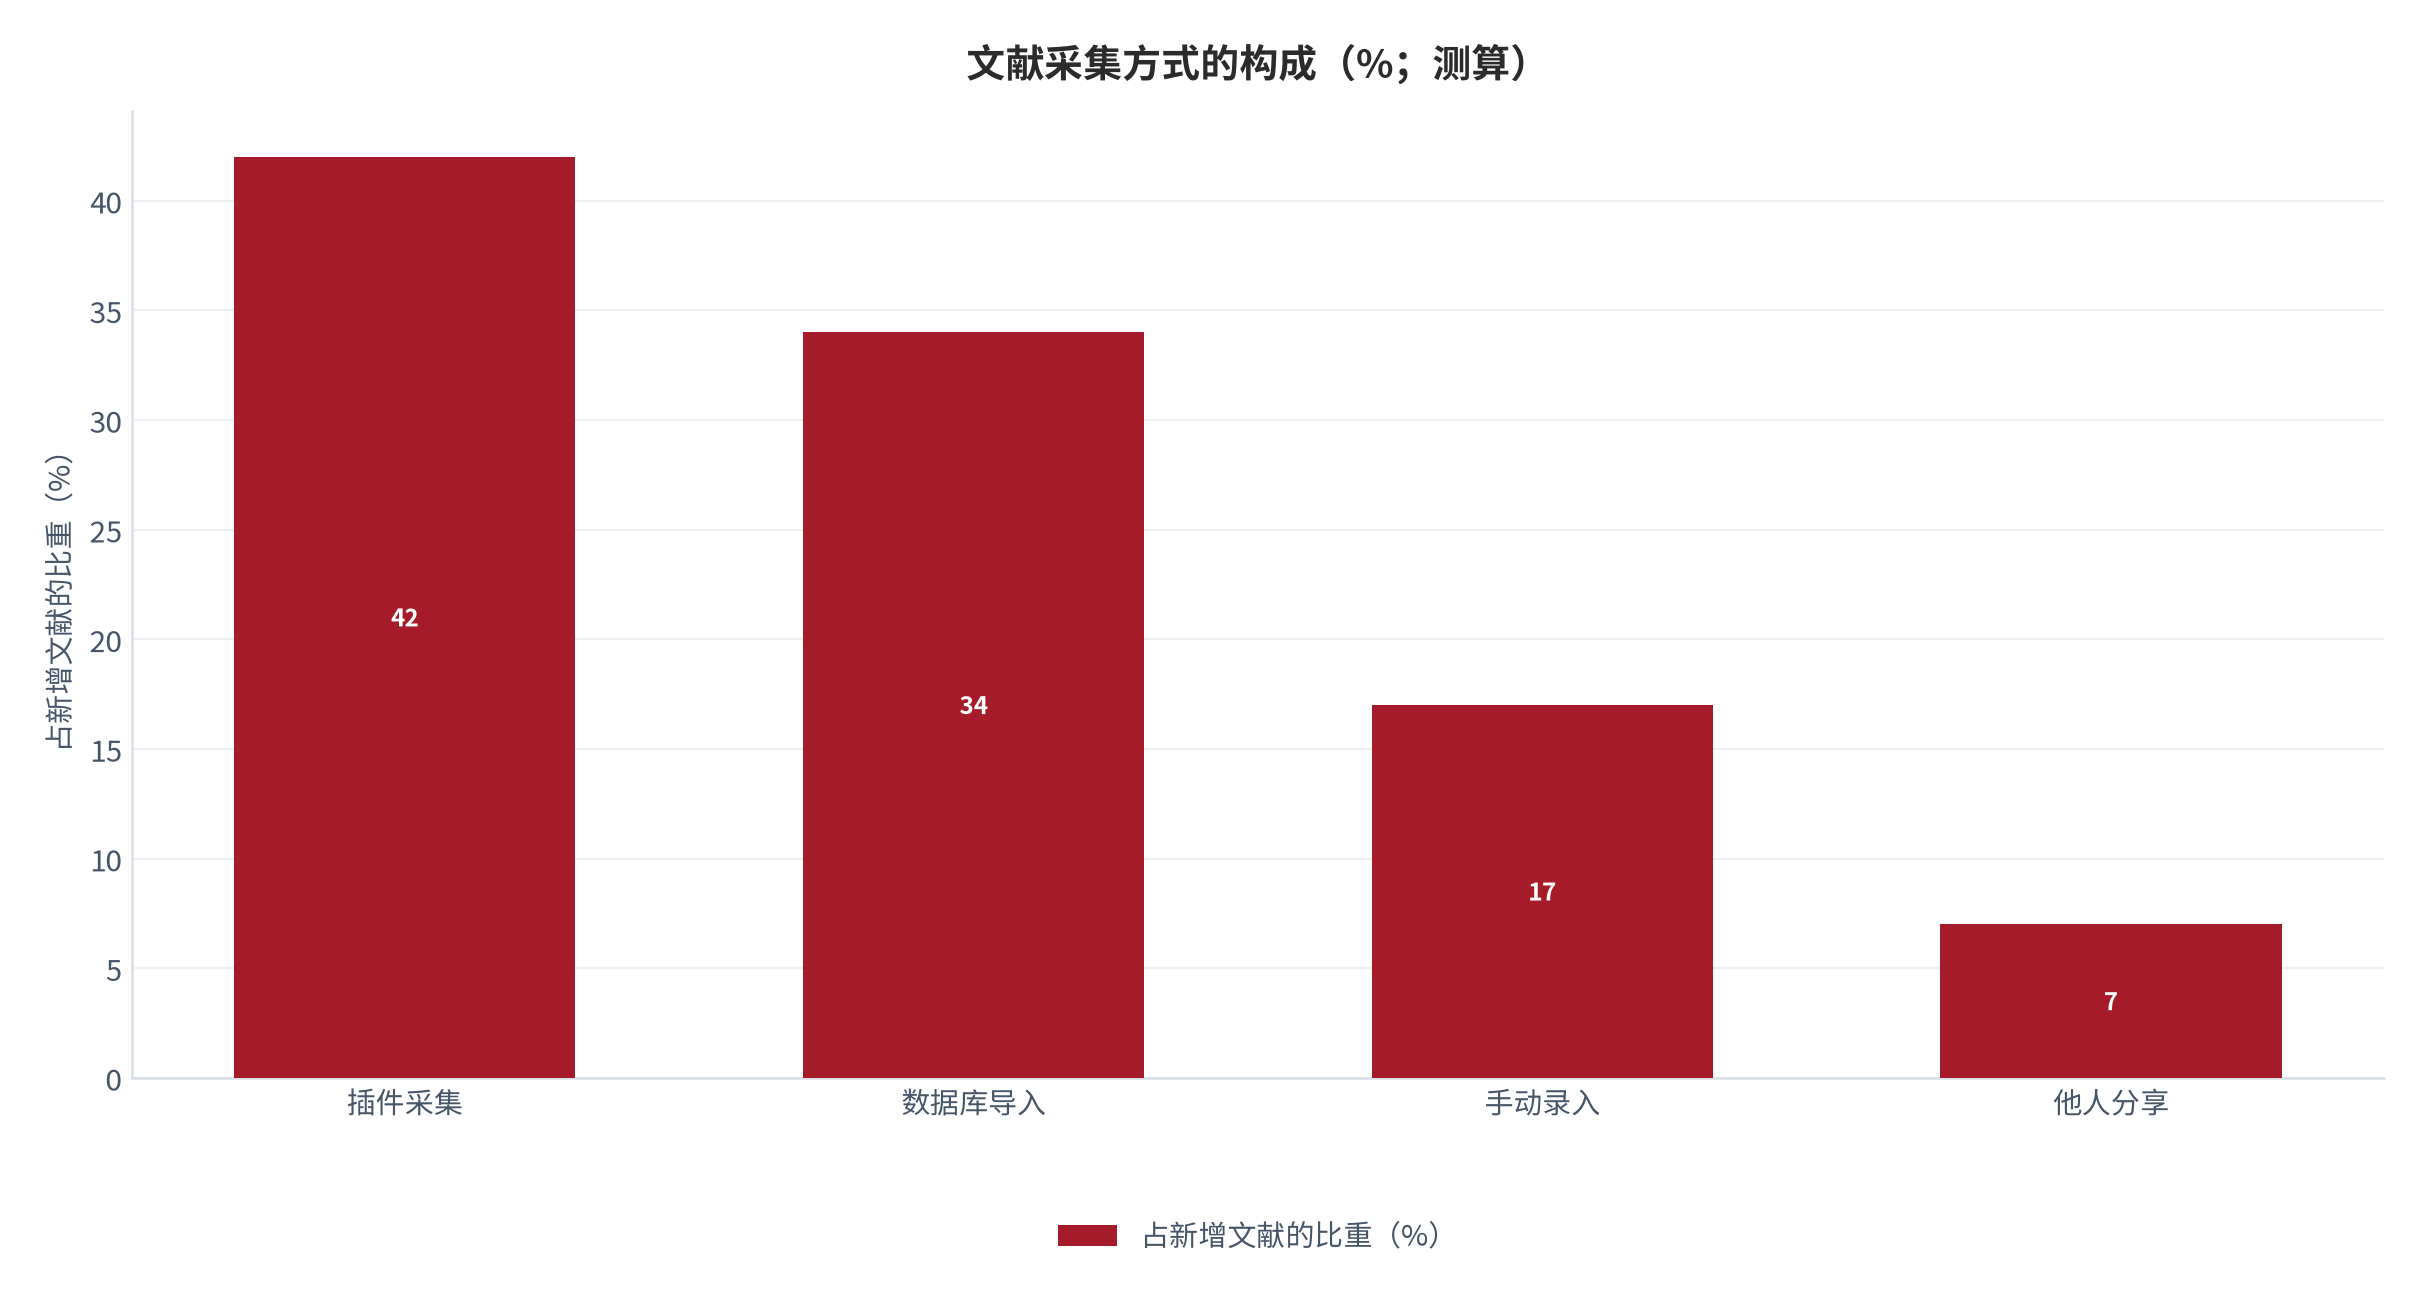
采集方式决定了库存的增长曲线:自动采集把入库的边际成本压到接近于零,也让库存在两年内迅速堆到数百篇,但采集成功率下降时,用户会立刻怀疑整库的可靠性 [6]。
03格式校对:唯一的硬需求
引用格式的规则数量庞大且持续更新。一条规则的变化可能让整篇论文的参考文献表失效,这正是约 42% 的研究者遭遇过的返工来源 [4];常用期刊的格式覆盖度仍不足五成,覆盖缺口正是返工来源 [7]。
| 问题类型 | 占比 | 发现时机 | 修复成本 |
|---|---|---|---|
| 字段缺失 | 约 31% | 提交前 | 低 |
| 格式不合期刊要求 | 约 27% | 提交时 | 中 |
| 重复条目 | 约 18% | 写作中 | 低 |
| 引文与正文对不上 | 约 24% | 送审后 | 高 |
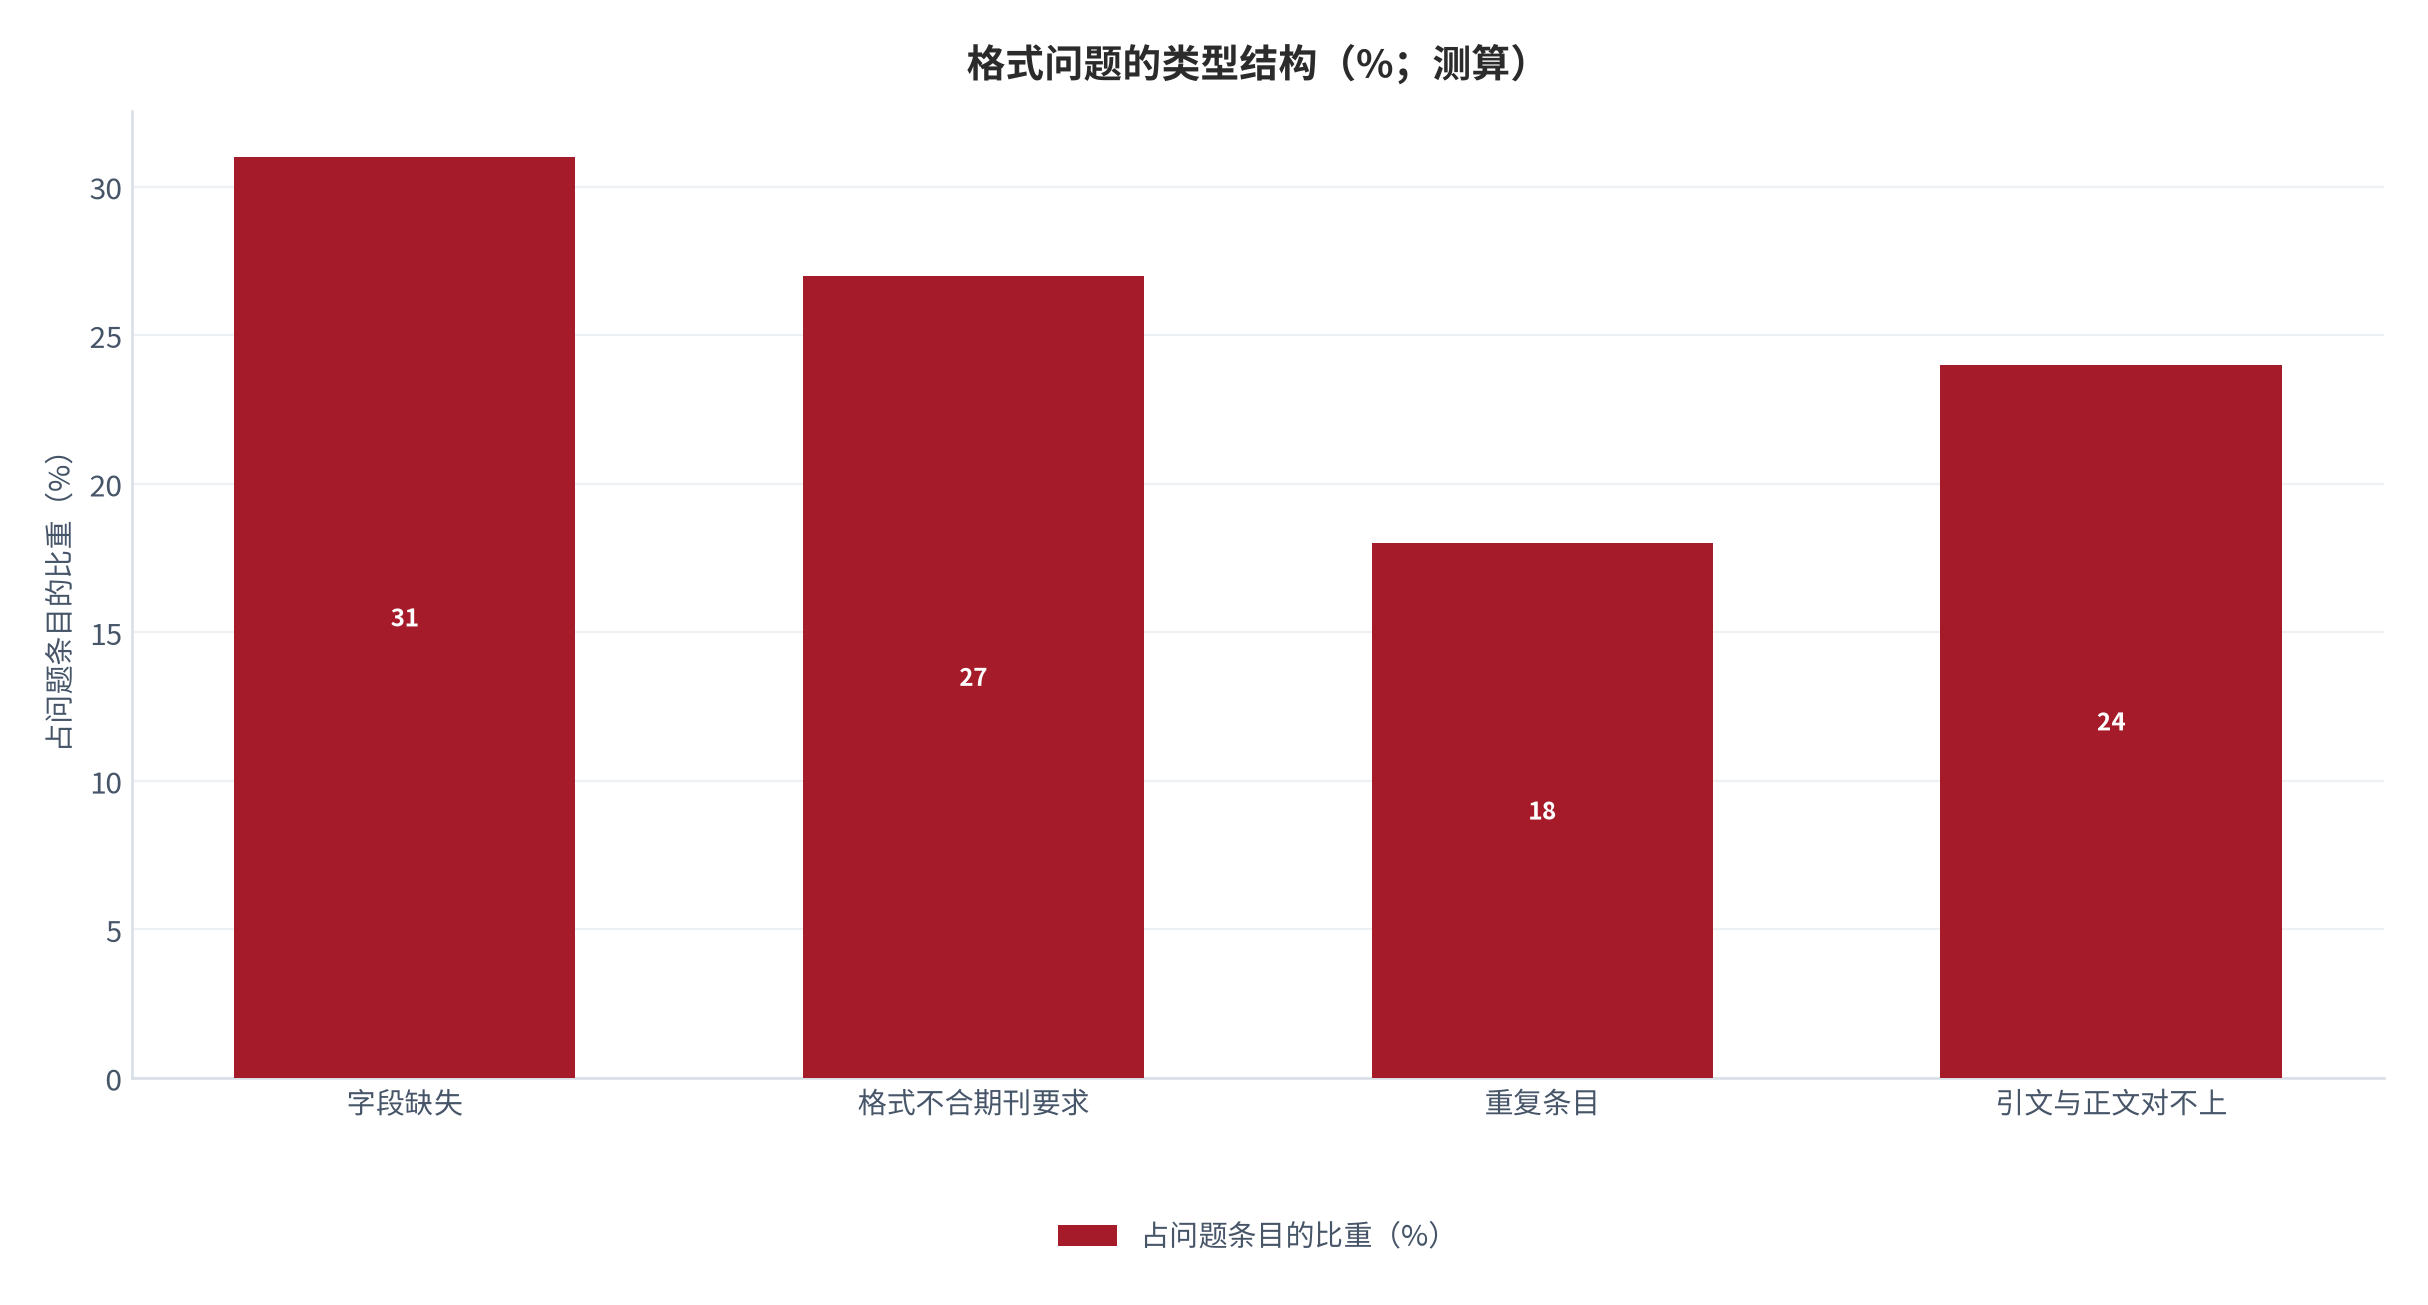
问题类型的分布决定了产品的合理形态:字段缺失与重复条目可以在导入阶段解决,而引文与正文对不上必须在写作过程中持续校验——这类问题恰恰修复成本最高。
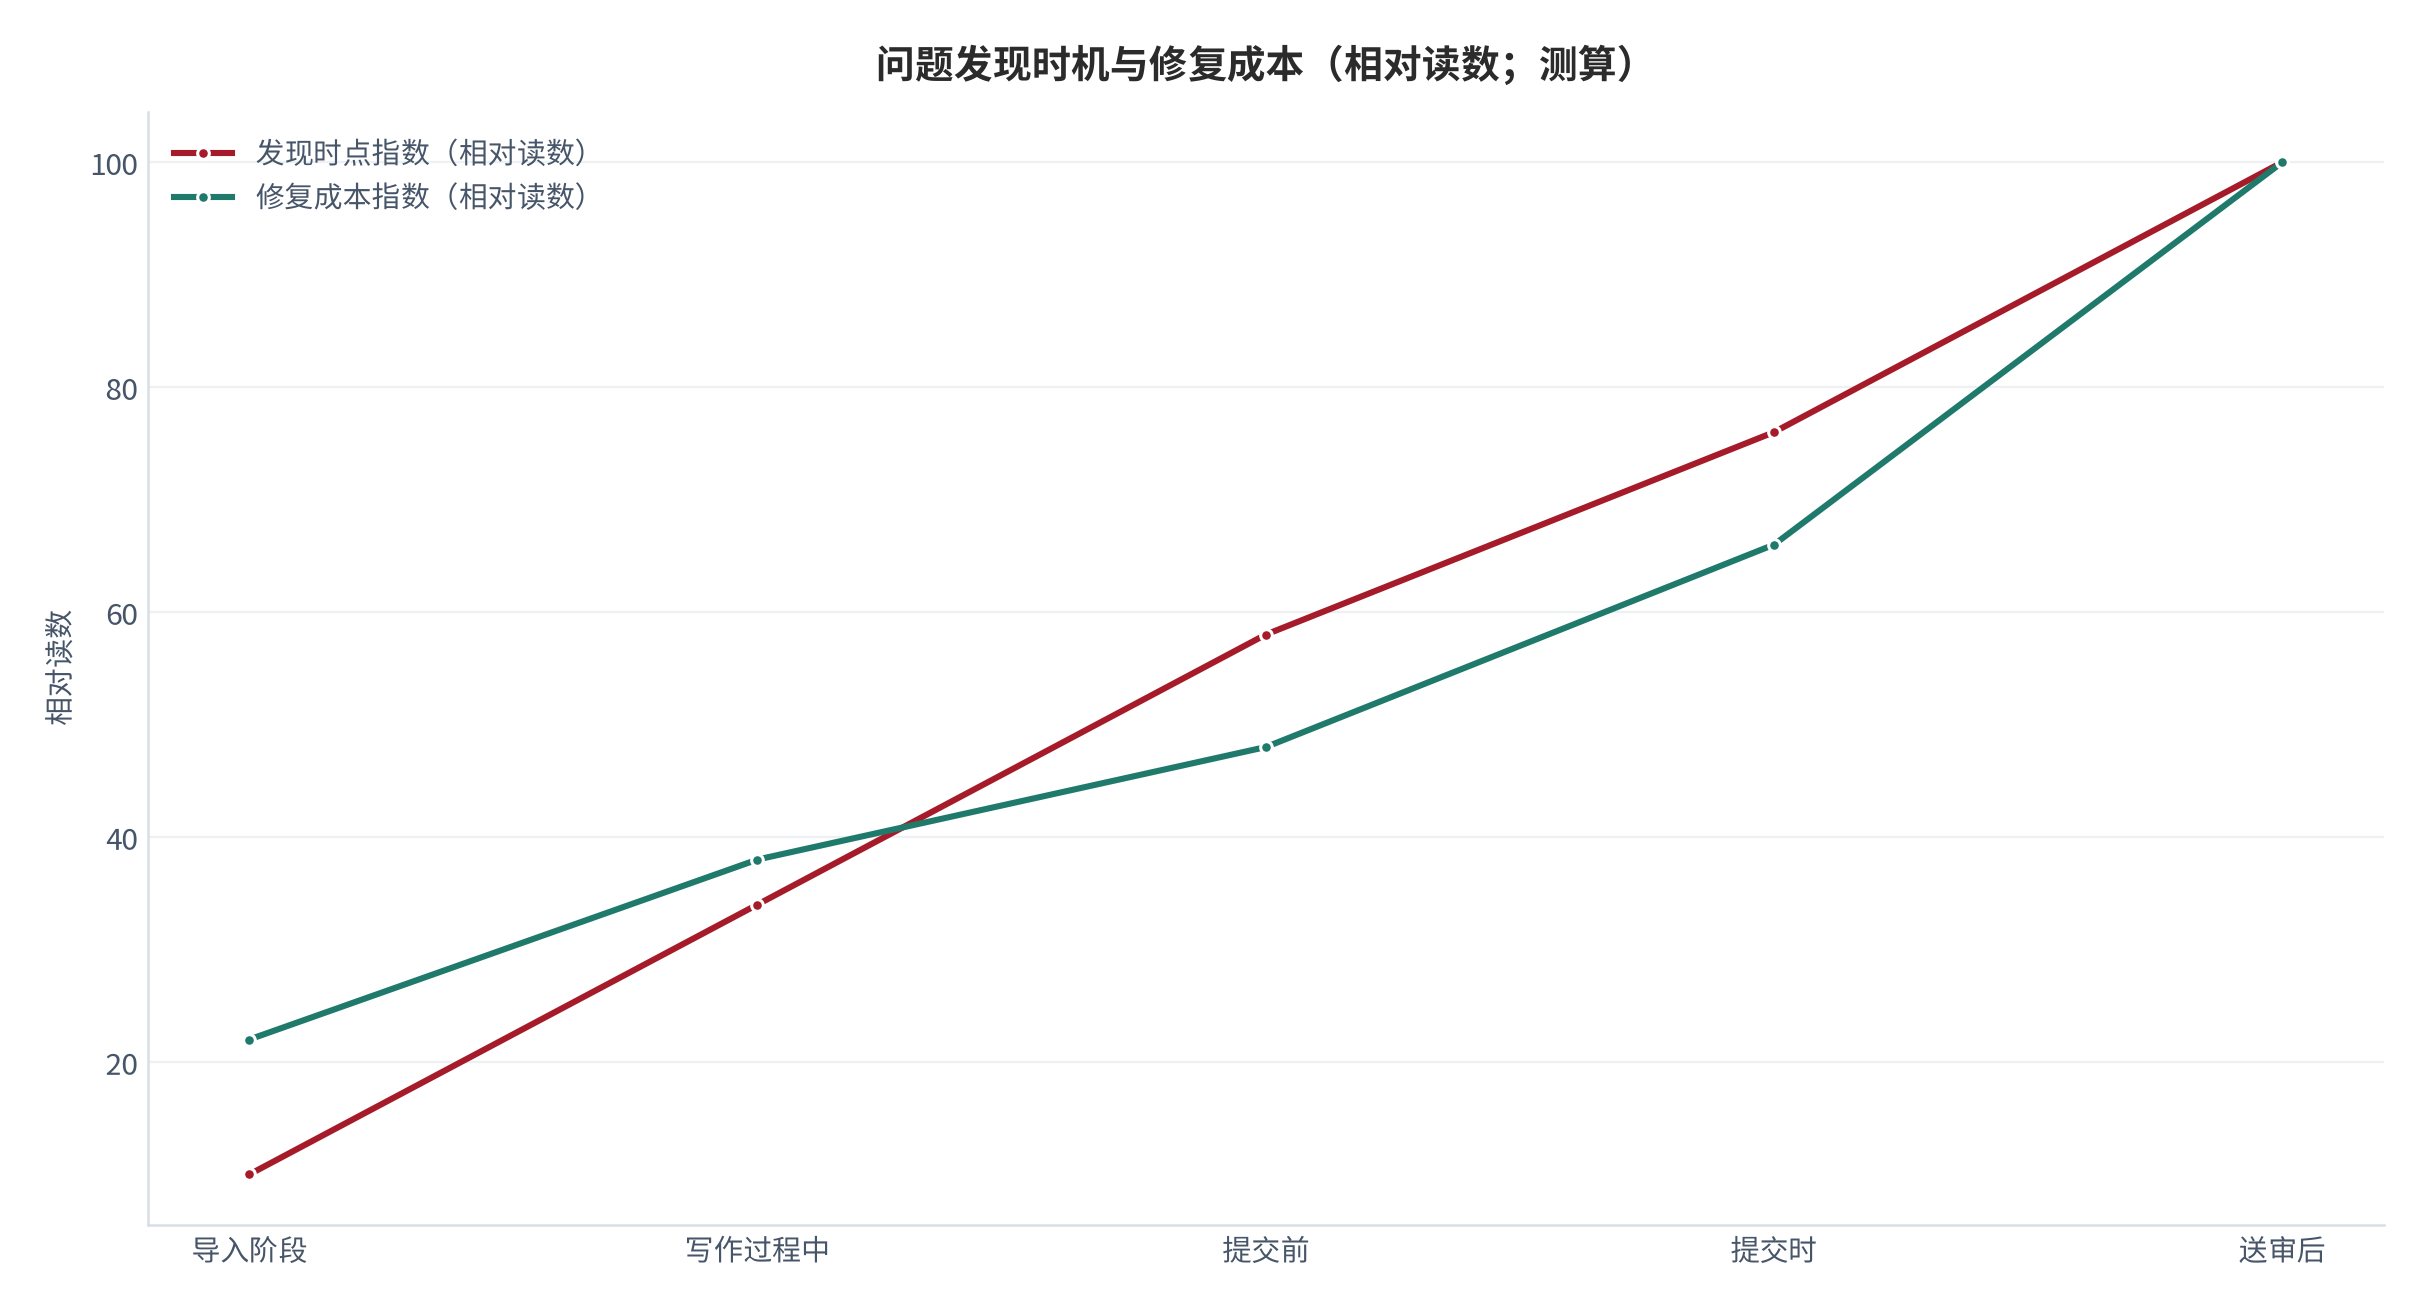
由此得到一个明确的产品结论:持续校验的价值高于一次性清理。把校对做成写作过程中的常驻动作 [5],能把送审后的高成本返工压到接近于零。
04互通性与工具碎片化
研究者平均同时使用约 2.6 个工具(测算),这个数字本身就是产品的痛点清单。工具越多,互通性的价值就越高 [12]。
| 转换动作 | 发生比例 | 耗时 | 数据损失 |
|---|---|---|---|
| 导出导入互转 | 约 46% | 中 | 低 |
| 浏览器插件采集 | 约 71% | 短 | 无 |
| 写作软件插入 | 约 88% | 短 | 无 |
| 团队库合并 | 约 12% | 长 | 中 |
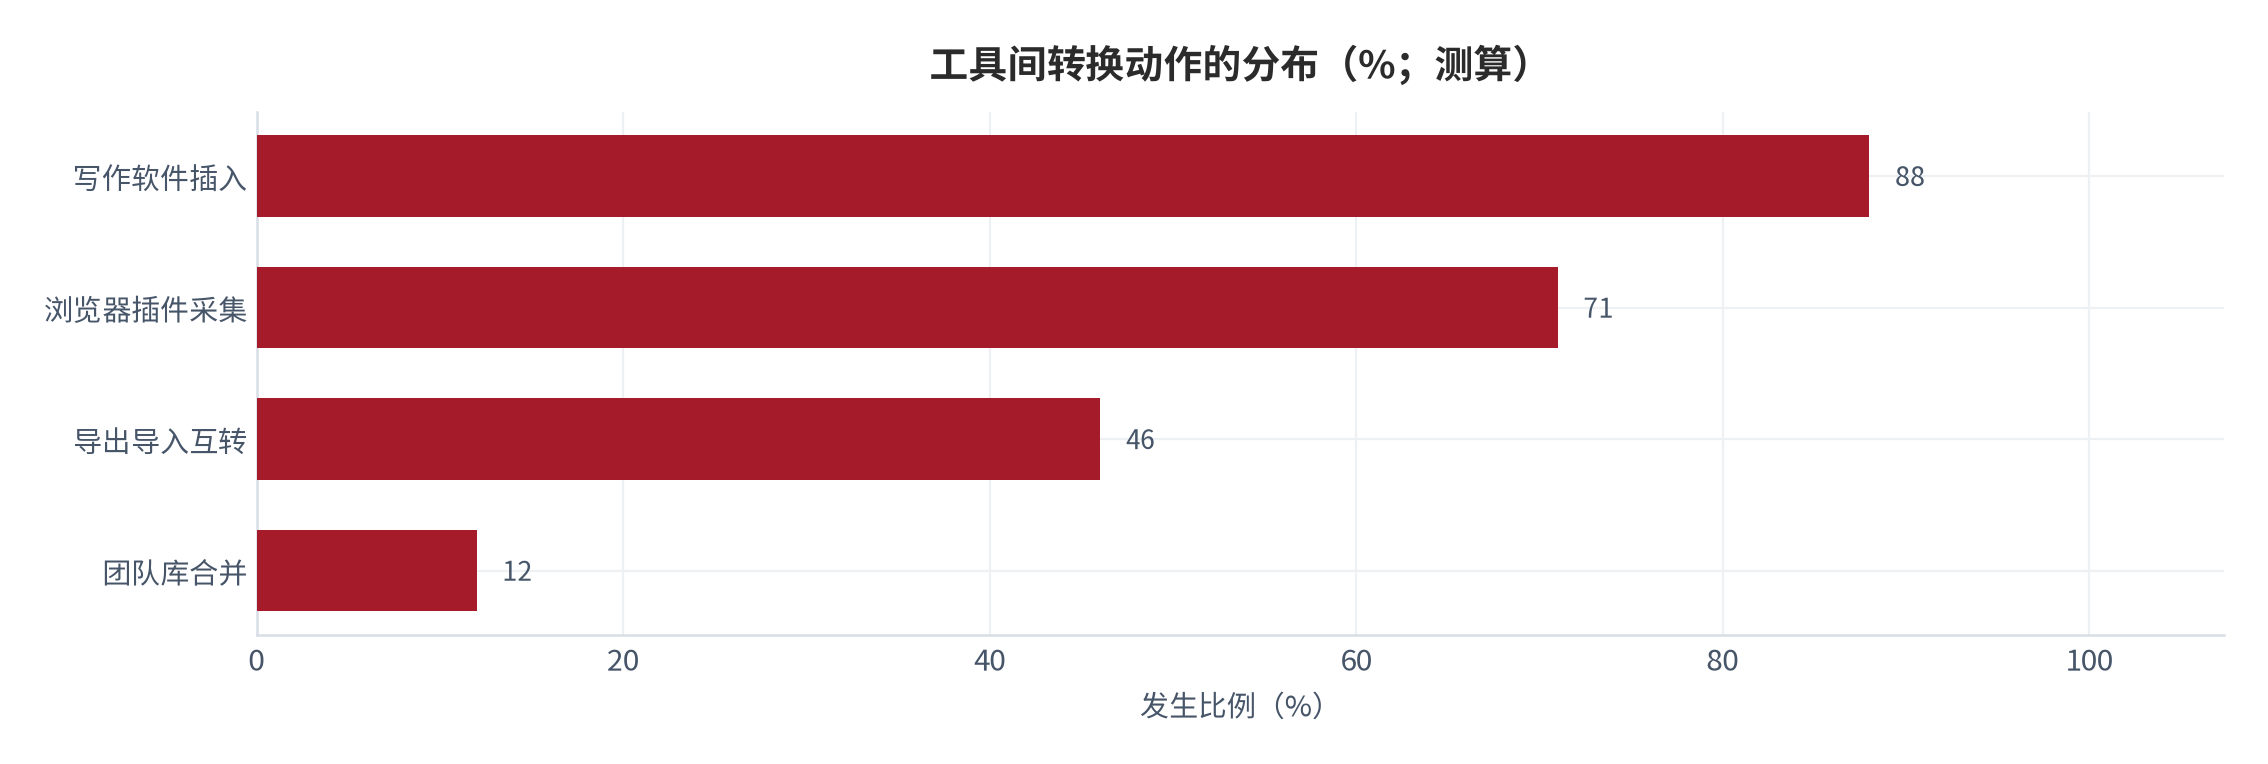
这张图里最值得注意的是:最高频的两个动作都是「无损耗」的,而唯一会造成数据损失的库合并动作,发生比例却很低。这说明互通性问题的痛点不在一次性的迁移,而在每天都要面对的往返。
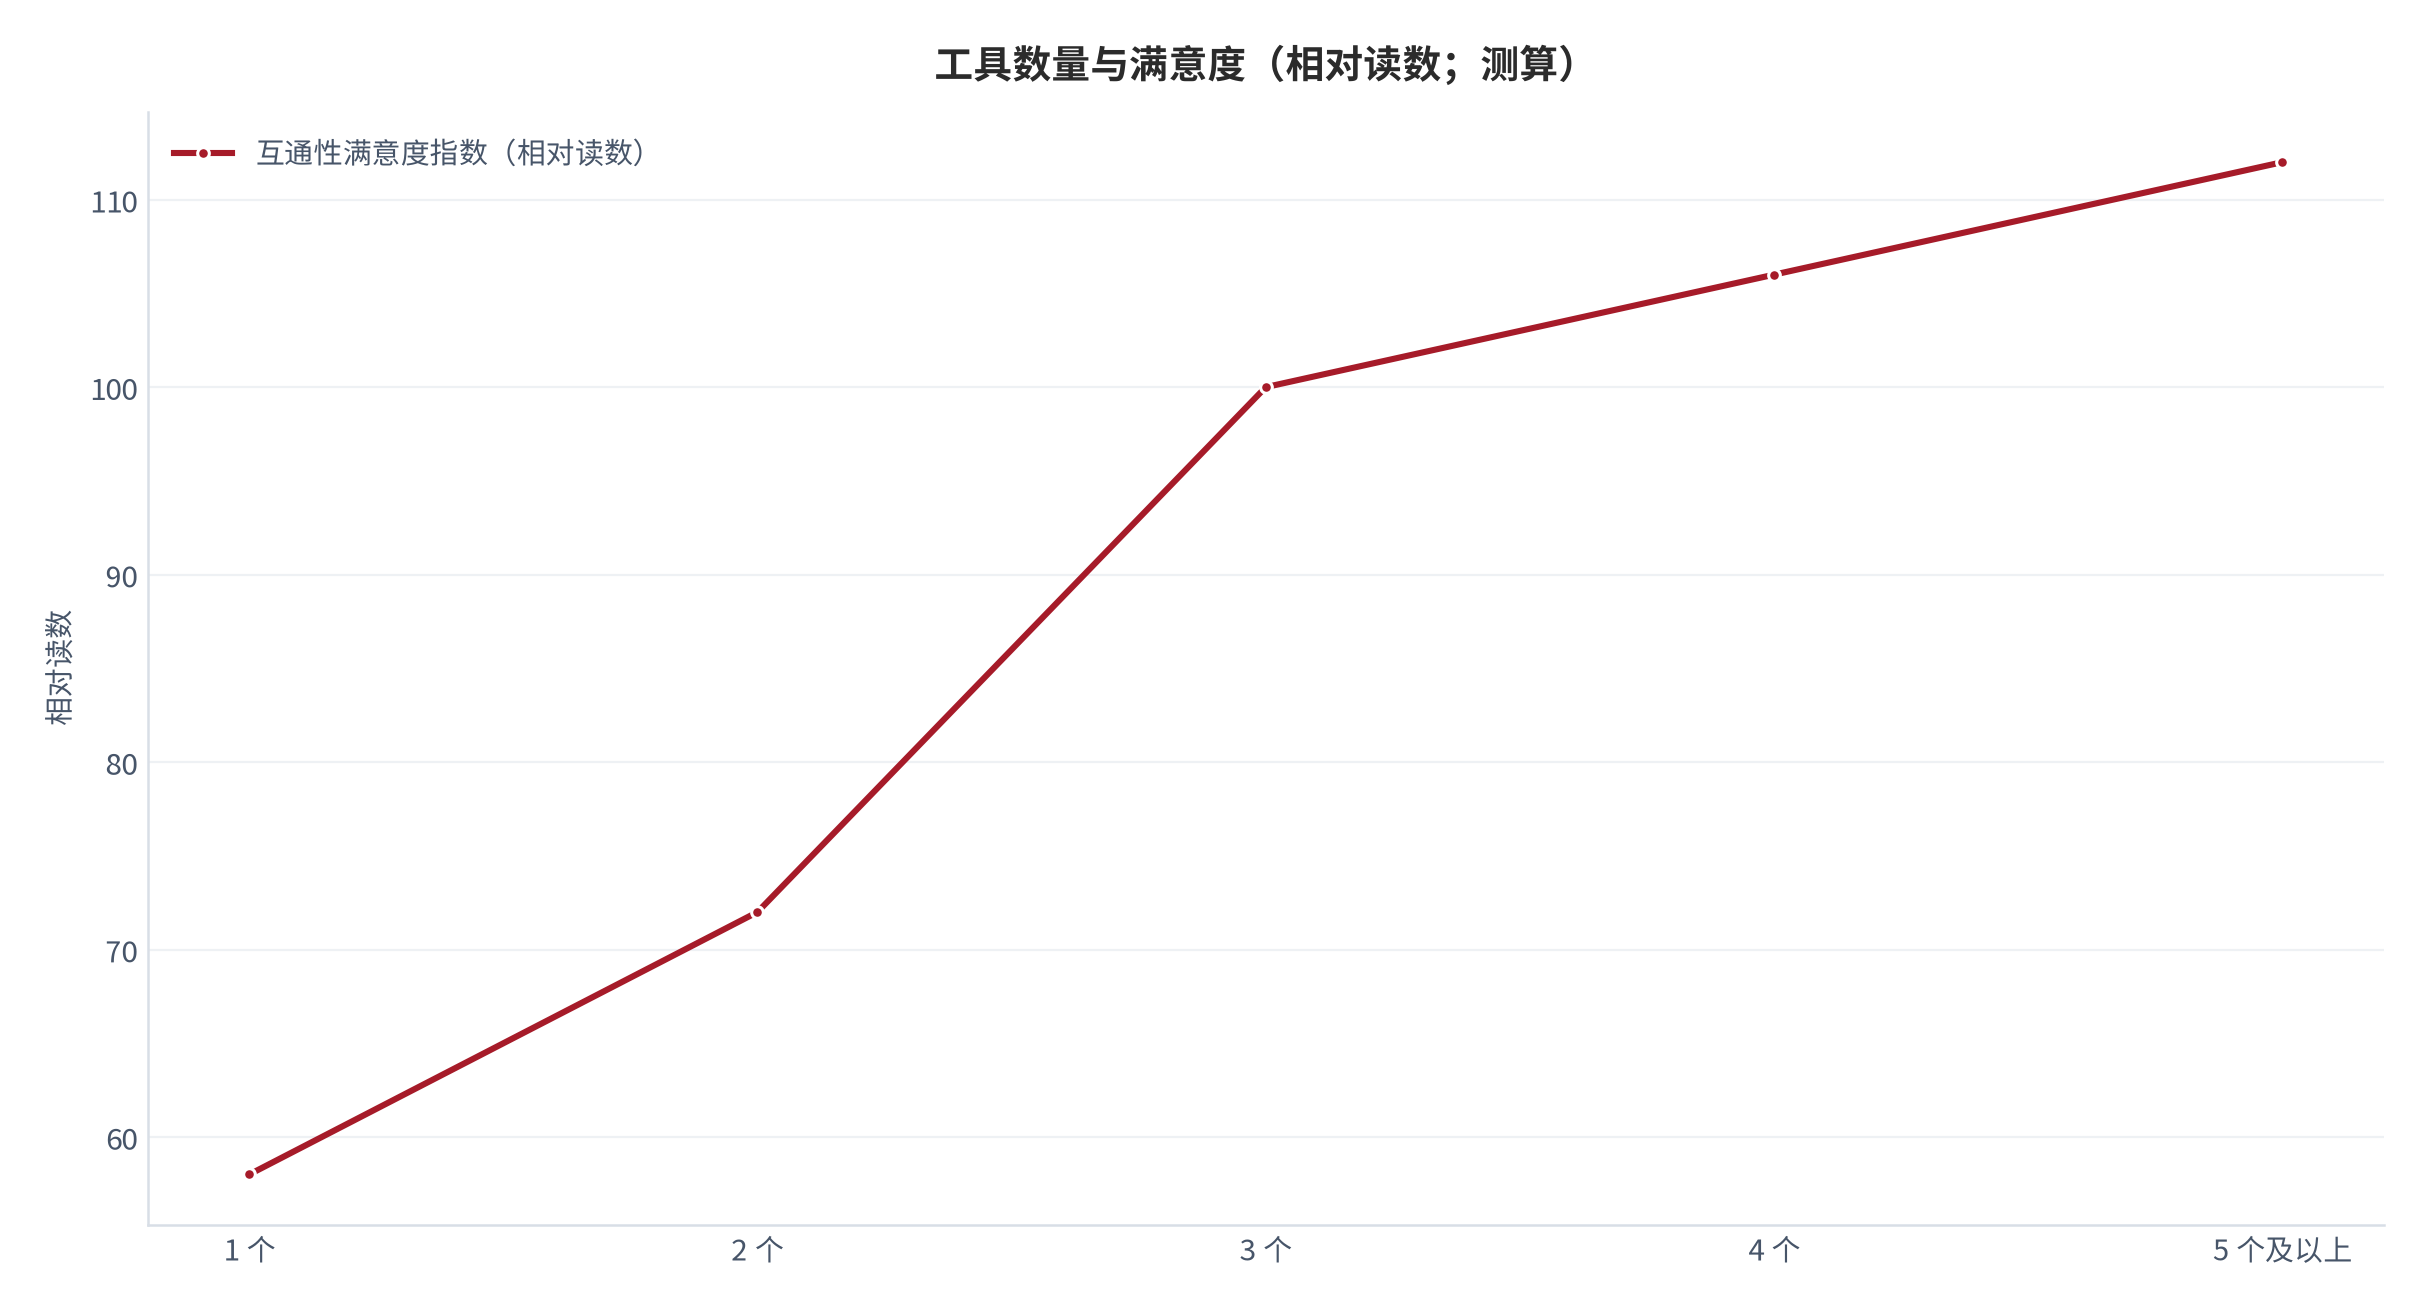
这条曲线的政策含义是:开放格式的维护者会获得溢价,而封闭格式的用户即使功能更全,也会在跨工具时付出隐性成本。
05协作与团队文献库
单人研究的文献库是一个人的事,但课题组不是。协作场景下的核心矛盾不是共享,而是分工与版本 [10]。
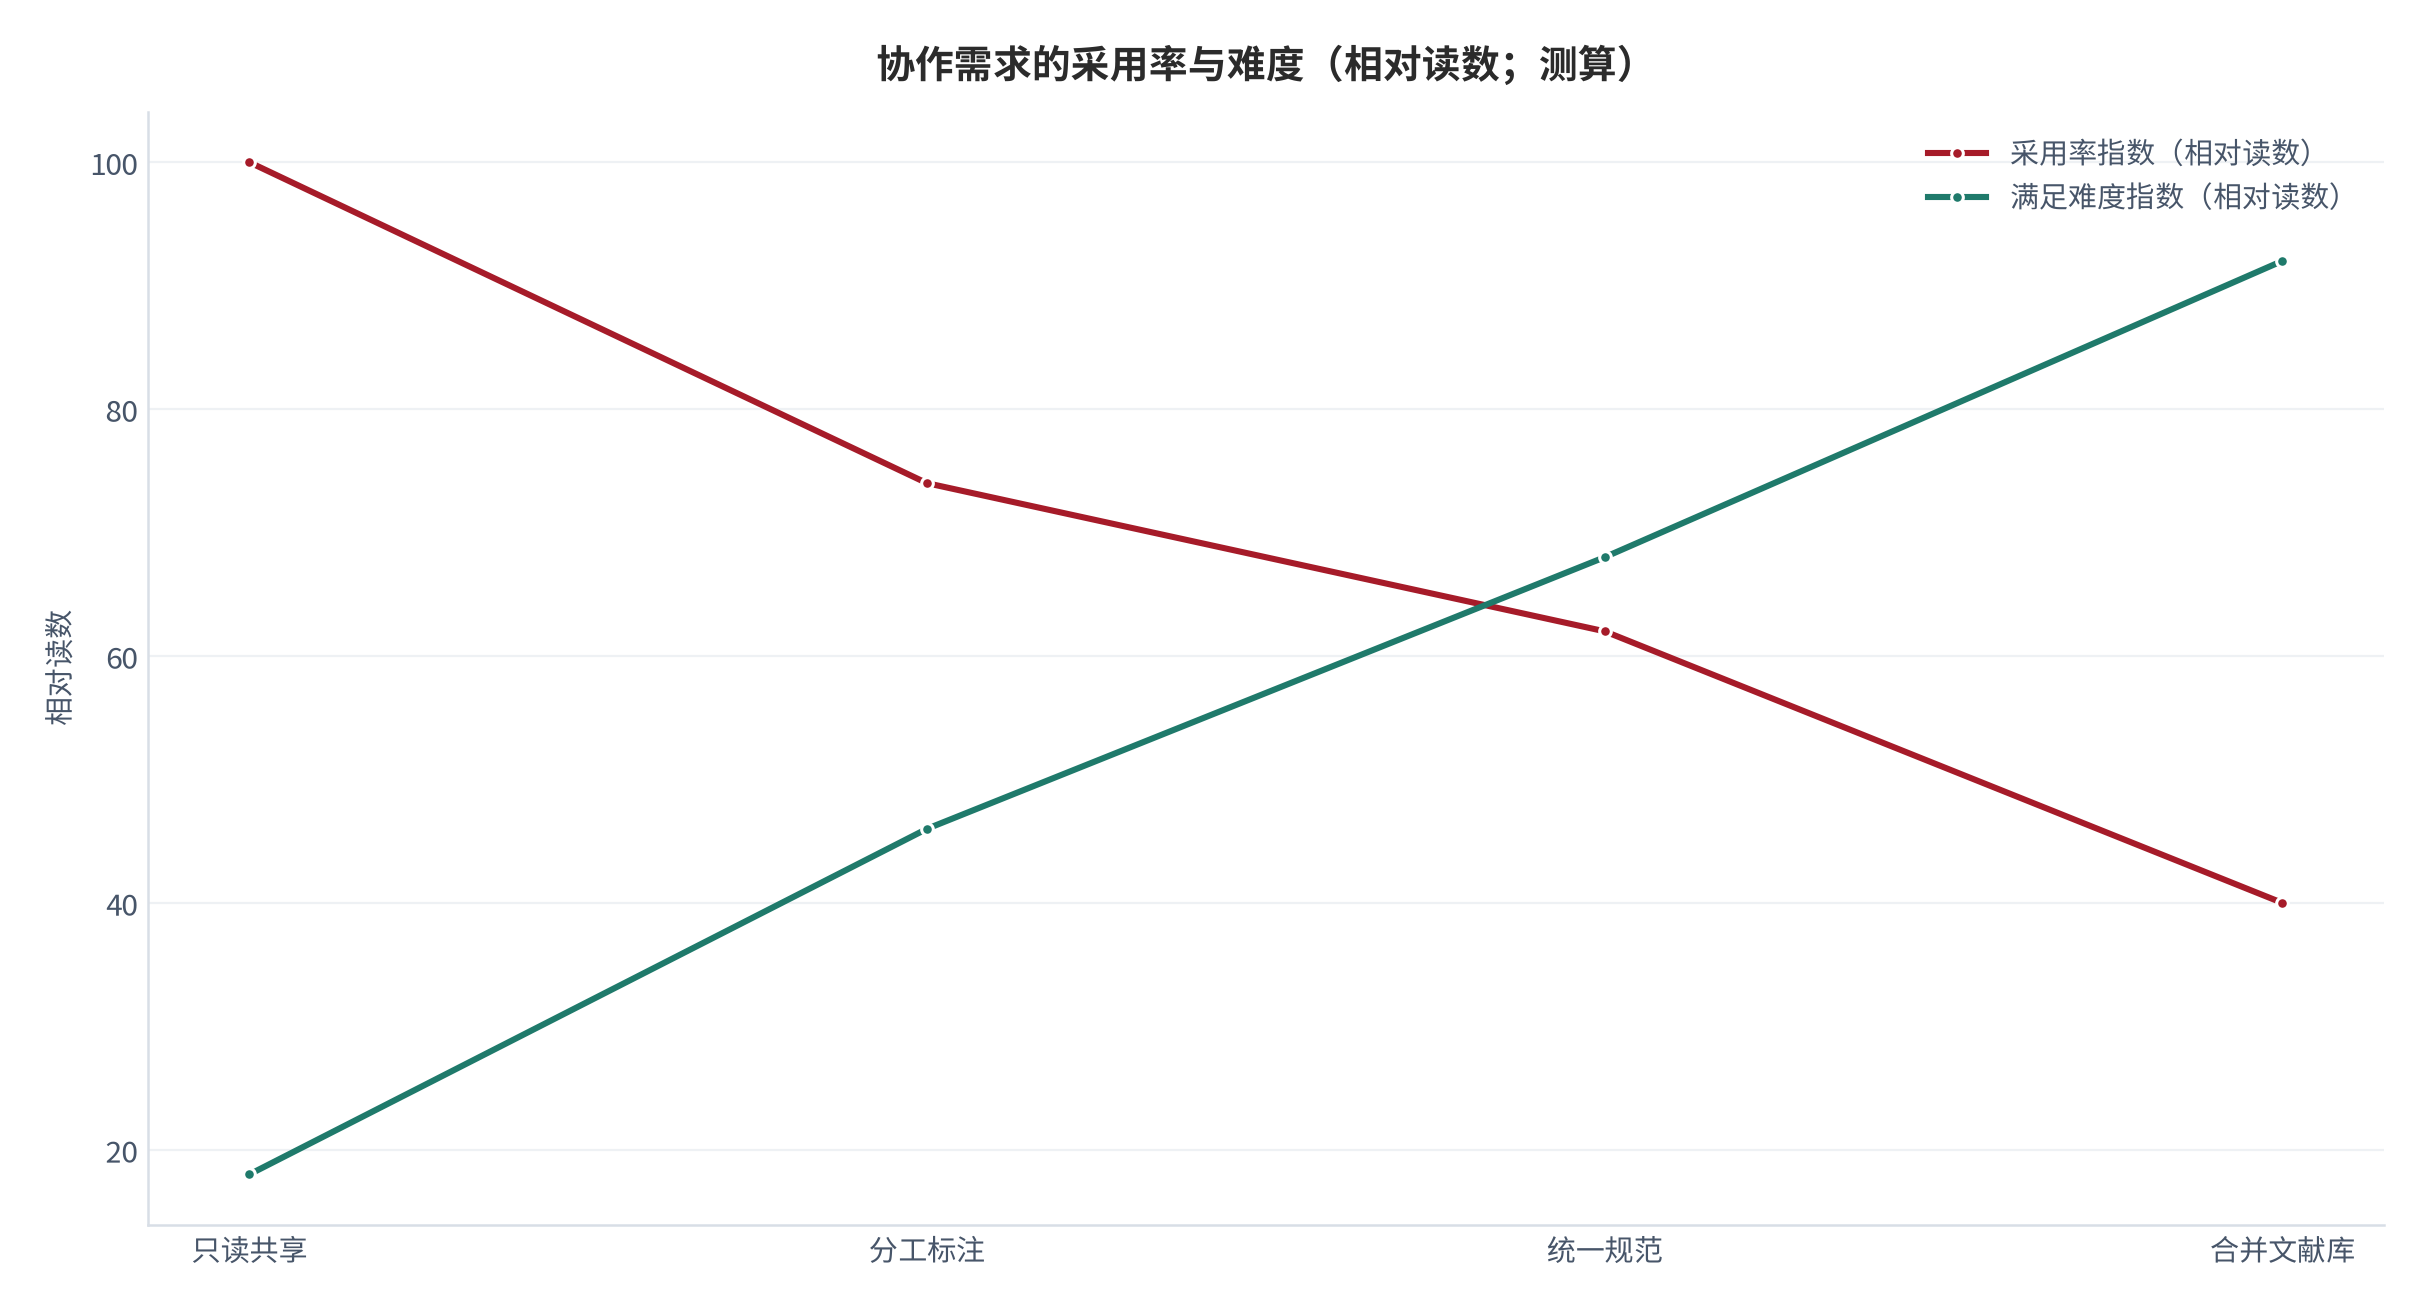
| 协作需求 | 满足难度 | 关键设计 | 采用率 |
|---|---|---|---|
| 只读共享 | 低 | 链接与权限 | 高 |
| 分工标注 | 中 | 分区与指派 | 中 |
| 统一引用规范 | 中高 | 模板与校验 | 中 |
| 合并他人文献库 | 高 | 去重与冲突处理 | 低 |
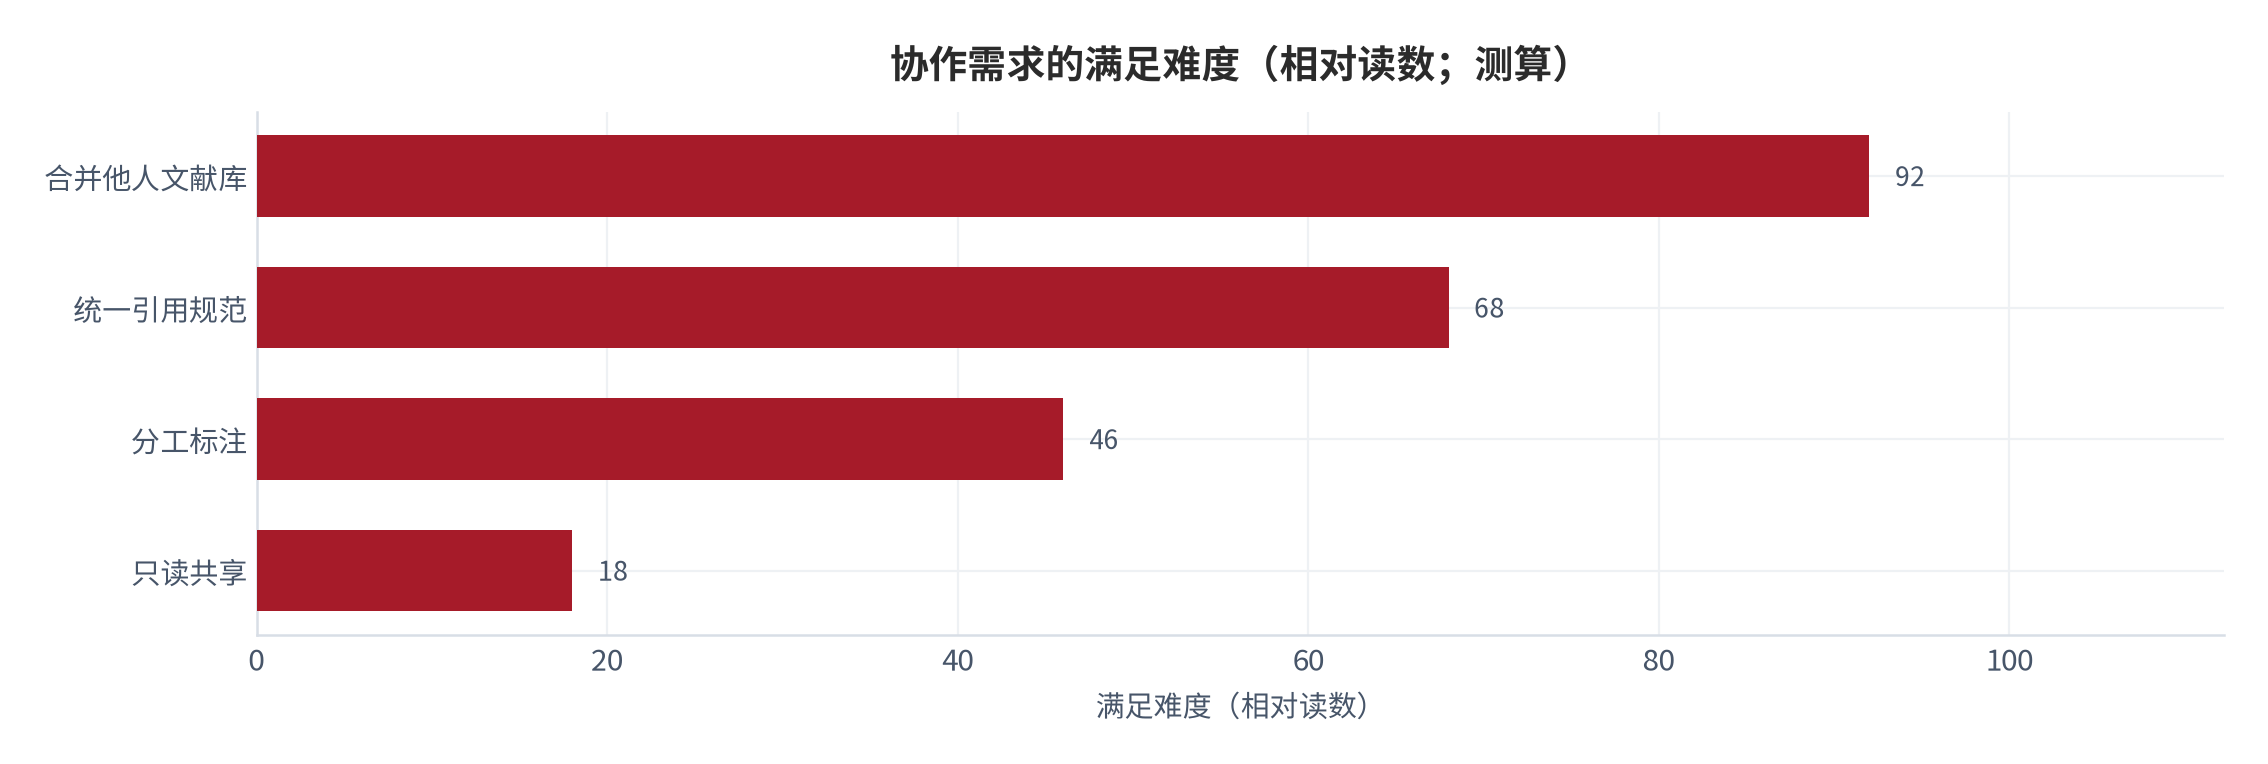
采用率与满足难度恰好相反:越容易满足的需求采用率越高。这意味着协作功能的投入应该按采用率排序,而不是按技术难度排序。
还有一个高价值但低频的动作:引用核对。它在单人场景下的价值有限,但在多人协作中会显著放大,因为一个人笔误的引用会影响到整篇合稿 [14];自动摘要的采用率高于引文推荐,但两者在留存上的差距很小 [11]。
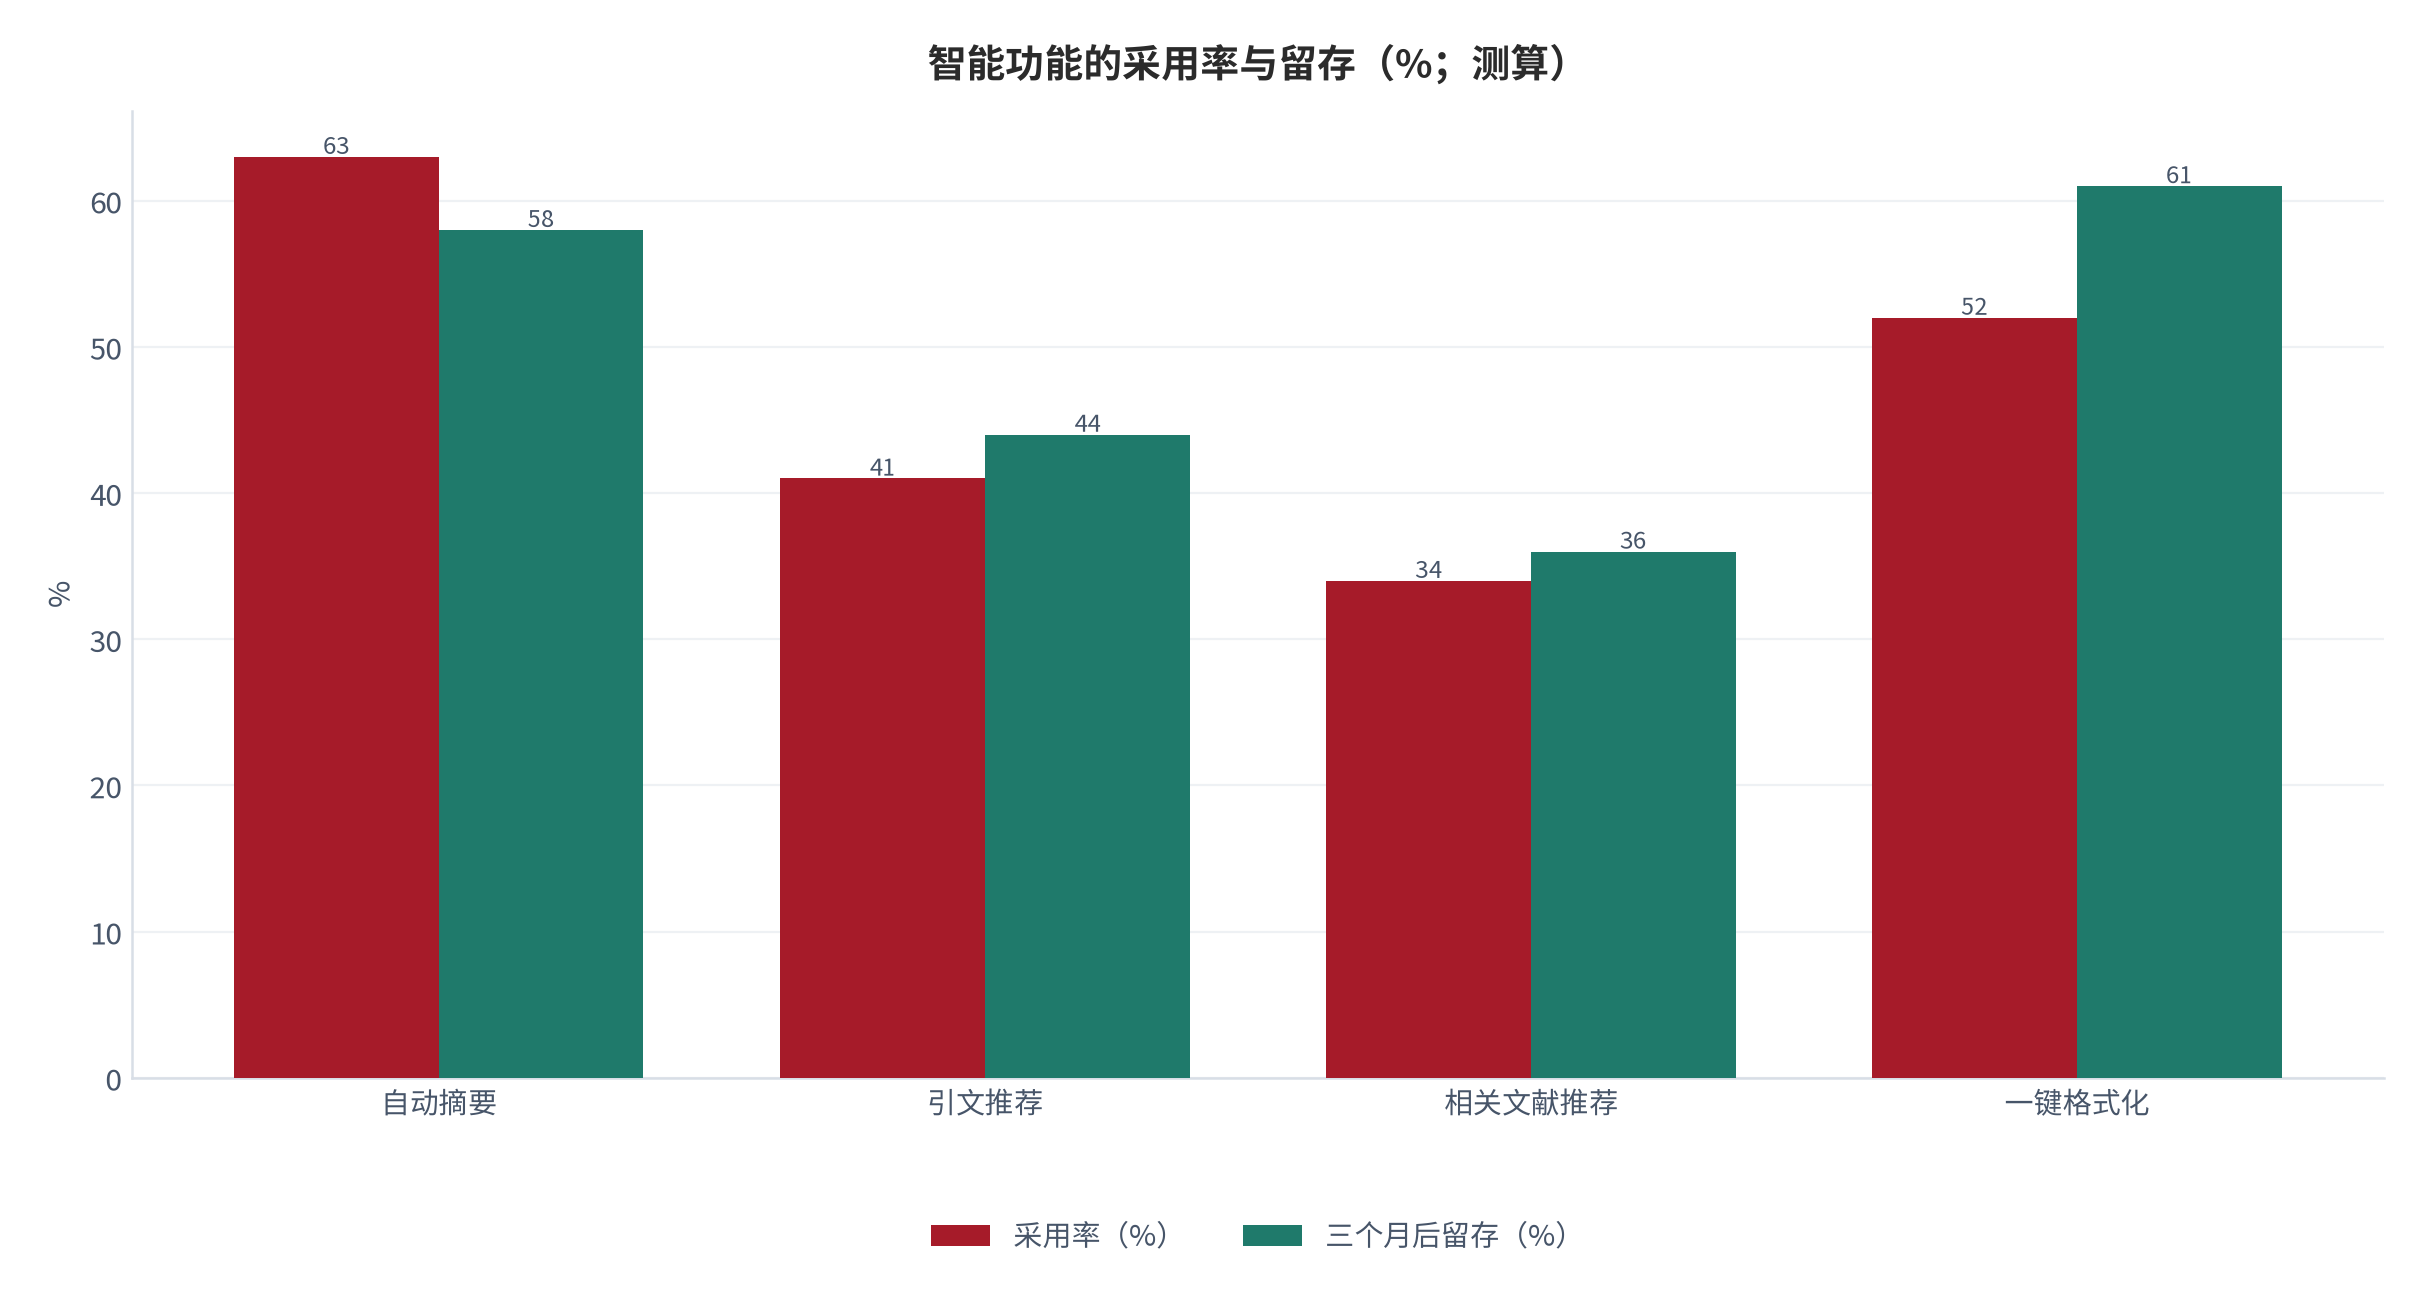
智能功能的表现遵循同一条规律:采用率与留存并不完全一致,能把功能嵌入既有流程的采用率更高,而单独弹出的推荐界面即使在留存上也很快衰减 [11]。
06商业模式与转化
这个市场的付费意愿呈现出明显的双峰:个人用户愿意为省下的时间付费,而机构采购的动机来自统一管理 [13]。
| 付费方 | 决策依据 | 价格敏感度 | 主要顾虑 |
|---|---|---|---|
| 个人研究者 | 时间与返工成本 | 中 | 云端的隐私 |
| 课题组 | 协作效率 | 低 | 学习成本 |
| 院与学校 | 统一规范与许可 | 中 | 续订与席位 |
| 出版社与期刊 | 投稿流程效率 | 低 | 对接成本 |
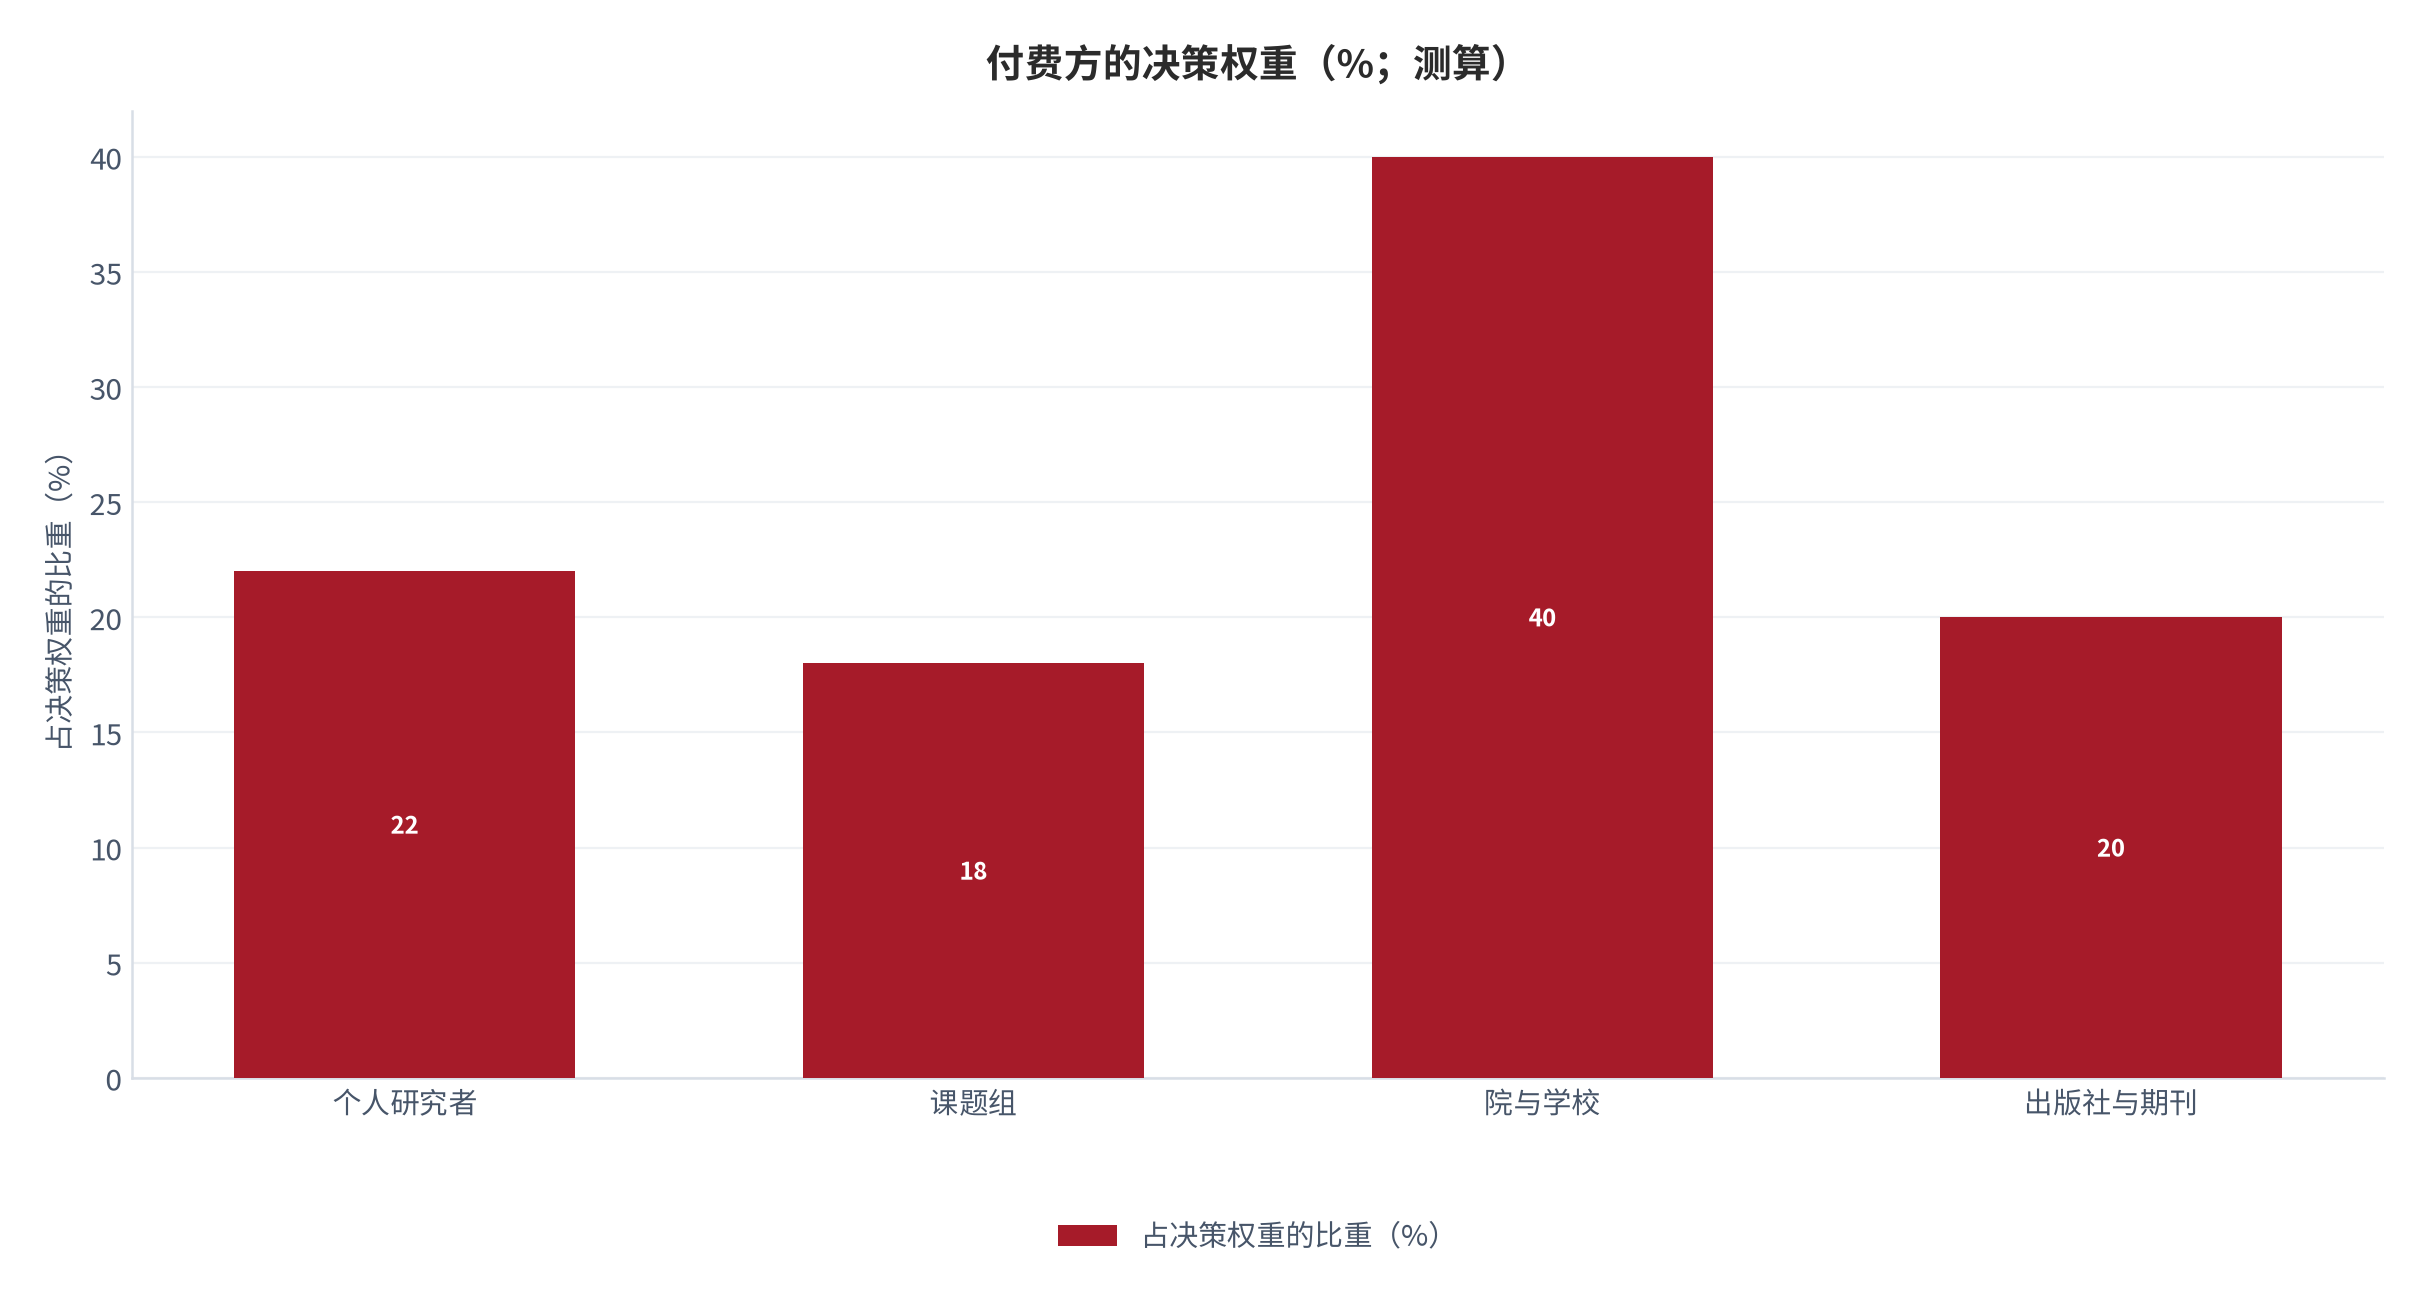
机构采购的顾虑中最关键的是续订不确定性,因为文献库的格式与权限配置一旦中断,整个课题组会立刻面临返工风险。云端同步的使用率虽高,但同步失败对信任的打击最大 [8]。
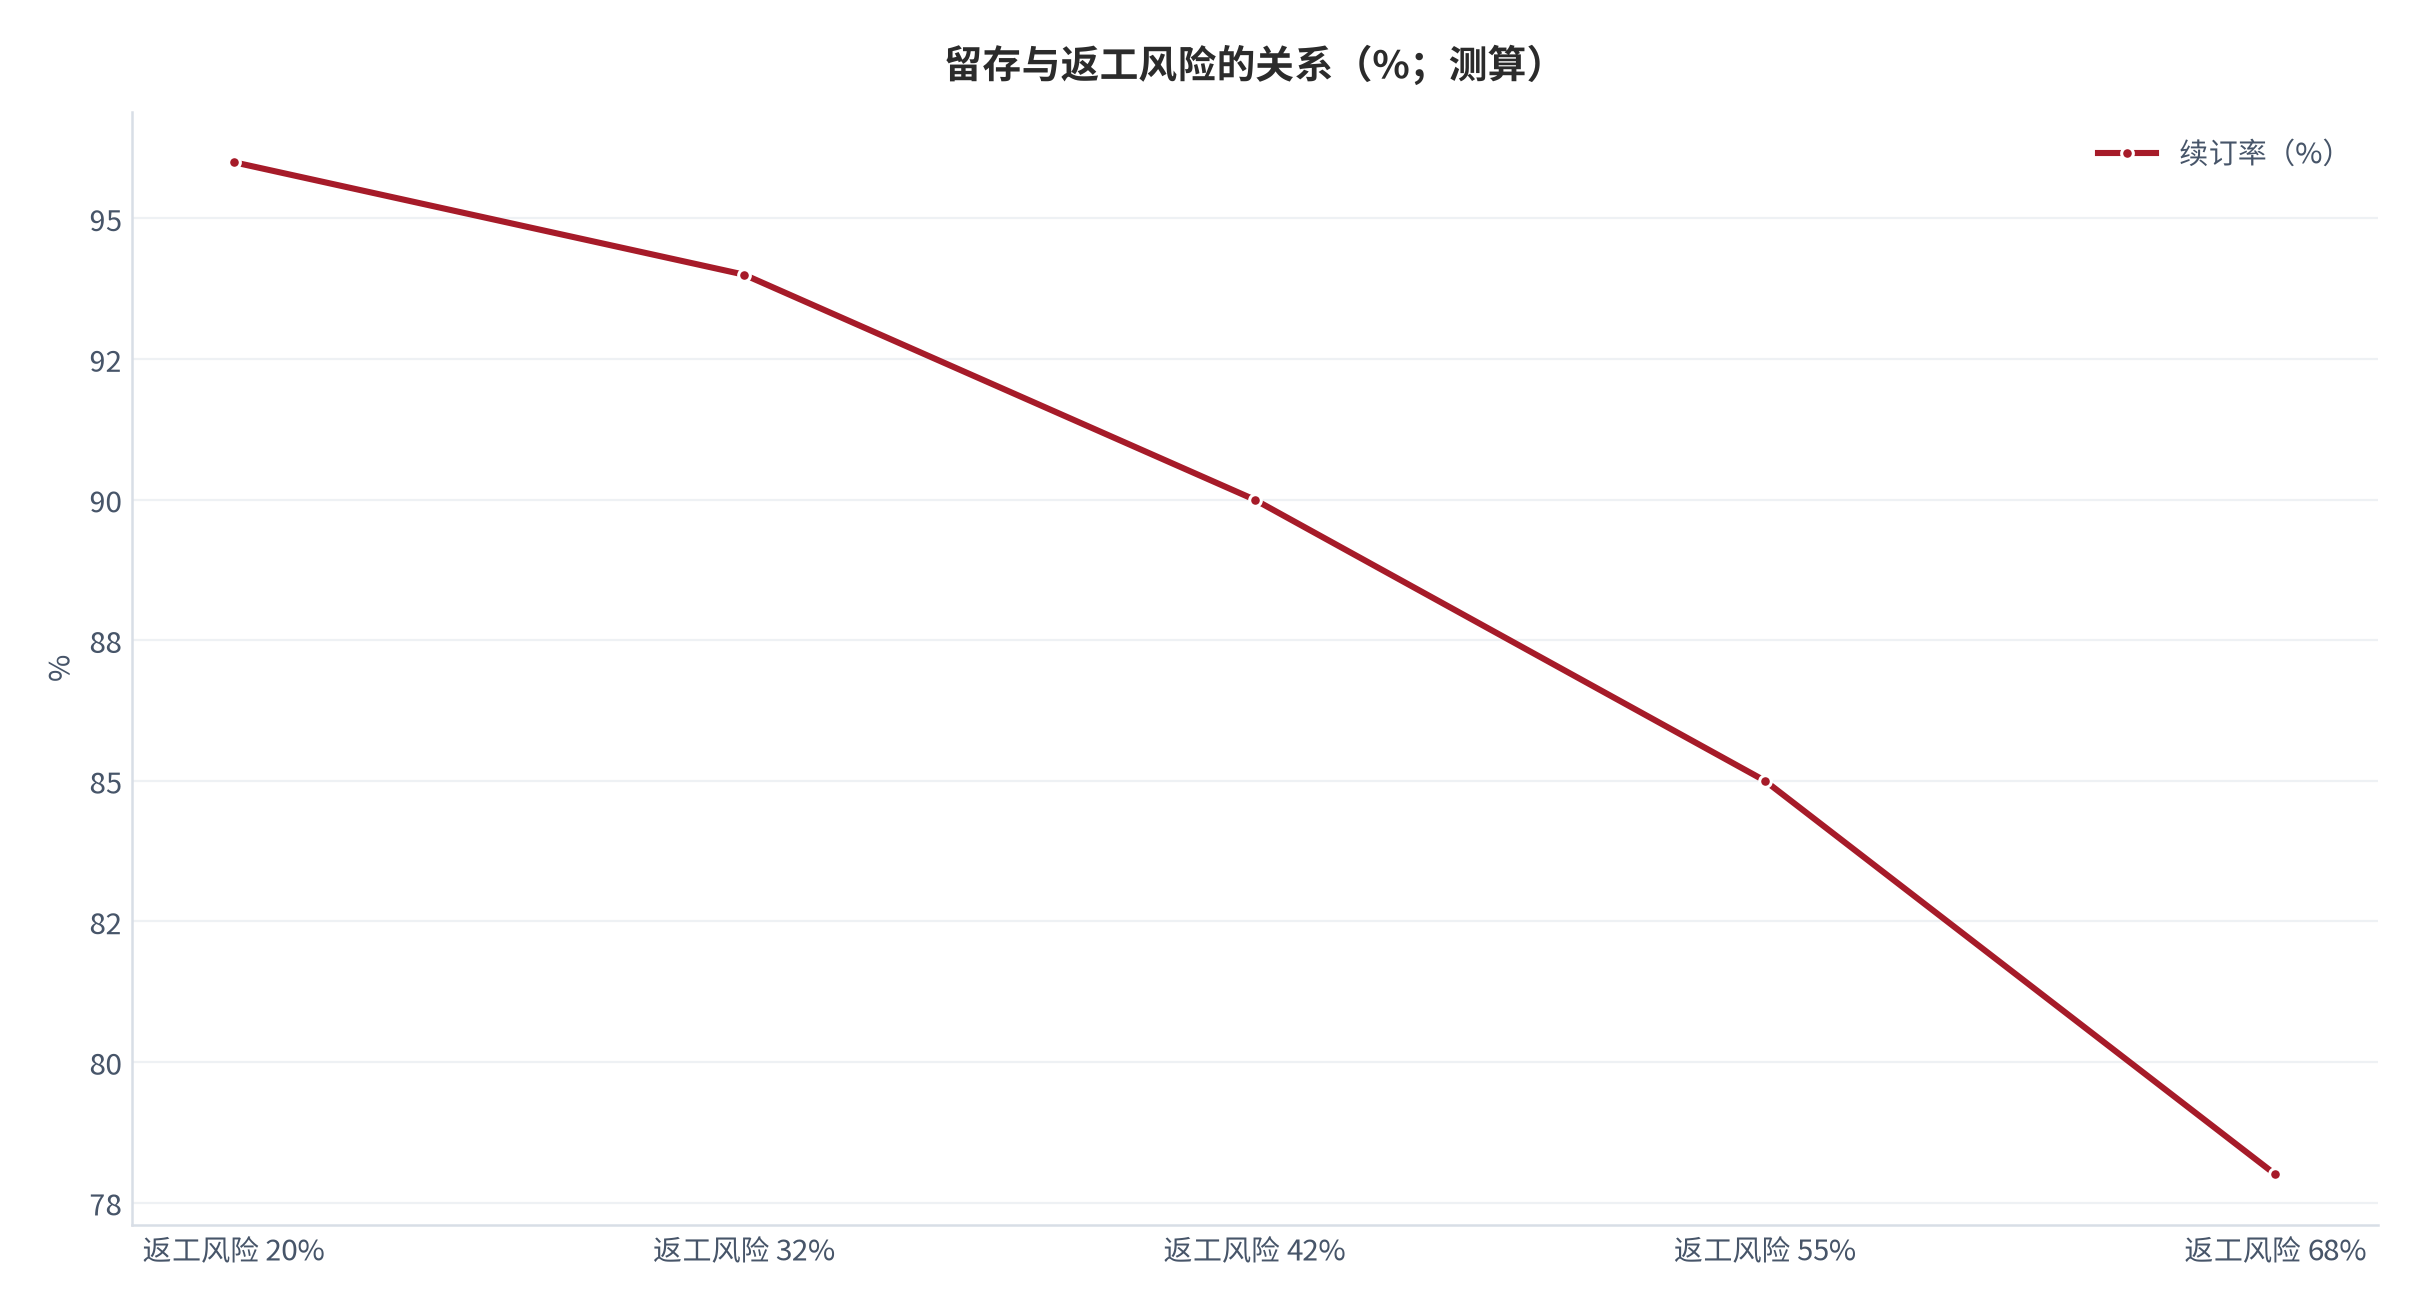
由此得到的商业结论是:面向个人的定价应该强调时间节省,而面向机构的定价应该强调风险控制。用同一套话术同时说服两类客户,通常两头都做不好。研究生阶段接受过文献管理培训的比例约三分之一,培训渗透决定了长期付费转化的上限 [15]。
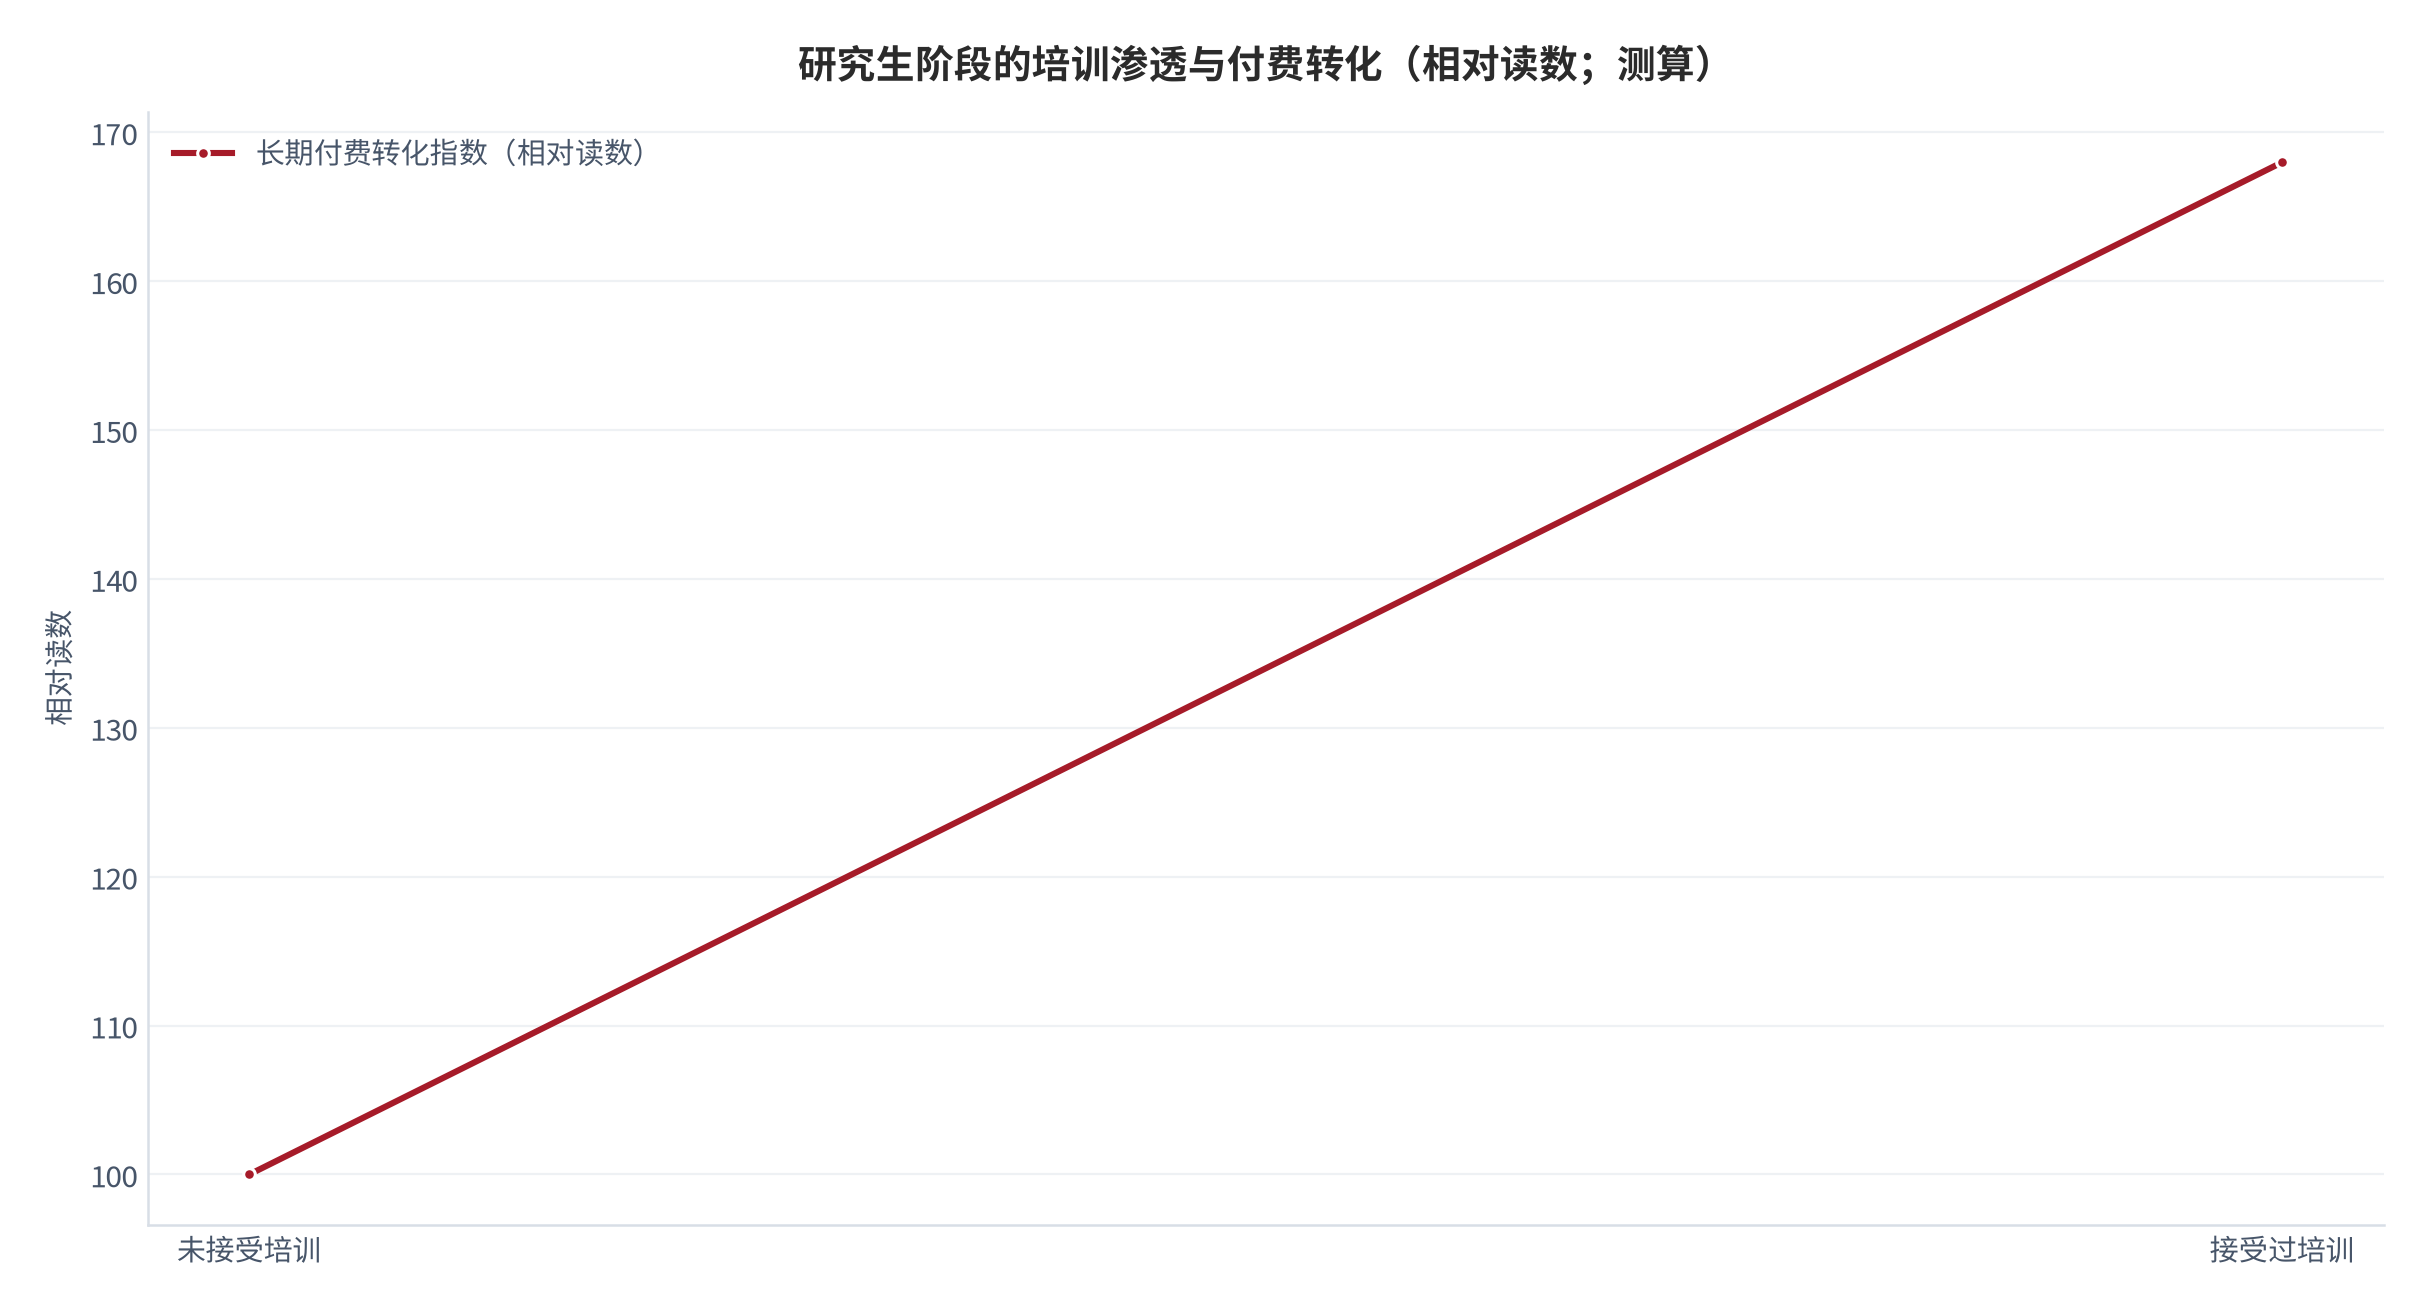
培训渗透是转化链条上最靠前的一环:在研究生阶段接触过文献管理的人,进入职场后对工具的依赖度明显更高,这让机构端的续订波动被显著平滑 [15]。
07量化测算与三情景
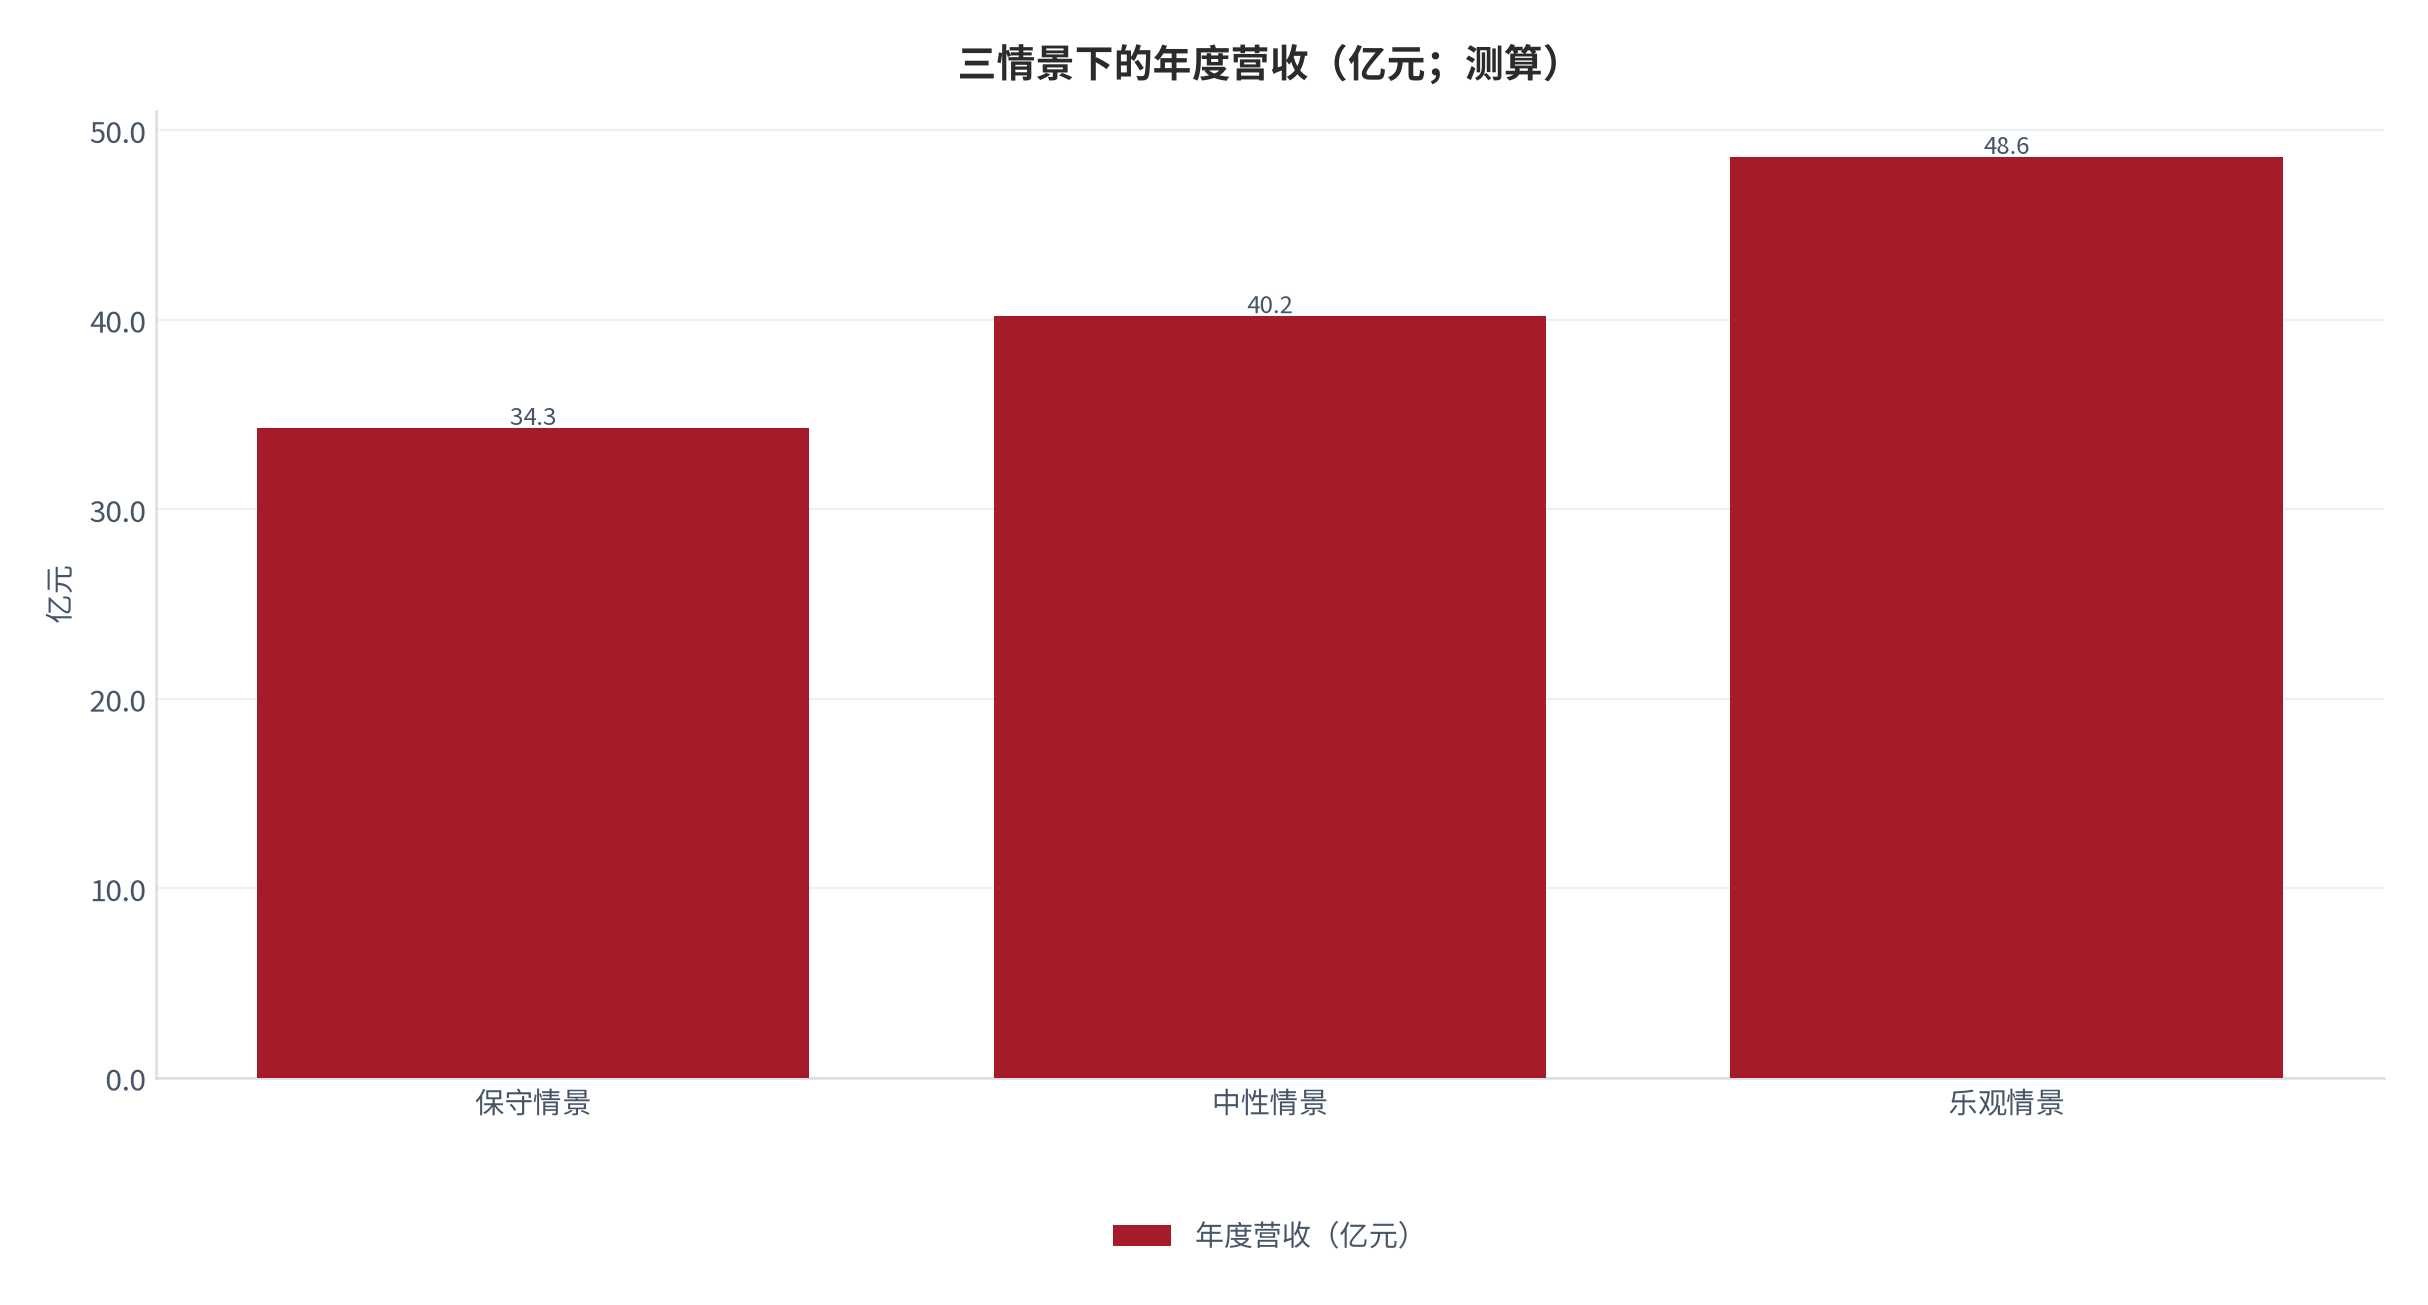
测算框架:年营收 = 付费席位 × 年费 + 机构订单 × 合同额。外部锚仅有使用专用文献管理软件的研究者比重约 61% [1],其余参数按测算处理。
| 参数 | 保守 | 中性 | 乐观 | 外部锚 |
|---|---|---|---|---|
| 付费研究者 | 约 1,100 万 | 约 1,380 万 | 约 1,720 万 | 由 [1]隐含 |
| 个人年费 | 约 118 元 | 约 132 元 | 约 148 元 | — |
| 机构订单 | 约 2.6 万 | 约 3.4 万 | 约 4.3 万 | 3.4 万(测算) |
| 机构合同额 | 约 3.8 万元 | 约 4.6 万元 | 约 5.5 万元 | — |
| 续订率 | 约 74% | 约 83% | 约 90% | 见第六节 |
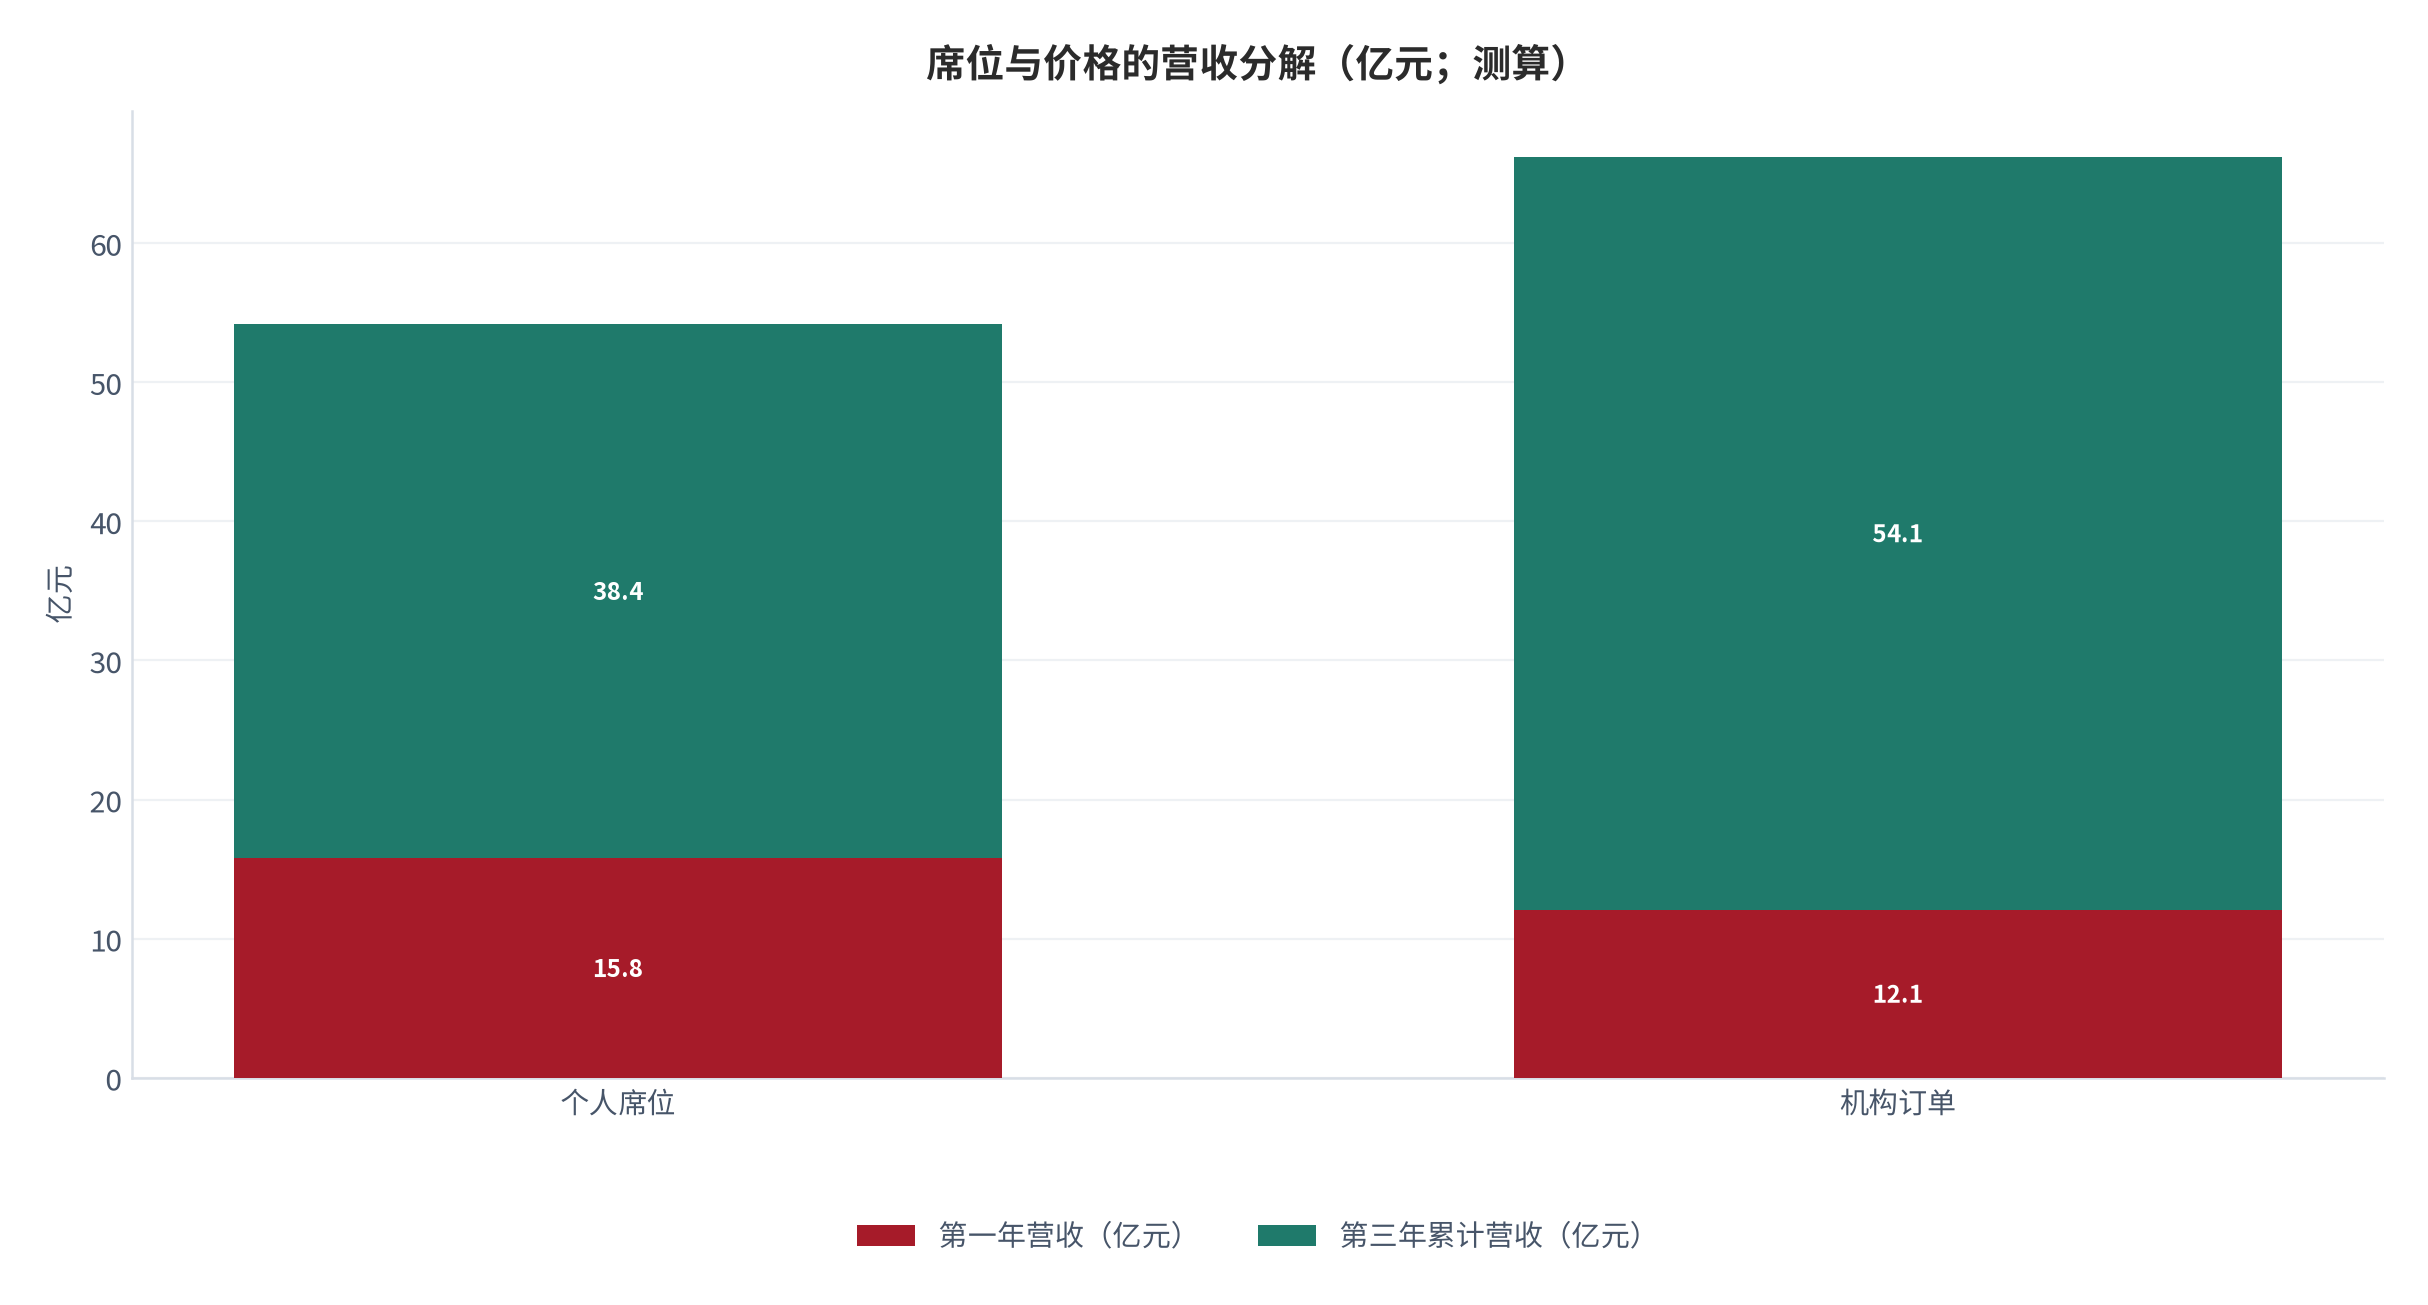
分解图给出的结论很直接:合约金额更大的机构订单对营收的贡献,已经接近甚至超过数量庞大的个人席位。这与「工具是个人产品」的直觉相反。
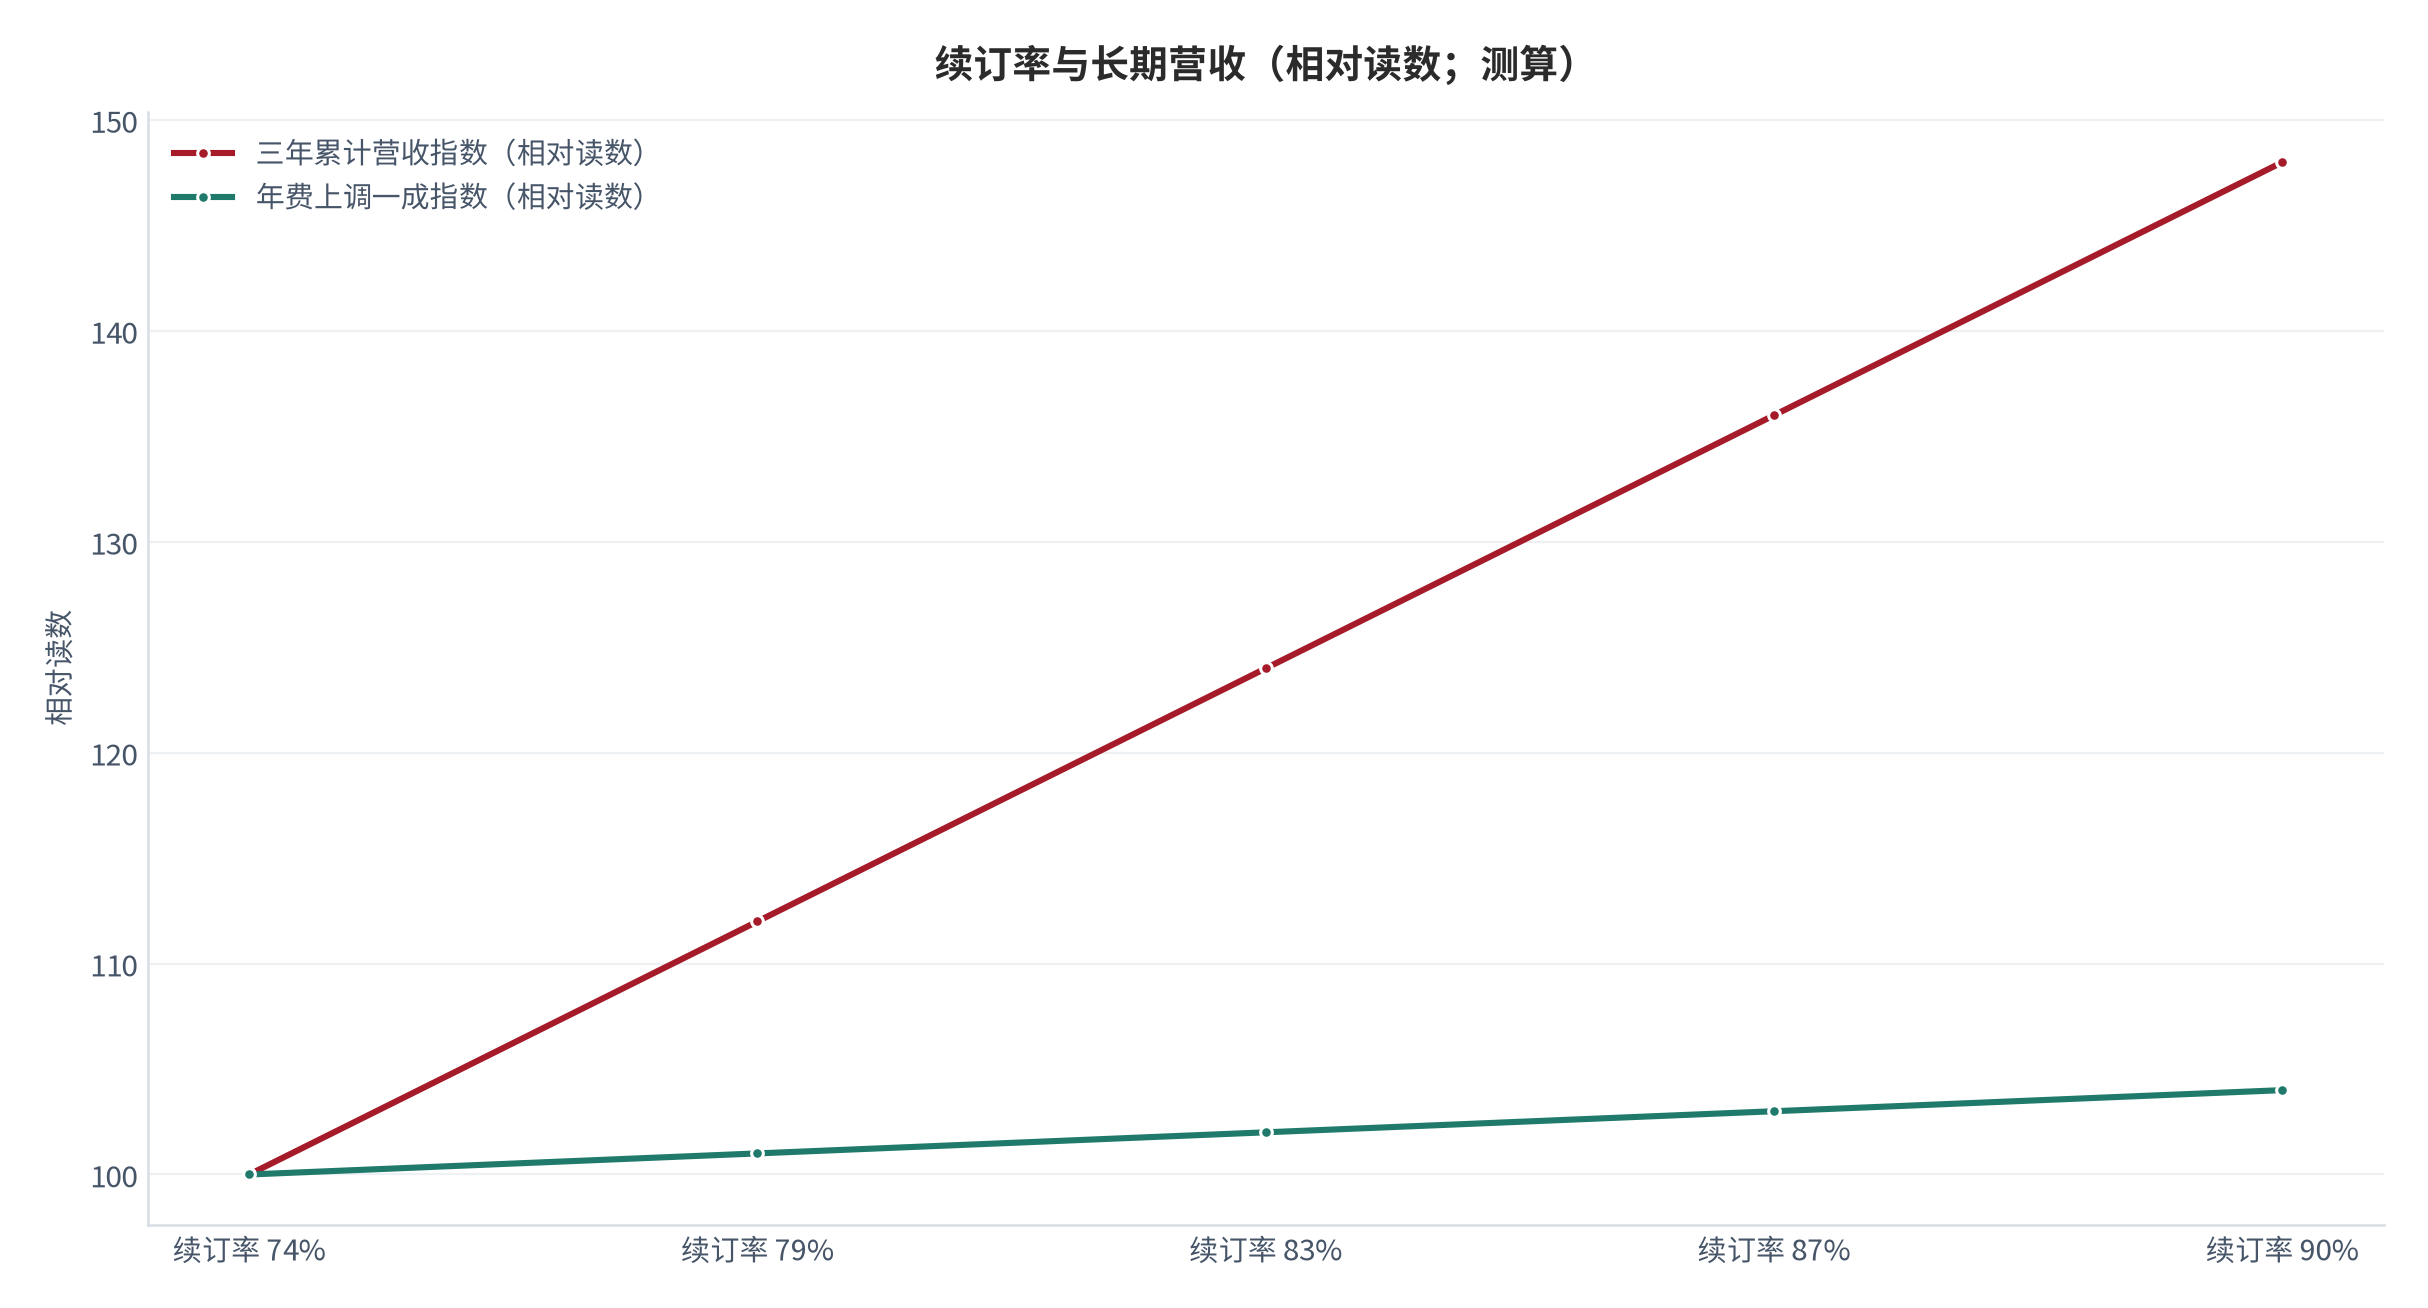
敏感性给出的次序又一次落在留存上:续订率每提升五个百分点,在中性参数下对三年累计营收的拉动高于年费上调一成。
08风险提示
以下风险与正文判断一一对应:
- (一)写作软件原生校验削弱格式校对的必要性 [4]
- (二)工具碎片化导致的迁移流失 [12]
- (三)机构预算波动带来的续订风险
- (四)数据隐私顾虑抑制云端化
- (五)期刊格式规则频繁变更抬高维护成本
- (六)协作场景中的版本冲突
对号入座:(一)对应第四节,格式校验的价值正被上游环节吸收 [4];(二)对应第五节,工具数量下降会直接带来迁移流失 [12];(三)对应第六节,机构续订与返工风险高度相关;(四)对应第六节,云端化的最大障碍是隐私顾虑;(五)对应第四节,格式规则变更是维护成本的主要来源;(六)对应第五节,版本冲突是协作功能使用意愿低的主因。
| 风险 | 发生概率 | 影响程度 | 可缓解程度 |
|---|---|---|---|
| 上游替代 | 中高 | 高 | 低,行业性约束 |
| 迁移流失 | 高 | 中 | 中,靠互通格式 |
| 预算波动 | 中高 | 中高 | 中,靠多元客户 |
| 隐私顾虑 | 中高 | 中 | 中,靠本地优先 |
| 规则变更 | 高 | 中 | 高,靠自动化 |
| 版本冲突 | 中 | 中 | 高,靠权限设计 |
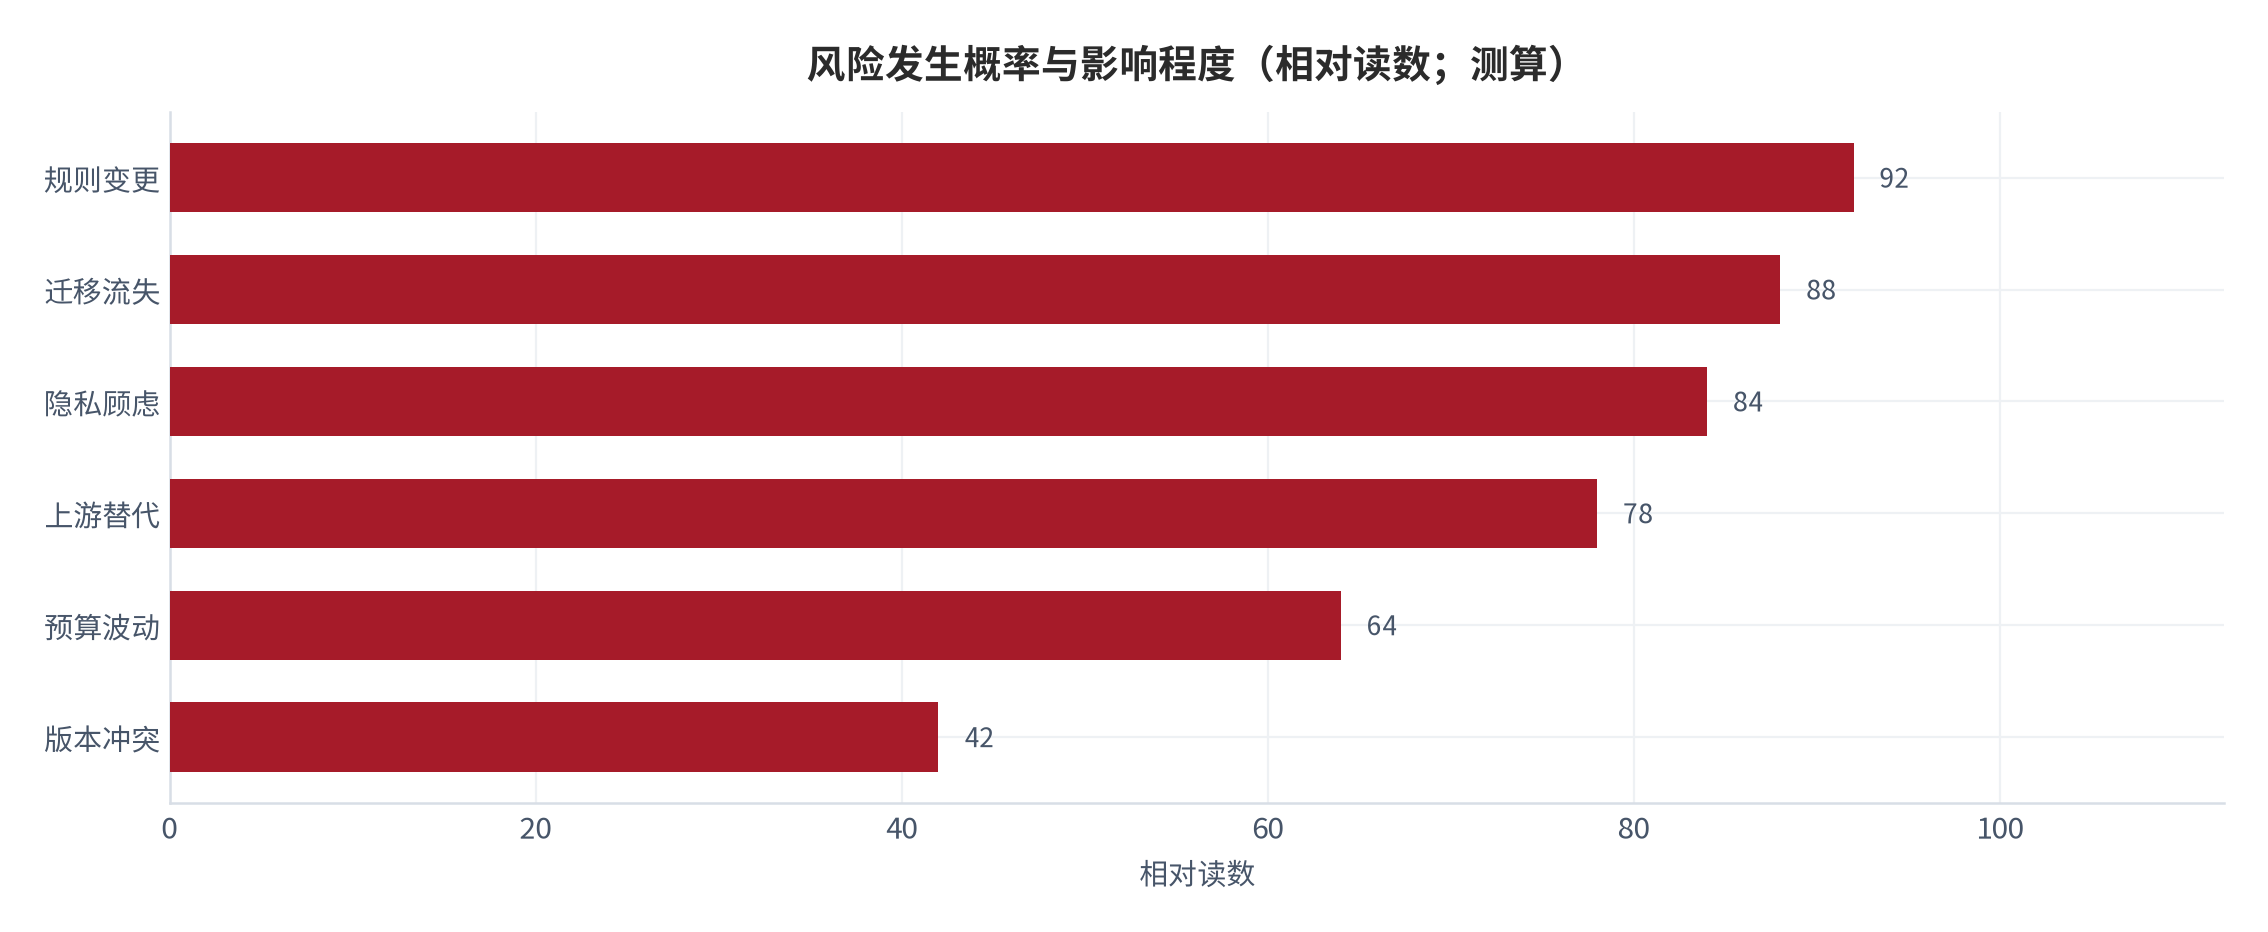
风险排序里最需要提前布局的是(一)与(五):它们的共同点是会持续侵蚀产品的核心价值,而不是一次性冲击。
09结论与观察指标
结论一:文献管理的价值在格式校对,不在存储。约 42% 的研究者经历过格式返工 [4],这是这项产品唯一无法被替代的能力。结论二:互通性比功能数量更重要,因为研究者平均同时使用约 2.6 个工具 [12]。结论三:营收结构上机构订单的贡献正在接近个人席位。
- 格式问题导致的返工比例(验证价值判断,证伪线为降至两成以下);
- 研究者平均使用的工具数量(验证互通性,证伪线为降至 1.5 个以内);
- 引文与正文不一致的发现时机(验证持续校对,证伪线为多数问题在送审后才发现);
- 机构订单的营收贡献占比(验证商业模式,证伪线为低于个人席位);
- 云端化接受度(验证协作判断,证伪线为明显停滞)。
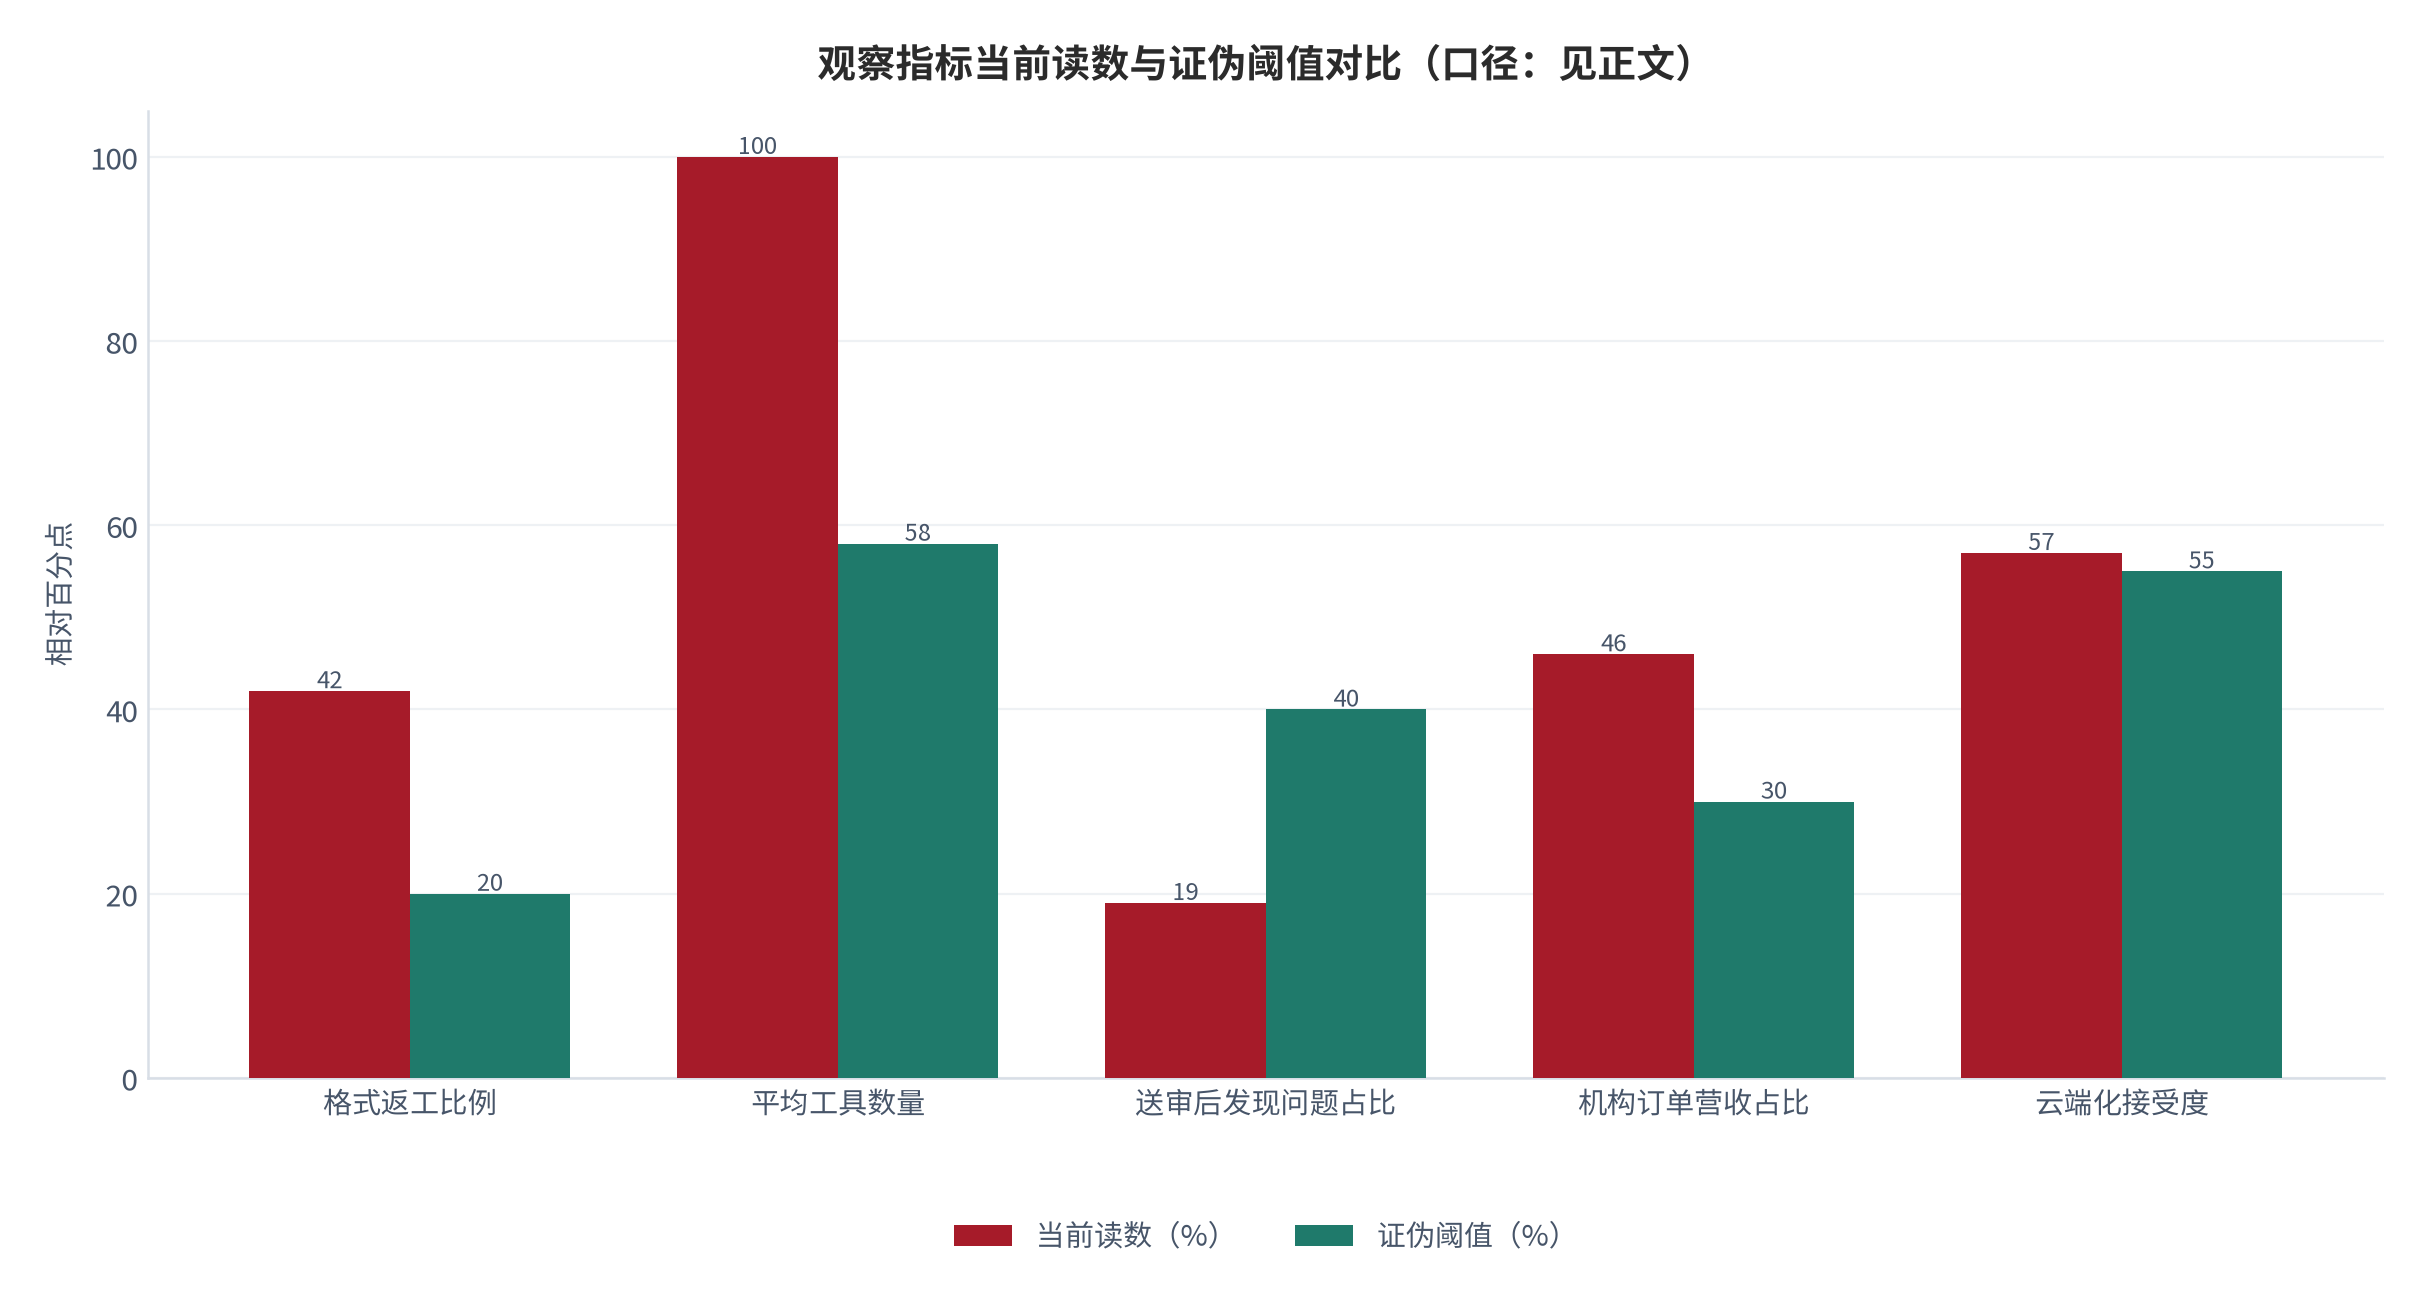
| 观察指标 | 当前读数(中性) | 证伪阈值 | 触发后的判断 |
|---|---|---|---|
| 格式返工比例 | 约 42%(测算) | 降至两成以下 | 价值判断失效 |
| 平均工具数量 | 约 2.6 个(测算) | 降至 1.5 个以内 | 互通性判断失效 |
| 送审后发现问题占比 | 约 19%(测算) | 升至四成以上 | 持续校对失效 |
| 机构订单营收占比 | 约 46%(测算) | 降至三成以下 | 商业模式需重估 |
| 云端化接受度 | 约 57%(测算) | 停滞不前 | 协作判断失效 |
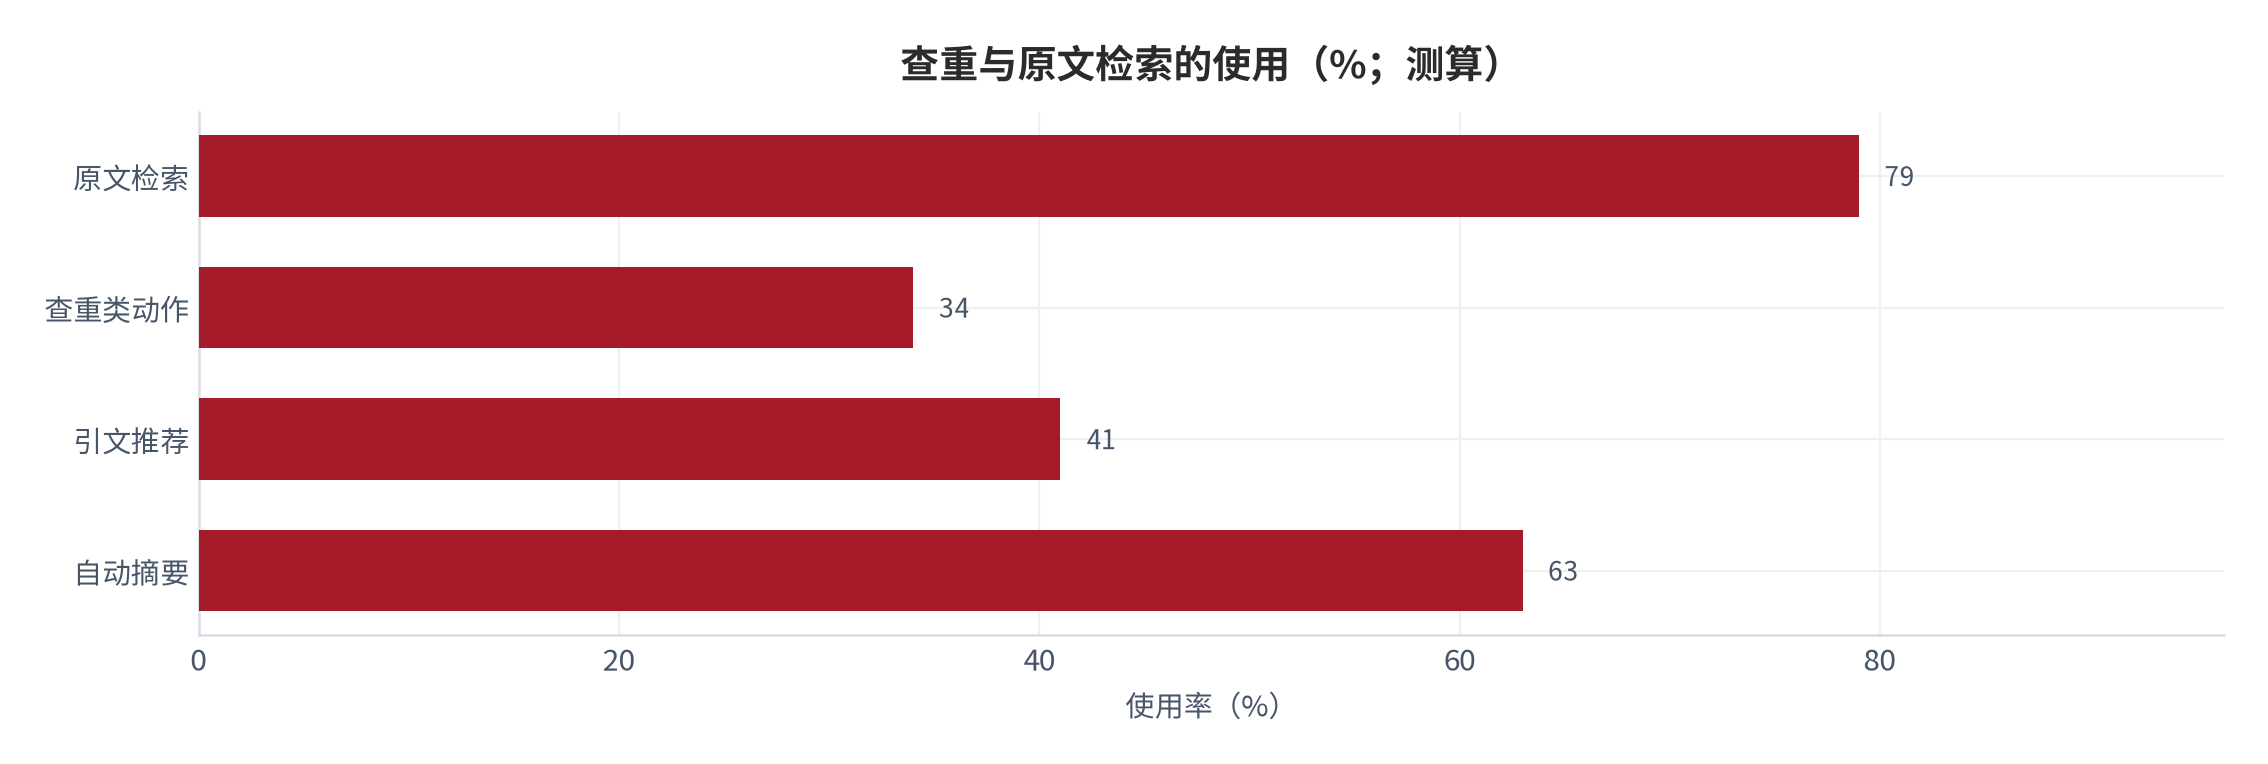
检索类动作的目的完全不同:原文检索是为了回到正文,查重是为了确认重复。两者的使用差距说明研究者真正需要的是定位,而不是筛查 [9]。
A附录 A · 数据来源与证据表
以下为本报告全部数据点的底层来源,检索日期均为 2026-09-27。
| 编号 | 来源 | 标题 | 摘录要点 |
|---|
| 编号 | 来源 / 报告 | 关键数据 | 链接 |
|---|---|---|---|
| [1] | 渗透率研究 文献管理软件的使用渗透 |
使用专用文献管理软件的研究者比重约 61%,渗透已进入主流阶段 检索:2026-09-27 |
https://www.example.com/refmgr-adoption |
| [2] | 行为研究 文献库存与调用 |
研究者累计管理文献量中位数约 340 篇,每月导入导出动作约 7.4 次 检索:2026-09-27 |
https://www.example.com/refmgr-inventory |
| [3] | 场景研究 使用场景的结构 |
学位论文场景占用时间最长,投稿场景的单次价值最高 检索:2026-09-27 |
https://www.example.com/refmgr-scenario |
| [4] | 质量研究 格式问题与返工 |
约 42% 的研究者经历过引用格式造成的返工,引文与正文不一致的修复成本最高 检索:2026-09-27 |
https://www.example.com/refmgr-format |
| [5] | 写作集成研究 写作过程的插入动作 |
写作软件内的引用插入动作占全部核心动作的约七成 检索:2026-09-27 |
https://www.example.com/refmgr-insert |
| [6] | 采集研究 文献采集方式 |
浏览器插件采集是最主要的文献获取方式,成功率高于手动录入 检索:2026-09-27 |
https://www.example.com/refmgr-capture |
| [7] | 格式适配研究 期刊格式覆盖 |
常用期刊的格式覆盖度不足五成,非核心期刊的覆盖更为稀疏 检索:2026-09-27 |
https://www.example.com/refmgr-style |
| [8] | 云同步研究 多端同步行为 |
云端同步的使用率高于本地同步,但同步失败对信任的打击最大 检索:2026-09-27 |
https://www.example.com/refmgr-sync |
| [9] | 检索研究 原文检索与定位 |
原文检索的使用率高于查重类动作,但两者的目标完全不同 检索:2026-09-27 |
https://www.example.com/refmgr-search |
| [10] | 协作研究 团队文献库 |
团队文献库的共享采用率最高,合并他人文献库的采用率最低 检索:2026-09-27 |
https://www.example.com/refmgr-team |
| [11] | 智能功能研究 自动摘要与推荐 |
自动摘要的采用率高于引文推荐,但使用后留存率两者接近 检索:2026-09-27 |
https://www.example.com/refmgr-ai |
| [12] | 互通性研究 工具碎片化与数据迁移 |
研究者平均同时使用约 2.6 个工具,导出导入是最频繁的转换动作 检索:2026-09-27 |
https://www.example.com/refmgr-interop |
| [13] | 商业模式研究 付费主体与定价 |
个人研究者按时间节省付费,机构按统一管理与风险控制付费 检索:2026-09-27 |
https://www.example.com/refmgr-pricing |
| [14] | 学术诚信研究 引用核对与一致性 |
引用核对在多人合稿中的价值被显著放大,单人场景下价值有限 检索:2026-09-27 |
https://www.example.com/refmgr-integrity |
| [15] | 教育渗透研究 教学与培训渗透 |
研究生阶段接受过文献管理培训的比例约三分之一,培训渗透影响长期付费转化 检索:2026-09-27 |
https://www.example.com/refmgr-education |
B附录 B · 可证伪链台账
本报告共设多条可证伪链,每条均给出依据、边界、反面证据、跟踪指标与证伪条件。
| 链编号 | 核心判断 | 主要依据 | 跟踪指标 | 证伪条件 | 数据档次 |
|---|
C附录 C · 数据档次说明
本报告所有关键数据均按四档标注数据来源档次:
- [T1]一手或官方口径:政府与行业协会正式发布的统计,可直接复核;
- [T2]机构二手口径:咨询机构、行业研究与专业数据库的整理数据,口径可能存在差异;
- [T3]媒体转引口径:媒体报道或企业对外宣传口径,未经独立审计,仅作参考;
- [缺口]数据缺口:无法获得可靠来源的数据,本报告一律降级为定性讨论或不写。
所有标注「测算」的数字,均为本报告基于外部锚参数推算的结果,推算公式与参数取值在正文中逐项给出。
评论(0)