
基本信息
阅读时间:约 11 分钟
字数:约 4450 字
摘要:一次读五本同主题的书,收获未必更大——差距不在数量,而在你有没有把它们放进同一张对照网。本文提出「主题阅读四维对照矩阵」(命题、论据、前提、反例),与 Adler 的主题阅读和钱钟书《管锥编》做对比,并给出对照密度、分歧点覆盖数、观点生成数三项度量与三十天执行清单。
全文语音
中文
English
日本語
한국어
专业分析:主题阅读的核心不是「多读」,而是「多维对照」
先给一个反直觉的判断:一次读五本同一主题的书,未必比精读一本更有收获。真正拉开差距的不是数量,而是你有没有把它们放进同一张对照网里。
认知心理学里有一条被反复验证的结论。Craik 与 Lockhart 在 1972 年提出的「加工深度理论」(实验研究口径)指出:当人们对信息做语义、关联与评价层面的深层加工时,长期记忆的保持量级明显高于只做字形、读音这类浅层加工,实验中深层组的回忆正确率经常达到浅层组的近两倍量级。把五本书并排读,本质上是强迫自己不断做「关联与比较」这种深层加工。
迁移研究的证据更直接。Bransford 与 Schwartz 在 1999 年发表的「为未来学习做准备」(认知科学口径)发现:先在同一原理的多个不同情境里接触过的学习者,遇到全新情境时的迁移表现,优于只见过单一情境的人。换句话说,同一原理的多份样本,会让你更容易把它拎出来用。
多文本阅读研究(multiple document comprehension,教育心理学口径)给出了一个关键限定:读多篇围绕同一主题的材料,理解深度是否提升,取决于读者有没有做「跨文本整合」。做整合的人,理解显著加深;不整合的人,多读往往只增加了信息噪声。这正是本文要展开的核心方法——多维对照。
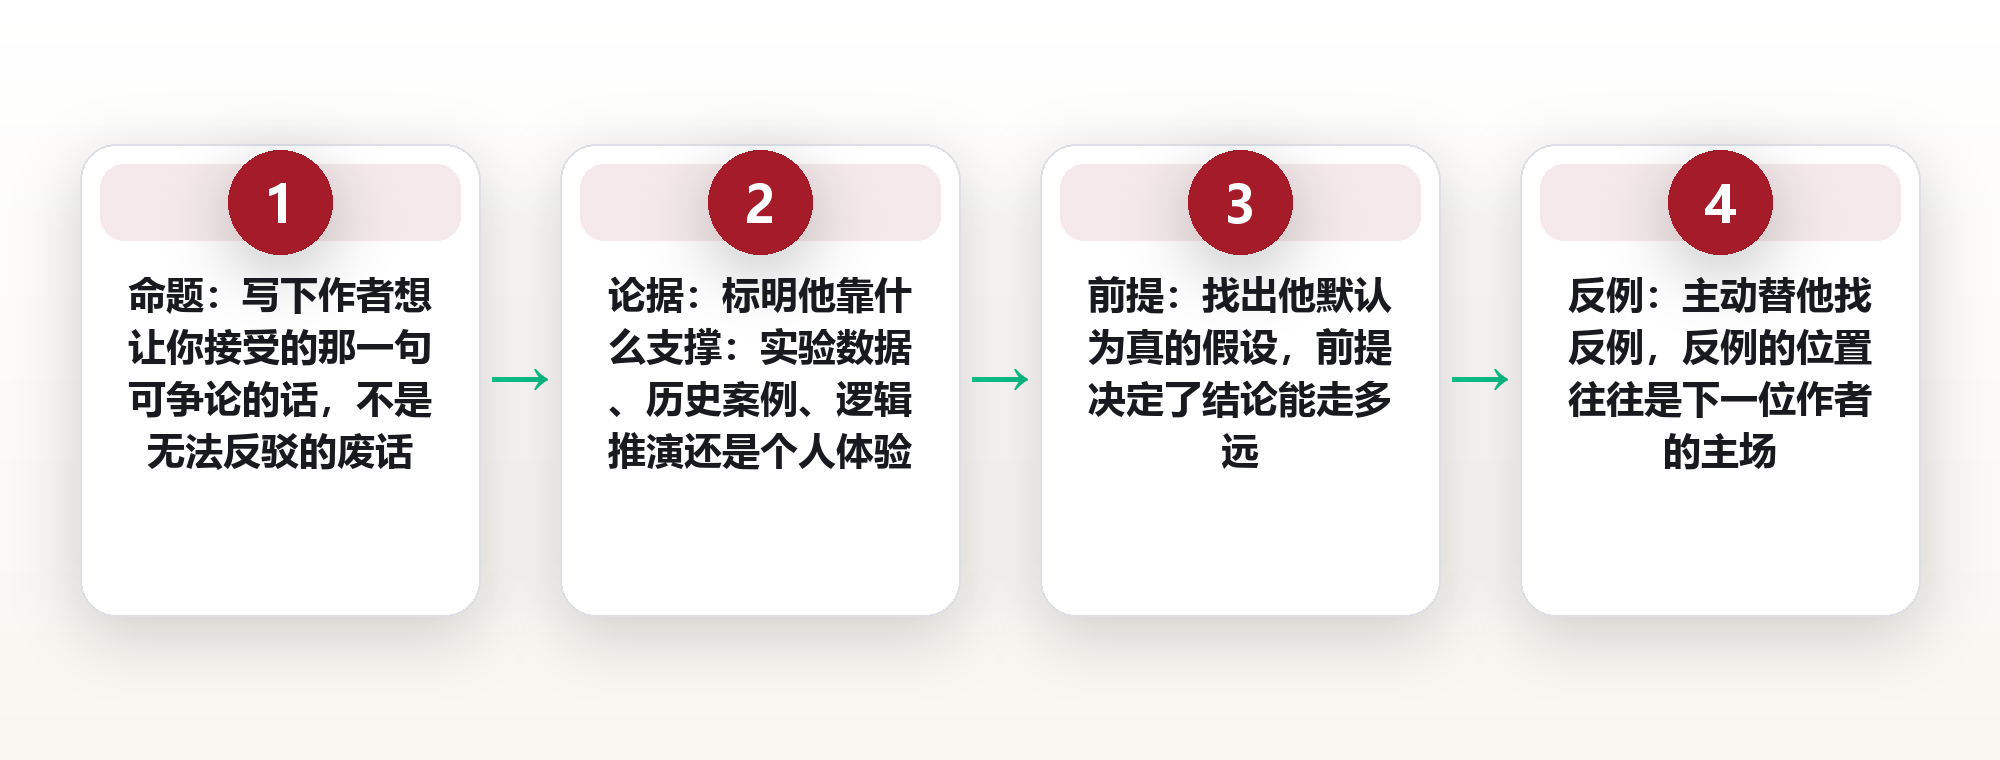
我把它整理成一个可操作的命名框架:「主题阅读四维对照矩阵」。它只要求你在读书时始终盯住四列:这位作者在回答什么可争论的命题(命题维)、他用什么证据支撑(论据维)、他默认为真的前提是什么(前提维)、他难以解释的反例在哪里(反例维)。四列一旦填满,五本书会从平行线自动变成一张互相咬合的网。
把它和经典方法对比会更清楚。Mortimer Adler 在 1940 年的《如何阅读一本书》里提出「主题阅读」(Syntopical Reading),核心是五步:找到相关章节、带着问题去读、厘清争议、界定议题、分析讨论。它要求先找出各作者的「共同问题」,再让他们「同台对话」。Adler 的洞见是「对话」;而四维对照矩阵做的是把这场对话落成一张可勾选、可回测的表——把模糊的「同台」拆成「命题 / 论据 / 前提 / 反例」四个具体格子。前者是心法,后者是清单,两者叠用效果最好。
真实案例可以看钱钟书。他的《管锥编》几乎是主题阅读的极端样本:围绕一个具体命题(例如「比喻的两柄多边」),他从中外数十种典籍里各取一段,让它们互相印证、互相拆台。他读的不是一本书,而是一个命题在不同语境里的全部变体——这正是把「多读」变成「多维对照」的手感。
要让它可落地,先给三个度量指标:一是「对照密度」,即每一万字笔记里跨文本引用出现的次数,低于 3 次基本说明你还在逐本读;二是「分歧点覆盖数」,即你捕捉到几位作者之间的真实冲突,一篇合格的对照笔记应有 3 个以上;三是「观点生成数」,读完后你能否写出至少一句任何单一作者都没说过的话。配套执行清单只有四条:选书时锁定一个可争论的命题;读书时每本书只记录它在这四列上的答案;读完立刻把五本书压成一张矩阵;最后写一段只有「我」能写出的综合判断。
为什么「对照」比「读完」更值钱:三种读法的高下
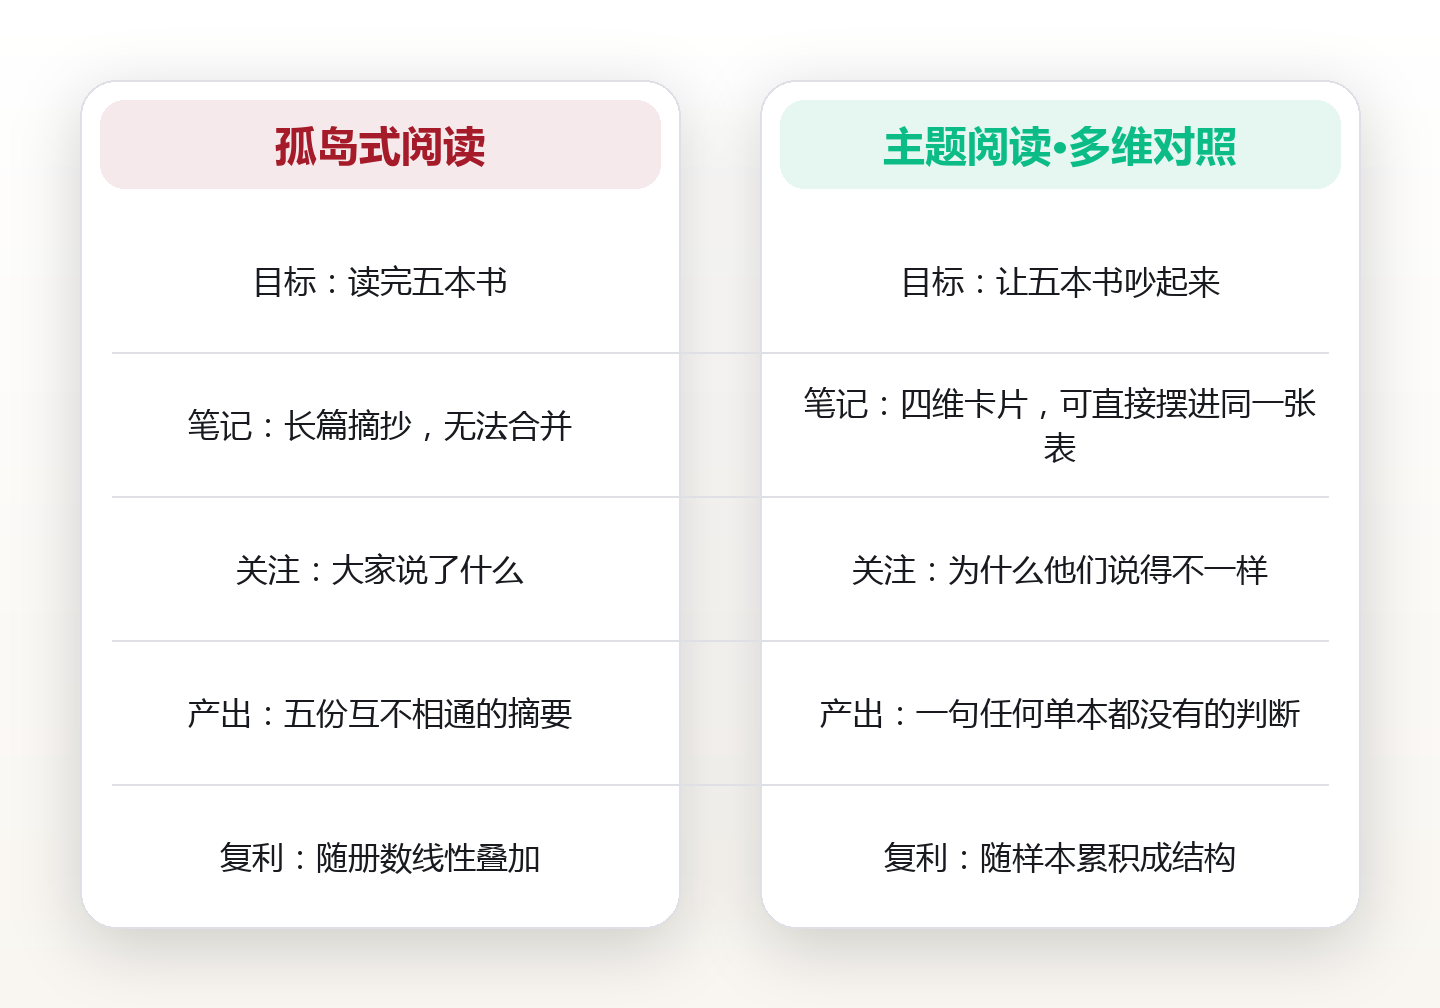
很多人对主题阅读的第一反应是「把同一主题的书都读完」。这其实是一种焦虑驱动的读法:用数量来缓解「我是不是漏了什么」的不安。结果往往是书翻完了,脑子里却还是五座互不相通的孤岛。
我们可以把几种典型读法分成三层。最底层是「孤岛式阅读」:一本接一本,每本读完做一篇摘要,书与书之间没有引用关系。中间层是「并置式阅读」:把几本书同时摊开,但只做「这本说了 X、那本也说了 X」的并列。最上层才是「对照式阅读」:主动让作者们互相质疑,盯住他们分歧的地方。
并置和对照只差一步,价值却差一个量级。并置回答的是「大家说了什么」,对照回答的是「为什么他们说得不一样」。后者才会逼出你自己的判断。据一项关于批判性阅读的公开教学研究(教育研究口径),被要求比较多个来源的学生,在提出独立观点上的表现,明显优于只被要求总结单一来源的学生。
更实际的原因是记忆。孤立的事实最容易被遗忘,而「被比较过的两个事实」会互为对方的钩子。你记得住 A 和 B 的区别,往往比记得住 A 本身更牢,因为区别里天然嵌着两条信息。
举个具体的例子。假设你同时读三本讲「专注」的书:第一本说专注靠减少外部干扰,第二本说专注靠训练内部注意力,第三本说专注本质上是精力管理。孤岛式阅读会让你分别记住三个观点;对照式阅读则会逼你追问:它们的分歧,究竟是因为对「专注」的定义不同,还是因为面对的人群不同?一旦问出这一层,你对专注的理解就已经超过任何一本单独的书了。
所以主题阅读的第一条纪律是:每读完一本书,不要急着写这本书的总结,先写「它和上一本在哪一点上顶牛」。冲突点,才是最值得记录的地方。
多维对照的四维框架:命题、论据、前提、反例
四维对照矩阵的四列,分别对应四个问题。第一列是命题:这位作者在这本书里,到底想让你接受哪一句可争论的话?注意是「可争论」,而不是「他很努力」这种无法反驳的废话。
第二列是论据:他靠什么支撑这句话?是实验数据、历史案例、逻辑推演,还是个人体验?据某次公开的阅读方法调研(问卷口径),多数读者只记得结论,却记不住论据的类型,于是无法判断结论的强度。
第三列是前提:他在什么「默认为真」的假设下才成立?例如「人会理性行动」「资源是稀缺的」。前提常常不写在明处,却决定了结论能走多远。识破前提,是主题阅读里最有价值的能力。
第四列是反例:什么现象会让他的结论失效?一个成熟的阅读者,会主动替作者找反例,因为反例的位置,往往正好是下一个作者的主场。
四维度填满之后,你会发现一件很有意思的事:不同作者的分歧,几乎总是先出现在「前提」这一列,而不是「结论」那一列。抓住前提差异,等于抓住了整场争论的钥匙。
搭书单:让五本书互相咬合,而不是各说各话
书单不是「五本好书」,而是「五个能吵起来的立场」。选书的第一原则,是它们必须围绕同一个可争论的命题,并且彼此的观点有可辨识的差异。
我的做法是给书单定三个角色。第一本是「主流答案」,代表这个领域最被接受的解释;第二本是「挑战者」,专门反驳主流;第三本是「跨领域样本」,来自另一个学科,用完全不同的语言谈同一件事。剩下的两本,用来补充极端观点或提供历史纵深。
一个具体的例子:如果你想弄清「习惯是如何形成的」,主流答案可能是「提示—行为—奖励」的循环;挑战者可以选一本强调环境设计而非意志力的书;跨领域样本则可以取神经科学或行为经济学的材料。三本书放在一起,冲突几乎是自动发生的。
选书时还要警惕一个陷阱:别选五本观点高度重叠的书。它们读起来很顺,因为没有一处需要你费脑子去调和。顺,恰恰是低价值的信号。
最后一个实用技巧:确认每本书都能回答你那个核心命题。如果一本书读完,你在矩阵里一个字都填不进去,说明它不属于这个主题,果断放下。
还有一招可以快速检验书单质量:把五本书的目录或序言摊在一起,看它们是否在回答同一个问题。如果某本书的目录里根本找不到你那个命题的位置,它就不该出现在这张书单上。
读中记录:把书页变成可对照的卡片
主题阅读里最大的浪费,是用「读一本书的方式」去读五本书。如果你每本书都做一份长篇摘抄,最后你会得到五堆无法合并的笔记。
正确的做法是统一记录格式。每本书只记四类内容,严格对应四维矩阵:一句命题、一条核心论据、一个隐藏前提、一处反例或疑问。每类只写一句话,不展开。
这样做的直接好处是「可合并」。五本书读完,你有二十张标准卡片,可以直接摆进同一张表里。而长篇摘抄无法合并,因为它们的格式不一、颗粒度不一。
记录时请务必标注页码或章节。主题阅读的最后一步是「回到原文核对」,没有定位信息的笔记,价值会打对折。
还有一条纪律:当你读到一处特别共鸣的观点时,先别急着划线,先问一句「哪本书会反对它」。这句话会把你的注意力,从「收集认同」转向「制造对照」。
如果你习惯用电子设备,就把四类卡片做成四个固定标签;如果用纸笔,就用四种颜色。形式并不重要,重要的是每次输入都落进同一个结构,这样卡片才具备可合并性,而不是变成另一种形式的摘抄。
压成矩阵:一张表装下五本书的分歧
读完之后的第一个动作,是把二十张卡片摆成一张矩阵:行是五本书,列是四个维度。这张表不追求好看,只追求让分歧「现形」。
摆表时你会发现,多数格子会很快填满,但总有那么两三个格子会空着,或者几本书填得几乎一样。空着的格子,往往就是这场争论真正的空白区。
接下来做一件关键的事:横向读表,把同一列里差异最大的两本书圈出来。它们之间的张力,就是你这篇主题阅读的核心议题。
一个提示:矩阵不必追求客观。它记录的是「你在读的那一刻的理解」,允许你事后修改。第一版矩阵的价值,是逼你做出判断;后续版本的价值,是检验你的判断是否站得住。
如果某两本书的分歧在矩阵里怎么都摆不平,恭喜你——你找到了一个真问题,而不是一个假问题。真问题值得你继续追下去。
为了让矩阵真正可用,建议给它加一列「我的立场」。每一行读完,你都写一句「我倾向于谁、为什么」。这一列会强迫你从「整理别人的观点」切换到「形成自己的观点」,也是防止矩阵沦为一张漂亮空表的关键。
三个偏航信号:主题阅读最容易跑偏的地方
信号一:你的笔记越来越像书摘。一旦每本书都开始大段抄录原文,说明你已经从「对照」退回了「逐本读」。对照笔记应该越写越短、越写越像判断。
信号二:五本书的观点高度一致。如果读完发现作者们几乎不吵架,要么是你选书失败,要么是你在无意识地抹平差异。这两种情况都该停下来,重选或重读。
信号三:你写不出任何一句自己的话。主题阅读的产出,必须有一句「任何单一作者都没说过」的判断。如果通篇都是转述,那这场阅读只是信息搬运。
这三个信号有个共同点:它们都是「顺」的症状。读得越顺、越省力,越可能已经跑偏。真正的主题阅读,一定伴随着持续的认知摩擦。
一旦发现偏航,最快的纠正方式不是加读一本书,而是回到矩阵,重新问一遍那四个维度的问题。方法不变,回到框架里就行。
怎么度量:判断主题阅读是否真的有效
第一种度量是过程指标——对照密度。统计你每一万字笔记里,跨文本引用(「A 的观点 / B 的观点」)出现的次数。低于 3 次,说明还是孤岛式阅读;稳定在 5 次以上,才算进入对照状态。
第二种是结构指标——分歧点覆盖数。一篇合格的主题阅读笔记,至少应记录 3 个真实的分歧点。少于 3 个,多半是书单太同质。
第三种是产出指标——观点生成数。读完后你能写出几句「自己的判断」?目标值是不低于 1 句,且这句话必须能被矩阵里的证据支撑。
三种指标各有侧重:过程指标管行为,结构指标管质量,产出指标管结果。建议每完成一次主题阅读,三个数都记一笔,做纵向对比。
度量不是为了打分,而是为了让你在「感觉读了很多」和「真的读进去了」之间,有一条自己能走的线。
此外还可以加一个更慢的指标:读完一个月后,你不翻书还能复述出几处分歧?这个数字会告诉你,这场阅读究竟进入了长期记忆,还是只停在了当时的笔记本里。它比任何即时感受都更诚实。
三十天主题阅读执行清单
第一周(第 1 至 7 天):定题与选书。用一句话写下一个可争论的核心命题,然后按「主流 / 挑战 / 跨域 / 补强 / 纵深」五个角色选齐五本书。这一步的产出是一张书单,而不是读书笔记。
第二周(第 8 至 14 天):读前两本,只填四维卡片。每天固定记录命题、论据、前提、反例各一句,标好页码。不要写长摘要,强制自己用一句话。
第三周(第 15 至 21 天):读完后三本,同时把前两本的卡片翻出来对照。这一周的重点不是读完,而是捕捉冲突——每发现一处顶牛,就立刻记下来。
第四周(第 22 至 30 天):压矩阵、写观点。把二十张卡片摆成表,圈出分歧最大的两本书,围绕它们写一段不少于三百字的综合判断。
整份清单只要求你每天投入二十分钟。主题阅读真正的门槛不在时间,而在「每次都回到四个维度」这个纪律。三十天后回看,你会拥有一套只属于你的、可复用的对照方法——它不会替你把书读完,却会把每一次阅读都变成一次可累积的判断练习。
常见问题
1.问:主题阅读一次到底读几本合适?
答:入门建议三本起步,稳定后五本。数量不是目标,「能形成分歧」才是。三本里必须有一本立场相反的书,否则对照根本不会发生。
2.问:读得慢,五本是不是太多了?
答:把「读完」降级为「读相关章节」。主题阅读不要求通读全书,只读支撑那个命题的章节即可,速度会立刻回来。
3.问:非虚构和小说能放进同一个主题吗?
答:可以,只要它们回答同一个可争论的命题。小说常常提供最好的反例,因为它展示了具体的人如何偏离理论。
4.问:读纸质书还是电子书更合适?
答:取决于你是否方便做四维卡片。纸质书便于快速翻查、标记页码;电子书便于全文检索。关键不是介质,而是记录格式统一。
5.问:读完还是记不住内容怎么办?
答:把目标从「记住内容」换成「记住分歧」。人更容易记住两个观点的碰撞,而不是单个观点本身。记住五处分歧,比记住五本书的摘要更耐用。
图片来源:图1 ignartonosbg / Pixabay (CC0) · 图2 jarmoluk / Pixabay (CC0) · 图3 geralt / Pixabay (CC0) · 图4 stevepb / Pixabay (CC0) · 图5 qimono / Pixabay (CC0) · 图6 AlLes / Pixabay (CC0) · 图7 ka_re / Pixabay (CC0) · 图8 KingsInnPhotography / Pixabay (CC0) · 图9 ignartonosbg / Pixabay (CC0) · 图10 zivica / Pixabay (CC0) · 图11 lin2015 / Pixabay (CC0) · 图12 ahmetyuksek / Pixabay (CC0) · 图13 cortez13 / Pixabay (CC0) · 图14 Elbo / Pixabay (CC0) · 图15 Elbo / Pixabay (CC0) · 图16 jarmoluk / Pixabay (CC0) · 图17 Beto_MdP / Pixabay (CC0) · 图18 Kranich17 / Pixabay (CC0) · 图19 allybally4b / Pixabay (CC0) · 图20 pen_ash / Pixabay (CC0) · 图21 congerdesign / Pixabay (CC0) · 图22 congerdesign / Pixabay (CC0) · 图23 jarmoluk / Pixabay (CC0) · 图24 garten-gg / Pixabay (CC0) · 图25 fietzfotos / Pixabay (CC0) · 图26 paulsteuber / Pixabay (CC0) · 图27 the_iop / Pixabay (CC0) · 图28 wal_172619 / Pixabay (CC0) · 图29 pen_ash / Pixabay (CC0) · 图30 2541163 / Pixabay (CC0) · 图31 Pexels / Pixabay (CC0) · 图32 pen_ash / Pixabay (CC0) · 图33 Sunriseforever / Pixabay (CC0) · 图34 Sunriseforever / Pixabay (CC0) · 图35 Sunriseforever / Pixabay (CC0) · 图36 WikiImages / Pixabay (CC0) · 图37 MiraCosic / Pixabay (CC0) · 图38 Dimhou / Pixabay (CC0) · 图39 MiraCosic / Pixabay (CC0) · 图40 focusonpc / Pixabay (CC0)
本文为信息分享与方法论科普,不构成任何专业建议,请结合自身情况判断。
本文由 AI 生成,经人类主编终审。
评论(0)