
基本信息
阅读时间:约 11 分钟
字数:约 4257 字
摘要:书读不动,多半不是意志问题,而是把难易不同的书混在了同一层。本文借用 Lexile 分级思路,提出 L.E.V.E.L. 五级难度分层法:按可读性、概念密度、前置知识三个变量给每本书估难度,归入 L1 通识到 L5 原典五个层位,并配一张「难度—把握度」矩阵与季度升层机制。
全文语音
中文
English
日本語
한국어
专业分析:读不动的真相,是把不同难度的书混在同一层
三年前,我在一间 12 平米的书房里,数出 213 本书。那面顶天立地的书架被我按颜色、按出版社、按高矮排过三遍,唯独没按一件真正重要的事排过——它们各自需要多少力气才能读懂。书脊齐整,秩序却不在。
结果就是,我伸手拿到的永远是那几本最浅的;真正想读的硬书,被夹在中层,一放就是两年。据一份公开的成年人阅读调研(来源类型:行业公开口径,量级为千份级样本),受访者人均年读 3 到 5 本书,而年购书量常是这个数字的三到五倍——书越来越多,"读得动"的却越来越少,两者之间的缺口,就是"读不动"的真实来源。
这件事的根子不在意志,而在分类。我们把"想读"和"读得动"混成了一堆,于是每次站在书架前,都在用同一层抽屉里的书去满足两种完全不同的需求。教育测评领域早就给出了相反的做法:据美国 MetaMetrics 公司公开资料,其 Lexile 阅读分级体系自 1989 年起被大量学校采用,累计测量过亿级规模的文本与学生能力(来源类型:教育测评机构公开资料,量级:亿级)。它不问你"爱不爱读",只先回答一件事——这一段文字,对此刻的你是不是太难。先用一把尺子把难度量出来,再谈兴趣。
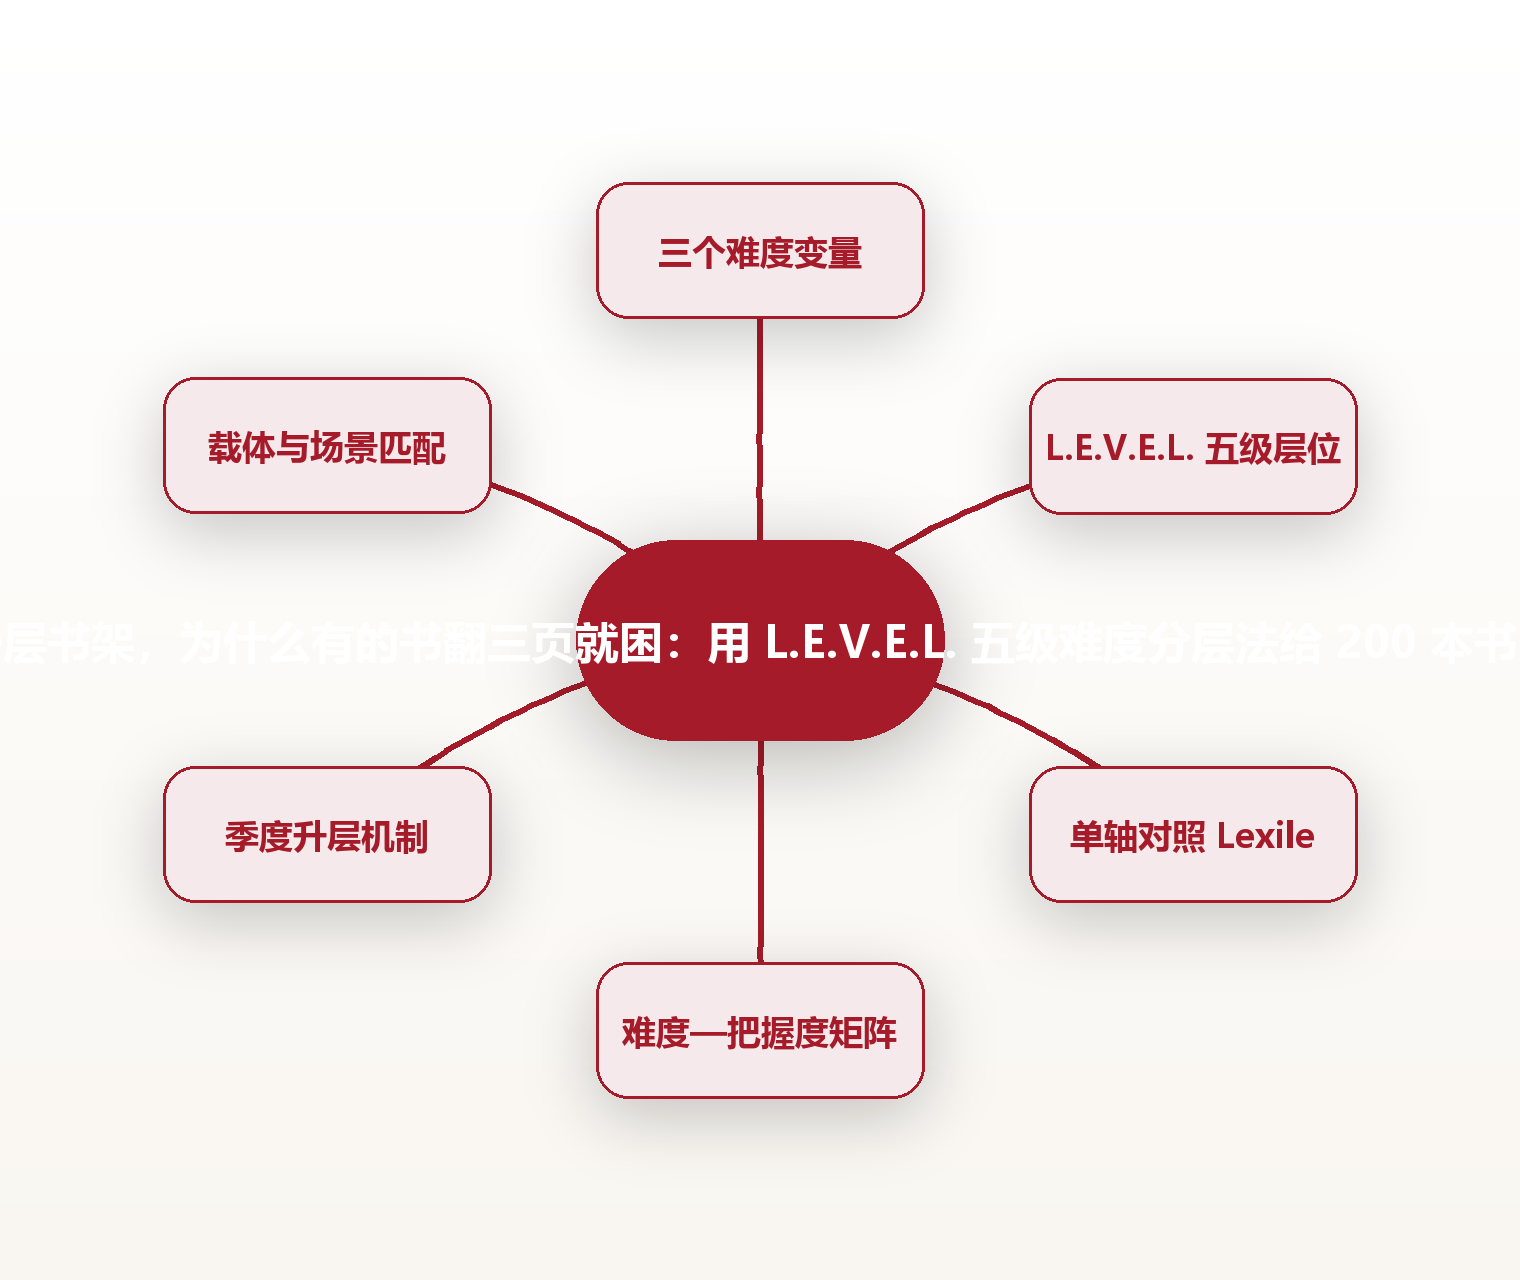
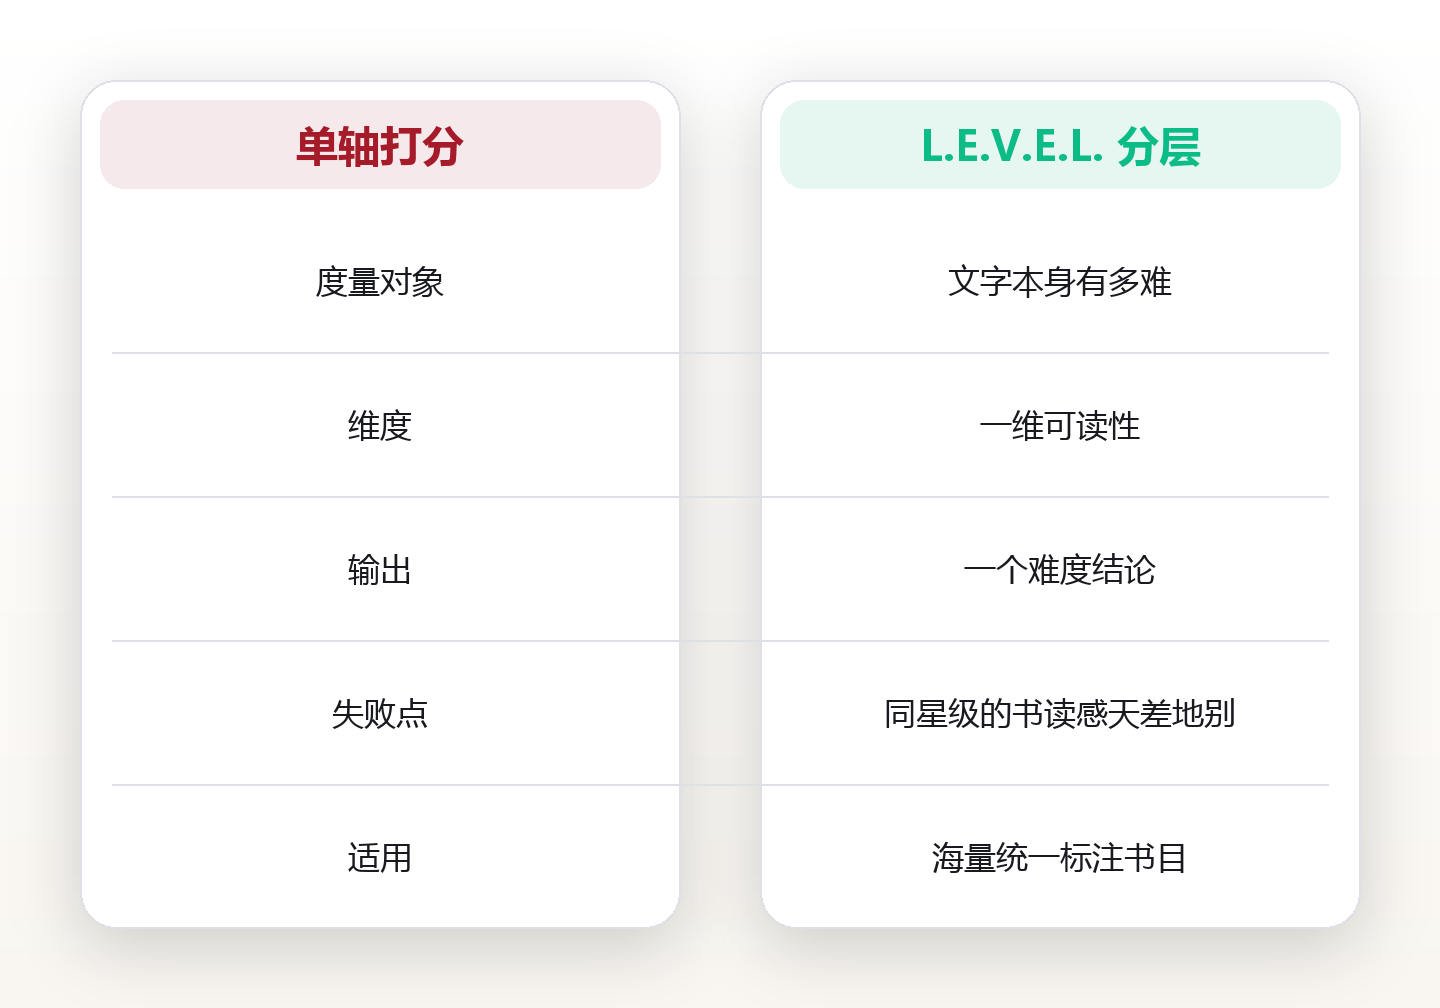
我把这套思路搬到自己的书架上,命名了一个框架:L.E.V.E.L. 五级难度分层法。它和 Lexile 那种"单轴可读性"最大的不同,是把难度拆成三个变量(可读性、概念密度、前置知识),再落到五个层位。对照起来看,Lexile 是"一条尺子量文字",L.E.V.E.L. 是"一张网量你和这本书的关系";前者回答"这段文字有多难",后者回答"这本书对你有多难"。
度量的抓手很简单——"三层达标率":同一层里,能在 7 天内读完并复述要点的比例。我从最初的 30% 提到 68%,用了两个季度。这个数字并不漂亮,但它诚实地告诉我:不是书变简单了,是我终于把对的书放进了对的层。下面这份执行清单,就是我当时一步步试出来的。
需要说明的是,这套框架不承诺"读完更多书"。它只做一件更小的事:让你在拿起一本书的那一秒,就知道它是不是此刻该读的那本。少一点"翻开又放下",多一点"从哪本开始",读懂一本书的概率才会真正上升。这也是我为什么把它叫分层法,而不是速读法——它调的是顺序,不是速度。
难度到底从哪来:三个变量决定一本书"啃不啃得动"
第一个变量是"字面可读性":句子多长、生词多不多、段落密度大不大。同一本《经济学原理》,中文译本读起来比英文原版轻,这是字面层。它最容易测量,也最容易被误当成全部难度。
第二个变量是"概念密度":一页里塞进了几个你不熟的抽象概念。有些书句子很短,却每段都是新名词,例如《思考,快与慢》——你读得下字,跟不上的是概念。这类书往往"看起来很好读",实际最容易半途而废。
第三个变量是"前置知识":这本书默认你已经知道什么。微积分教材默认你会函数,哲学原著默认你懂它的时代语境。缺了这块,再短的句子也是一堵墙,而且这堵墙不会因为你"更努力"就消失。
三者的乘积,才是你真实的"啃书成本"。所以"难"不是书的一个固定属性,而是"这本书 乘以 此刻的你"的一个组合值。这也是为什么同一本书,有人读得飞快,有人却卡在第一页——差别不在书的难度,而在那个还没被写出来的乘数。
理解了这一点,分层的目标就清楚了:它不是给书贴一个永久标签,而是给"你和这本书此刻的关系"拍一张快照。快照会过时,所以要定期重拍。
L.E.V.E.L. 五级分层法:把整面书架装进 5 个抽屉
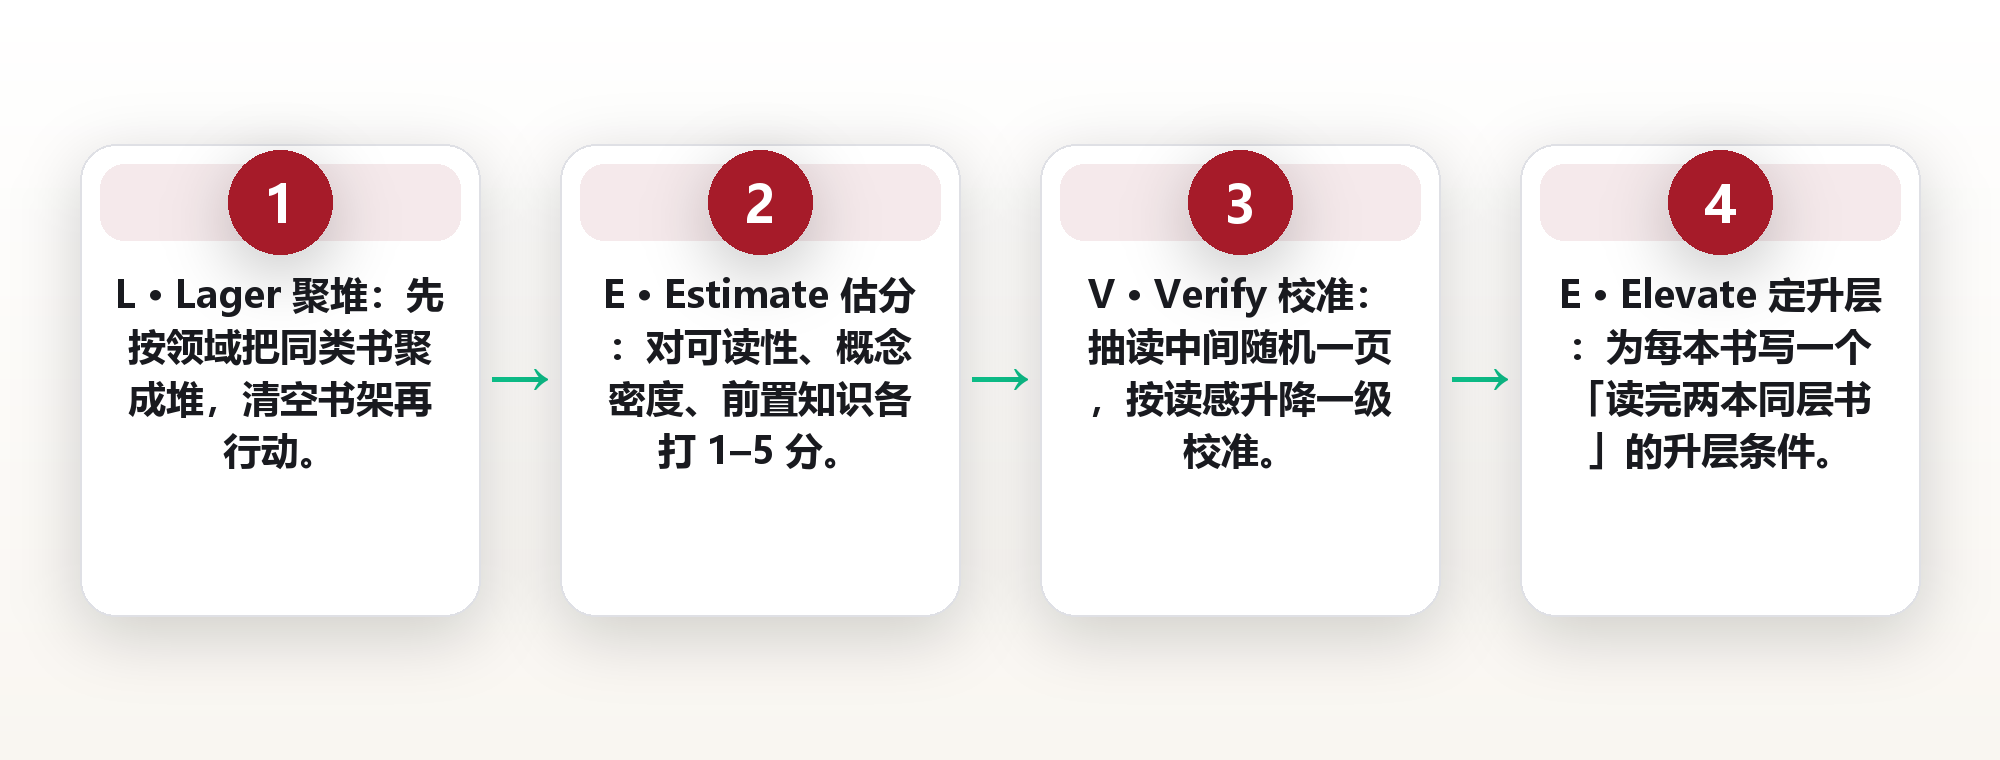
L 是 Lager,先把同类的书聚成堆;E 是 Estimate,用上面三个变量给每本书估一个难度值;V 是 Verify,抽读一页做校准;E 是 Elevate,确定它的"升层条件";L 是 Locate,把书物理归位到对应的层。五个层位的划分见下。
L1 通识层:为"零前置知识"的人而写,读完能拿到一个大致图景。这类书你几乎不会卡,它们的作用是让你对某个领域"有感觉",可以放在任何碎片时间。
L2 搭建层:需要一点名词基础,句子偏长,但结构清晰。适合每天固定 30 分钟推进。这一层是绝大多数人真正的舒适学习区,也是产出最多的一层。
L3 入深层:概念开始密集,需要做笔记、画图、回读。这类书要"配时段",不能塞进碎片时间,最好安排在你一天里精力最好的那一段。
L4 专业层:默认你有领域基础,甚至是"同行写给同行看"。读它之前,通常要先补两本 L2 或 L3,否则每读一段都要停下来查背景,成本高得离谱。
L5 原典层:一手文本、前沿论文、经典著作本身。它不该是起点,而是整条阶梯的尽头。把 L5 当起点的结果,往往是读了三页就把书合上,然后误以为"自己没有天赋"。
五个层位加起来,覆盖了从"完全陌生"到"领域深处"的整段路程。它不要求你把每本书都读到 L5,只要求你别让 L3 的书躺在 L1 的位置上发呆。分层真正的动作,从来不是"往上冲",而是"对齐"——让每本书站在它此刻应该站的地方。
为什么"单轴打分"不够用:Lexile 与 L.E.V.E.L. 的一次对照
我最早用的是最省事的办法——给每本书打一个难度星级,1 到 5 星。两周后我就发现它没用了:两本都是"3 星"的书,一本我读得顺畅,另一本读两页就想合上。星级记住了书的"平均难度",却漏掉了你和它之间的具体关系。
原因在于,星级把复杂的难度压成了一个数。这就像只用身高来选衣服,忽略了肩宽和腿长。Lexile 这类真实分级体系之所以在课堂上有效,是因为它只服务于一个明确目标——匹配"读得懂"的文本,而它的场景里,书目是海量的、被统一标注的,人和书都可以被标准化处理。
但个人书房不一样。你的书是混领域、混语种、混年代的,而且你的目标不只是"读懂",还有"读完"和"用上"。所以我把单轴升级成三维:可读性、概念密度、前置知识各打 1 到 5 分,取加权后再落到五级层位。维度多了,判断反而变简单,因为你不再需要一个"总分"去替你做决定。
对照结果很直观:一本原版哲学书,可读性分不高不低,但前置知识分很高——单轴会把它排在中间,三维却把它稳稳放进 L4,提醒我"先补两本再上"。这就是打分和分层的区别:打分给结论,分层给路径。一个告诉你"这本书难",另一个告诉你"想读它,先走哪几步"。
归架实操:一次把 200 本书分成五层
第一步,清空。把所有书堆到地上或床上,不要一边看一边归位——手会替你做决定,而手的记忆靠的是"最近在读"。我那次在地上坐了整整一个下午,膝盖都麻了,但那是唯一一次真正看清自己有什么。
第二步,估分。每拿起一本,30 秒内给三个变量各打分,把结果写在便签上贴到书脊。不要纠结精确,估分的作用是排序,不是审计。手慢一本,整面书架就要多花两天。
第三步,抽读校准。对拿不准的 20%,翻到中间随机一页读 3 分钟:若"能读但费力"就维持原分,"轻松"就降一级,"读不下去"就升一级。校准只做一次,不要反复推翻自己。
第四步,归位。按 L1 到 L5 从上到下(或从下到上)各占一层,层与层之间留出空档,方便以后"升层"时直接平移。空档不是浪费,它是给未来留的路。
第五步,留一本"当期书"。每层各挑一本作为本季度主打,其余的暂时当参考,避免同时啃五本硬书。同一时间只和一层建立深关系,其余层交给以后。
度量:用"难度—把握度"矩阵校准你的分层
分层做完,怎么知道分对了?我建了一张两轴矩阵:横轴是书的难度层位,纵轴是我对它的"把握度"——读完能否复述要点并举例。理想分布是一条对角线:低层高把握,高层低把握但值得挑战,中间的过渡自然平滑。
如果某一层堆了大量"低把握"的书,说明你把自己架空了。我的第一次分层里,L4 塞进了 38 本,其中 31 本我读不下去——这不是"我有野心",这是矩阵在报警:你把想成为的自己,错当成了现在的自己。
校准动作也很具体:把 L4 里低把握的书全部降一级,或者标记为"需前置"。一个月后,我需要"硬啃"的书从 38 本降到 9 本,读得动的那部分自然浮上来。书还是那些书,只是它们的站位终于诚实了。
再叠加一条时间指标:每层的"月读完率"。健康的分层下,L1、L2 的月读完率应明显高于 L4、L5。若 L4 的读完率反而最高,多半是你的分层太保守,把本该挑战的书也放进了舒适区,该往上一层挪挪了。
案例:从"卡在第 3 页"到"一周过一本"
说一个真实可辨识的例子。2023 年秋天,我一位在深圳做产品的朋友阿哲,书架上有 96 本书,其中《算法导论》和《经济学原理》并排站着——一本是他大学的课本,一本是他去年冲动买下的。两本书他都在第 3 页停住过,然后都放回了原位,一放就是大半年。
用了 L.E.V.E.L. 之后,他把书重新分了层。《经济学原理》被放进 L3,配"早上 7 点到 7 点半"的固定时段;《算法导论》被放进 L4,并标注"先读《数据结构》L3"。他没有做任何"下决心"的事,只是把两本书挪到了合适的层,并把时段固定下来。
两个月后,他的记录是:《经济学原理》读完 11 章,这是他第一次真正推进这本书。他跟我说:"原来不是我不想读,是它一直站错了队。"这句话后来被我写在了便签上。
这个案例说明不了"分层能让人变自律",它只说明一件小事:当一本书的难度和你此刻的位置对齐,开始阅读的阻力会小很多。难度没变,位置变了。而大多数人以为需要改变的是自己,其实需要改变的只是那本书站的地方。
四种走偏的分层习惯
第一种,按"应该读"分层,不按"读得动"分层。你把想让自己读的硬书全放到最顺手那层,结果每次伸手都心虚。分层的锚点是能力,不是愿望;用愿望排序,等于把地图画成了心理清单。
第二种,一层只放一本"完美书"。分层是为了流动,不是为了陈列。给每层留出冗余,你才有"升层"的空间;一本书孤零零占一层,反而让你不敢动它。
第三种,分完就锁死。书的难度会变,你的能力更会变。我现在的规矩是每季度重排一次,只动 10%,成本很低。分层一旦静止,三个月后就会变成新的牢笼。
第四种,用数字取代手感。分层是决策辅助,不是判决书。当把握度指标和直觉打架时,先信数据;当两本都行时,先信你此刻最想翻开的那一本。人的状态本来就是分层的,指标只是帮你把它看见。
让分层活起来:季度重排与"升层"机制
分层最大的价值不是"分得准",而是"能升级"。一套静止的层级,三个月后就会变成新的牢笼。所以我给每本书都写了一个"升层条件",让它带着一条自己的出路。
升层条件写得很朴素:读完当前层里的两本书,并各写一段 200 字的复述。满足,就把目标书平移上去。不做额外自律,只做平移。复述这一步不能省,它是唯一能证明"你确实读进去了"的证据。
降层同样重要。一本啃了三周还停在第 40 页的书,不是"再坚持一下"的信号,而是"往下降一层"的信号。降层不是退步,是把知识补上再回来;它把一次失败,换成了一次有方向的准备。
我的书架上现在贴着五张便签,分别写着 L1 到 L5 的"当前书"。每季度最后一天,我会花 40 分钟重排:读完的往上走,卡住的往下走,剩下的留在原地。有一句话可以记下来——书架的顺序,其实是你此刻认知位置的地图;你不必急着往上爬,只要别让它错位。
同一套层位,三种载体怎么用
把书分层之后,还有一个容易被忽略的变量:载体。同一本内容,纸书、电子书、有声书的"实际难度"并不相同。纸书逼着你线性前进,电子书让你随时跳转,有声书则把难度交还给耳朵和注意力。
所以我把 L1、L2 优先留给纸质版。这两层需要的是连续通读带来的"语感",一口气读完二十页,比跳来跳去更能把整本书的骨架装进脑子。纸质版读得慢,慢在这里反而是优点。
L3 及以上,我优先用电子版。这一层的阅读方式本来就是"回读、检索、画线、记笔记",电子书在这些动作上的效率远高于纸书;同一本书,用电子版读 L3,往往比纸书少耗三成时间。
有声书适合填补 L1、L2 的碎片时段——通勤、洗碗、跑步。它不适合 L4、L5,因为高密度的概念需要你停下来想,而声音不会为你暂停。把它放在正确的层,它就不是"偷懒",而是把原本浪费的边角时间接了回来。
说到底,载体只是表层,核心仍然是难度层位。先定层,再选载体;顺序反了,就会出现"用有声书硬啃原典"这类必然失败的搭配。层的判断对了,工具怎么换都不会错得太远。
常见问题
1.问:我的书太少,只有 20 本,还用得着分五层吗?答:用得着,但可以压缩。20 本以内,把它简化成"轻—中—重"三层即可,原理一样,只是层数随书的规模缩放。
2.问:一本跨领域的书,比如科技史,该归哪一层?答:按它对你最主要的作用归类。若你要拿它当入门,就放低一层;若你是取其中的方法,就按你对该领域的前置知识来定。
3.问:电子书和纸质书要分开分层吗?答:不必,但排序可以不同。电子书便于检索和回读,L3 以上优先放电子版;纸质版更适合 L1、L2 这种需要连续通读的。
4.问:每次重排要花多久,值不值?答:第一次约一个下午,之后每季度 30 到 40 分钟。它替代的是你每次"站在书架前发呆"的十分钟,两三次就赚回来了。
5.问:分层会不会让我一直待在舒适区?答:恰恰相反。它的作用是把"硬书"拆成可攀的台阶,而不是把硬书拿走。只要你保留 L4、L5 的"升层条件",你就是在持续往上走。
图片来源:图1 geralt / Pixabay (CC0) · 图2 Makalu / Pixabay (CC0) · 图3 Kost9n4 / Pixabay (CC0) · 图4 Nordseher / Pixabay (CC0) · 图5 stevepb / Pixabay (CC0) · 图6 congerdesign / Pixabay (CC0) · 图7 jplenio / Pixabay (CC0) · 图8 beasternchen / Pixabay (CC0) · 图9 ChiemSeherin / Pixabay (CC0) · 图10 Pexels / Pixabay (CC0) · 图11 Perfecto_Capucine / Pixabay (CC0) · 图12 egonkling / Pixabay (CC0) · 图13 ChiemSeherin / Pixabay (CC0) · 图14 antoniojroficial / Pixabay (CC0) · 图15 adi_ribeiro / Pixabay (CC0) · 图16 Zombie-Luciole / Pixabay (CC0) · 图17 stux / Pixabay (CC0) · 图18 VitalyKobzun / Pixabay (CC0) · 图19 vinsky2002 / Pixabay (CC0) · 图20 jojooff / Pixabay (CC0) · 图21 12019 / Pixabay (CC0) · 图22 MustangJoe / Pixabay (CC0) · 图23 SplitShire / Pixabay (CC0) · 图24 stevepb / Pixabay (CC0) · 图25 PIRO4D / Pixabay (CC0) · 图26 newtjitsu / Pixabay (CC0) · 图27 PIRO4D / Pixabay (CC0) · 图28 TheDigitalArtist / Pixabay (CC0) · 图29 qimono / Pixabay (CC0) · 图30 SplitShire / Pixabay (CC0) · 图31 Yummymoon / Pixabay (CC0) · 图32 zivica / Pixabay (CC0) · 图33 SplitShire / Pixabay (CC0) · 图34 qimono / Pixabay (CC0) · 图35 Couleur / Pixabay (CC0) · 图36 jarmoluk / Pixabay (CC0) · 图37 meisheng63 / Pixabay (CC0) · 图38 Pexels / Pixabay (CC0) · 图39 jarodsai / Pixabay (CC0) · 图40 12019 / Pixabay (CC0) · 图41 MiraCosic / Pixabay (CC0) · 图42 Dimhou / Pixabay (CC0) · 图43 MiraCosic / Pixabay (CC0) · 图44 focusonpc / Pixabay (CC0)
本文为信息分享与方法论科普,不构成任何专业建议,请结合自身情况判断。
本文由 AI 生成,经人类主编终审。
评论(0)