
基本信息
阅读时间:约 12 分钟
字数:约 4753 字
摘要:谈话保密边界的难点,很少在“能不能说”,而多在“这段内容能走多远”。本文以 SPAN 四问框架(信源、目的、受众、必要性)拆解内容共享范围,对比查塔姆宫守则,给出原话/结论/信号三类内容分档、一对一默认规则、去标识转述、跨层级协商与越界修复的完整方法,并配套四个可度量指标与执行清单,让每次谈话都有清晰的边界。
全文语音
中文
English
日本語
한국어
专业分析:一次谈话的内容,共享半径究竟有多大
谈话保密边界这件事,第一个反直觉的事实是:绝大多数信息外泄并非出于恶意,而是出于「内容共享范围」的模糊。据公开的组织沟通调研(样本量级:数百家企业、数千名知识工作者,口径为匿名问卷),相当比例的敏感信息扩散源于内部转述,而非外部获取;而在被访者中,过半的人承认自己「拿不准某句话能不能转给第三方」。请注意,这是量级演示,不同行业差异很大,但它稳定指向一个结构:边界不是靠人品守住的,而是靠事先约定的范围守住的。
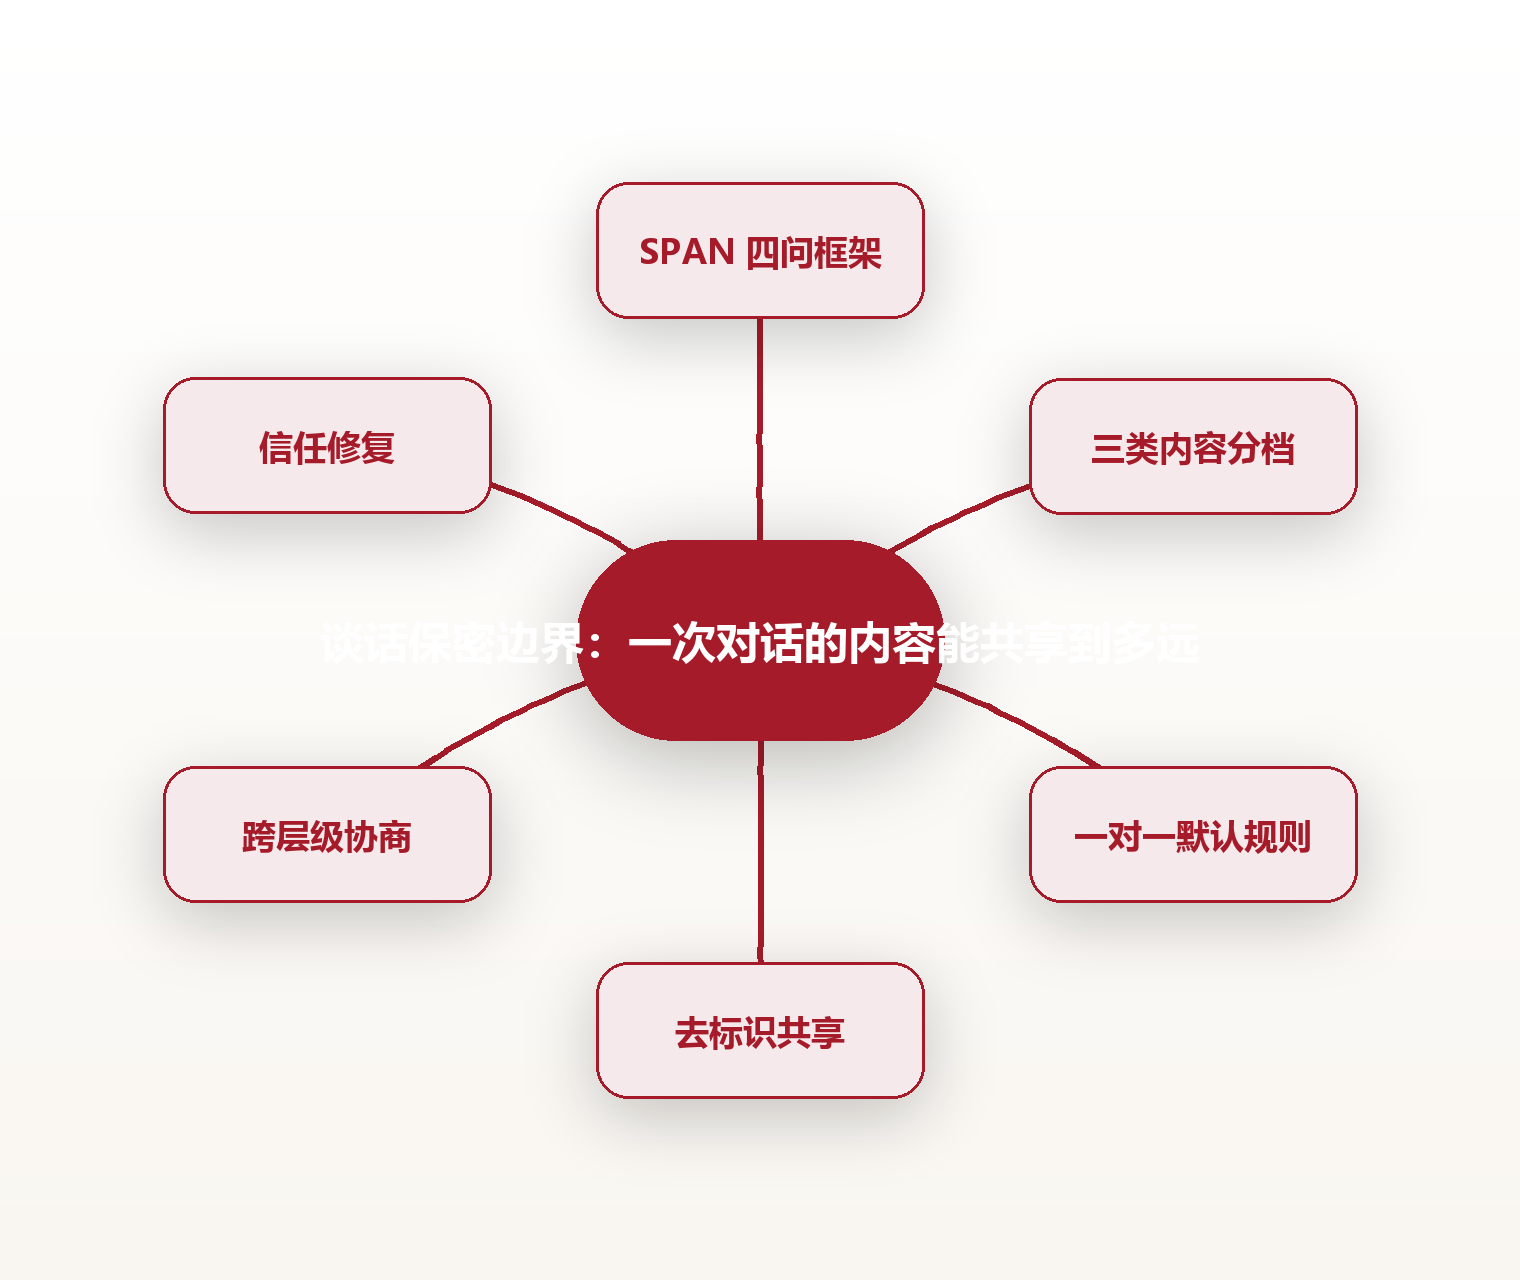
先把概念说清楚。所谓谈话保密边界,指的是在特定对话场景中,哪些内容可以被带出、以什么形式带出、又能带给谁。它由三个变量共同决定:内容的敏感度、对话的语境、以及接收方与话题的关联度。三者只要有一个失控,边界就会被击穿。很多人只盯内容敏感度,却忽略了语境和受众,结果一句本可以共享的事实,因为带上了错误的语境,变成了伤害。
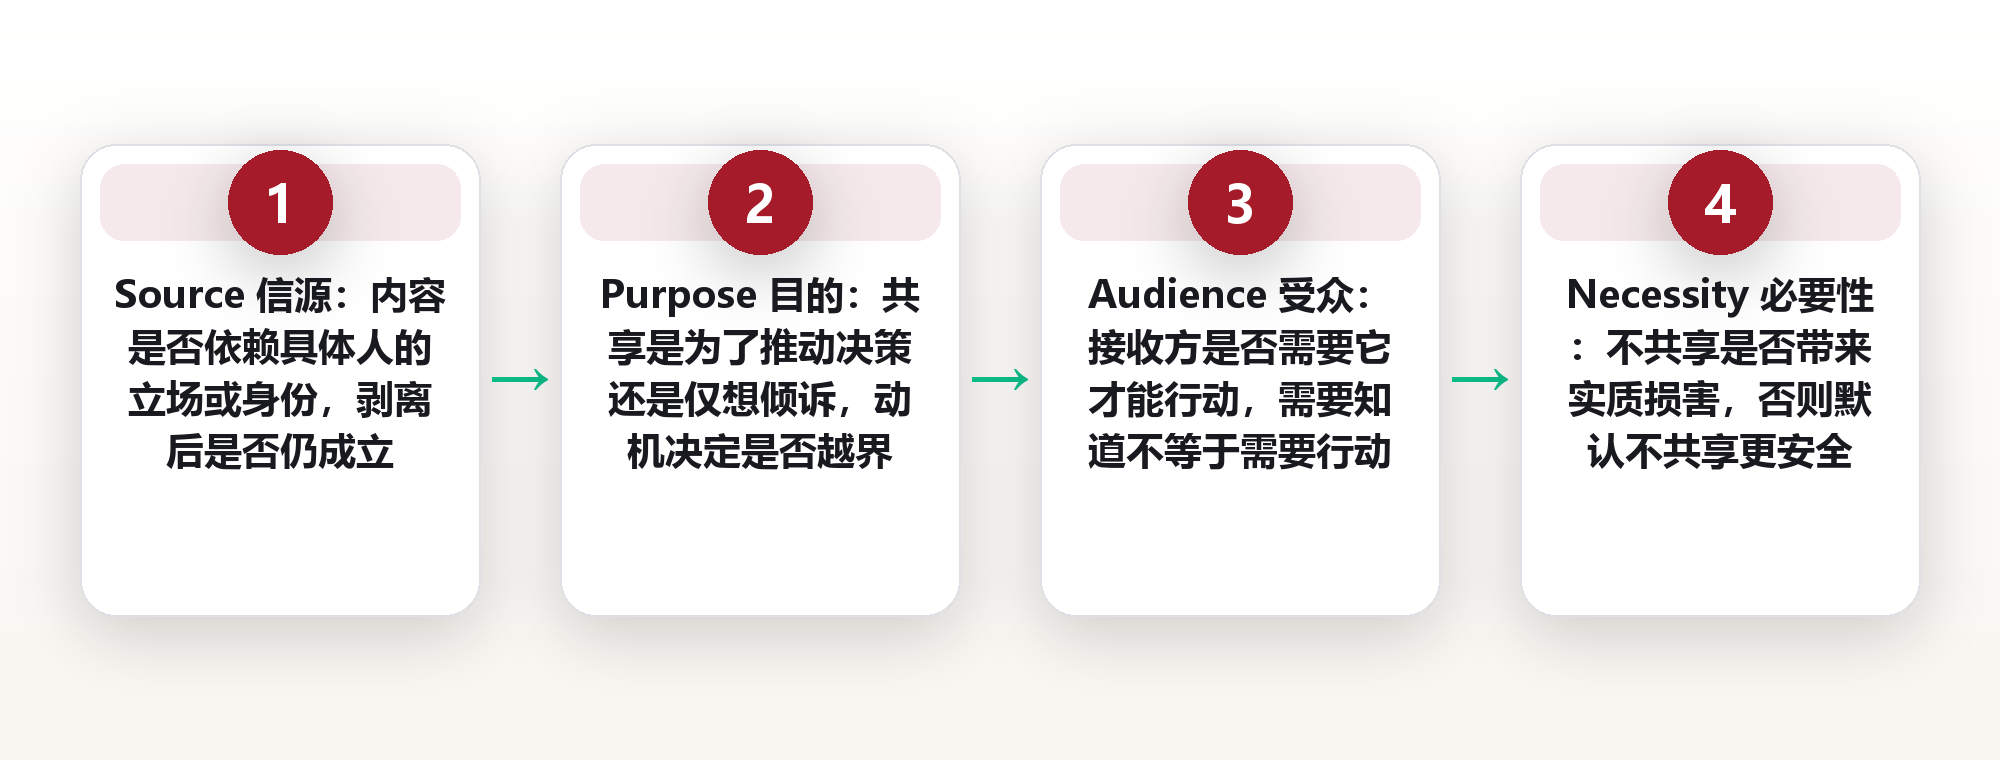
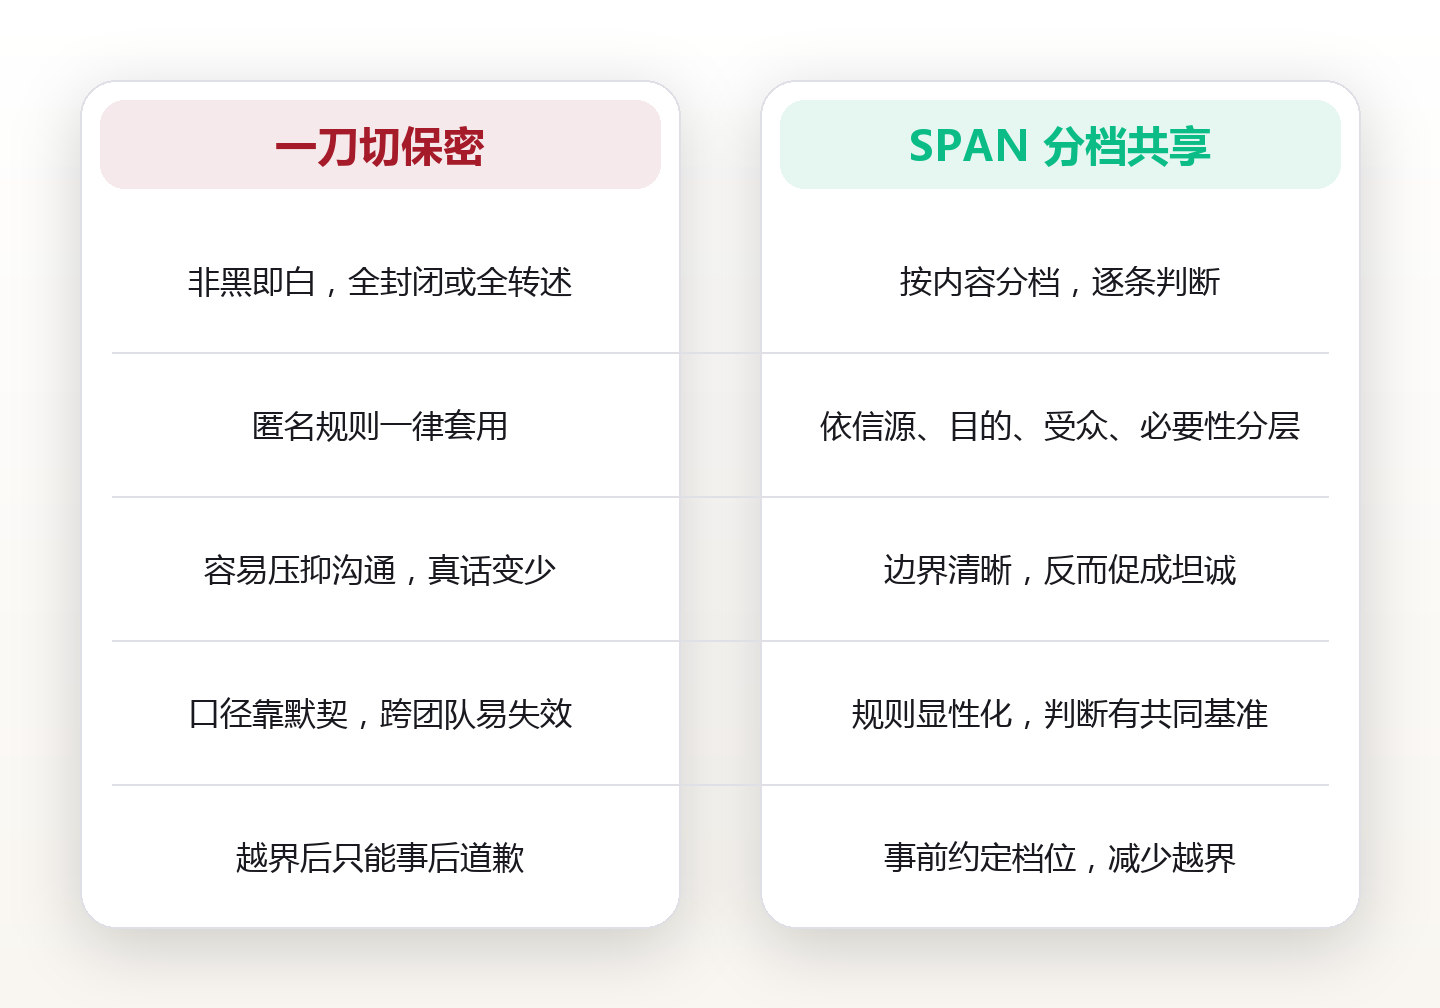
我把判断流程命名为 SPAN 四问框架:S 是 Source(信源是否可披露),P 是 Purpose(共享目的是否正当),A 是 Audience(接收方是否确实需要),N 是 Necessity(不共享是否会带来实质损害)。四个问题全部通过,内容才可以外传;任一不过,就应降级为去标识共享或留在原地。它和著名的查塔姆宫守则(Chatham House Rule)形成鲜明对照:查塔姆宫守则是「一刀切」的匿名规则——与会者可以引用信息,但不得披露发言者身份;而 SPAN 是一个分档判断,允许同一场谈话里的不同内容走不同档位,粒度更细,也更贴近日常协作。
一个真实可辨识的参照,正是查塔姆宫守则本身。它起源于 1927 年英国皇家国际事务研究所(Chatham House,又译查塔姆研究所)的一次闭门会议,目的是让与会者能坦诚交换意见,同时保护发言者不被对外引用。近百年后,它被联合国、北约以及大量跨国企业采用,作为高层闭门会的默认规则。它的可识别之处在于:一条简单的共享范围约定,就让原本不愿开口的人愿意说真话——可见边界并不意味着限制沟通,恰恰相反,清晰的边界是促成坦诚的条件。
落地时建议盯四个指标。第一,转述合规率:事后抽查被转述的内容里,符合事先约定范围的比例,健康团队应保持在九成以上;第二,去标识率:需要外传的敏感内容里,完成去标识处理的比例;第三,边界争议数:一定周期内关于「这句能不能说」的争论次数,这个数字先升后降是健康信号——升说明大家开始有意识,降说明边界已经内化;第四,信任回修时长:从一次越界到关系恢复的平均时间,它衡量的是协作网络的韧性。
执行清单同样要给到:①谈话开始前,用一句话约定本轮内容的共享档位;②对含糊内容,默认按更严的档位处理;③转述前先问一句「我能不能引用」,这一句话就能避免大多数误会;④需要共享结论时,剥离信源与身份,只带走观点;⑤把「哪些能带出、哪些留在原地」写进会议与协作模板,让边界成为默认动作,而不是临场判断。
为什么「共享范围」比「能不能说」更棘手
把保密理解成一个「能说」或「不能说」的开关,是团队协作里最典型的误区。真实的谈话内容很少是非黑即白的,它更像一条光谱:同一场一对一里,既有可以公开的进展信息,也有必须留在原地的个人评价。用开关思维去管理光谱,边界必然处处漏风。
所以真正难的不是判断「要不要保密」,而是判断「这段内容能走多远」。范围判断要求同时权衡内容、语境与接收方,而二元判断只需要一个「否」字。人的大脑偏爱二元判断,因为它省力;但组织协作需要的是范围判断,因为它精确。省力的代价,往往是信任的损耗。
范围失控有典型的连锁效应。一句在一对一里出于信任说出的顾虑,被原样带进团队会议后,会迅速被解读为「某人反对某事」。发言者失去的不仅是隐私,还有对未来对话的安全感——下一次,他会选择不说。沉默一旦成为理性选择,组织就失去了最早的风险信号。
另一个难点是信息的不对称。发言者往往比别人更清楚一句话的分量,而转述者未必掌握背景。当转述者用「我觉得这个不重要」来裁剪内容时,无异于替别人决定了他隐私的边界。善意并不等于授权,这是边界管理里最容易被忽视的一条。
因此,边界必须被显式地谈出来,而不是靠默认的默契。默契只在双方经验接近时有效;一旦跨层级、跨团队、跨文化,默契几乎必然失效。把隐含期待变成共同约定,是让共享范围可控的第一步。
保密边界里的三类内容:原话、结论、信号
与其逐句判断,不如先把谈话内容分档。实践中可以把内容归为三类:原话、结论、信号。这三类内容的共享成本与风险依次递减,处理方式也各不相同。
原话,是发言者的具体措辞与语气。它信息量最大,也最容易被归因——只要措辞有辨识度,听者往往就能猜出说话的人是谁。因此原话默认不外传,除非发言者明确授权。很多人没意识到,原话的杀伤力不在内容,而在它还原了「谁说的」,从而把观点变成了立场。
结论,是从原话里提炼出的判断,例如「资源需要向某个项目倾斜」。结论可以共享,但前提是剥离信源与情绪色彩,只保留事实与主张。共享结论的正确姿势,是让它脱离某个人的名字依然成立,而不是成为某人的代言。
信号,是更抽象的趋势,例如「团队对当前的节奏普遍感到压力」。信号几乎总是可以共享的,因为它不指向任何个人,却能帮助更大范围的人做判断。把敏感内容提升到信号层再共享,是一种既保护个体、又传递价值的成熟做法。
分档的最大好处,是把「能不能说」这个大问题,拆成「这段内容属于哪一档」这个小问题。判断对象从模糊的整体,收敛为清晰的类别,决策速度与准确度都会明显提升。
SPAN 四问框架:把判断拆成四个动作
第一问 Source,问的是信源。这段内容是否依赖某个具体的人的立场、措辞或身份?如果剥离信源后内容就失去意义,说明它高度依赖身份,应当留在原地。依赖身份的内容,一旦外传就等于把人一起带了出去。
第二问 Purpose,问的是目的。我为什么要共享它?是为了推动决策、请求资源,还是仅仅为了交换信息、寻求认同?前者往往正当,后者则要警惕——很多越界的起点,只是「想找人聊聊」。
第三问 Audience,问的是接收方。对方是否确实需要这条信息才能行动?需要「知道」和需要「行动」是两回事,共享范围应以后者为准。受众越精准,边界越容易维持。
第四问 Necessity,问的是必要性。如果不共享,是否会带来实质损害?如果答案是否定的,那么不共享就是更安全的选择。默认不共享,需要时才共享,这一取向能挡住绝大多数无谓的扩散。
四问全部通过,内容方可外传;任一不过,就降级处理——要么去标识,要么缩小受众,要么干脆留在原地。框架的价值不在复杂,而在让判断有据可依,让「我觉得可以说」变成「四条都过了才说」。
一对一的默认规则:哪些话默认留在原地
一对一之所以能产生真话,是因为参与者默认它比公开场合更安全。这个「默认」就是边界的地基,一旦被破坏,一对一的沟通质量会迅速下降。保护这个默认,比事后补救重要得多。
建议给一对一设一条底线规则:涉及对第三方个人的评价、涉及尚未决定的组织变动、涉及发言者的脆弱表达,默认不对外转述。需要共享时,先取得发言者同意。这三类内容一旦流出,对关系的伤害往往是不可逆的。
同意也应有明确的粒度。「我可以把这件事跟团队说吗」与「我可以把具体说法转给谁」是两个不同层级的问题。越具体的授权,越能保护信任;笼统的授权,则容易在传递中被放大解读。
对主管而言,一个实用习惯是:在转述前先告诉当事人「我打算这样表述,你看可以吗」。把措辞提前给对方过目,既尊重了边界,也避免了自己无心造成的误读。这一动作几乎零成本,却能显著提升信任。
需要说明的是,默认规则不是绝对禁令。当谈话涉及安全、合规或重大风险时,共享义务可能高于保密期待。但即便是这种情况,也应事先说明「我可能无法完全保密」,而不是事后才解释——前者是尊重,后者是背叛。
去标识共享:怎样转述才不伤信任
大多数需要外传的内容,都不必以原话形式出现。去标识共享,就是把「谁说的」和「说了什么」拆开,只带走后者。它是在保护信任的前提下,让有价值的信息继续流动的关键技术。
去标识有三层动作:换人称,把「他对我说……」改成「有一种观点认为……」;去细节,删掉只有当事人知道的背景与数字;改归因,不把观点绑定到某个部门或岗位。三层叠加,内容才会真正脱离个人。
一个典型错误是「伪匿名」——嘴上说不提名字,描述里却保留了独一无二的细节,听者一猜就中。真正的去标识,要站在接收方的角度自问:仅凭这些信息,他能不能反推出是谁?推得出,就等于没做去标识。
去标识还要保留语境。只带走结论、丢掉前提,容易让内容在传播中被放大或变味。稳妥的做法是同时保留「这是在什么背景下说的」,让接收方不至于误判,也避免原意被扭曲成极端版本。
最后,去标识不等于免责。如果内容本身高度敏感,即使隐去身份,共享仍可能造成伤害——比如涉及健康状况或家庭变故。这时应回到 SPAN 框架,重新判断是否真的需要共享,而不是用「我已匿名」来自我开脱。
跨层级与跨团队:共享范围需要被谈出来
向上汇报与向下传达,是共享范围最容易失控的两个方向。向上时,信息容易被层层加码;向下时,领导者的一句话常被当成正式决策。两个方向都容易让边界在传递中走样。
跨层级共享的第一原则是标注性质。转述时明确区分「这是讨论中的想法」与「这是已确定的方向」,能避免大量误解。一句话的定性,胜过事后十次澄清;很多所谓的执行偏差,源头其实是性质标注的缺失。
跨团队共享则要先对齐定义。同一个词在不同团队里含义可能完全不同,边界之争常常源于术语不清,而非立场对立。共享前先统一关键概念,能省下大量返工,也能减少无谓的摩擦。
当团队需要长期共享某类信息时,建议把规则显性化,写进协作约定:哪些内容可直接转述,哪些需要事先确认,哪些永不外传。规则一旦公开,判断就有了共同基准,个人也就不必独自承担猜测的压力。
显性规则还有一个好处:它把边界从「靠个人记性」变成「靠共同约定」。新人加入时,不必靠试错去摸索什么能说、什么不能说,融入成本大幅下降。清晰的规则,本身就是一种对成员的善意。
边界被突破时:修复信任的动作顺序
再谨慎的团队也会有越界。真正决定关系走向的,不是越界本身,而是越界之后的处理顺序。第一时间否认或辩解,几乎必然加重伤害;而有章法的修复,往往能让关系比从前更稳。
第一步是确认事实:到底哪句话被带出、带给了谁、造成了什么影响。把事实与感受分开,避免在情绪里争论对错。先对齐「发生了什么」,再谈「我们怎么处理」,顺序不能颠倒。
第二步是承担责任。有效的道歉要具体——指出越界的具体行为,而不是笼统地说「如果让你不舒服我很抱歉」。具体的承认,才有可信的修复;含糊的措辞,反而暗示着推脱。
第三步是约定改进。比起「我以后会注意」,更有效的是给出可执行的机制,例如「涉及你的内容,我转述前一定先问」。把承诺变成动作,信任才有重建的抓手,而不是又一句空头保证。
最后一步是给时间。信任的恢复往往慢于它的破裂,急于让对方「翻篇」,本身就是又一次不尊重边界。允许情绪存在、允许对方观望,反而能更快走向真正的修复。
度量与工具:让共享范围可被看见
边界管理要落地,同样需要被度量。无法被看见的规则,最终都会退化成口号。团队可以从几组轻量指标入手,用趋势而非精度来指导改进。
第一组是合规类指标:转述合规率与去标识率,反映规则被执行的程度。它们可以通过定期抽查共享记录来估算,不必追求精确,量级正确的方向就足够指导调整。这类指标回答的是「我们有没有按约定做」。
第二组是健康类指标:一对一的主动表达次数与边界争议数。前者上升说明安全感在改善;后者先升后降,说明意识先觉醒、规则后内化。两个数字要放在一起看,才不会误判。
第三组是修复类指标:越界事件数与其后的修复时长。修复时长的下降,通常比越界数量的下降更早出现,是团队信任韧性的先行信号。一个能快速修复的关系网络,比一个从不犯错的关系网络更现实、也更牢固。
工具上,原则仍然是够用即可。会议模板里加一栏「共享档位」,协作空间里设一个「仅限当事人」的标签,就能覆盖大多数场景。工具承载规则,纪律决定效果——没有约定,再好的工具也只是摆设。
说到底,谈话保密边界的本质,是让人们在知道「话会被如何对待」之后,敢于说真话。当共享范围被清晰约定,沟通不是被限制,而是被解放。清楚自己站在边界之内的人,才有底气把话说透。这也是云上有品一直强调的协同理念:清楚的边界,正是信任的前提。
常见问题
1.问:把所有内容都设为保密,是不是最安全?答:不是。过度保密会让信息无法流动,团队会因缺乏共享而重复犯错。边界的目的是让该共享的顺畅共享、该保护的严格保护,而不是把所有内容一律锁死。
2.问:转述时只要不点名,就算合规吗?答:不一定。如果描述里保留了独一无二的细节,听者仍能反推出是谁,这就是「伪匿名」。合规的去标识要求站在接收方角度检验:仅凭这些信息,他能不能定位到具体的人。
3.问:一对一里说的话,当事人反对外传,但内容涉及团队风险,怎么办?答:应先向当事人说明「这条可能无法完全保密」,并尽量用去标识的方式共享风险本身,而不是共享发言者的身份。透明的事前沟通,远比事后的解释更能保住信任。
4.问:新人总是拿不准共享范围,有没有快速上手的办法?答:给他们一个可执行的默认规则:拿不准时按更严的档位处理,转述前先问一句「我能不能引用」。规则越简单,越容易被记住和执行,边界意识也更容易内化。
5.问:团队从不发生越界,是不是说明边界管理已经到位?答:未必。也有可能是成员因为不信任而根本不开口。比起越界事件的数量,一对一的主动表达次数更能反映边界是否真正健康,沉默往往比说错话更值得警惕。
图片来源:图1 pen_ash / Pixabay (CC0) · 图2 dragh / Pixabay (CC0) · 图3 pen_ash / Pixabay (CC0) · 图4 TerriAnneAllen / Pixabay (CC0) · 图5 jaksco / Pixabay (CC0) · 图6 Ahep317 / Pixabay (CC0) · 图7 AS_Photography / Pixabay (CC0) · 图8 deanmarston432 / Pixabay (CC0) · 图9 viarami / Pixabay (CC0) · 图10 JerzyGórecki / Pixabay (CC0) · 图11 congerdesign / Pixabay (CC0) · 图12 paulsteuber / Pixabay (CC0) · 图13 TheOtherKev / Pixabay (CC0) · 图14 eduardovieiraphoto / Pixabay (CC0) · 图15 Kaffeesüchtig / Pixabay (CC0) · 图16 hbieser / Pixabay (CC0) · 图17 modernseoul / Pixabay (CC0) · 图18 theharpreetbatish / Pixabay (CC0) · 图19 Alexas_Fotos / Pixabay (CC0) · 图20 Daniel_Nebreda / Pixabay (CC0) · 图21 garten-gg / Pixabay (CC0) · 图22 garten-gg / Pixabay (CC0) · 图23 garten-gg / Pixabay (CC0) · 图24 susan-lu4esm / Pixabay (CC0) · 图25 geralt / Pixabay (CC0) · 图26 muhammedweb / Pixabay (CC0) · 图27 muhammedweb / Pixabay (CC0) · 图28 Pexels / Pixabay (CC0) · 图29 Pexels / Pixabay (CC0) · 图30 29277261 / Pixabay (CC0) · 图31 Hans / Pixabay (CC0) · 图32 Pexels / Pixabay (CC0) · 图33 blickpixel / Pixabay (CC0) · 图34 Pexels / Pixabay (CC0) · 图35 blickpixel / Pixabay (CC0) · 图36 blickpixel / Pixabay (CC0) · 图37 MiraCosic / Pixabay (CC0) · 图38 Dimhou / Pixabay (CC0) · 图39 MiraCosic / Pixabay (CC0) · 图40 focusonpc / Pixabay (CC0)
本文为信息分享与方法论科普,不构成任何专业建议,请结合自身情况判断。
本文由 AI 生成,经人类主编终审。
评论(0)