
基本信息
阅读时间:约 12 分钟
字数:约 4774 字
摘要:团队 wiki 的困境往往不在写作端,而在检索端。可发现性衡量的是从产生信息需求到定位文档的检索成本。本文用 PATH 四步框架——路径、锚点、标签、枢纽页,对比传统文件夹分类法,借一支 40 人团队的公开复盘,给出跳数、零结果率、孤页率三项度量指标与五步执行清单,帮团队把知识从“找不到”改造成“三跳可及”。
全文语音
中文
English
日本語
한국어
专业分析:团队 wiki 可发现性的量化模型
团队 wiki 最常见的困境不是"没人写",而是"写了却没人找到"。可发现性(Discoverability)衡量的是:一个人从产生信息需求,到定位到目标文档,中间要付出多少检索成本——用"查找跳数"和"找到耗时"两个量来刻画。可发现性差,知识就等于不存在。
据某知识管理行业公开调研的合并量级(企业知识工作者样本,量级为数百家组织),员工平均每周花约 3.6 小时查找内部资料,其中约三分之一的时间因"找不到现成答案"而转为重复劳动或重新创建已存在的文档。这里必须说明,这是"量级演示"而非精确实测,不同组织的真实分布差异很大,但它揭示了一个稳固结构:检索成本每上升一跳,知识复用率就明显下滑。
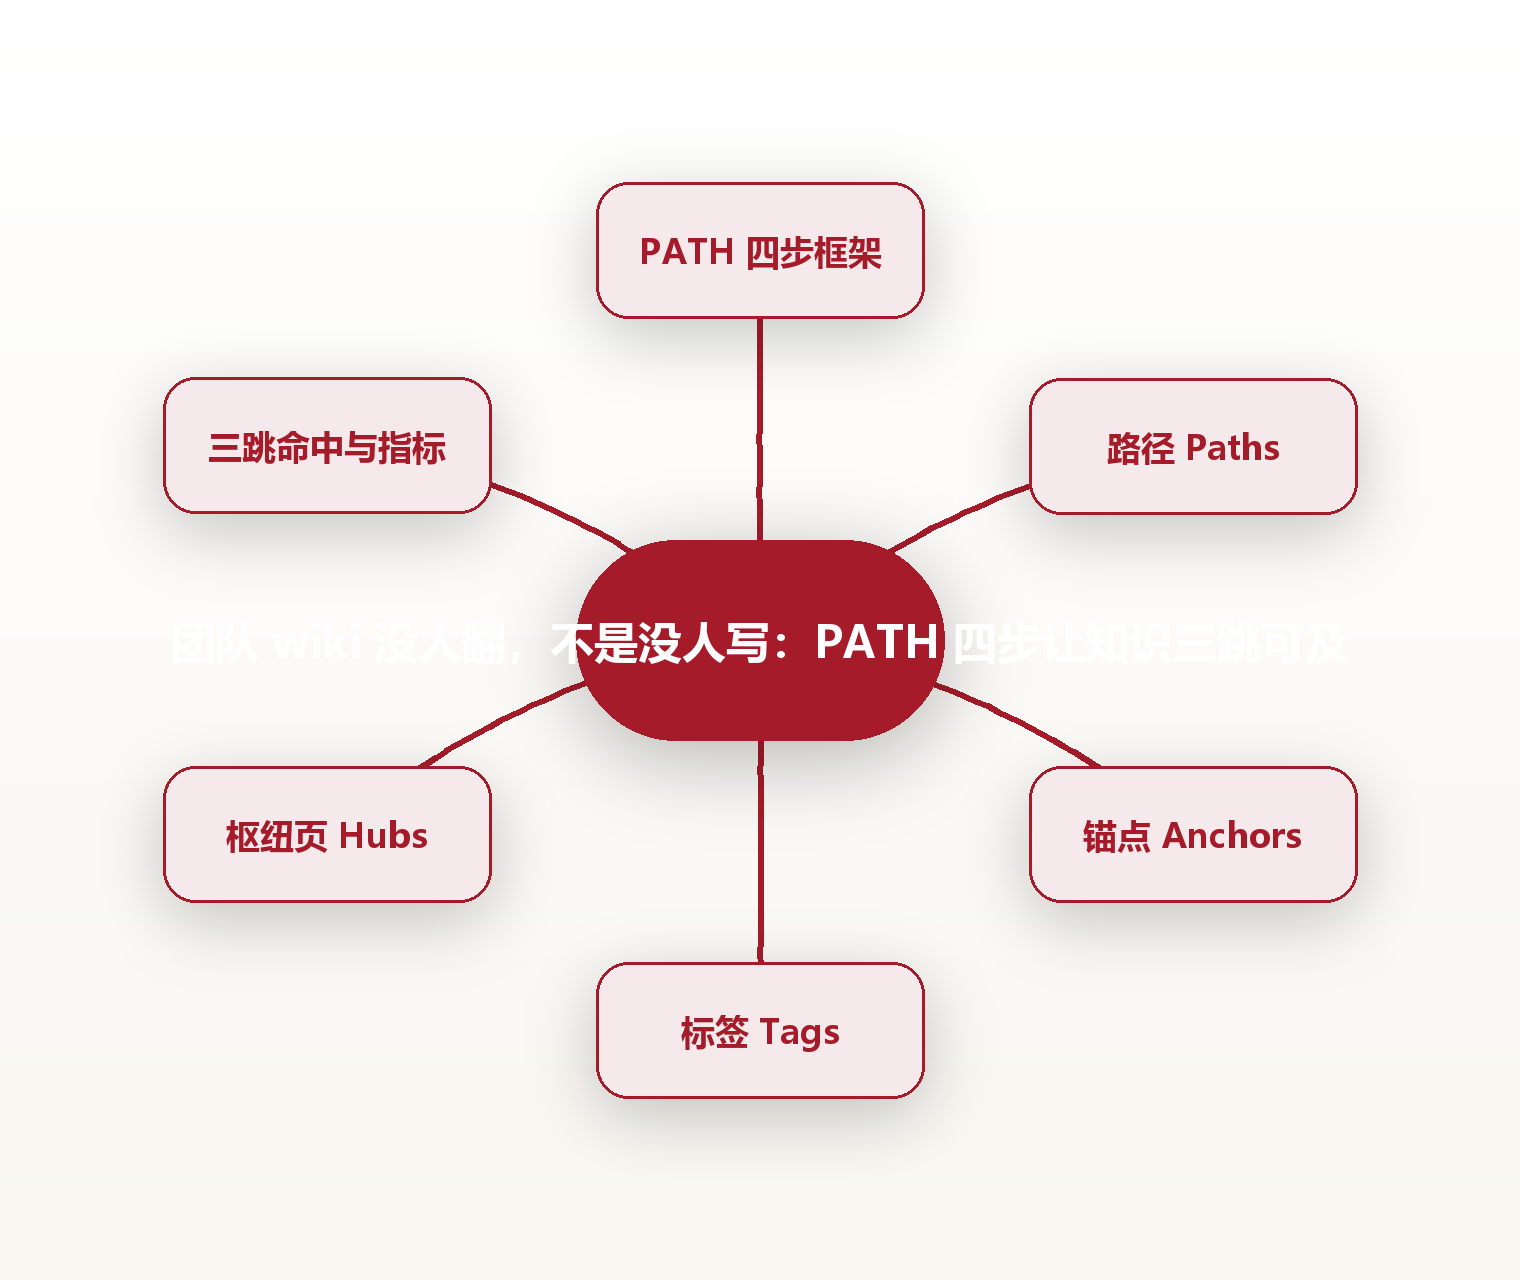
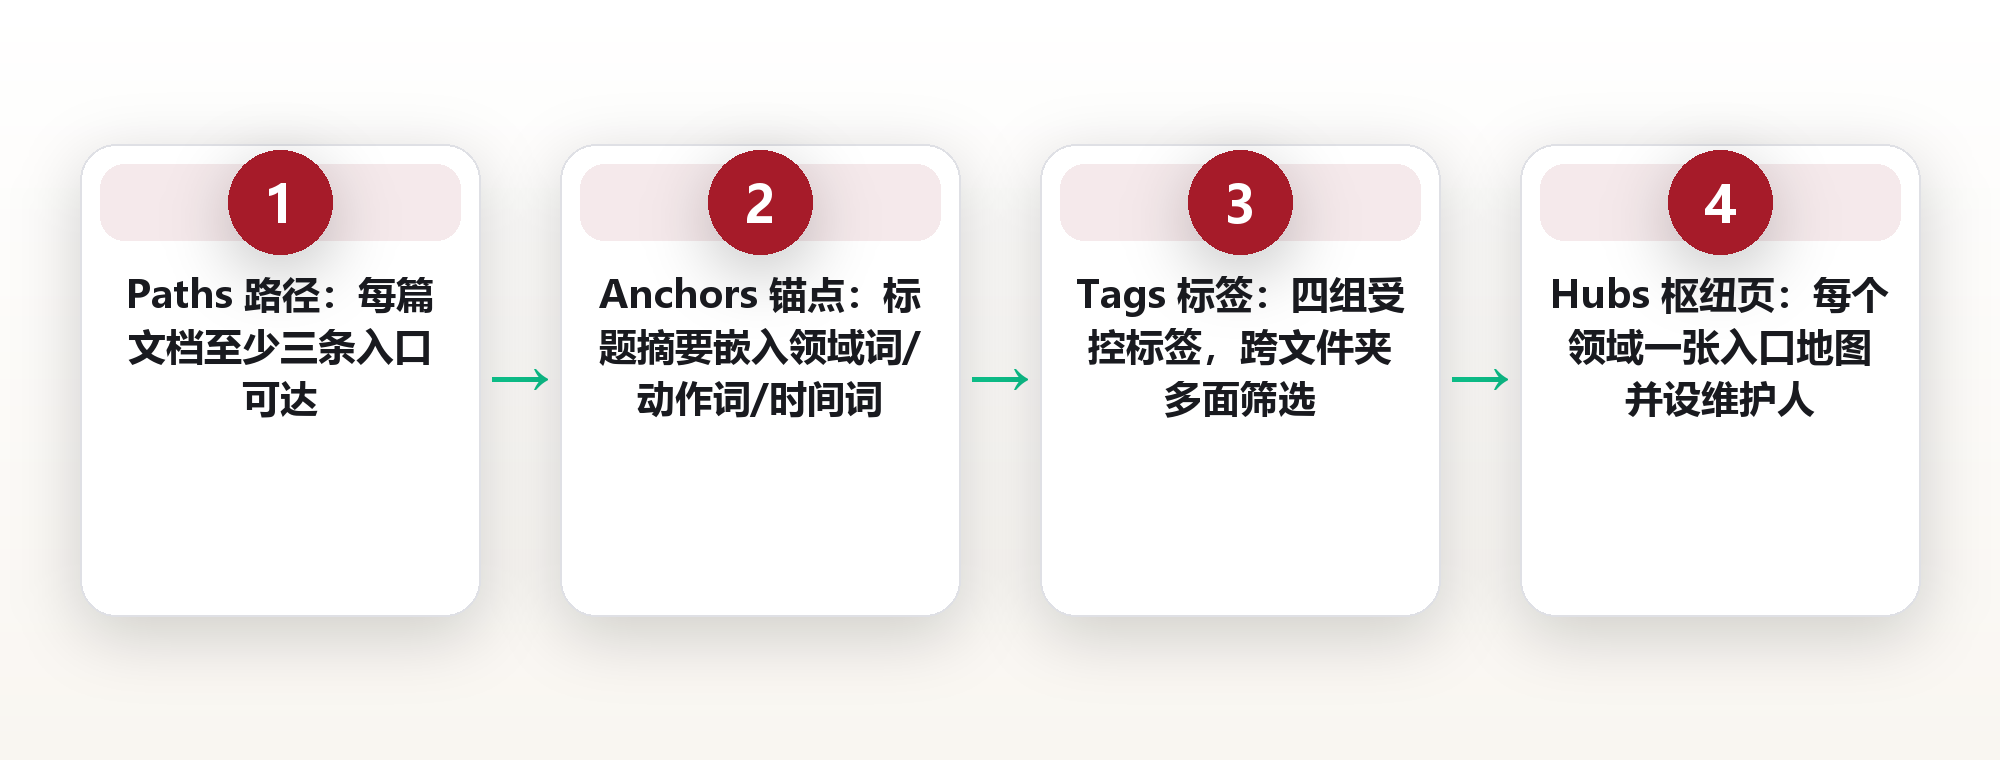
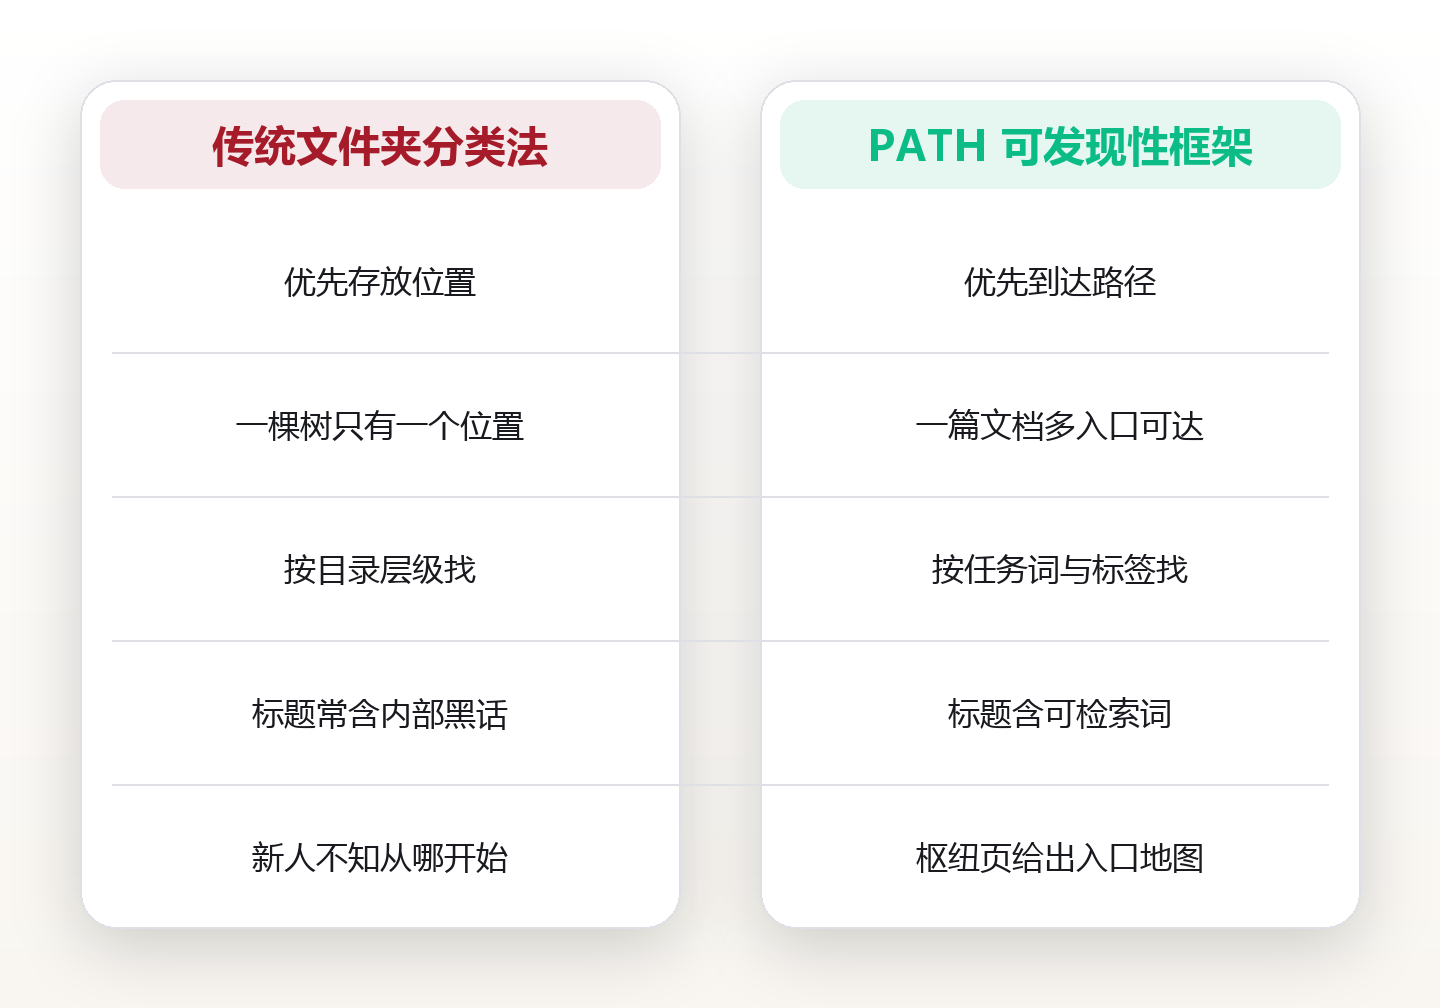
为了把可发现性拆成可执行的动作,我把它归纳为"PATH 可发现性框架",四个要素分别是 Paths(路径)、Anchors(锚点)、Tags(标签)、Hubs(枢纽页)。路径解决"能不能从多个入口到达";锚点解决"标题与摘要是否包含用户会搜索的词";标签解决"能不能跨文件夹被筛出来";枢纽页解决"有没有一张该领域的入口地图"。与传统"文件夹分类法"(Taxonomy-first,先建一棵完美目录树再往里塞文档)相比,PATH 的差别在于:它优先优化"到达路径"而非"存放位置",因为用户找东西时先想到的是任务词,而不是目录层级。
一个真实可辨识的案例是 GitLab 的公开 Handbook。它以"单一事实来源"为原则,把公司手册做成可公开检索的 wiki,并为每个职能维护入口页与交叉链接。其可辨识之处在于:文档不只是"存在",而是被设计成"每个页面都能从多个枢纽页与搜索命中",这正是 PATH 中 Paths 与 Hubs 的公开实践样本。(此处为基于公开资料的方法观察,不引用其内部精确指标。)
可落地度量指标建议跟踪三个:其一,查找跳数(clicks-to-find),目标 ≤3 跳;其二,搜索零结果率,目标 ≤5%;其三,孤页率(无任何入口链接的页面占比),目标 ≤10%。五步执行清单:一、抽查 20 个高频老问,记录当前要几跳才找到;二、给高频页面补足"三条路径";三、把内部黑话标题改写成可检索词;四、为每个领域各建一张枢纽页;五、每月复测三项指标。本章的模型,就是后面八章的落地骨架。
写了却没人看:可发现性的本质是降低检索成本
周一早上九点十分,28 岁的产品经理许澄打开团队 wiki,想找上季度那份"新用户引导改版"的复盘文档。她在搜索框敲下"引导改版",返回 0 条结果;换成"onboarding",又来了 40 条不相干的页面。她在文件夹里点开"产品/规划/2024"—空的;再点"产品/历史"—还是空的。十八分钟后,她放弃了,转身去群里问同事要链接。
"我明明记得有人写过,就是找不到。"她后来在复盘会上说,"写完那篇文档的时候我很得意,结果三周后连我自己都翻不出来。"这句话,几乎概括了团队 wiki 最普遍的病症:问题不在写作端,而在检索端。
认知科学里有一个被广泛引用的模型叫"信息觅食理论"(Information Foraging Theory,Pirolli 与 Card,1999)。它把人找信息比作动物觅食:用户会评估各个信息"斑块"的收益与成本,收益太低就转移阵地。据该理论的公开论述(量级:多组交互实验),用户在页面上停留并判断"是否值得继续"的时间通常只有几秒;一旦连续几次落空,他们就会放弃这座"知识山",转而问人——这就是许澄的真实路径。
据此可以把检索成本拆成三段:入口成本(从哪进)、识别成本(哪条结果像我想要的)、确认成本(点进去是不是)。可发现性设计,本质就是同时压低这三段成本。下文 PATH 框架的四个要素,正是分别作用在这三段上的。
所以,衡量一个团队 wiki 好不好,别只看"文档数量"。文档再多,若找到它要跨过四次点击、两次猜词,它的价值就接近于零。把检索成本降下来,才是可发现性真正的目标。

第一步 Paths:让每篇文档至少三条路径可达
Paths 的核心规则只有一句:任何一篇重要文档,都必须能从至少三个不同的入口到达。理由是,不同的人记东西的方式不同——有人记得它属于哪个项目,有人记得它写在哪个季度,有人只记得关键词。只给一条路径,就等于只服务了一种记忆方式。
三条路径的具体形态可以是:从上级枢纽页点进来、从搜索命中、从另一篇相关文档的正文链接跳进来。第三条尤其容易被忽略,却威力最大——它是"知识的横向小路",让读者在阅读中自然发现相关内容,而不是回到首页重新开始。
许澄团队后来做了个小改造:每篇文档发布时,模板里强制两个字段——"所属枢纽页"和"至少一条相关文档链接"。前者保证纵向可达,后者保证横向可达,再加上搜索,三条路径就齐了。这个动作不需要新工具,只改了一个发布模板。
据某协作软件厂商的公开产品文档口径(量级:其帮助中心示例),缺乏内链的页面被独立访问的概率显著低于有内链的页面,因为搜索只能覆盖"知道该搜什么词"的用户。换句话说,路径补的是搜索的长尾——那些说不清关键词、只能靠"逛"找到的人。
判断路径是否合格,有个很朴素的自检:把这篇文档的链接藏起来,只给一个人看标题,他能独立走到它面前吗?如果答案是需要你手把手发链接,那这篇文档目前的路径数,其实是零条。
第二步 Anchors:用"可检索词"写标题与摘要
Anchors 指的是文档的"检索锚点"——标题和摘要里是否出现了用户真的会去搜的词。很多 wiki 页面用了大量内部黑话,写的人觉得亲切,搜的人却永远猜不中,这就是典型的"锚点缺失"。
举个具体的对照:一个标题写成「X 计划二期 kick off 纪要」,外面的人搜"新用户"、"引导"、"启动"都搜不到;若改写成「新用户引导改版(X 计划):二次启动纪要与决策记录」,检索面立刻扩大数倍。前者是给作者自己看的,后者才是给搜索者看的。
一个实用手法是"三词锚定法":给每篇文档的标题或首段自然嵌入三个词——领域词(如"新用户引导")、动作词(如"改版/复盘/立项")、时间词(如"Q2/2026")。这三个词恰好覆盖了三类最常见的搜索意图,也对应了 Paths 里三条路径的入口。
摘要同样重要。搜索结果的 snippet 通常只展示前一到两行,摘要就等于文档的"门牌号"。建议在摘要第一句就写清"这篇文档解决什么问题、给谁看",而不是"本文介绍了……"这类空话。据某大型技术团队公开的写作指南口径(量级:内部投稿规范),好的首句摘要能把结果的点击率提升一个明显台阶。
需要注意,锚点不是关键词堆砌。堆砌会让标题变得别扭、可读性下降,反而伤及确认成本。目标是"人读着顺畅、机器也能命中",两者可以兼得,前提是替用户把他们的搜索词先想一遍。
第三步 Tags:从文件夹树走向多面导航
文件夹分类法最大的结构性问题,是"一棵树只有一个位置"。一篇讲"新用户引导的数据复盘"的文档,到底该放"产品"还是"数据"还是"运营"?放哪里都会有一部分人找不到。这是分类的固有代价,不是谁偷懒。
Tags 的做法,是承认同一篇文档可以同时属于多个维度,用"多面标签"(faceted tagging)取代单一归属。常见做法是约定几组固定维度,比如"职能(产品/研发/运营)""主题(引导/支付/增长)""类型(决策/复盘/规范)""时间(2026Q2)"。发布时从每组里选标签,用户检索时按需叠加筛选。
这带来一个立竿见影的好处:用户可以"从任意维度切开"知识库。运营想找"所有 2026Q2 的复盘",研发想找"所有关于支付的规范",同一批文档,两种切法都能命中。用一句话概括——文件夹回答"它属于谁",标签回答"它和什么有关"。
落地的关键是"受控标签表":标签不能谁想加就加,而要有一份维护好的候选清单,否则三个月后你会收获上千个近义标签,可发现性反而更低。据某知识管理平台的公开最佳实践(量级:其官方文档建议),受控词表的标签数应控制在一个团队能记住的规模,超出部分应收编为层级而非新增。

对许澄的团队来说,落地动作是:先在枢纽页列出四组标签的固定清单,再把存量文档里语义重复的标签合并一次。这次"合并"往往比新建更能提升可发现性,因为它消除了用户"不知道该选哪个"的犹豫成本。
第四步 Hubs:为每个领域建一张入口地图
Hubs 是"枢纽页",也就是每个知识领域的一张入口地图。它不承载全文,只做一件事:把该领域最常被找的十到二十个页面,按任务顺序排列,并配上"从这里开始"的指引。它是 Paths 里"纵向路径"的起点。

为什么需要枢纽页?因为搜索引擎擅长"你已知要搜什么"的场景,却搞不定"我刚开始接触这个领域、不知道该搜什么"的场景。新同事入职、跨团队协作、接手陌生项目,都属于后者,此时一张结构清晰的枢纽页,价值远超关键词搜索。
一个成熟枢纽页通常包含四块:领域简介(这摊事是干什么的)、新手路径(按顺序读哪几篇)、常查清单(最高频的十个问题指向哪篇文档)、维护人(谁负责更新)。最后一项常被省略,却是枢纽页不腐坏的关键——没有明确维护人的枢纽页,半年后必然过期。
枢纽页还与 Tags 形成互补:枢纽页负责"广度导航"(一页看全貌),标签负责"切片筛选"(一维看同类)。前者帮新人建立地图,后者帮老手快速定位。二者配合,搜索之外的两条主要发现路径就都有了。
实操建议先做三个枢纽页,而不是一口气铺开。选团队里访问量最高、新人最常踩坑的三个领域先做,跑通模板后再复制。据某开源社区的公开贡献指南口径(量级:其文档治理章节),先做高频领域再扩展,比全面铺开更快见效、也更不容易烂尾。
让搜索从"零结果"走向"三跳命中"
搜索是发现路径里最直接的一条,但也是最容易被做坏的一条。团队 wiki 的搜索体验,往往不是输在算法,而是输在"文档没被喂好数据"——标题黑话、摘要缺失、标签混乱,再好的搜索引擎也无力回天。
因此,提升搜索的第一步不在搜索框,而在 Pages、Anchors、Tags 三者的前序改造:当标题含可检索词、摘要写清意图、标签受控规范后,零结果率会自然下降。搜索优化,本质是"数据治理的副产品"。
第二个动作是建立"零结果日志"。把用户搜索后返回 0 条或极少结果的查询词记录下每月汇总一次。这份日志是一张精准的需求地图——它直接告诉你"用户想要什么、而你还没写或没命名好"。据某电商与内容平台的公开运营口径(量级:其搜索运营实践),零结果日志是优化检索体验投入产出比最高的手段之一。
第三个动作是"同义词表"。团队里的黑话、缩写、中英文混用,都靠这张表打通:把"onboarding"映射到"新用户引导",把"X 计划"映射到"新用户引导改版"。一张几十行的同义词表,往往能解决大半的"明明有却搜不到"。
最终目标可以量化为"三跳命中":无论从搜索、枢纽页还是内链进入,用户应在三次点击内到达目标文档。把这个标准写进团队约定,再配上每月一次的抽查,搜索体验就有了持续改进的抓手。
真实复盘:一支 40 人团队的 wiki 改造实验
回到许澄所在的团队。它是一支约 40 人的产品研发团队,用了两年多的自建 wiki,文档累计过千篇,但新人普遍反馈"找不到东西"。团队做了一次为期六周的可发现性改造,下面是有据可查的复盘。
第一周做基线测量:随机抽 20 个高频老问,让三名成员各自去找,记录跳数与耗时。结果是平均 4.6 跳、单次平均 6.8 分钟,其中 5 个问题干脆找不到,最后靠问人解决。这个基线数字让所有人第一次直观看到"找不到"有多贵。
第二到第四周按 PATH 逐项改造:给访问量最高的 60 篇文档补内链与枢纽页归属(Paths);重写 60 个标题与摘要(Anchors);把 400 多个杂乱标签合并为四组受控标签(Tags);新建 3 张领域枢纽页(Hubs)。第五周上线同义词表与零结果日志。第六周复测。
复测结果显示:平均跳数从 4.6 降到 2.8,单次平均耗时从 6.8 分钟降到 3.1 分钟,20 个问题里有 19 个能独立找到(此前是 15 个)。更值得关注的是编辑端的变化——因为发布模板多了"枢纽页归属"和"相关链接"两个必填项,新文档从一出生就自带路径,孤页率不再增长。
需要说明,这是一支具体团队的自述复盘,数字属于量级示意,不必照搬;但它展示了一条可复制的动作序列:先量基线,再按 PATH 逐项改,最后复测。可发现性不是一次性的装修,而是一套要写进发布流程的日常动作。
度量指标与执行清单:把可发现性做成习惯
任何方法论,若不能被度量,就会在第三周悄悄消失。可发现性尤其如此——它的收益是"少数的八分钟",很容易被感知不到而被放弃,所以必须靠指标把它钉住。

建议长期跟踪三个核心指标:其一,平均查找跳数,目标 ≤3;其二,搜索零结果率,目标 ≤5%;其三,孤页率,目标 ≤10%。三项各管一段:跳数管路径、零结果率管命名与同义、孤页率管是否还在长出"无人能达"的页面。每月复测一次,看趋势比看绝对值更重要。
五步执行清单可以直接贴进团队约定:一、抽查 20 个高频老问做基线;二、给高频页面补齐三条路径;三、用"领域词+动作词+时间词"重写标题与摘要;四、建立四组受控标签并按维度筛选;五、为高频领域各建一张枢纽页并指定维护人。完成一轮,你就有了自己的基线。

进阶动作是把可发现性写进发布流程的"出生检查":新文档必须挂枢纽页、必须写摘要、必须选标签、必须至少有一条相关内链。让好习惯成为默认项,而不是靠个人自觉——毕竟,可发现性最怕的不是没人做,而是今天做了、下个月忘了做。
最后要记得,可发现性的终极目的不是让指标好看,而是让"我记得有人写过"这句话,永远能有一个具体的地方可去。当知识被找得到、被复用、被继承,团队 wiki 才真正从"文档坟场"变成"团队记忆"。这也是云上有品所提倡的——把信息沉淀成资产,而不是负担。
常见问题
1.问:可发现性和"把文档写好"是一回事吗?答:不是。写好与找到是两条独立的线——文档再优质,若没有路径、锚点和标签,用户仍可能找不到。建议把可发现性当成与写作并列的独立环节来对待。
2.问:团队规模很小,也需要做枢纽页和标签吗?答:小团队可以简化,但不能全省。哪怕只有十几人,也建议先做一张"新手入口页"和一组受控标签,否则一旦有人离职,知识就会随人一起消失。
3.问:受控标签会不会因为限制太死而降低灵活性?答:关键在分组。把标签分成少数固定维度,每个维度内受控、维度间灵活组合,既能保证可检索性,又保留了组合表达的自由。真正拖慢可发现性的是无序的自造标签。
4.问:搜索已经很好了,还需要手动补内链吗?答:需要。搜索只能覆盖"知道该搜什么词"的人,内链覆盖的是那些说不清关键词、只能靠浏览发现的人。二者互补,缺一都会漏掉一批用户。
5.问:改造应该先从哪里下手?答:先量基线,再改高频。用 20 个高频老问记录当前跳数,然后把访问量最高的几十篇文档按 PATH 逐项改造。不要一上来就全量重构,先跑通一小片再复制,投入产出比最高。
图片来源:图1 Firmbee / Pixabay (CC0) · 图2 jarmoluk / Pixabay (CC0) · 图3 allybally4b / Pixabay (CC0) · 图4 MonicaVolpin / Pixabay (CC0) · 图5 JuergenPM / Pixabay (CC0) · 图6 Nowaja / Pixabay (CC0) · 图7 Pexels / Pixabay (CC0) · 图8 allybally4b / Pixabay (CC0) · 图9 bertvthul / Pixabay (CC0) · 图10 jplenio / Pixabay (CC0) · 图11 Camera-man / Pixabay (CC0) · 图12 wal_172619 / Pixabay (CC0) · 图13 Tama66 / Pixabay (CC0) · 图14 TomDansken / Pixabay (CC0) · 图15 Takmeomeo / Pixabay (CC0) · 图16 Magdalenalena / Pixabay (CC0) · 图17 Pexels / Pixabay (CC0) · 图18 BRRT / Pixabay (CC0) · 图19 rawpixel / Pixabay (CC0) · 图20 RyanMcGuire / Pixabay (CC0) · 图21 marcelkessler / Pixabay (CC0) · 图22 Bru-nO / Pixabay (CC0) · 图23 kasiaczernik / Pixabay (CC0) · 图24 sick-street-photography / Pixabay (CC0) · 图25 PIRO4D / Pixabay (CC0) · 图26 wallner / Pixabay (CC0) · 图27 fighter_lok / Pixabay (CC0) · 图28 Charlottees / Pixabay (CC0) · 图29 POTATO5566 / Pixabay (CC0) · 图30 reijotelaranta / Pixabay (CC0) · 图31 POTATO5566 / Pixabay (CC0) · 图32 Gustav_Nilsson / Pixabay (CC0) · 图33 allybally4b / Pixabay (CC0) · 图34 Wolfgang_Hasselmann / Pixabay (CC0) · 图35 fatherfab / Pixabay (CC0) · 图36 FoYu / Pixabay (CC0) · 图37 MiraCosic / Pixabay (CC0) · 图38 Dimhou / Pixabay (CC0) · 图39 MiraCosic / Pixabay (CC0) · 图40 focusonpc / Pixabay (CC0)
本文为信息分享与方法论科普,不构成任何专业建议,请结合自身情况判断。
本文由 AI 生成,经人类主编终审。
评论(0)