
基本信息
阅读时间:约 13 分钟
字数:约 5163 字
摘要:多数人评估概率时只盯着眼前的这一件,却跳过了它所属那一整类的历史频率。基础比率就是被跳过的那层底座。本文用一个二战弹孔案例、一道医学检测错题,提出 BASE-4 校准框架,给出先验与似然比的更新方法、三类塌陷点、三个校准度量和一页纸落地清单,帮你把「感觉」换成「分母」。
全文语音
中文
English
日本語
한국어
专业分析:先站回「这类事」里,再谈「这一件」
我们评估一件事的概率时,几乎本能地在问「这件事本身会不会成」,却极少先问「属于它的那一整个类别,历史上成或不成各占多大比例」。后者就是基础比率(base rate)。它指的是一个参照类在长期里呈现的总体频率——不是你的这一件,而是成千上万个「同一类」样本累加出来的先验底色。跳过它,等于把手里最厚、也最便宜的那一层信息直接扔掉,剩下的判断只能靠直觉和故事撑场面。
先给量级。据认知心理学领域的公开研究口径(Kahneman 与 Tversky 自一九七三年起的系列实验),当描述性信息与基础比率同时出现时,多数被试会把决策几乎完全押在具体描述上,对基础比率的权重逼近于零;在部分设定下,即使明确告知基础比率,也只有约一成到三成的被试会显著向它回归。这不是智力问题,而是默认的思维出厂设置:大脑偏爱生动的个案,回避枯燥的频率。
一个真实可辨识的案例来自二战。统计研究小组的 Abraham Wald 受命分析返航战机的弹孔分布。数据清楚显示机翼弹孔密集、发动机弹孔稀少,军方据此提议加固机翼。Wald 指出:能被观察到的只是「活着飞回来」的飞机,发动机中弹的飞机根本没飞回来,真正的薄弱点恰恰在弹孔最少的部位。这是典型的幸存者偏差,而它的本质正是基础比率缺失——被观察样本只代表「幸存」这个子类,而不是全部「参战」的参照类。
第二个案例更直接指向基础比率。一九七八年《新英格兰医学杂志》刊登了 Casscells、Schoenberger 与 Gray 的一项调查:他们问一群医生,「某疾病患病率为千分之一,检测假阳性率为百分之五,若某人检测结果为阳性,他真患病的概率是多少?」约百分之九十五的医生回答「约百分之九十五」,而按基础比率推算,正确答案约百分之二。原因并不复杂:在十万人里,约一百人真患病、约五千人假阳性,阳性结果里真患病的只占极小一小块。医生并非不专业,只是被「阳性」这个具体信号牵着走,绕过了患病率这个先验底座。
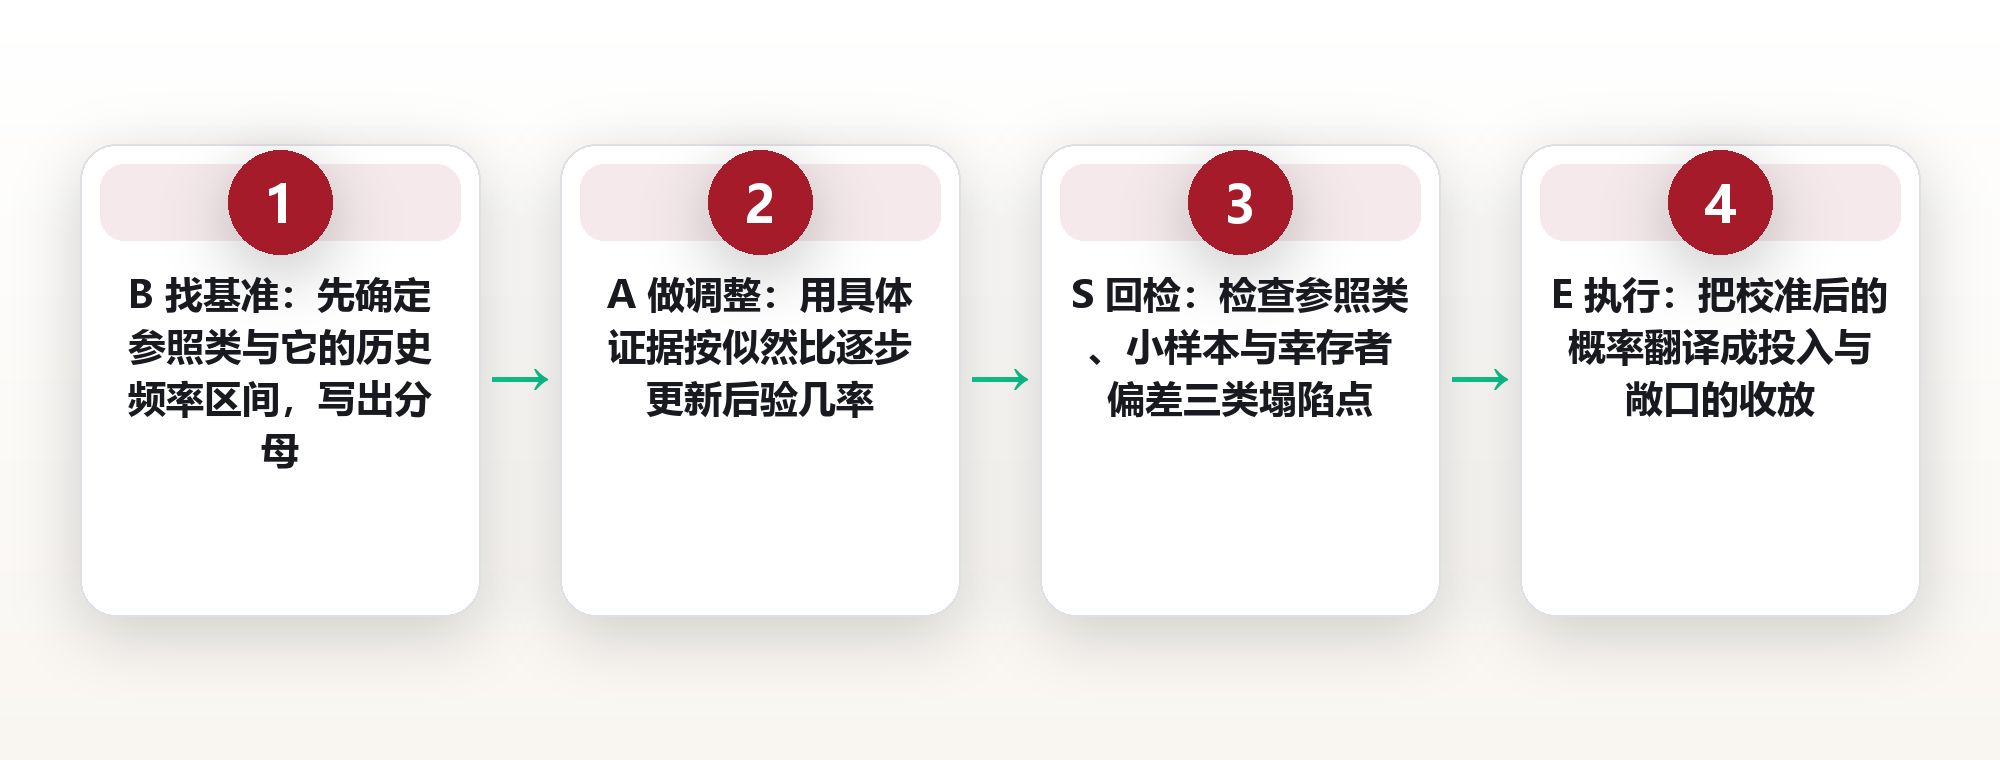
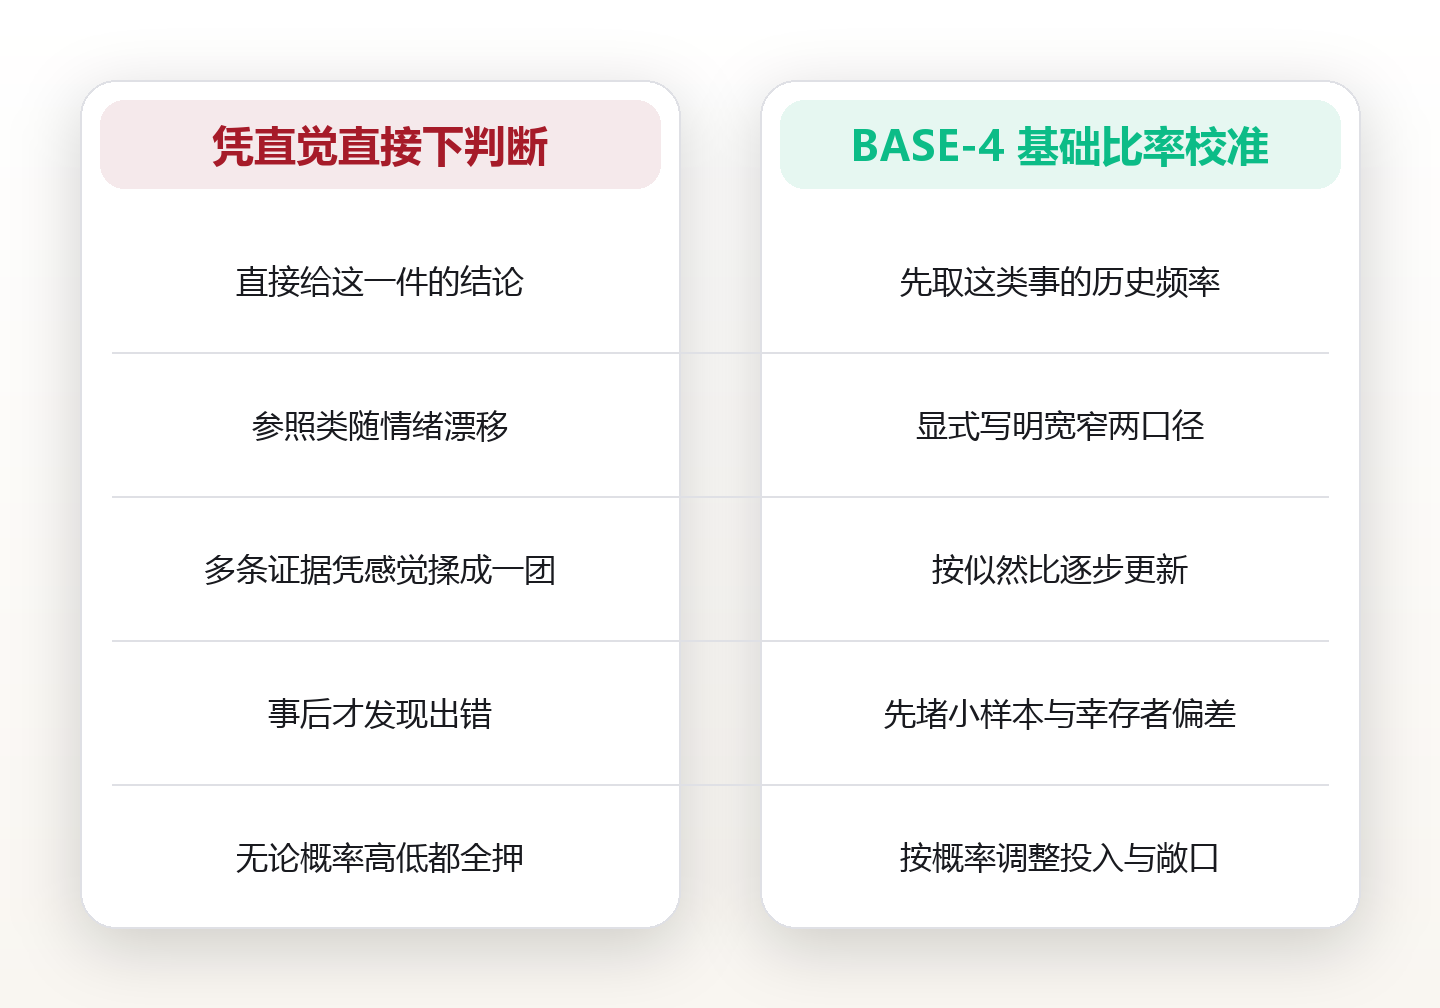
这两类案例指向同一个机制:忽略基础比率,会把概率判断放大到失真。为此我提炼一套命名框架 BASE-4,把被跳过的这一步重新装回决策流程。四个动作分别是:B 找基准(Baseline)——先确定参照类与它的历史频率;A 做调整(Adjust)——再用你手里的具体证据按似然比上下修正;S 回检(Sanity)——检查参照类是否选错、样本是否太小、是否被幸存者偏差污染;E 执行(Execute)——把校准后的概率写进决策与投入比例,而不是只停留在感觉上。它和「凭直觉直接给结论」的差别,是本章要对比的核心。
落地时,我会盯三个度量指标。第一是基础比率偏差比:你的初始估计除以参照类历史频率,理想值应逐步逼近一,长期偏离超过三倍就说明先验权重过低。第二是校准分:把你做过的所有概率判断按区间分桶,看每个桶里真实发生的比例是否落在区间内,比如你标「七成把握」的事,真的兑现约七成,校准才算合格。第三是命中率与惩罚分:只看命中率会被极端押注骗过,配合对数或布里尔类的惩罚分,才能识别「经常喊极致但常错」的虚高。执行清单则固定在五步:写下判断前先写参照类;查一个历史频率区间;用似然比修正;记录校准;每季度按结果换挡,而不是按情绪换挡。
基础比率是一块怎样的信息
基础比率之所以重要,是因为它提供的是一种「锚」的替代品。人一旦没有客观基准,就会把最近看到、最容易想起的样本当作默认值,这正是可得性偏差的入口。而基础比率来自大样本、长时间、可复核的统计汇总,它天然抵抗单个故事的引力。你不需要相信它也成立,你只需要承认它是当前最省成本的起点。
它有两个基本构件。其一是参照类,也就是「这件事属于哪一类」。同一个人在「创业能否三年存活」上,参照类可以是全行业新设企业,也可以是同城同类门店,还可以是同一细分赛道里拿到首轮融资的公司——参照类不同,基础比率可以相差数倍。其二是频率口径,也就是这个比例是年度存活率、是五年存活率,还是到某个里程碑的转化率。口径不写清,数字就没有意义。
基础比率还分两类:一类是通用的、几乎人人都适用的底色,比如「多数人的年度投资收益会显著低于自己的预期」;另一类是与你的情境更贴近的局部基础比率,比如同一城市、同一品类、同一资金规模下的实际分布。好的判断先取通用底色,再用局部比率替换或叠加,而不是一上来就用最乐观的那个子类安慰自己。
需要提醒的是,基础比率不是宿命。它描述的是「在不掌握额外信息时,最合理的起点」,而不是「你必然如此」。有了它,你的每一次个体证据才有比较对象;没有它,你的证据再多也只是一个孤立的点,无法拼成一张概率地图。这也是为什么专业判断常常看起来很「冷」——它先把人放回人群里,再谈个体差异。
为什么大脑会自动跳过它
大脑偏爱故事,而基础比率是反故事的。一个鲜活案例能瞬间点燃情绪,而「百分之四十的存活率」既没有面孔也没有情节,激活不了同样的注意力。在信息处理层面,具体信息更容易被编码和提取,抽象频率则容易被忽略,于是默认路径就是用个案代替总体。
第二重原因是表达方式。比率如果只写成百分比,很容易被当成背景噪音;如果换成自然频率,比如「一千个人里有一百个」,理解度会明显提升。研究发现,把概率改写为「每多少人里有多少人」的形式,能显著降低错误率。可见跳过基础比率,很多时候不是不理性,而是信息没被翻译成大脑好消化的格式。
第三重原因是动机。当我们想要某个结果时,会本能地寻找支持它的证据,而基础比率往往是冷水。于是有人会主动缩小参照类,直到找到一个「乐观的子类」,用少数成功者的比例替代整体比例。这不是逻辑错误,而是情绪在替你选样本,代价是把风险敞口悄悄放大。
理解这三重原因的现实意义是:你不必和自己的直觉硬碰硬,只需要在流程里给基础比率留一个固定卡位。只要它每次都先被写下,后面的调整就有据可依,直觉就从「裁判」降格为「一名证人」,位置一旦摆正,判断质量往往就能上一个台阶。
BASE-4:把这一步补回来的四步框架
框架第一步是找基准。做法是先写一句话:「我这件事属于哪一类?」然后尽力把它对应到一个有公开统计的参照类,取一个频率区间,而不是一个精确到小数点的假精度。如果实在找不到统计,就退一步用同类事件的经验比例,并明确标注这是估计值,方便日后校准。
第二步是做调整。拿到基准后,再用你手里的具体证据修正。贝叶斯给出的做法是先验几率乘以似然比:如果某条证据在「为真」的情况下出现的概率,是在「为假」情况下的两倍,那么它就把先验的赔率翻一倍。注意,调整的是几率而不是百分比,而且要一步一步来,每加一条证据就更新一次,避免把多条证据凭感觉揉成一团。
第三步是回检。这一关专门防止你「假装用了基础比率」。要问三件事:参照类是否被悄悄换成乐观子类?样本量是否小到没有统计意义?我的信息是否只覆盖了幸存者,漏掉了沉默的失败者?三问任何一问亮红灯,都要把结论往基准方向拉回一截。
第四步是执行。校准后的概率必须落到动作上才有价值:概率高就加大投入,概率低就控制敞口,而不是无论概率高低都全押。这一步常被忽略,于是出现「账算得很明白、手却照旧乱动」的割裂。BASE-4 的闭环,就是把认知结果翻译成杠杆与仓位的收放。
贝叶斯视角下的先验与调整
把基础比率说清楚,最好的语言是贝叶斯。先验概率就是基础比率,它代表在你看到任何个体证据之前的判断;证据则通过似然比起作用,也就是「这条证据更可能出现在哪种情况下」的比值。后验概率是先验与似然比相乘的产物。三者关系清晰之后,很多争论其实会立刻收敛。
用医生那道题走一遍。患病率的先验是千分之一,换成十万人里约一百个病人。检测灵敏度假设为九成九,假阳性率为百分之五:一百个病人里约九十九人呈阳性,九万九千九百个健康人里约五千人呈阳性。阳性结果总共约五千零九十九人,其中真患病约九十九人,占比约百分之二。一步算术,就把「阳性等于九成五患病」的错觉击穿。
贝叶斯框架还解释了一个反直觉现象:同样的证据,在不同先验下结论天差地别。同一份亮眼的业绩数据,放在「该行业普遍高波动」的基础上,和放在「该行业普遍稳定」的基础上,得到的后验概率完全不同。所以争论谁对之前,先对齐先验,往往比对证据本身更重要。
需要补充的是,真实判断里似然比常常是估计出来的,并不精确。稳妥做法是给先验和似然比都留一个区间,看最终结论落在什么范围。如果结论对先验极度敏感,说明你的证据信息量不足,此时更该保守下注,而不是假装算准了。
把基础比率放进真实决策
职业选择是基础比率最容易被浪费的场景。很多人评估「转行去某赛道」时,只看几位成功转型者的故事,却不查该类转型的普遍成功率与平均过渡时长。把参照类的存活率、平均收入变化、过渡期回撤写下来,你会发现决策的重点从「心动不心动」变成了「我能否承受大概率的那条路径」。
消费与配置同样适用。当我们评估「这笔投入多久回本」时,基础比率提醒你先看同类项目的普遍回报周期,而不是拿自己最乐观的设想当默认。对于高波动的选择,理性做法是按概率调整敞口:概率越不确定,单次投入越应控制,把「全部换入」改成「分次换入」,把一次性押注变成可承受的试探。
健康与自我管理里,基础比率对应的是「人群层面的普遍规律」。例如某类指标的普遍变化区间、某种生活方式调整的平均见效周期,都应以人群数据为起点,再谈个体差异。这里的关键不是用统计否定个案,而是先用统计给自己一个合理预期,避免用极端案例设定不现实的进度表。
信息判断上是另一个高频战场。看到一条「某某方法让人一夜翻盘」的说法,先问:这类说法的整体兑现率是多少?被报道的个案是不是经过了幸存者筛选?如果只统计成功者,基础比率就被系统性高估。养成先找分母的习惯,很多夸张叙事会自行露馅,而你也省下了大量被情绪牵着走的决策成本。
三个最容易踩空的塌陷点
第一个塌陷点是参照类选错。参照类太宽,会掩盖关键差异;太窄,则容易滑向乐观子类。稳妥做法是同时列出「宽口径」和「窄口径」两个基础比率,看两者差距有多大,再决定更信哪个。差距越大,越要谨慎,因为这恰恰说明你对情境的判断会强烈影响结论。
第二个塌陷点是小样本。连续三次成功,很容易被当作「找到了规律」,但在小样本下,这样的结果完全可能是随机波动。经验法则是:观察次数越少,越应该向基础比率回归,而不是相反。把「三次都成了」翻译成「样本量为三,不足以推翻基准」,判断就会稳得多。
第三个塌陷点是幸存者偏差。书店里满是成功者写的回忆录,失败者没有动力再写一本。当你只统计能说话的那部分样本时,基础比率会被系统性抬高。对策是主动寻找「沉默的证据」:去查行业整体的退出率、失败案例的公开数据,用全量分母替代幸存者分子。
这三个塌陷点往往会叠加出现:选错参照类,再用小样本佐证,最后只统计成功者,于是得到一个漂亮却危险的结论。回检时把它们按顺序过一遍,比事后复盘便宜得多。真正成熟的判断,不是从不犯错,而是把这几类系统性错误提前堵在流程里。
怎样知道自己的校准在变好
校准是可以被度量的。最朴素的方法是分桶:把你所有标过概率的判断按百分之十为一档分组,统计每档里真实发生的比例。如果你标「六成把握」的事最后约六成兑现,说明校准良好;若远低于六成,说明你整体过度自信,需要把日常估计系统性下调。
第二个指标是基础比率偏差比的趋势。记录你每次判断的初始估计与参照类基准,算它们的比值,观察这个比值是否随时间向一收敛。早期它可能常在三倍以上,随着习惯形成会逐步缩小。趋势比单次数值更有意义,因为它反映的是习惯是否真的长出来了。
第三个指标是惩罚分。只看命中率会被极端押注误导:偶尔押中极端事件,命中率看起来不错,但长期代价巨大。引入对数或布里尔类的惩罚分,可以给「过度自信的边缘押注」应有的惩罚,让你的记录更真实地反映判断质量,而不是被少数幸运样本美化。
第四个维度是记录本身的质量。好的决策日志不止写「我猜会不会」,还要写「依据哪条参照类、用了什么似然比、当时的把握区间是多少」。这样事后才能归因:错了是基准取偏,还是证据解读有误。没有这个颗粒度,复盘就会退化成「下次运气好点」,校准也就无从谈起。
一页纸的落地清单
第一,判断前先写参照类。无论多小的事,先补上一句「这属于哪一类」,把族群比例写在最前面。这一句话只要三十秒,却能把整条推理链的起点从「感觉」换成「频率」,大幅降低后续偏差的传播空间。
第二,把比率翻译成自然频率。遇到百分比,就换算成「每一千人或每一万人里有多少个」,让数字变成可想象的场景。大脑对可数的人头反应更快,这一步能显著降低误判率,也方便你在和别人沟通时把共识建立在同一套分母上。
第三,用似然比逐步更新,而不是一步到位。每获得一条新证据,就把它对先验的倍数影响算清楚,再更新一次后验。哪怕只是粗略估计,也比你把所有证据凭感觉揉在一起更可靠,而且留下痕迹便于日后复核。
第四,把校准后的概率写进动作。概率高就换入、加码;概率低就换出、减仓;不确定就分批处置、控制单次敞口。让仓位和概率挂钩,是把认知真正兑现为结果的唯一通道,否则再漂亮的判断也只是纸面功夫。
第五,定期回检并记录。每季度把判断与结果对一次账,算校准分与基础比率偏差比的趋势,标出最常犯的那类错误。清单的价值不在一次执行,而在长期重复中把「先看基础比率」变成本能。慢慢地,你会在别人还在为一个故事下注时,已经先算清了分母。
常见问题
1.问:基础比率和直觉冲突时,到底该信谁?答:先信基础比率,再用证据和直觉去调整,而不是反过来。基础比率是最省成本、最不容易被故事误导的起点,直觉适合作为「可能漏掉了什么」的提醒,而不是直接推翻分母的理由。
2.问:找不到自己这件事的基础比率怎么办?答:先找宽口径参照类,再逐步收窄。哪怕只有一个粗略的经验比例,也先写下来并标注为估计值,随着记录增加再替换。关键在于养成「先有分母」的习惯,而不是等到数据完备才开始。
3.问:基础比率是不是会让人过于保守?答:不会,它只是把起点摆正。真正的激进应建立在校准后的高概率上,而不是建立在忽略分母的乐观上。用基础比率打底,反而让你在证据充分时敢于重仓,在证据不足时不至于全押。
4.问:小样本的成功经验该不该用?答:可以参考,但要向基础比率回归。样本越小,越应该把它当作线索而非结论,并主动设想它在更大样本下是否仍成立。用「样本量不足」做提醒,能避免把随机波动误读成可复制的规律。
5.问:多久能看到校准的改善?答:取决于记录密度,但趋势通常在坚持记录数十次判断后开始显现。要点不是单次的准确,而是偏差比是否持续向一收敛、过度自信是否缓解。把它当成一项长期习惯,而不是一次性的技巧。
图片来源:图1 yanyunyi / Pixabay (CC0) · 图2 jarmoluk / Pixabay (CC0) · 图3 bigtorica / Pixabay (CC0) · 图4 Pexels / Pixabay (CC0) · 图5 zkittler / Pixabay (CC0) · 图6 x-readingman / Pixabay (CC0) · 图7 biglinker / Pixabay (CC0) · 图8 falco / Pixabay (CC0) · 图9 PIRO4D / Pixabay (CC0) · 图10 fighter_lok / Pixabay (CC0) · 图11 Charlottees / Pixabay (CC0) · 图12 wallner / Pixabay (CC0) · 图13 ColiN00B / Pixabay (CC0) · 图14 cherylholt / Pixabay (CC0) · 图15 lusepho / Pixabay (CC0) · 图16 lucaspapa_ / Pixabay (CC0) · 图17 ambquinn / Pixabay (CC0) · 图18 ArWeltAtty / Pixabay (CC0) · 图19 Alexas_Fotos / Pixabay (CC0) · 图20 divotomezove / Pixabay (CC0) · 图21 zkittler / Pixabay (CC0) · 图22 falco / Pixabay (CC0) · 图23 Wunderphotos1951 / Pixabay (CC0) · 图24 biglinker / Pixabay (CC0) · 图25 amadia91 / Pixabay (CC0) · 图26 daschorsch / Pixabay (CC0) · 图27 Willystanley / Pixabay (CC0) · 图28 Felix-Mittermeier / Pixabay (CC0) · 图29 geralt / Pixabay (CC0) · 图30 geralt / Pixabay (CC0) · 图31 geralt / Pixabay (CC0) · 图32 geralt / Pixabay (CC0) · 图33 modernseoul / Pixabay (CC0) · 图34 theharpreetbatish / Pixabay (CC0) · 图35 Daniel_Nebreda / Pixabay (CC0) · 图36 Alexas_Fotos / Pixabay (CC0) · 图37 MiraCosic / Pixabay (CC0) · 图38 Dimhou / Pixabay (CC0) · 图39 MiraCosic / Pixabay (CC0) · 图40 Surprising_Media / Pixabay (CC0)
本文为信息分享与方法论科普,不构成任何专业建议,请结合自身情况判断。
本文由 AI 生成,经人类主编终审。
评论(0)