
基本信息
阅读时间:约 16 分钟
字数:约 6226 字
摘要:判断力强的人不是记性最好的人,而是最会更新的人。本文围绕「贝叶斯更新法」的先验与后验,用医学筛查等公开算例说明为什么直觉会系统性高估证据,提出「先验—证据—后验三步法」框架,并给出似然比、更新幅度、校准度等四个可量化指标与一份每周十分钟的更新日志,让信念从一句感觉变成可以被证据移动、被记录复核的对象。
全文语音
中文
English
日本語
한국어
专业分析:先验与后验,高手的判断为什么能越用越准
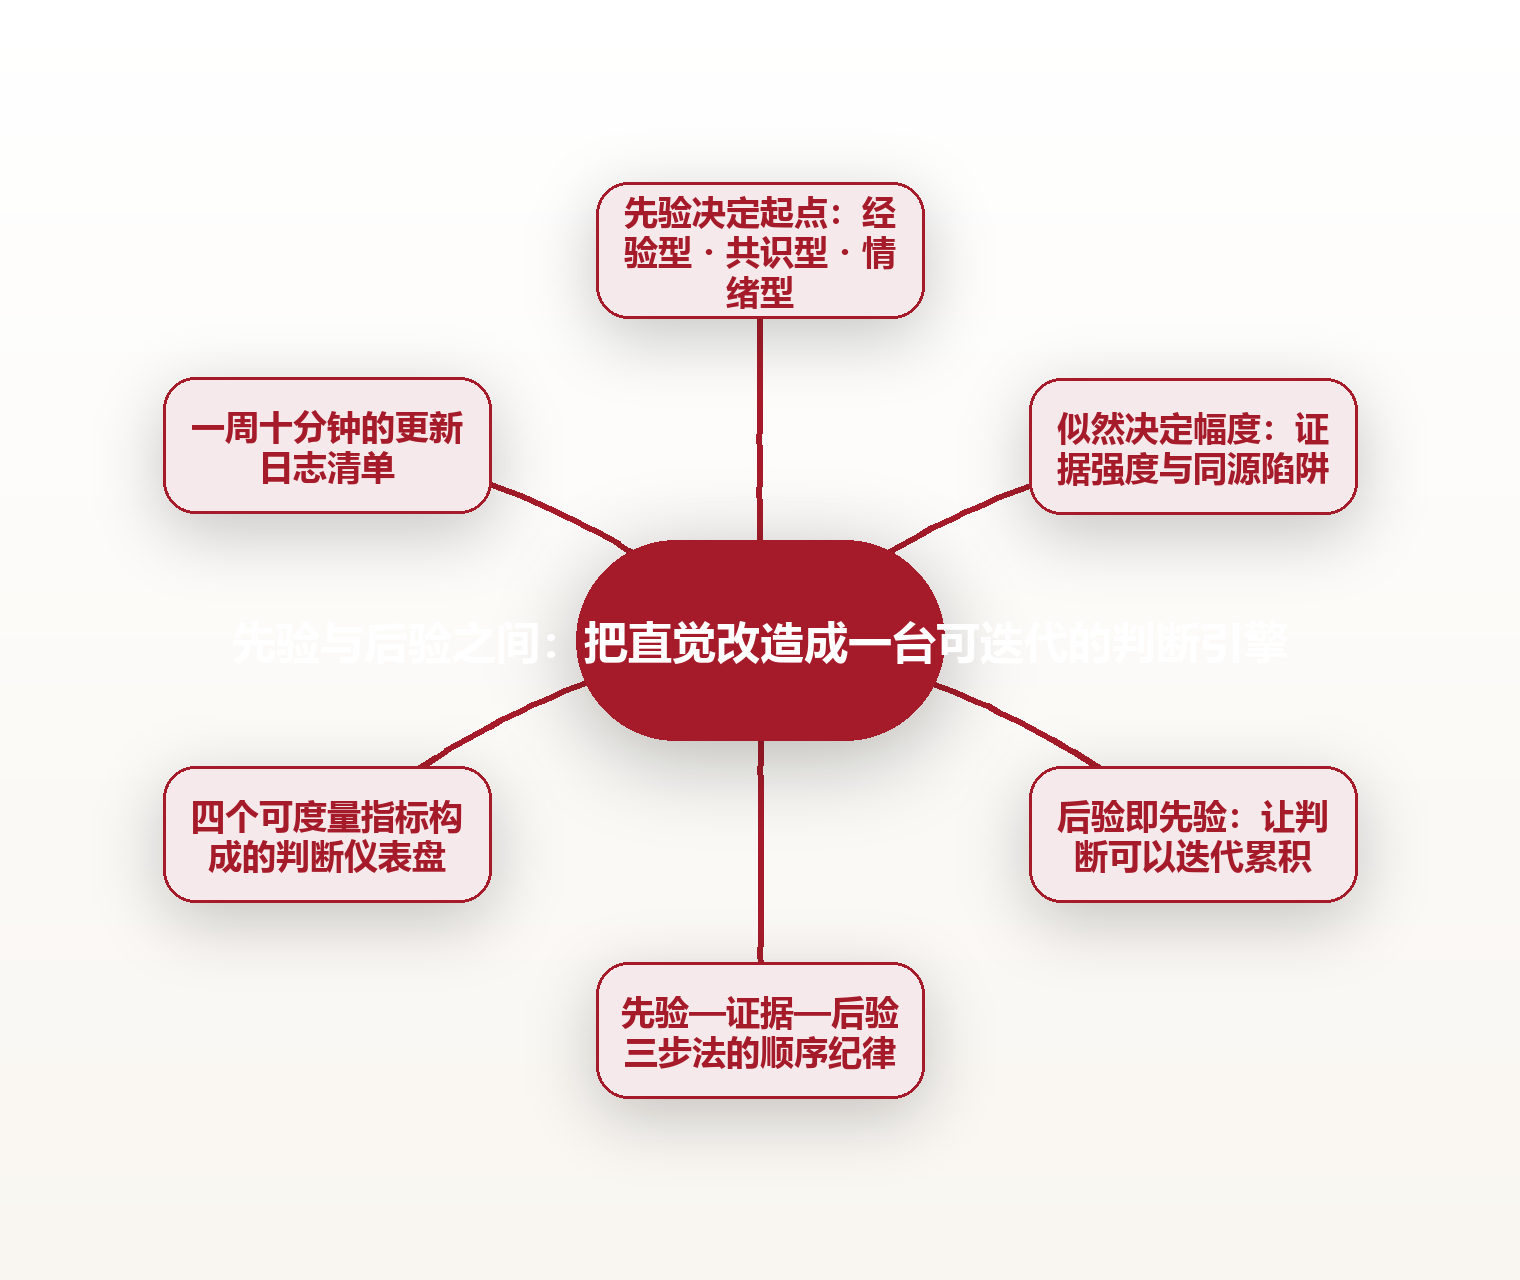
先给结论:判断力强的人,往往不是记性最好、也不是最自信的那一个,而是最会更新的人。他们在任何时刻都同时拿着两样东西——一个当下的判断,和一条随时准备改写它的通道。贝叶斯更新法讲的,正是这条通道如何运作;而先验与后验,是这条通道的两个端点。
把这件事压缩成一行量级关系就是:后验 ∝ 先验 × 似然。它不是一个关于信心的理论,而是一条关于「新证据应当把信念移动多远」的会计规则。据概率与统计领域的公开口径,这个算式的雏形由 18 世纪的托马斯·贝叶斯提出、经拉普拉斯完善成型,两百多年后被写进从垃圾邮件过滤到医学筛查的无数真实系统里。
一个被公开教材反复引用的案例来自医学筛查。以认知科学家吉仁泽在著作中讨论过的乳腺筛查为例:设某病在人群中的患病率约为 1%(这是先验),某项检查对患者的检出率约为 90%(敏感度),对健康者的误报率约为 9%(假阳性率)。当一个人拿到「阳性」结果时,她实际患病的概率只有大约 9%,而不是直觉里的「90%」。来源类型:公开教材与认知科学著作中反复出现的经典算例。
命名框架:我把它叫「先验—证据—后验三步法」,简称 PEL 环(Prior—Evidence—Likelihood)。它把一次判断拆成三步——先问「我现在大致信什么」(先验),再问「这条新证据在患病与健康两种情形下分别有多大可能出现」(似然比),最后把两者相乘并归一化,得到「更新后我该信什么」(后验)。它和「看到强证据就直接下结论」是两套完全不同的逻辑:后者只看证据本身有多强,前者还问证据相对于原有判断有多新。
上面那个 1% 与 9% 的算例之所以重要,是因为它暴露了一个系统性偏差:人会忽略「基础比例」(先验),把「检查准确率」直接当成「我患病的概率」。同一份阳性报告,在低患病率人群里携带的信息量,远小于在高患病率人群里携带的信息量。证据相同,后验不同——差别全部来自先验。
落到可操作层面,这篇文章给你四个可以量化的指标——先验透明度、似然比对强度、更新幅度合理性、校准偏差——再给你一份一周十分钟就能跑的「更新日志」清单。目标不是让你变成一台概率计算机,而是让被先验带偏的判断从隐性变成显性,让每一个结论在写下之前就能被证据检验、被自己复核。
贝叶斯更新到底是什么:一次信念的重新分配
贝叶斯更新的本质,是一次信念的重新分配:不是把旧想法全部推翻,也不是固执地守着旧想法,而是按证据的强弱,把原来压在各个可能解释上的「注意力和信任」,重新码放一遍。先验是分配前的样子,后验是分配后的样子。
要理解它,先要接受一个前提:我们几乎从不在「零信息」状态下做判断。你见到一个新同事、拿到一份新报告、听到一个传闻,脑子里都已经先有一个大致的判断。这个先有的判断就是先验。它可能来自经验、来自行业常识、也可能来自偏见,但它一定存在。
贝叶斯更新做的第一件事,是把这个「一定存在」的先验请到明面上。它不允许你说「我没有预设」——因为那通常是在掩盖一个没被检视过的预设。承认先验,是更新能够开始的前提。
第二件事,是区分「证据看起来很强」和「证据相对于先验很强」。一条能同时解释两种可能性的证据,几乎不携带信息。真正推动后验移动的,是那些在一种假设下很常见、在另一种假设下很罕见的证据,也就是似然比高的证据。
第三件事,是把更新变成可以反复进行的动作。一次更新结束,得到的后验不会停在原地,它会成为下一次判断的先验。判断力之所以能「越用越准」,不是因为单次更新有多神,而是因为这个环形动作可以被无限次地重复:先验进去,证据进来,后验出去,再回到先验的位置。
所以贝叶斯更新的价值,不在于给出一个精确的数字,而在于提供一个可复核的结构。它把「我觉得」拆成「我原先觉得什么」「我看到了什么」「这条证据把我说服了多少」。三句话分开写下来,判断就从一句感觉,变成了一段可以被追问的记录。
先验从哪里来:三种先验与它们各自的代价
先验不是从天上掉下来的,它总有来源。理解先验的来源,是理解自己判断偏差的第一步。粗略地分,日常判断里的先验大致有三种:经验型、共识型与情绪型。
第一种是经验型先验。它来自你过去真实经历过的样本——你办过十次类似的事,其中几次顺利、几次不顺,于是你形成了一个大致比例。这种先验质量通常最高,但它的坑在于样本太小:三次经历就敢总结出规律,本身就是一种过度自信。
第二种是共识型先验。它来自你所在群体的普遍看法、行业惯例或权威结论。它的好处是省事,站在别人肩膀上;它的风险是把共识当成事实,而不去追问这个共识是何时形成、基于什么样本、是否已经过时。共识型先验最容易在环境变化时失效。
第三种是情绪型先验。它来自你此刻的感受——最近被类似的事伤过,于是对这类事一概戒备。情绪型先验反应快,但在低概率、高情绪的场景里最不可靠,因为它把一次强烈体验的权重,错误地放大成了一类事件的普遍规律。
三种先验各有代价,也各有用处。关键不是消灭某一种,而是知道当前这个判断用的是哪一种。一个可以随身用的自检问题是:「我这个先验,是基于多少次亲身样本、多少人形成的共识、还是一件事的情绪?」答得出来,先验就从隐形变成了可调整的。
还有一个容易被忽略的事实:先验越模糊,证据的作用就越大;先验越确定,同样的证据就越难移动你。这解释了为什么有些人对新信息几乎免疫——他们的先验已经硬到了一个临界点,任何一条证据进来,都只是被吸收进原有的框架里。
似然的分量:证据强度决定更新的幅度
如果说先验决定「起点在哪」,那么似然决定「这一步能走多远」。同样一条证据,落在强先验上只能带来小幅移动,落在弱先验上却可能彻底改写结论。更新的幅度,从来不是由证据单独决定的。
一个有用的直觉是把证据分成三类。第一类是「两边都常见」的证据,比如一个含糊的表态,无论对方是不是可信,这类话都可能出现,它几乎不携带信息,似然比接近 1。第二类是「一边常见、一边罕见」的证据,比如一份有具体数字的原始记录,它才真正推动判断。第三类是「只在一侧可能」的证据,一旦出现几乎可以直接定论,但现实中它极其稀有。
大多数人犯的错,是把第一类证据当成第二类来用。一条模糊的传闻、一次礼貌的点头、一段被剪裁过的自媒体叙述,被当成了「有力证据」,于是后验被大幅度地、错误地移动。学会给证据的似然比估个数,是防止被带偏的第二道闸。
这里有一个反直觉的量级结论:证据的可信度不等于证据的独立性。如果你听到的三条「好消息」,其实都源自同一个消息源,那么在贝叶斯意义上它们只算一条,不该乘三次。把相关证据当成独立证据重复计数,是普遍被低估的高估来源。
所以看证据时不妨多问两句:这条证据,在我原本相信的情形下出现的概率有多大?在我不相信的情形下呢?如果两个答案差不多,那就先别急着改变结论。养成了这个习惯,你会发现很多「震惊」的消息,其实携带的信息量小得可怜。
似然的分量还有一个时间维度。同一类证据反复出现,每出现一次,更新幅度都会递减——第一条证据最有力,后面每一条的边际贡献都在变小。理解这一点,能让你在被同一种消息连续轰炸时,仍然保持更新的节制。
后验不是终点:把结论变成下一轮的先验
很多人把贝叶斯更新理解成「算出一个答案」,其实真正的用法是「得到一个可以继续更新的起点」。后验算出来之后,它立刻回到台上,成为下一次判断的先验。这个循环闭环,才是判断力可以持续进步的原因。
如果后验是终点,那么每次遇到新问题都要从零开始,经验无法累积;如果后验是起点,那么同样的先验可以被一步步可靠的证据不断地修正,越来越接近真相。贝叶斯更新法真正提供的,正是这种「把过去积累成现在的起点」的能力。
要让这个循环转得起来,关键动作是记录。你需要把「这一轮的先验是什么、看到了什么证据、更新后的后验是多少」写下来。只在自己脑子里更新,下一次你根本想不起来上一次信的是什么,更新就退化成了一次性的感觉。
记录还有一个隐含好处:它让「我改变主意」变成一件正常的事。在贝叶斯框架里,改主意不是丢脸,而是证据到位的自然结果。一个人如果从不在新证据面前调整判断,要么是他一直看的都是没信息量的证据,要么是他根本没在用后验驱动下一步。
需要警惕的是相反的方向——为了显得一致,拒绝更新。维护一个旧结论的成本,会随着时间越滚越高,因为你要不断地为它找理由。贝叶斯更新提供的态度恰恰相反:判断是流动的,只要证据足够,任何先验都可以被更新。
把「后验即先验」这句口诀记住,你就从「做完一次判断就结束」,切换到了「每一次判断都在为下一次铺路」。这也是判断力这台机器能够越用越准的核心机制。
先验—证据—后验三步法:可随手使用的更新流程
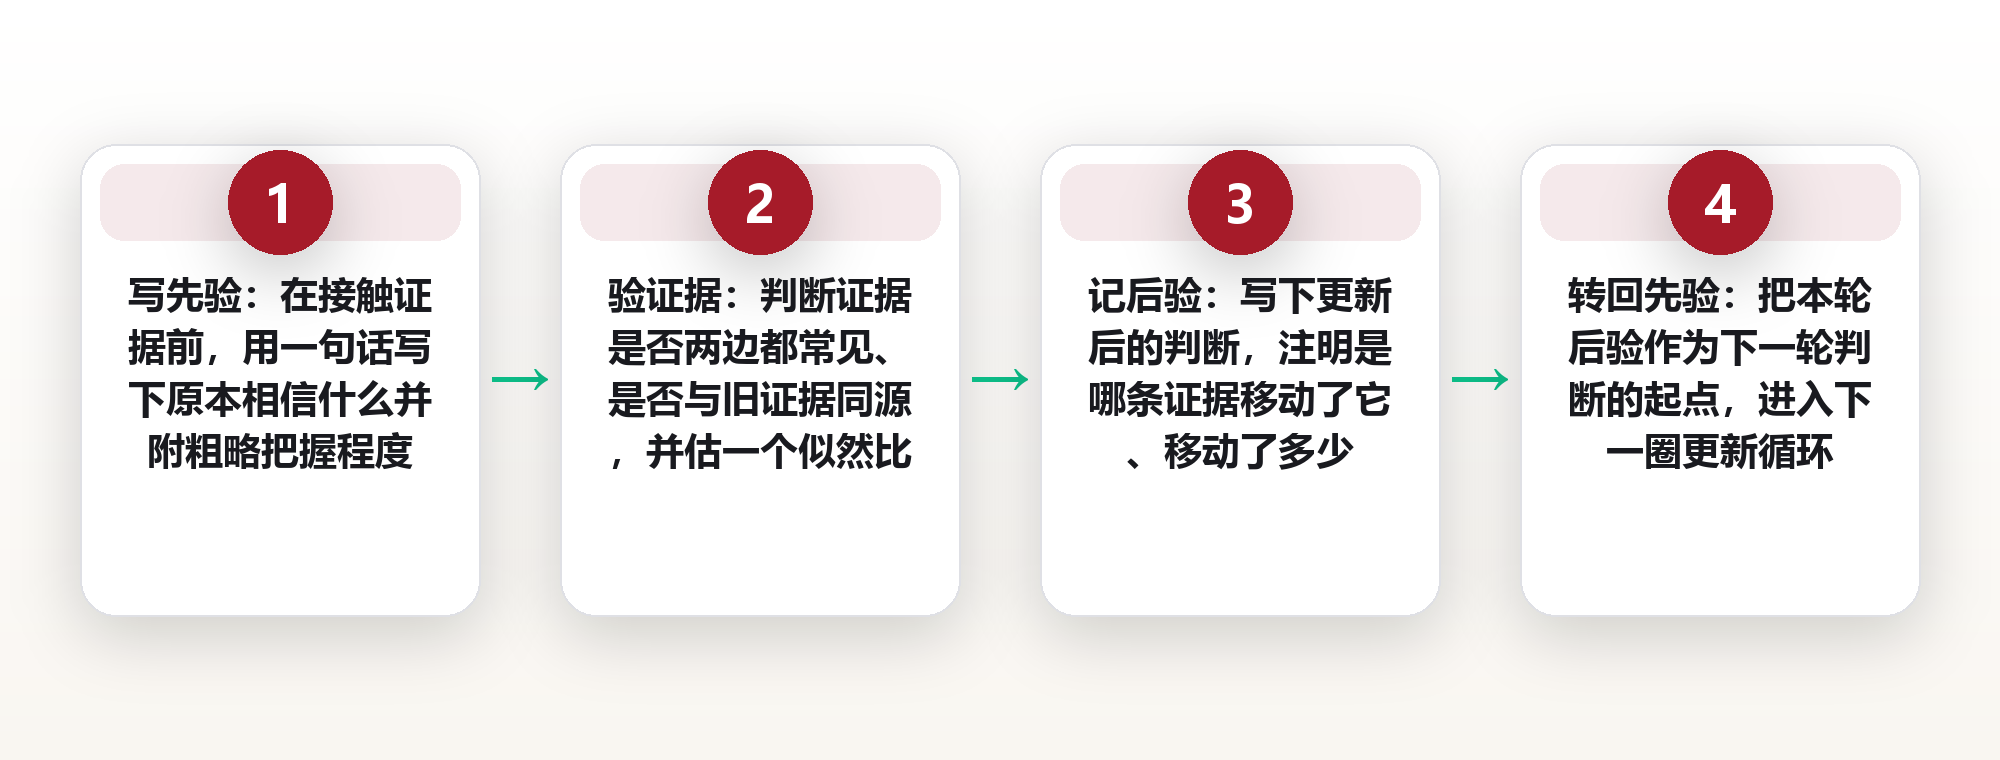
把前面所有内容收拢成一个可以随手使用的流程,就是「先验—证据—后验三步法」。它的设计目标是低成本——不要求你算概率,只要求你在做重要判断前,按顺序把三个位置各填一次。
第一步,写先验。用一句话写下「在此之前,我大概相信什么」,并附上一个粗略的把握程度,比如「七成」「说不好」「几乎确定」。刻度不必精确,但要写下来,因为写不出来的先验,往往是被情绪临时撑起来的。

第二步,验证据。拿着这条新信息,先问它是不是「两边都常见」的模糊证据;若是,就果断降权。再问它是否与之前听过的证据同源;若是,就只当一条计。最后估一个方向:这条证据在哪种假设下更可能出现。
第三步,记后验。把更新后的判断写下来,并写清「是什么证据让我移动了、移动了多少」。移动幅度要克制——除非证据的似然比明显高,否则不要因为一条信息就从「几乎确定」跳到「完全不信」。
三步之间有一个容易被忽略的顺序纪律:先写先验,再看证据。很多人是看完证据才回头去编一个「我本来就觉得」的先验,这在心理上叫事后合理化,它会让更新变成装饰,而不是真实的推理。
这套流程最大的价值,是让「先验」和「后验」在时间上被清晰地隔开。当它们被分开记录,你就能看出一个人的判断到底是「证据推动的」,还是「情绪摇摆的」。前者可以复现,后者只能事后解释。
两套判断逻辑的对照:锚定直觉与贝叶斯更新
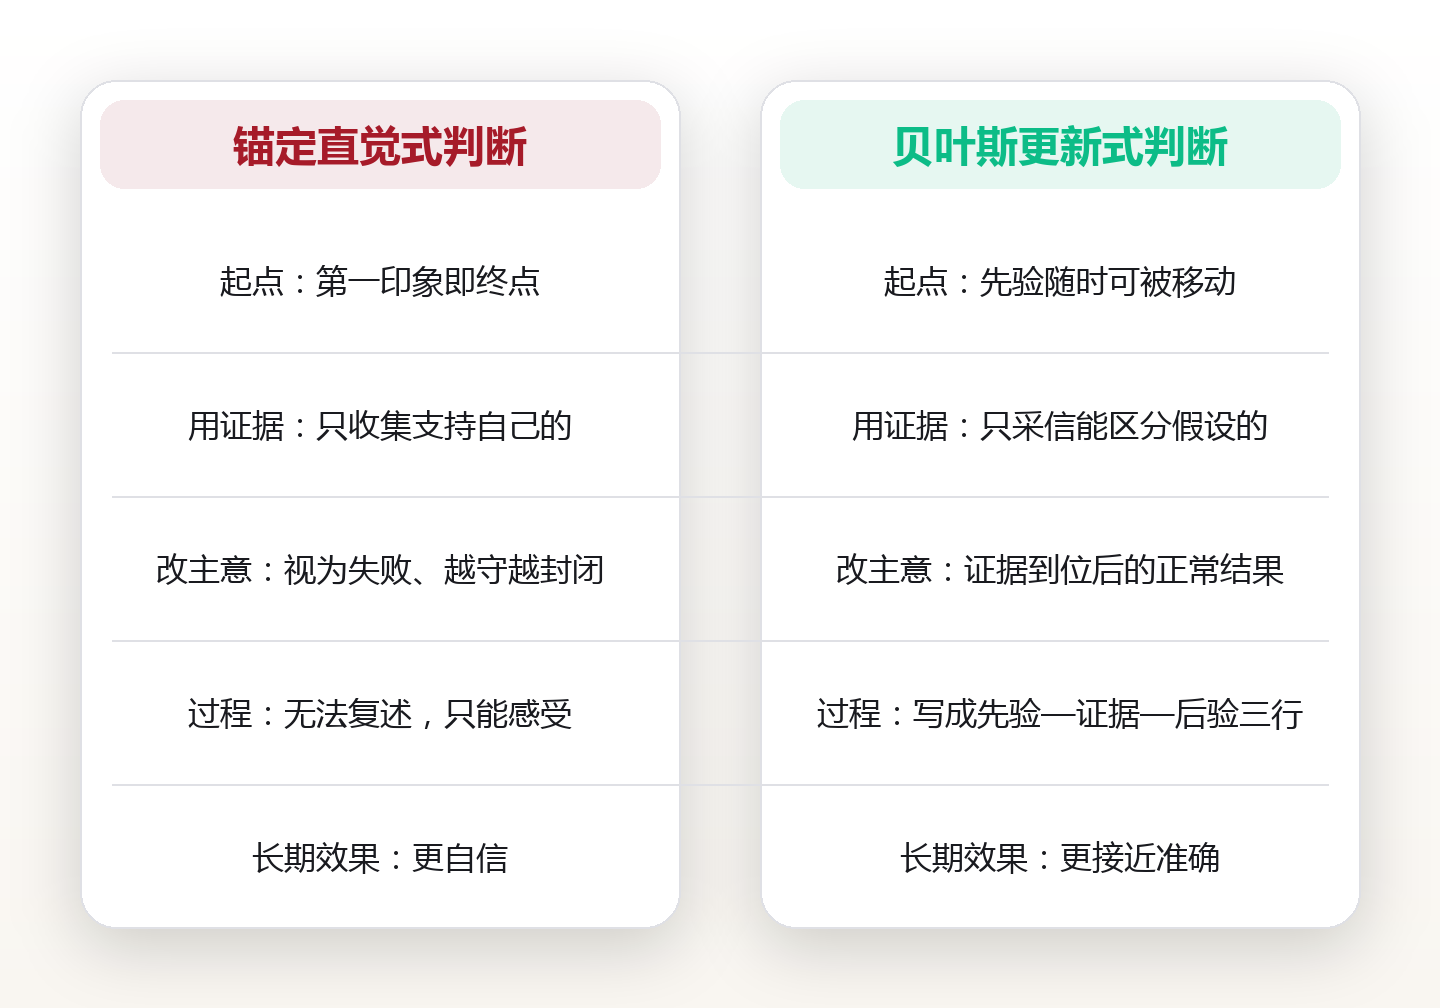
为了看清贝叶斯更新的分量,把它和最常见的替代逻辑——锚定直觉——并排摆出来最有效。锚定直觉的典型过程是:先抓住第一个印象,之后所有的信息都被用来加固或修饰这个印象。
锚定直觉的第一个特征是「起点即终点」。第一印象一旦形成,后续信息大多被用来找证据支持它,而不是用来检验它。贝叶斯更新则要求起点只是一个可被移动的「先验」,随时准备为新证据让位。
第二个特征是证据的用法不同。锚定直觉把「符合印象的证据」当宝,把「不符的证据」当例外;贝叶斯更新则专门盯着那些能区分两种假设的证据,无论它是否符合预期。前者追求的是自洽,后者追求的是校准。
第三个差别在于改变主意时的心态。锚定直觉把改主意看成失败,于是越坚持越封闭;贝叶斯更新把改主意看成系统正常运转的产物——证据到了,更新就发生了,不需要为此辩护,也不需要为此惭愧。
第四个差别在于可复现性。锚定直觉的过程无法被复述,只能被感受;贝叶斯更新的过程可以被写成三行——先验、证据、后验,任何人都能顺着这三行检查你哪一步走得不对。可复现,是它能被改进的前提。
把这四点放在一起就能看清:锚定直觉让你更自信,贝叶斯更新让你更接近准确。这两个目标在短期内常常一致,但在长期里,只有后者能积累出真正可靠的判断力。
四个可量化指标:给更新过程装一块仪表盘
要让「先验—证据—后验」不停留在口号层面,需要几个可以写进表格、每周回看的指标。下面四个分别对应更新的四个环节,不求精确,只求可比可核。
指标一:先验透明度。衡量你能否在接触证据之前,用一句话说清自己原本相信什么。可以给自己一道及格线——事前说不清先验的判断,先搁置,别急着下结论。透明度越低,越容易事后编造先验。
指标二:似然比对强度。用「这条证据在两种假设下的出现概率之比」来粗估。比值接近 1 的证据果断降权,比值明显偏离 1 的才纳入更新。这一步能过滤掉绝大多数看似热闹、实则无信息量的消息。
指标三:更新幅度合理性。对照证据强度检查你移动了多少。一个健康的更新,幅度应当与似然比大致匹配——证据平平却大改结论,或证据很强却纹丝不动,都是需要复查的信号。
指标四:校准偏差。长期看,你给出「八成把握」的判断里,最终对的比例是否接近八成。这就是校准。它可以粗略统计——把你最近十次带把握程度的判断记下来,看实际命中率与自信度差多少,差值就是你的校准偏差。
这四个指标放在一起,就构成了一台判断力的仪表盘:第一盏灯看起点是否清晰,第二盏看证据是否够格,第三盏看移动是否匹配,第四盏看长期是否准。灯一旦常年亮红,说明你需要的不是更多信息,而是更诚实的更新习惯。
仪表盘的意义不在于精确读数,而在于把「我判断得准不准」这个模糊的问题,拆成四行每周可以填的记录。数字一旦写下来,锚定的惯性就会明显减弱。
一周十分钟的更新日志:把判断变成可复核的动作
下面这份「更新日志」清单,设计成一星期十分钟就能跑完,目的是让贝叶斯更新从一个概念,变成每周固定的动作。
第一项,盘点。每周挑出最近做过的三个重要判断,各写一句「当时的先验是什么」。这一步最容易被跳过,也最有价值——它逼你把隐形的预设请到台面上。
第二项,验证据。对每个判断,标出这一周里出现的最关键一条新证据,并粗估它的似然比对强度,给一个高、中、低的等级。同源的证据只计一次。
第三项,比幅度。把「证据强度」和「你的态度变化」并排放在一起看。证据是低而你态度大变,或证据是高而你雷打不动,都圈出来,作为下周重点复查的对象。
第四项,看校准。每月用一天,回看过去一个月里带把握程度的判断,统计实际命中率。命中率长期低于自信度,说明你整体偏过度自信;长期高于,说明你过于保守。
这份日志的价值不在于让你算得比别人准,而在于让你保持清醒:你改主意,是因为证据足了,而不是因为情绪来了;你坚持,是因为先验稳,而不是因为不肯认错。
真实复盘:三个被先验悄悄带偏的场景
把框架放进真实场景,才能看出它的分量。以下三个场景都很日常,也都很容易被一个没被检视的先验带进沟里。
场景一:看到一个片段就给人贴标签。你在朋友圈读到一个被截取的片段,立刻形成对某个人或某件事的判断。这里的问题不是证据错了,而是先验被一次强烈体验临时改写,似然比极低的信息被当成了定论。补救办法是先把先验写下来,再问这条证据够不够格移动它。
场景二:专家的一句话被当成终局。你信任某个权威,于是他说一句「大概率会这样」,你就把它记成了「一定这样」。这里的问题是忽略了证据的原始语境——专家的话有它的适用范围,脱离语境的转述,似然比会显著缩水。
场景三:连续几条同源消息让人兴奋。你看到好几条「利好」消息,越看越乐观。但如果它们都出自同一个源头,它们在贝叶斯意义上只是同一条证据的三张面孔,连续叠加会把一个很弱的信号,误算成一个很强的信号。
三个场景的共同点是:出错的地方都不在证据本身,而在先验与证据之间的那道闸门没有把关。识别的方法也一致——在改变结论之前,先问一句「这条证据,真的够格移动我原来的判断吗」。
把它们并排看还能发现一个规律:被带偏的时候,人往往是先有了强烈情绪,再去找证据。而贝叶斯更新的顺序恰好相反——先写先验,再看证据。顺序反过来,偏差就从源头上被压住了。
适用边界:什么时候不该急着更新
讲到这里也要泼一盆冷水:贝叶斯更新不等于「一有新消息就立刻改主意」。真正的成熟,是知道哪些证据值得更新,哪些噪音应当被过滤掉。
第一条边界是证据的可靠性。如果一条消息连基本来源都无法确认,那么它带来的似然比本身就不可信。这类信息不是「弱证据」,而是「不可用的证据」,不该进入更新流程,哪怕它情绪上很打动人。
第二条边界是样本量。一次亲身经历、一个孤立案例,在当前语境下可能有启发性,但作为移动先验的证据,它太弱了。把单次体验的权重放大成一类事情的规律,本身就是一种典型的过度更新。
第三条边界是代价与可逆性。对于那些一旦更新就难以回头、且代价很高的判断,即使证据强烈,也值得先把「更新后的判断会让我做什么」想清楚,再决定移动多少。更新的速度,应当与决策的不可逆程度相匹配。
所以贝叶斯更新的正确用法,不是让你对所有信息都反应过度,而是让你做一个分得清证据质量的人。该更新时果断更新,该过滤时稳稳过滤——先验不是用来死守的,也不是用来随波逐流的,而是用来被有分量的证据一步一步推动的。说到底,会更新不是为了显得灵活,而是为了让每一次改变主意,都站得住脚。
常见问题
1.问:先验和后验到底差在哪里?
答:先验是你接触新证据之前的判断,后验是你消化了这条证据之后的判断。两者之间的差别,就是这条证据实际携带并传递给你的信息量。
2.问:如果我对一件事完全没有把握,先验该写什么?
答:写「说不好」也是一种先验,而且往往比伪装的「确定」更诚实。先验的具体值不重要,重要的是把它写下来,这样你才能看出证据究竟移动了多少。
3.问:一条消息到底值不值得让我改主意?
答:看它是不是「在两种假设下都常见」。如果在你相信和不相信两种情况下它都可能出现,那它几乎不携带信息,不值得移动判断,无论它看起来多有说服力。
4.问:同时看到好几条支持同一结论的消息,是不是证据就很强?
答:要看它们是否同源。如果都源自一个出处,那在贝叶斯意义上只算一条,连续叠加会把很弱的信号误算成很强的信号,这是被普遍低估的高估陷阱。
5.问:这四个指标一定要精确计算吗?
答:不需要。它们的价值在于把模糊的「我判断得准不准」拆成四行可回看的记录。哪怕只用高、中、低粗评分,也足以在多数场景里帮你避开最典型的高估与偏差。
图片来源:图1 Ri_Ya / Pixabay (CC0) · 图2 knk1190 / Pixabay (CC0) · 图3 Ri_Ya / Pixabay (CC0) · 图4 ysen / Pixabay (CC0) · 图5 NoName_13 / Pixabay (CC0) · 图6 Orangefox / Pixabay (CC0) · 图7 marcinjozwiak / Pixabay (CC0) · 图8 Himsan / Pixabay (CC0) · 图9 12019 / Pixabay (CC0) · 图10 fernandozhiminaicela / Pixabay (CC0) · 图11 dropolto / Pixabay (CC0) · 图12 Antonio_Cansino / Pixabay (CC0) · 图13 MustangJoe / Pixabay (CC0) · 图14 ambquinn / Pixabay (CC0) · 图15 NoName_13 / Pixabay (CC0) · 图16 Chrehan6_6 / Pixabay (CC0) · 图17 Fxq19910504 / Pixabay (CC0) · 图18 minka2507 / Pixabay (CC0) · 图19 Kranich17 / Pixabay (CC0) · 图20 soap0119 / Pixabay (CC0) · 图21 NoName_13 / Pixabay (CC0) · 图22 qimono / Pixabay (CC0) · 图23 Fxq19910504 / Pixabay (CC0) · 图24 minka2507 / Pixabay (CC0) · 图25 NoName_13 / Pixabay (CC0) · 图26 tranmautritam / Pixabay (CC0) · 图27 fietzfotos / Pixabay (CC0) · 图28 viarami / Pixabay (CC0) · 图29 AlLes / Pixabay (CC0) · 图30 ahmetyuksek / Pixabay (CC0) · 图31 NoName_13 / Pixabay (CC0) · 图32 zivica / Pixabay (CC0) · 图33 NoName_13 / Pixabay (CC0) · 图34 ahmetyuksek / Pixabay (CC0) · 图35 qimono / Pixabay (CC0) · 图36 Yummymoon / Pixabay (CC0) · 图37 12019 / Pixabay (CC0) · 图38 Pexels / Pixabay (CC0) · 图39 Etivari / Pixabay (CC0) · 图40 29277261 / Pixabay (CC0) · 图41 NoName_13 / Pixabay (CC0) · 图42 tranmautritam / Pixabay (CC0) · 图43 javierMartinG / Pixabay (CC0) · 图44 Hans / Pixabay (CC0) · 图45 MiraCosic / Pixabay (CC0) · 图46 Dimhou / Pixabay (CC0) · 图47 MiraCosic / Pixabay (CC0) · 图48 focusonpc / Pixabay (CC0)
本文为信息分享与方法论科普,不构成任何专业建议,请结合自身情况判断。
本文由 AI 生成,经人类主编终审。
评论(0)