基本信息
阅读时间:约 15 分钟
字数:约 6001 字
摘要:时间审计最常漏掉的一栏,不是你做了什么,而是你什么都没做、时间却没了:排队等调度、加载等响应、找东西等自己想不起来放在哪。本文把这三类等待拆成三本账——排队账、加载账、搜寻账,用排队论与页面延迟的公开数据说明它们的成本形状,配一套四指标度量、一张账本表与一周五步清单,让「等了一会儿」变成「每周几小时」。
全文语音
中文
English
日本語
한국어
专业分析:三类等待是时间账本上最容易被漏记的一栏
先把结论放在前面:做时间审计的时候,大多数人记录的是「做了什么」,很少记录「什么都没做,但时间没了」。后者里最大的一块,恰好是三种等待——排队等外部调度、加载等系统响应、找东西等自己想不起放在哪。它们单次只有几十秒到几分钟,低于人对自己行为的记忆颗粒度,于是整整一年都不会被写进任何一张表。
第一组数据关于排队的形状。排队作为一门学问,起点是电话交换机的容量问题:丹麦工程师厄朗在 1917 年前后提出排队论,其中站得最稳的一条是,等待时间与窗口「利用率」不成线性关系。把窗口利用率从七成推到九成,平均等待往往要翻两到三倍;再往上推,等待会以更快的速度发散。这是量级判断而非精确公式,但足以解释日常困惑:明明只多来了几个人,队却长了三倍——问题不在人数,在窗口被排到了接近满载。
第二组数据关于加载的价格。2006 年谷歌公开过一组实验:把搜索结果页人为延迟 0.4 秒,观察到日均搜索次数出现可测量的下降,量级在千分之几到百分之一之间。同一年亚马逊公开的表述是,页面每慢 100 毫秒,销售收入会有约百分之一的变动。两个数字的绝对值不宜外推,但方向稳定:等待时间与使用意愿成反比,斜率在「已经很快」的区间里依然不为零。
第三组数据关于容忍度。移动端调研里被引用最多的一条是:页面加载超过 3 秒,超过一半的移动访问者会离开;超过 5 秒,放弃比例继续明显抬升。这类数字出自商业机构抽样,只看量级。它真正的价值是提示一种阈值感:人对等待的耐心不是平滑函数,而是在某个秒数附近突然折断。
第四组数据关于「找东西」。麦肯锡全球研究院 2012 年那份关于社交经济的报告估算,知识工作者每周约 28% 的时间在处理邮件与沟通,约 19% 用于搜寻和搜集信息。协作软件厂商的调研则常给出「每周一到两个半小时用于找文件」的量级。厂商调研自带立场,但多个独立来源互相印证,说明这条缝确实存在,而且比人们自估的要宽。
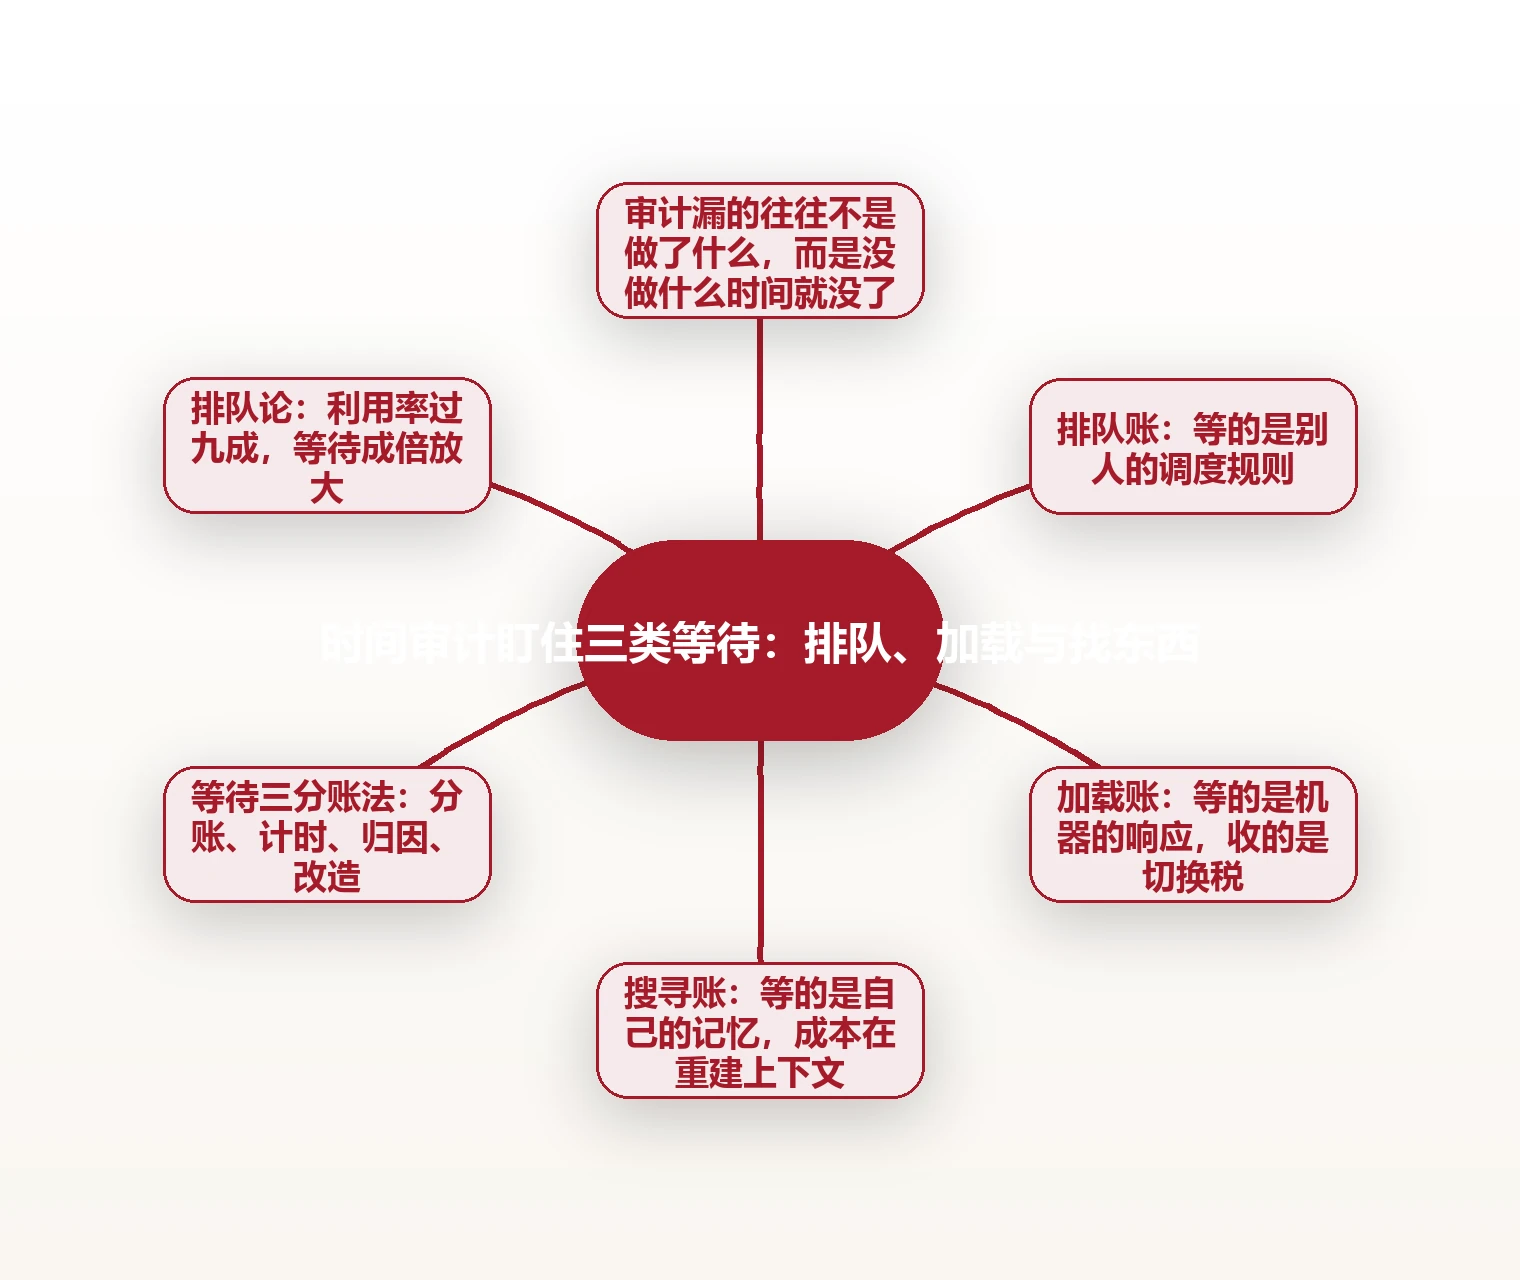
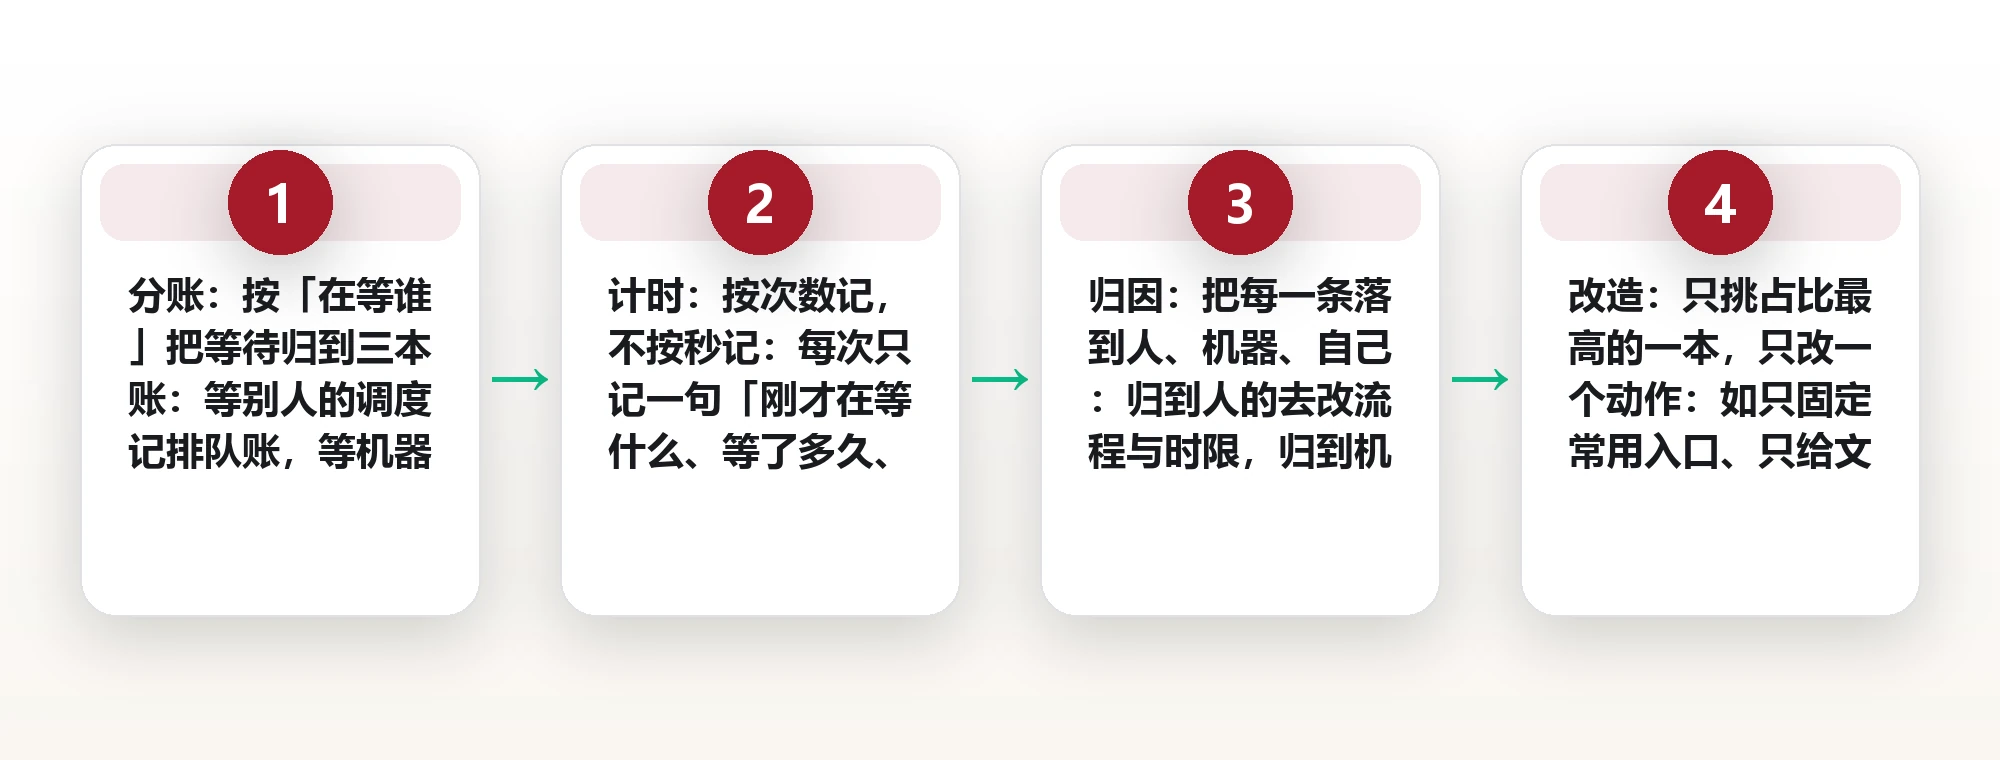
把四组数据放在一起,可以提炼出一个命名框架:等待三分账法。它不再把「等待」当成一个笼统感受,而是按「在等谁」拆成三本账——排队账,等的是别人的调度;加载账,等的是机器的响应;搜寻账,等的是自己的记忆与检索习惯。四步走完:分账、计时、归因、改造。
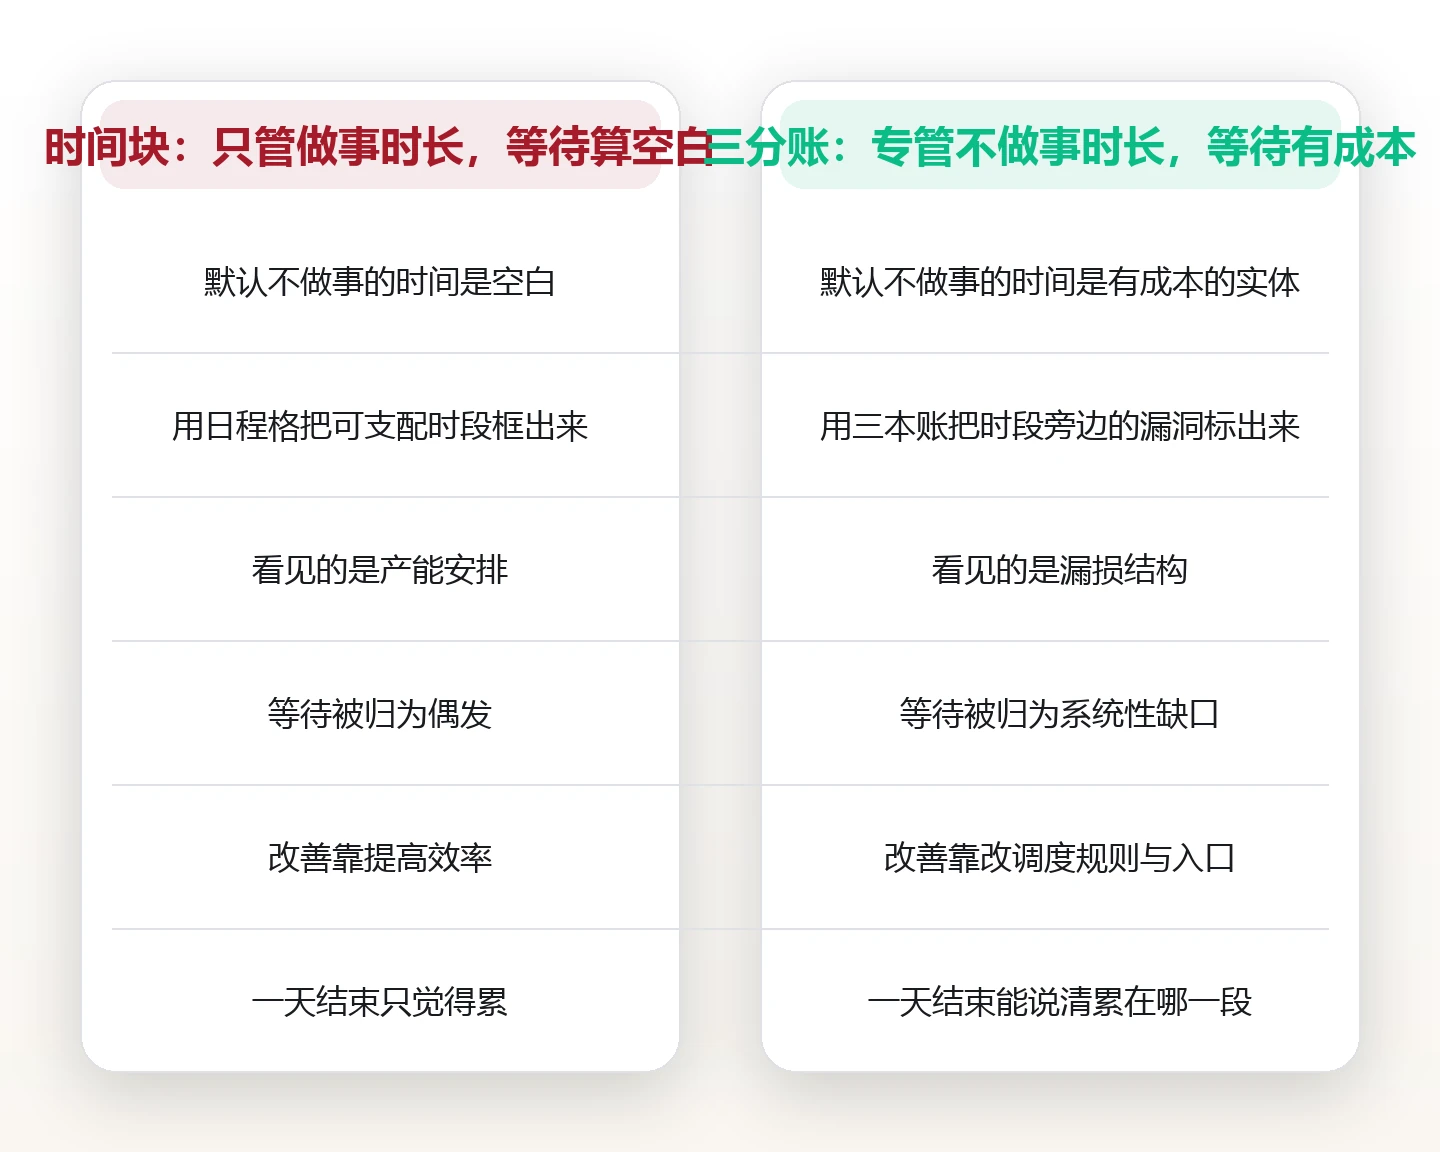
它与更常见的「时间块」方法差别在视角。时间块管的是「做事的那段时间怎么切」,默认不做事的时间是空白;三分账管的是「不做事的那段时间去了哪」,把空白当成有成本的实体。一个在安排产能,一个在堵漏。两者不冲突,但如果你已经能管住做事的时间,却仍觉得一天莫名其妙就过去了,缺的往往是后者。
一个可辨识的案例是迪士尼的排队系统。1999 年,迪士尼在旗下乐园推出快速通行券:游客在项目入口取一张指定时段的小票,到点再回来走专用通道。表面上是「帮你省掉排队」,实际上是一次等待的转移——物理队列里的时间被移走了,但它变成了一条新的约束:你必须在指定时段回到指定地点,一整天的行程被切成了碎片。2014 年这套系统升级为线上预约,2021 年又被新的预约体系替代。二十多年间规则换了几轮,等待的总量并没有消失,只是从「站着等」变成了「被时段牵着走」。这是理解等待的第一个要点:它能被转移,很难被消灭。
要判断自己一年被这三类等待拿走多少,看四个指标就够。第一是等待占比,即抽样日里三类等待合计时长除以清醒时长,经验刻度多落在一成到两成之间。第二是单次等待中位数,排队与加载各算一个,中位数比平均值更能说明日常体感。第三是可回收等待率,即那些「本可以并行做别的事」的等待占全部等待的比例。第四是上下文重建成本,即被打断后回到原任务所需的分钟数,这一项最难量化,却往往是最大的一笔。
一周的落地清单可以很短。周一挑三个固定时点做快照,每次只记一句话:刚才在等什么。周二把记下的条目按三本账归类。周三给每一条补一句「在等谁」。周四挑占比最高的那一本,只改一个动作。周五回看,把改动前后的等待分钟数写在同一行。不必精确,只要可比。
等待为什么不算浪费:它其实有三张不同的发票
很多人对等待不设防,是因为在心里把它记成了「没成本」。可等待从来不是免费的,它只是把账单开在了三个不同的户头上,而这三个户头都不在「工时」这一栏里。
第一张发票是注意力税。2008 年,格洛丽亚·马克等人在人际计算领域发表过一项被反复引用的观察研究:办公室职员在任务中被电话或邮件打断后,平均需要二十多分钟才能回到原来那件事上。这是一项观察性研究,个体差异很大,二十多分钟不能当标准答案;但它给出的量级很关键——打断的尾巴,比打断本身长得多。等待之所以收税,不在于那几十秒,而在于它把你从上下文里拽了出来。
第二张发票是情绪税。排队时人处于一种低强度的警觉状态:既不能走开,也无法投入。这种状态消耗的是「可支配的注意力余额」,而余额是有限的。所以一个上午排了三次队的人,下午往往连一封短邮件都写得艰难,不是懒,是余额已经被零散扣光。
第三张发票是机会税。等待把本可并行的动作强行串行化。等电梯的两分钟本可以回复一条确认消息,等页面加载的九十秒本可以读完一段材料,找钥匙的十分钟本可以让出门这件事整体提前。串行化本身不产生成本,叠加在「刚好卡在关键路径上」时才产生成本。
还有一层更隐蔽的:等待的成本在组织里没有归属人。你等审批,审批的人不觉得在让你等;系统慢,运维觉得那是网络问题。没有人为这段空白负责,于是它既不进预算,也不进复盘,只在每个人的体感里留下「今天很累但没做什么」的印象。时间审计要做的第一件事,就是给这段空白找一个记账的人——通常只能是你自己。
排队账:你等的往往不是前面的人,而是调度规则
排队这件事只有三个变量:到达的速度、服务的速度、队列的纪律。前两个你基本改不动,第三个常常可以。
先说利用率的陷阱。任何窗口如果被排到接近满载,等待就会指数级上涨,这不是管理不力,是数学。所以当你发现某个环节「平时还好,一到某个时段就崩」,不要急着怪人手不够,先看它是不是被排到了九成以上。解法通常不是加人,而是错峰:把可自主安排的事挪出高峰,让窗口留出两成余量。
再说队列纪律。多队列单窗口的设计,把「选错队」的风险转移给了排队的人:你站在这一队,隔壁那队忽然快了,你只能眼睁睁看着。叫号系统之所以让人舒服,不是因为它更快,而是因为它把「选队」这个决策从个人身上拿走了——你取号,坐下,等叫。同样的服务能力,体感差异可以很大。
预约制是第三种解法:把等待前移。代价是刚性——你必须按约到,晚到就作废。它适合那些「服务时间可预测」的事,不适合「随时可能被插单」的事。用错了地方,等待没有减少,只是从「当场等」变成「提前一周惦记」。
个人能做的改造很具体:把「必须现场等」的事,尽量换成「可预约、可远程确认、可并行处理」的事。去办事大厅先取号,然后坐下处理邮件,而不是站在队尾盯屏幕;能在线提交的材料不在窗口排队补;能把「等对方回复」和「写下一段」放在同一段时间里的,就不要分成两段。
加载账:进度条越顺滑,注意力越容易被收税
加载的时间通常很短,短到不值得记录,可它的破坏力不在时长,在「等待期间你会做什么」。
等待超过两三秒,人几乎一定会切走:切到另一个标签页,切到手机,切到一条推送。切走只要一秒,回来却要几分钟,因为你要重新找回刚才读到哪、想到哪。这就是加载账真正的计价方式——它不是按秒收费,是按「切换次数」收费。
加载还分冷热。冷启动是第一次打开某个页面或应用,要跑完整个请求链;热启动有缓存,几乎是瞬间。多数人的痛感来自冷启动,却误以为是自己「没耐心」。把常用入口固定下来、把资料提前存到本地、把需要在弱网下完成的操作挪到有稳定网络的一段,改的都是冷启动的次数,而不是网速。
这里有一条反常识:提高缓存命中带来的收益,往往大于换更快的网络。换网络改善的是传输速度,缓存消除的是往返次数;同样的带宽下,少一次往返省下的时间,常常比提速省下的更多。这也是「提前下载」这种土办法一直有效的原因。
也要留一条边界:不是所有加载都值得优化。低于一秒的等待去优化,收益小于你为此投入的注意力,还会让你养成「凡事都要顺畅」的预期,一旦遇到无法优化的等待就更烦躁。改造加载的目的是减少切换,不是追求零等待。
搜寻账:找东西的成本不在那两分钟,在重建上下文
搜寻分三种,成本结构完全不同,混在一起谈就会用错方法。
第一种是找物,找钥匙、找充电线、找那支笔。它的成本不在找的两分钟,在「找不到之后你开始的整理」——那往往是半小时。物理世界的搜寻有个特点:一旦开始找,就很难停在中途,因为放弃意味着承认丢了。
第二种是找文件。这一类的瓶颈几乎总在命名和目录。三个约定能解决八成问题:日期前缀让你按时间排序,对象名让你按事找人,版本号让你在三个「最终版」里认出哪个是最终。约定不必优雅,只要全组一致。目录结构同理,宁可浅而稳定,不要深而精巧——深目录的每一次点击都是一次加载。
第三种是找信息,也就是「我记得在哪看过」。这一类最贵,因为你要重建的不是位置,是当时的语境:那句话说在什么前提下,那组数据是谁给的,那个结论后来有没有被推翻。重建语境没有捷径,只有一条笨办法:看到值得留的东西,当场写下三行——它是什么、它能用在哪、它来自谁。三行字的成本是一分钟,省下的是将来的十分钟。
三种搜寻共用一个原则:单一入口。同一类东西只允许有一个「正确的存放处」,可以有副本,但只认一个主入口。入口一旦分裂成三个,搜寻成本就不是三倍,而是三倍乘以「你要先判断去哪个入口找」的那次犹豫。
最后是复位。每周留十五分钟,只做一件事:把这一周随手放下、没有归位的东西放回去。这十五分钟不产生任何产出,却能让下一周的搜寻账少掉一大截:它省的不是当下的效率,是未来的手忙脚乱。
三个反直觉:短等待最难记住,等待只会转移,省下的会被填满
关于等待,有三条与直觉相反的规律。不认这三条,前面的方法会用错方向。
第一,短等待最难被记住。三十秒乘以每天二十次,是十分钟;可没有人会在日记里写「今天等了二十次三十秒」。人的记忆按事件记账,不按累积记账,而短等待恰好是最碎的那一类事件。所以审计等待时,要按次数记,不要按时长记:先数次数,次数乘出来的总量往往吓人。
第二,等待可以被转移,很难被消灭。迪士尼的通行券已经说明过一次:队伍短了,约束多了。个人层面的转移同样如此——把现场排队换成线上预约,把等待加载换成提前下载,把翻找换成命名规范,每一次都只是把等待从「看得见的地方」挪到「看不见的地方」。转移本身是有价值的,前提是你知道它被挪到了哪,并接受那笔新成本。
第三,省下的等待会被重新填满。这就是帕金森定律的日常版本:工作会膨胀,直到填满可用的时间。你从排队里抠出二十分钟,如果没有预先指定这二十分钟给谁,它会自动被下一条短视频、下一次刷新、下一轮无目的浏览吃掉,而且你不会有任何「被偷走」的感觉。所以改造等待必须配一个动作:在省下时间之前,就把它指派给一件有名字的事。
还有一条补充的:越顺滑的等待越危险。加载动画做得越好看,进度条越有节奏,人就越能忍受,也就越不会去改造它。可忍受的等待不会消失,只会长期存在。真正该警惕的不是让人烦躁的等待,而是让人习惯的等待。
度量:把等待折成每周小时数的四个指标
没有度量,等待永远只是一个形容词。四个指标足够把它变成数字,而且都不需要工具,纸笔即可。
第一个是等待占比。算法是:抽样日里三类等待的合计时长,除以当天的清醒时长。经验刻度是一成到两成,超过两成说明你的日程结构里有系统性缺口,不是偶发。这个数字不需要天天算,一个月算两次即可看出趋势。
第二个是单次等待中位数。排队和加载各算一个,取中位数而不取平均值,因为平均值会被一两次极端的长等待拉高,掩盖日常体感。中位数告诉你「典型的一次等待有多长」,而这个数才决定你会不会切走。
第三个是可回收等待率。定义是:在全部等待里,有多少比例是「本来可以并行做别的事」的。同样是每天四十分钟等待,全部发生在电梯口和收银台,可回收率可能只有两成;全部发生在等文件传输和等回复,可回收率可能到七成。前者要改结构,后者只要改习惯。
第四个是上下文重建成本。做法很土:被打断时看一眼时间,回到原任务、重新想起「我刚才要干什么」时再看一眼,差值就是这一次的重建成本。不用每次都记,一天记三次,一周就能估出自己的中位数。多数人的估算是五分钟上下,而这五分钟每天要发生十几次。
抽样方法也要说清:连续五天,每天三个固定时点——上午开始工作后一小时、午饭后、下班前一小时。每次只记三列:在等什么、等了多久、在等谁。五分钟填完,不追求精确到秒。五天后把三列摊开,横着是三本账,竖着是五天,缺口一眼就能看见。
最后一条纪律:宁可粗而连续,不要细而中断。精确度的边际收益很低,连续性的边际收益很高:用「大概三分钟」记满五天,胜过用秒表记两天然后放弃。
三类场景各盯一处:个人、团队与家庭的不同用法
三本账是同一套账,但不同身份要盯的位置不同。盯错位置,努力会全部落在不产生杠杆的地方。
个人要盯加载账。个人的时间结构最碎,最容易被「顺手点开、等两秒、切走」这一串动作切碎,而这类动作几乎全部发生在加载窗口里。有效的做法不是提升意志力,而是减少需要加载的次数:常用页面固定入口,资料提前存本地,需要读的长文一次性下载。
团队要盯排队账。团队里的等待极少来自个人偷懒,绝大多数来自审批链和交接点:一份材料要过三个人,每个人都说「我看看」,加起来就是三天。判断方法很简单:找出那个「只有一个人能批、且他手上永远有更急的事」的环节,那里通常躺着团队最大的一笔等待。解法是给这个环节设时限,而不是催人。
家庭要盯搜寻账,兼一点排队账。家庭事务的等待往往藏在出门前的十分钟里:找钥匙、找卡、找那双鞋。它的特点是集中爆发、全员参与、情绪浓度高。有效的改造是把「找」变成「放」——给钥匙、卡、常用包各定一个固定位置,且这个位置必须在门口动线上。规则一旦成立,出门前的十分钟可以稳定压缩到三分钟。
三种身份有一个共同点:都要在规则层改,而不是在意志层硬扛。意志层能撑三天,规则层能撑三年。时间审计真正的产出,不是一张更精确的表,而是几条被改掉的规则。
一周落地:记录、分账、归因、改造、复核
方法再多,落到一周只需要五个动作,每天一个,不叠加。
周一记录。挑三个时点做快照,每次一句话。不要试图记录全部,也不要试图记录准确,只要「有记录」这件事成立。这一步的唯一目标是打破「我没在等」的错觉。
周二分账。把周一的条目按排队、加载、搜寻归到三本账里。归类有争议的条目不要纠结,选一个然后继续——分类的价值在于形成对比,不在于绝对正确。
周三归因。给每一条补一句「在等谁」:等某个人的回复、等某个系统的响应、等自己的记忆。归到「人」的,去改流程;归到「机器」的,去改预取;归到「自己」的,去改命名与归位习惯。三种归因对应三种完全不同的解法,混着改一定失败。
周四改造。只挑占比最高的那一本账,只改一个动作。比如只做「常用入口固定」这一件事,或者只做「文件命名加日期前缀」这一件事。改一个,才有办法判断有没有用。
周五复核。回答三个问题:这周的三本账,哪一本变了?改的那个动作,省下的时间是几分钟?省下的那几分钟,最后去了哪?第三个问题最容易被跳过,却决定改造能否留住。
最后提醒一句:一周之后不要立刻扩大范围。等这套动作不需要提醒就会做,再去改第二本账。等待是结构性的,改结构急不得。
常见问题
1.问:三类等待里,我应该先改哪一类?答:先看可回收等待率。三类里可回收率最高、且改动成本最低的那一类,就是起点。多数人的答案是加载账,因为它只需要固定几个入口、提前下载几次,当天就能见效;排队账往往涉及别人,改起来慢;搜寻账需要长期养成习惯,见效最晚。
2.问:每天只有十几分钟等待,也值得记录吗?答:值得,但要按次数记而不是按时长记。十几分钟摊成二十次三十秒,单次都不足以让你重视,累积起来却相当于每年少掉好几天。记录的真正作用不是算出总量,而是让你看见「原来一天要被打断这么多次」。
3.问:把等待改成预约制,是不是就一定更好?答:不一定。预约制把等待前移,代价是刚性,你必须按约到,晚到就作废。判断标准是这件事的服务时间是否可预测:可预测的适合预约,随时可能被插单的适合现场取号加并行处理。用错地方,等待没有减少,只是从当场等变成提前一周惦记。
4.问:省下的时间总是又被填满,怎么办?答:在省下之前就指定接收人。具体做法是提前写好一句话:「这二十分钟用于写某某材料的第二段」。有了名字,它才不会被默认选项吃掉;没有名字,它一定会被最省力的那个动作接管。
5.问:这套方法和番茄钟、时间块冲突吗?答:不冲突,管的是两件事。时间块管做事的时间怎么切,三分账管不做事的时间去了哪。可以先用时间块把可支配的时段框出来,再用三分账去堵这些时段旁边的漏洞。两者的共同前提是一样的:先把时间当成有成本的资源,而不是当成背景。
图片来源:图1 高捷 / Pixabay (CC0) · 图2 mattiaverga / Pixabay (CC0) · 图3 LoboStudioHamburg / Pixabay (CC0) · 图4 xiSerge / Pixabay (CC0) · 图5 jarmoluk / Pixabay (CC0) · 图6 4262159 / Pixabay (CC0) · 图7 terski / Pixabay (CC0) · 图8 Felix-Mittermeier / Pixabay (CC0) · 图9 Kranich17 / Pixabay (CC0) · 图10 Sumo_img / Pixabay (CC0) · 图11 fotshot / Pixabay (CC0) · 图12 ValterM / Pixabay (CC0) · 图13 ahmetyuksek / Pixabay (CC0) · 图14 JonPauling / Pixabay (CC0) · 图15 mattiaverga / Pixabay (CC0) · 图16 katerinavulcova / Pixabay (CC0) · 图17 Alexas_Fotos / Pixabay (CC0) · 图18 Monoar_CGI_Artist / Pixabay (CC0) · 图19 KELLEPICS / Pixabay (CC0) · 图20 reallywellmadedesks / Pixabay (CC0)
本文为时间管理与生活方式信息分享,仅供一般参考,不构成任何专业建议。
本文为信息分享与财商教育,不构成任何证券、期货或投资咨询建议,亦不构成个性化投资建议。市场有风险,决策需谨慎。
本文由 AI 生成,经人类主编终审。
评论(0)