基本信息
阅读时间:约 12 分钟
字数:约 4821 字
摘要:判断出错不可怕,可怕的是不修正。本文用贝叶斯与概率权重函数,教你把新证据折算成可比较的概率。
全文语音
中文
English
日本語
한국어
专业分析
上个月我帮一位做跨境电商的朋友复盘他连亏三单的判断。他当初说“供应商样品合格率99%,翻车概率不到1%”,于是把一半现金流压在一家长尾工厂。结果三个月里两次大批次次品,直接吃掉全年利润。坐在我对面他说了句让我记到现在的话:“我以为1%就是几乎不会发生。”这句话里藏着的,正是概率权重扭曲——我们大脑把极端概率偷偷换算成了一个和真实数值差很远的内部权重。
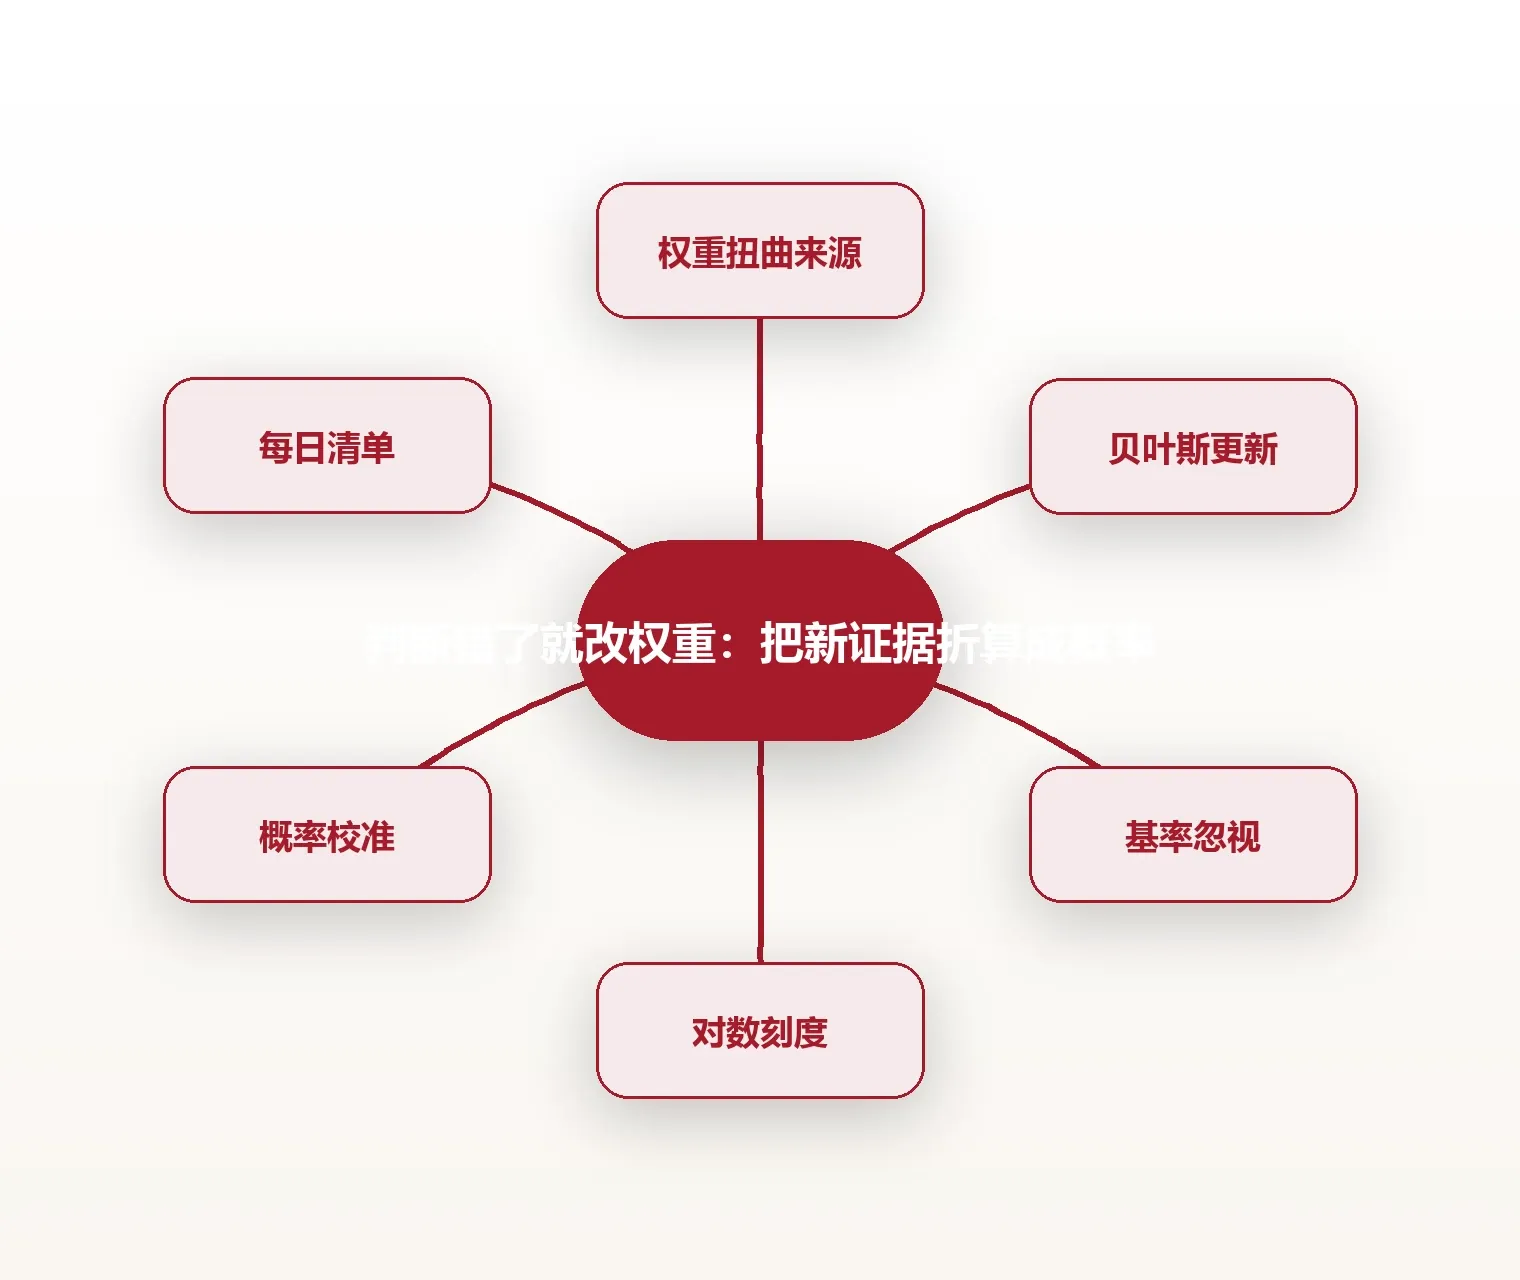
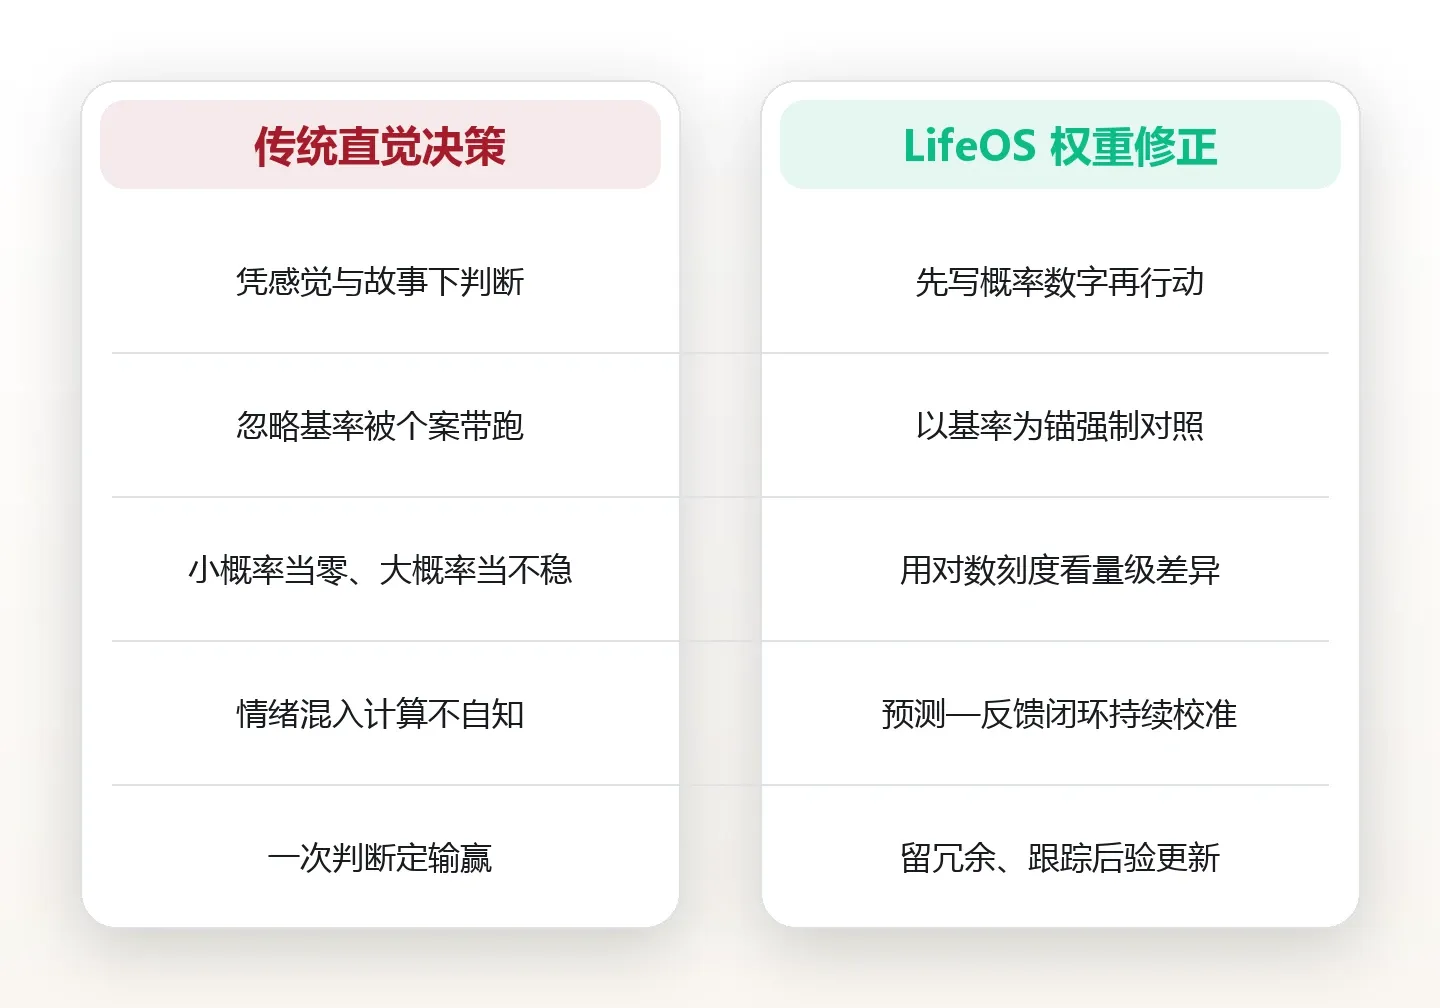
行为经济学对这种现象有过扎实的量化。Kahneman 与 Tversky 在 1979 年提出前景理论,后来在 1992 年的累积前景理论里给出了一个具体的“概率权重函数”:w(p)=p^γ/(p^γ+(1-p)^γ)^(1/γ)。通过对 10 组实验(含 1999 年 Gonzalez & Wu 的 11 个实验池化估计)的拟合,参数 γ 的共识取值约为 0.61。把这个公式代进去会得到一个惊人的结果:一个真实概率为 1% 的事件,在人的主观权重里被放大到约 5.5%;而一个真实概率为 90% 的事件,主观权重反而被压低到约 72%。也就是说,我们系统性地“高估小概率、低估大概率”。
在修正方法上,最可靠的工具是贝叶斯定理,它和另一种常见直觉——“代表性启发式”——形成了鲜明对比。代表性启发式会让你看到一个大眼睛、爱读书的人,就立刻判断他是图书管理员,完全无视“图书管理员在人群里占比不到 0.5%”这个基率。贝叶斯更新则强制你先写下先验概率,再乘以新证据的似然比,最后算后验。两者的差异不是风格问题:在一次经典的“律师/工程师”实验中(Kahneman & Tversky 1973,被试 140 人),当给出 70/30 的基率、又附上一段中性描述时,被试的预测落回了约 50/50,等于把基率几乎丢弃;而严格按贝叶斯计算,答案应紧贴 70/30。
一个真实可辨识的案例发生在 2007—2008 年的次贷危机。当时评级机构给大量次级抵押贷款支持证券(MBS)的优先档贴上 AAA,模型隐含的年违约概率被标成 0.01%—0.1% 量级,市场据此把这类资产当成接近无风险。但 IMF 与 S&P 后续的复盘数据显示,部分优先档的实际累计违约率在危机高峰达到了 6%—8%。这里同时存在两种扭曲:一边把“极小概率”在主观权重里压到近乎零(于是敢加杠杆),一边又过度信任评级标签这个“权威证据”。一次权重计算失误,放大成全球性金融海啸。
要把这种扭曲量化地管起来,最实用的度量指标是 Brier 分数(Brier Score)。它的算法是:你对每个事件给出 0—1 的概率,事件发生后记 1 或 0,再算 B=(你的预测-实际结果)²。分数越低越准,完美是 0,瞎猜均值约 0.25,乱猜二分类是 0.5。Tetlock 在“Good Judgment Project”(2011—2015,约 2800 名预测者、追踪两年)中发现,经系统训练的“超级预测者”群体 Brier 分数能做到约 0.25,而普通对照组在 0.37 上下。差距看似不大,但跨上千次押注会拉开巨大的决策质量差。
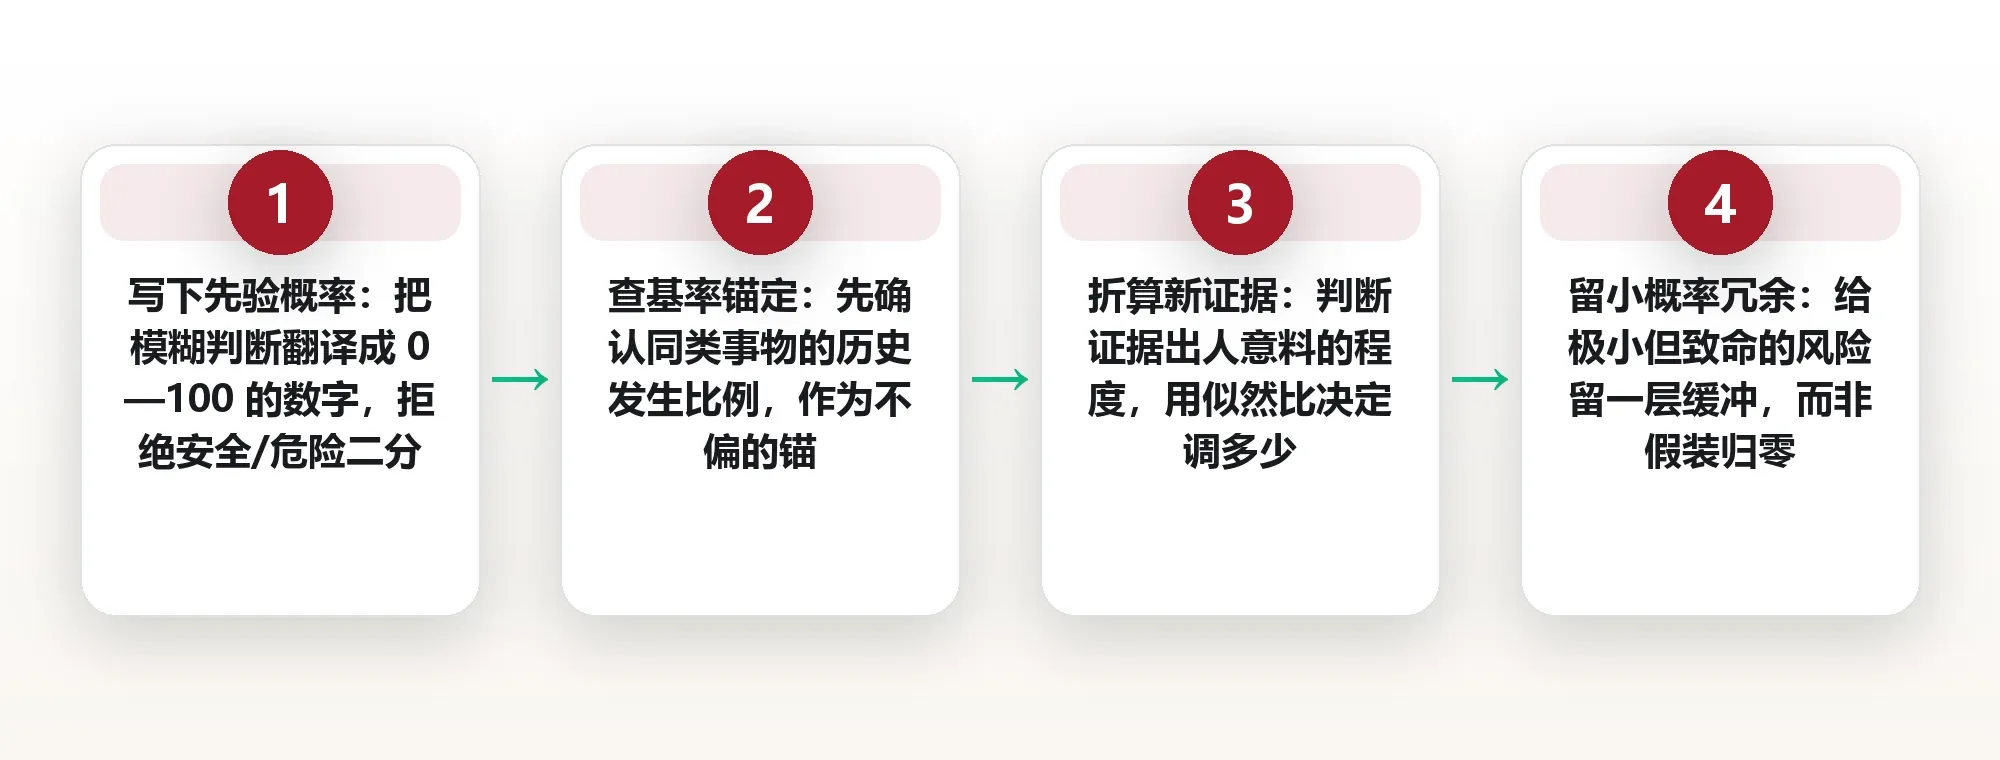
落到日常,我给自己定了一套可执行的修正清单,你也可以照搬:第一,任何“肯定/绝不”类表述先折算成数字,例如把“几乎不可能”写成 ≤1%;第二,遇到新证据先问“这会改我的先验多少”,用一句话写下前后概率;第三,凡涉及风险,先查基率(同群体历史发生比例)再下判断;第四,每周复盘一次自己的预测命中率,用 Brier 分数给自己打分;第五,对极小/极大概率的事,刻意反向加一层“万一我错了”的压力。把这五条贴在决策前,你会发现很多冲动判断在第二步就被拦下。
我为什么总把小概率当成不会发生
还是说回我那位朋友。他不是不聪明,反而是我们圈子里算账最细的人。问题在于,他脑子里没有“1%”这个刻度,只有“安全”和“危险”两个桶。一旦某件事被他归进“安全桶”,后面再出现多少警示信号,他都选择性忽略。这不是他一个人的毛病,是大脑的默认出厂设置。
心理学上管这叫“零风险偏差”的一种变体:人对“概率从 1% 降到 0”的满足感,远大于“从 30% 降到 10%”。所以商家卖保险、卖延保、卖各种“安心服务”,永远在暗示你“彻底杜绝风险”,而从不跟你谈真实的百分比。你付出的溢价,买到的往往是心理上的“归零”,而不是数学上的“降低”。
另一头是“确定性效应”:一个 100% 拿到 100 块,和一个 90% 拿到 110 块,多数人选前者,哪怕数学期望更低。我们的权重函数在概率接近 1 时会急剧上翘——觉得“九成把握”还不够稳,非要到“板上钉钉”才肯动。结果就是:该出手时犹豫,该收手时因为“都 99% 安全了”而放松警惕。
我后来给自己立了个规矩:凡是听到“绝对”“肯定”“从来不会”这种词,先在旁边写“概率=95%,留 5% 给黑天鹅”。这个动作很笨,但有效。它把模糊的安全感拽回数字世界,让权重扭曲无处藏身。你也试试,下次有人跟你说“这项目稳了”,别急着信,先问一句:你说的稳,是百分之多少的稳?
权重扭曲的三个来源
想把权重改对,先得知道它从哪里歪的。我把它归纳成三个最常见的来源,理解它们,你才能在扭曲发生的那一刻认出它。
第一个来源是“可得性启发式”:我们凭一件事好不好回忆来估概率。飞机出事新闻铺天盖地,你就觉得坐飞机比开车危险,但世卫组织的数据显示,每十亿客公里死亡率,自驾约为民航的约 100 倍。新闻的可视度,不等于风险的实际量级。你脑子里“容易想起来的坏事”,权重被悄悄调高了。
第二个来源是“代表性启发式”,前面在贝叶斯那段提过。它让你被一个生动的细节带着走,忘了大背景。比如看到一个人说话严谨、戴眼镜、喜欢古典乐,你就猜他是大学教授,却没去想大学教授在总人口里占比不到 0.3%。一个具体故事,压垮了一组冷冰冰但更可靠的数字。
第三个来源是“情绪放大”:害怕和渴望都会改权重。恐飞的人在 turbulence 时心跳 140,那一刻他给“要出事”的权重,比落地后冷静时高出一个数量级。同样,沉迷某支股票的人,会把“涨回本”的主观概率从 20% 一路抬到 80%。情绪不是信息,但它伪装成信息混进了你的计算。
识别这三样,靠的不是更聪明,而是更慢。我现在的做法是:每当一个判断带着强烈画面感、强烈情绪、或强烈故事性出现,就强制按下暂停键,反问自己——这个权重,是我算出来的,还是被这些信息“喂”出来的?这一问,常常就够了。
贝叶斯更新:把新证据折算成一个可比较的数
贝叶斯定理听起来吓人,写成公式 P(后验)=P(先验)×P(证据|假设)/P(证据),很多人就划走了。但你不需要会推公式,只需要记住它的精神:新证据的价值,取决于它“有多出人意料”。一条所有人都预料之中的消息,不该改变你的判断;一条反转预期的消息,才值得大幅调权重。
举个我能天天用上的例子。假设你想判断“这家新供应商靠谱吗”,先验先给 70%(行业里新供应商头年存活并履约的比例大致如此)。现在拿到一份第三方质检报告,显示样品合格。问题来了:如果靠谱和不太靠谱的厂都能拿出合格样品,这份证据“出人意料”的程度就低,后验只该微调到 72%。可现实中我们常把它当成“直接变成 99% 靠谱”,这就是没做似然比折算。
反过来,如果来了一条反常证据——比如该供应商的其中一批货被海关抽检出重金属超标,而“靠谱厂出这种事”的概率只有 2%,“不靠谱厂”有 30%。用似然比 2%/30%≈0.067 一乘,先验 70% 会被狠狠拉低到约 8%。贝叶斯的可贵之处,是它给了你一个“该改多少”的客观上限,而不是让你凭心情从 70% 跳到“再也不合作”。
我把它简化成一张便利贴贴在显示器边:先验写在左,新证据写在右,中间问“这证据有多反常”。反常就大改,平常就小改,完全在预料中就别改。坚持一个月,你会发现自己越来越少被单条新闻或单句话带着跑,因为你的权重调整有了“制动阀”。
别被一个故事带跑:基率的重要性
基率就是“在没有任何额外信息时,这件事本来发生的概率”。它通常很无聊,所以最容易被忽略。但无数决策翻车,恰恰翻在忘了先看基率。
医学上有一个经典警示:某种罕见病在人群中的发病率是 0.1%,一种检测的准确率是 99%(即患病者 99% 阳性、健康者 99% 阴性)。如果你检测呈阳性,直觉会说“我有 99% 可能患病”。但用贝叶斯一算:100 万人里 1000 人真患病、其中约 990 人阳性;999000 健康人里约 9990 人假阳性。阳性者中真正患病的比例是 990/(990+9990)≈9%。也就是说,你的真实风险不是 99%,而是约 9%。忽略基率,你会把自己吓进医院。
投资里同理。一个朋友神秘兮兮跟你说“我有个内部消息,这只票必涨”,你一激动就重仓。但你没问基率:A 股里靠“内部消息”交易最终亏损的散户比例超过 70%(多项散户行为研究的一致结论)。哪怕这条消息本身有 60% 的胜率,叠加“消息贩子整体不靠谱”的基率后,你的期望收益可能已经是负的。故事越动听,越要回头看基率。
我给自己定的铁律是:任何判断前,先逼自己说出“这件事的基率大概是多少”。说不出,就先去查,查不到就用“同类事物的历史平均”顶上。基率是一根锚,没有它,你的权重会像风筝一样被每一个新故事拽着乱飞。
用对数刻度重新看概率
人对概率的直觉是“线性”的,但真实世界的风险往往是指数级的。1% 和 2% 看着只差一倍,可在复利和连锁失效的情境下,差距会被放大到难以承受。把概率换成对数刻度来看,是纠正权重扭曲的一剂良药。
对数刻度的核心,是关注“概率之间的倍数”而非“数值之差”。从 10% 降到 1%,是除以 10;从 1% 降到 0.1%,也是除以 10。前者你感觉“只降了 9 个点”,后者你感觉“都快归零了”,但对风险敞口而言,两次都是量级压缩十倍,重要性相同。当我们用线性脑去比较,就会在第一个 9 个点上过度反应,在第二个 0.9 个点上过度安心。
一个实用技巧:把概率取对数后,再谈“几个数量级”。比如某设备故障率从 10^-2 降到 10^-4,别说是“降了 0.99%”,而说“降了两个数量级”——这通常对应安全等级的根本性跃迁,而非微不足道的改进。核电、航空、医疗这类领域的冗余设计,本质都是在和对数尺度上消灭那最后的一两个数量级。
我把手机里一个备忘录命名为“数量级”,每次评估风险就写:当前概率=10 的几次幂,目标=10 的几次幂。当两个数的差≥2,我就知道这是值得专门投入资源去压的方向;差≤0.5,多半是过度操心。对数视角让我从“数字纠结”里解脱,直接看量级,效率反而更高。
概率校准:像运动员一样训练判断
权重扭曲不是靠懂了理论就能好的,它像肌肉一样需要练。心理学家把这件事叫“概率校准”——让你说出的概率,和真实发生的频率对得上。一个校准良好的人说“70% 会下雨”,历史上他这么说过一百次,大概就有七十次真的下了。
训练方法极其简单:每天对三件会出结果的小事给出概率,比如“今天会收到客户回信”“健身能坚持完”“这趟地铁不迟到”,然后记录实际结果。两周后回看,如果你的“80%”实际只中了 50%,说明你系统性地高估了自己的把握——这正是权重扭曲的体温计。
Tetlock 的“Good Judgment Project”证明,校准是可以被刻意练出来的,而且有可迁移性:那些在每周做预测、并收到反馈的人,跨领域的判断精度都随之上升。关键不在天赋,在于“预测—反馈—修正”这个闭环跑得够不够勤。超级预测者平均每周花数小时复盘,而不是凭直觉一拍脑袋。
我的做法是建一个只有自己看的表格,列三列:预测、概率、结果。每月算一次自己的 Brier 分数。当我看到分数从 0.4 慢慢滑到 0.3,那种踏实感比任何“我感觉我变聪明了”都可靠。校准训练最迷人的地方在于:它把“我好像判断力强了”这种虚的感觉,变成了可以画曲线的真实进步。
一份能贴墙的每日修正清单
前面讲的都是原理,真正改变行为的,是一张能每天照着做的清单。我把它打印出来贴在工位,名字就叫“改权重五问”。
第一问:我现在的判断,对应的概率数字是多少?把“应该行”“不太可能”全部翻译成 0—100 的数值,模糊词是权重扭曲的温床。第二问:这个数字里,有几成是我算出来的,有几成是听来的故事和情绪?把后者圈出来,提醒自己打折。
第三问:这件事的基率是多少?如果答不上来,今天先不拍板。第四问:刚冒出来的新证据,有多出人意料?寻常就小改,反常才大改,别被一条热搜掀翻整盘。第五问:如果我是错的,最坏会怎样、我扛不扛得住?给小概率留一点敬畏,而不是假装它不存在。
这五问我一般花三分钟。但它帮我拦下过好几次冲动消费、草率合作和情绪化发言。清单的价值不在于多聪明,而在于它把“慢一点”制度化了。你也可以在手机便签里存一份,关键决策前默念一遍——等到它变成肌肉记忆,权重扭曲就很难再偷袭你。
顺带说一句,清单要常更常新。我每季度回看一次,把那段时间里“我以为 1% 结果真发生了”的案例补进去,当作反面教材。这些真实踩过的坑,比任何教科书都更能校准你下一次的权重。
把权重修正用进三类日常决策
理论再好,落不到生活里就是装饰。我把概率权重修正塞进了三类最高频的决策,效果最明显。
第一类是消费决策。面对“买延保吗”“加购碎屏险吗”,以前我靠感觉,现在先算期望值:商品价格 5000,碎屏概率约 8%(行业维修数据),期望损失 400;保险卖 600,还不含免赔条款——明显不划算,于是一键跳过。把“安心”翻译成数字,省下的钱很可观。
第二类是职业与投资。接到一个新机会,我先写先验:成功概率多少(参考同类人历史),再逐条叠加证据调权重,而不是被对方描绘的愿景带着走。去年我推掉一个“稳赚”的项目,正是因为用基率一算,同类模式的失败率超过 60%,所谓稳赚只是话术。错过是遗憾,但避开大坑是实在的。
第三类是健康与风险。体检报告上一个“结节,恶性概率约 2%”,我不再自己吓自己到失眠,也不装作没看见,而是按贝叶斯跟踪:复查、影像、活检逐级更新概率,让每一步的权重都有依据。理性地给小概率留位置,反而让我更从容。
这三类的共通点,是都要求你“先有数字,再有行动”。一旦养成这个顺序,你会发现很多焦虑来自“没算清就上头”,而很多后悔来自“算清了却没听”。权重修正不是让你变冷漠,是让你在热情和恐惧之间,多垫一层清醒的数字。
常见问题
1.问:概率权重修正和普通“多想一下”有什么区别?答:多想一下往往只是延长情绪纠结,权重修正要求你把模糊感觉翻译成具体概率,并用基率、似然比等客观量去调整。前者是原地转圈,后者是往前走一步。
2.问:我没有数学基础,也能用贝叶斯吗?答:完全可以。你只需要记住三件事:先写先验数字、判断新证据有多反常、反常就大改平常就小改。不必会推公式,把这条流程变成习惯,就够用了。
3.问:每天做概率预测会不会让人变得优柔寡断?答:恰恰相反。校准训练会缩短你的决策时间,因为它把“纠结”提前变成了“打分”。当你的概率和现实对得上,你会更敢在高位概率上果断出手。
4.问:小概率事件真的需要每次都防吗?答:不需要,也没必要。修正的目标不是消灭所有风险,而是让投入和真实概率匹配。对极小但后果致命的事留一层冗余即可,对多数小概率则接受它的存在。
5.问:怎么判断自己的权重扭曲有没有改善?答:建一个预测记录表,每月算一次 Brier 分数。当这个分数从偏高逐步降到 0.25 附近,说明你的主观权重正在靠近真实概率,扭曲在收窄。
图片来源:图1 AS_Photography / Pixabay (CC0) · 图2 DarkoStojanovic / Pixabay (CC0) · 图3 Leonhard_Niederwimmer / Pixabay (CC0) · 图4 pixel2013 / Pixabay (CC0) · 图5 wal_172619 / Pixabay (CC0) · 图6 Alexas_Fotos / Pixabay (CC0) · 图7 Kookay / Pixabay (CC0) · 图8 mattiaverga / Pixabay (CC0) · 图9 Alexandra_Koch / Pixabay (CC0) · 图10 Nennieinszweidrei / Pixabay (CC0) · 图11 PavanPrasad_IND / Pixabay (CC0) · 图12 Sekau67 / Pixabay (CC0) · 图13 pixel2013 / Pixabay (CC0) · 图14 AJEL / Pixabay (CC0) · 图15 congerdesign / Pixabay (CC0) · 图16 stevepb / Pixabay (CC0) · 图17 Silvo / Pixabay (CC0) · 图18 tphananh / Pixabay (CC0) · 图19 KELLEPICS / Pixabay (CC0) · 图20 xusenru / Pixabay (CC0)
本文为信息分享与方法论科普,不构成任何专业建议,请结合自身情况判断。
本文由 AI 生成,经人类主编终审。
评论(0)