基本信息
阅读时间:约 15 分钟
字数:约 5841 字
摘要:知识库变垃圾场,不是因为整理得少,而是因为什么都存。用未来会不会用、能不能复述、有没有出处这三道门槛做收录判断,配可执行判据与每周二十分钟的清理动作。
全文语音
中文
English
日本語
한국어
凌晨三点,我在自己的知识库里迷了路
上周三凌晨三点,我为了追一句半年前读到的引文,在自己那个收藏了七千多条内容的知识库里翻了整整两个小时。屏幕的冷光把天花板照成一块脏掉的幕布,我一条条往下滑,标题都眼熟,内容全陌生。最后我把电脑合上,重新去搜索引擎里把那句话找了回来——它明明就在我的库里躺着,我却找不到它。
那一刻我承认了一件不太体面的事:这个库不是知识库,它是一个囤积症的仓库。七千多条里,有六千多条从存进去的那天起,我再也没有打开过第二次。它们霸占了每一次搜索的前几页,把真正有用的那几百条埋到了最底下,像衣柜里过季的衣服把当季的全压住了。
我后来跟一个做内容的朋友聊到这个,她说她的库更夸张,一万两千条,标签建了两百多个,最后她自己都不敢往里存东西了,因为「存进去就等于失踪」。我们笑完之后都沉默了一会儿。收藏这个动作太便宜了,便宜到我们习惯用它来代替思考。
于是我花了一个周末,把七千多条一条条过了一遍,删掉五千三百多条,剩下的用三道门槛重新筛了一次,最后留下一千一百四十条。我现在想讲的就是这三道门槛——它们不解决「怎么整理」,只解决一个更前置也更致命的事:什么才值得存。存错了,后面所有的整理都是在给垃圾做收纳。
收藏是一种廉价的自我安慰
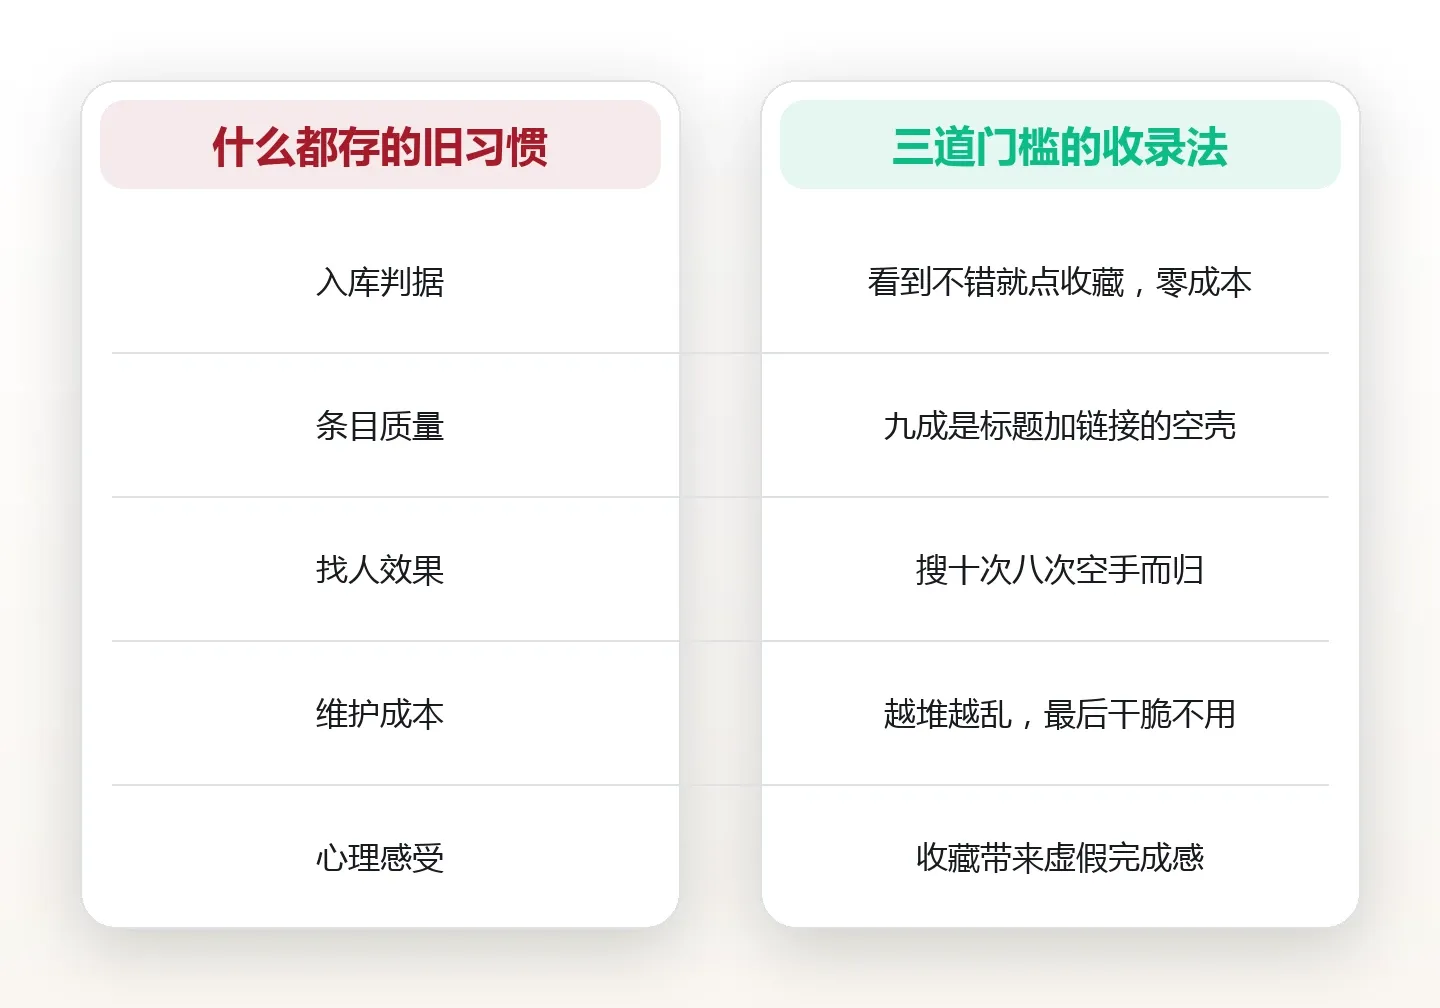
先说说为什么我们会什么都存。心理学里有个现象叫信息囤积,和物品囤积同源:我们把占有误当成了掌握。按下收藏键的那零点几秒,大脑会分泌一种轻微的完成感,很像把一件事从清单上划掉。但划掉的只是动作,事情本身一步都没往前走。
更隐蔽的一层是,收藏替我们承担了焦虑。看到一篇讲复利的好文章,你心里会闪过一句「这个以后要用」,于是存下来,焦虑立刻平息。存完之后你并不读,但那个「以后要用」的承诺还挂在库里,像一张永远不会被催的欠条。库越大,欠条越多,而欠条不会自己兑现。
我在自己的库里做过一次粗略统计:七千三百二十一条记录里,带完整笔记的只有四百一十条,占百分之五点六;剩下九成以上都是「标题加链接」的空壳。空壳的杀伤力在于它看起来像知识,实际只是一串字符。你以为自己拥有一座图书馆,其实你拥有的是一份书目。
这里要说清一个区分:收藏是采集,知识库是加工。采集可以无限,加工必然有限。把无限的东西塞进一个有限的容器,唯一的结局就是容器失效。所以我后来给自己立了一条很土的原则——没有被加工过的东西,不配进库。
还有一层代价很少被提起:囤积会让搜索变成一个惩罚。你每次想找东西,都要先穿过自己制造的噪音。找十次有八次空手而归之后,人就会下意识地绕开这个库,最后库存仍在增长,使用却已经归零。一个不被打开的库,比没有库更糟,因为它还持续消耗你的信任。
第一道门槛:未来会不会用
第一道门槛问的是时间维度:这条内容在未来半年里,我有没有具体的使用场景?注意是「具体」,不是「大概」。具体的场景能说出时间、场合、动作,比如「下个月做季度复盘时,用这个四象限拆一下上季度的三个失误」。说不出来的,就是模糊,模糊就等于没有。
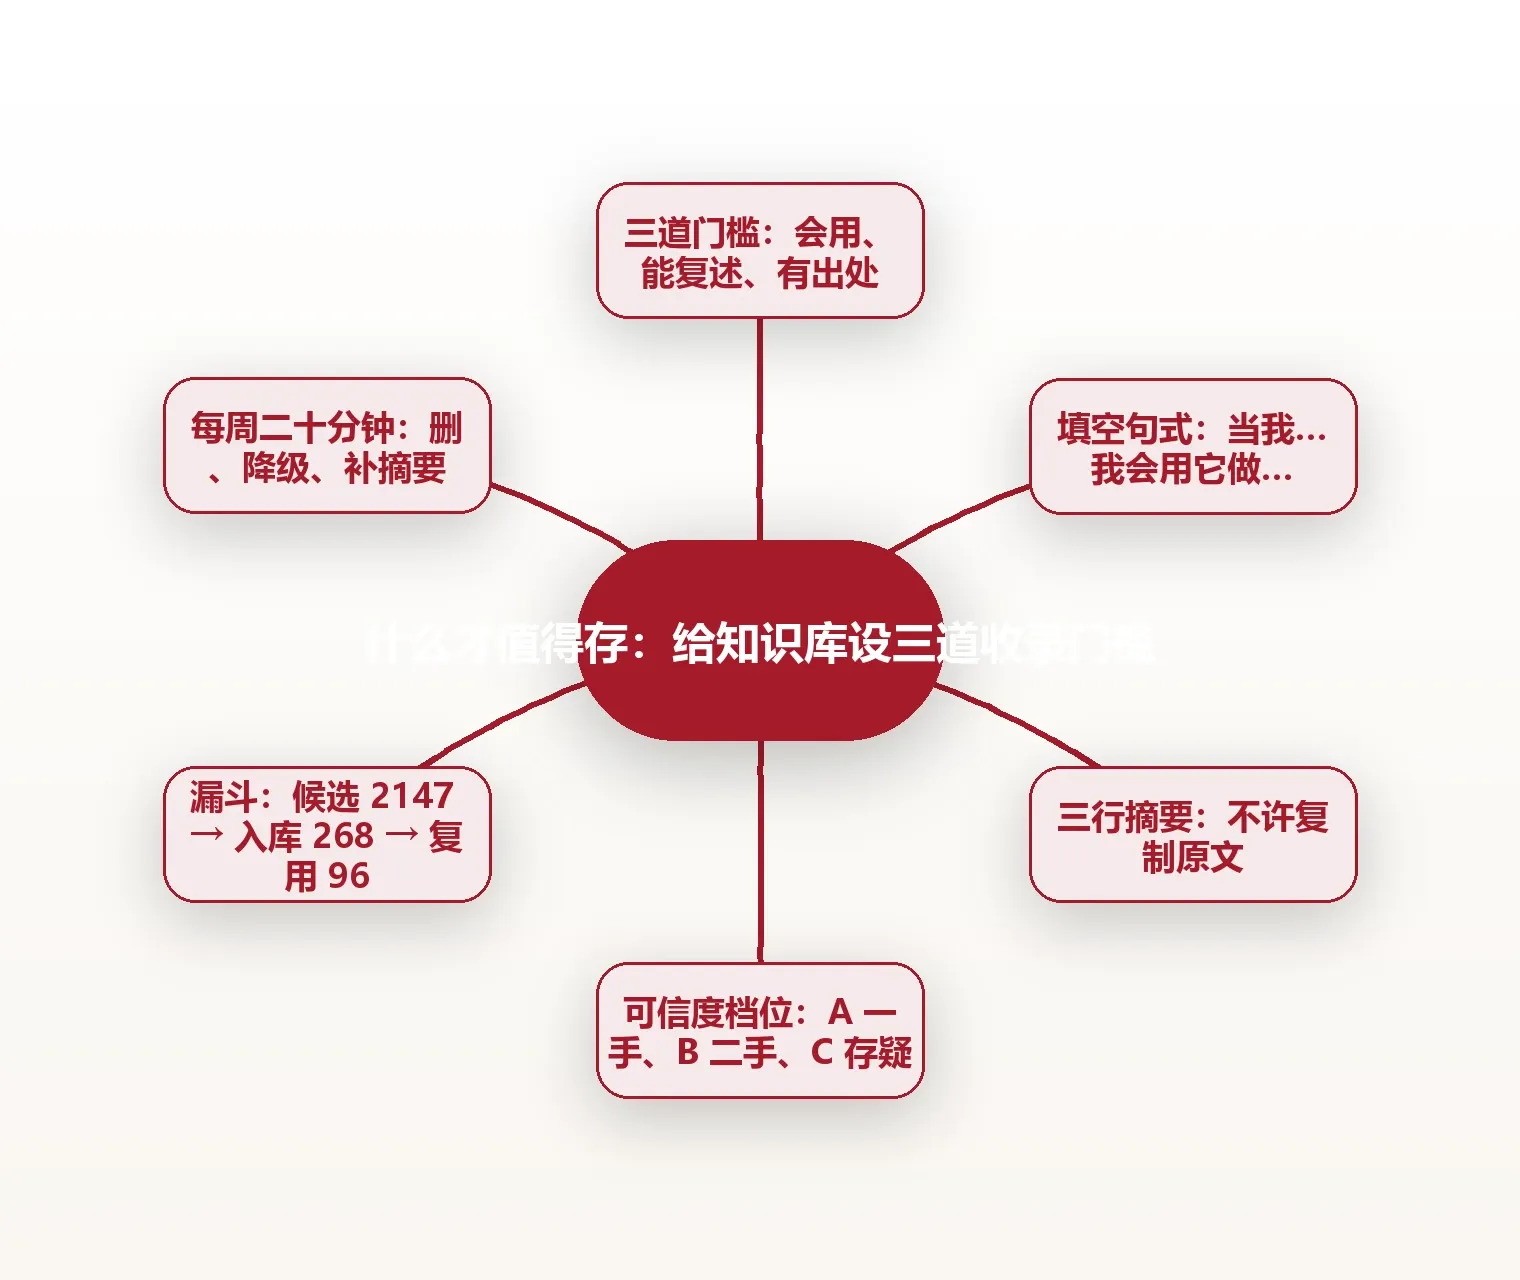
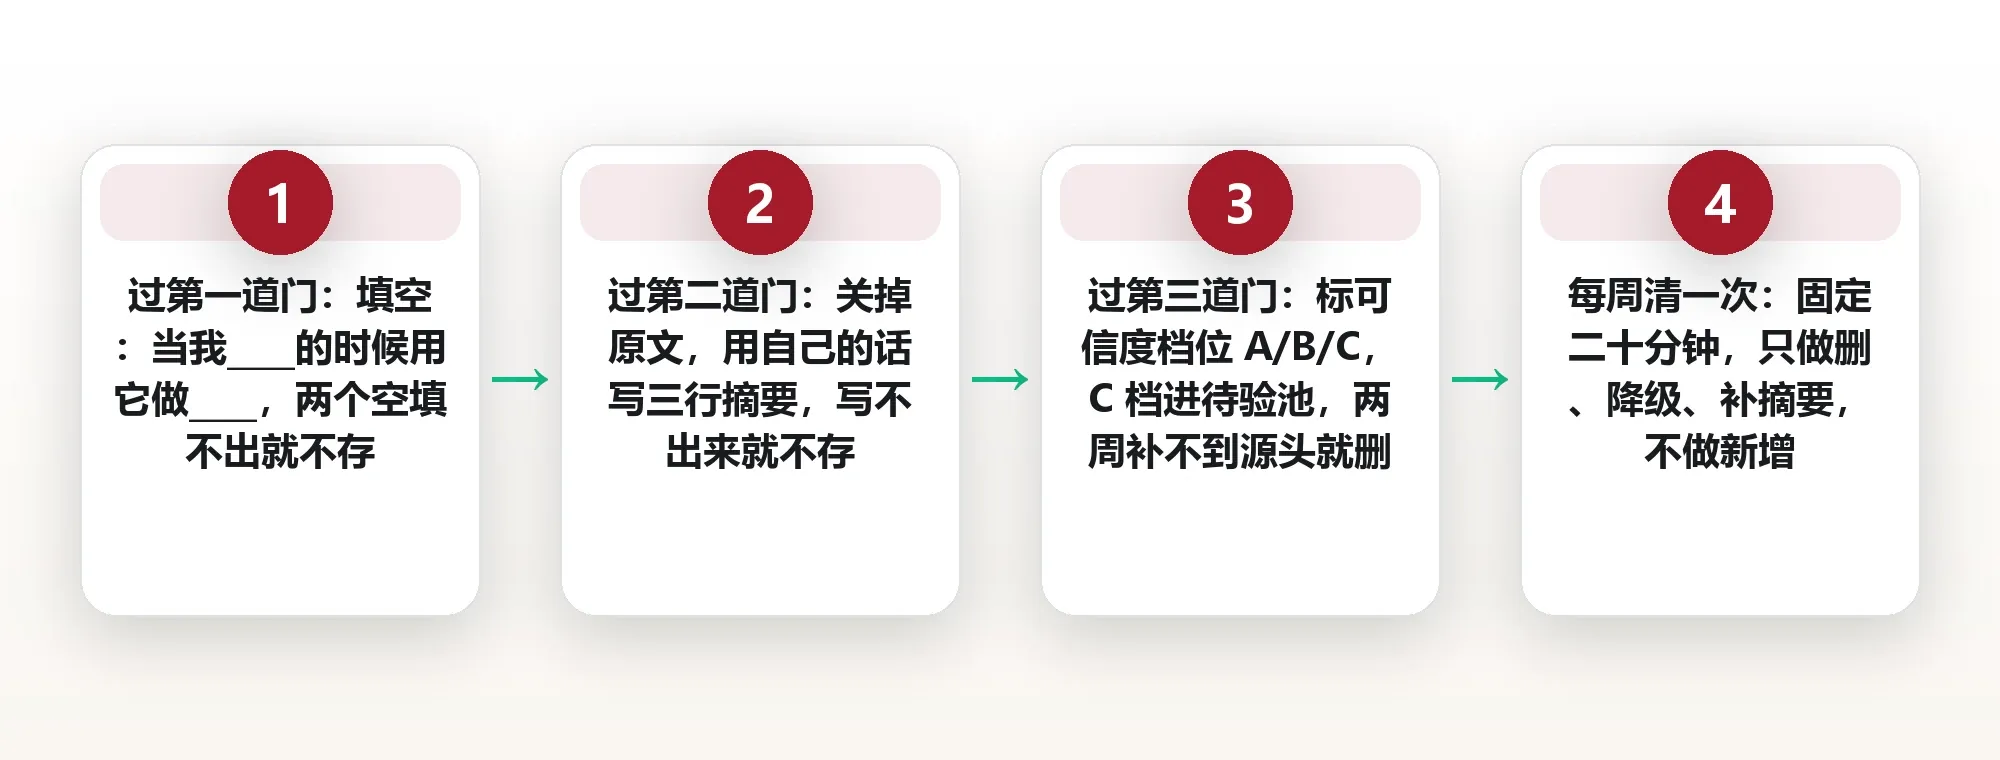
我用的判据是一个很简单的填空句式:当我____的时候,我会打开它,用它来做____。两个空都必须填得出来,第一个空填场景,第二个空填动作。只要有一个空卡住,这条内容就过不了第一道门。
这道门挡掉了大约六成内容,挡得最多的有三类:行业新闻,看着重要但保鲜期只有三天;观点金句,读的时候很爽,用的时候无处安放;还有「看起来很厉害但我根本不做那件事」的方法论。我存过十几篇跨境电商选品的深度分析,而我一天跨境电商都没做过。
有人会担心:万一以后真的用得上呢?我的经验恰恰相反——真正会用得上的东西,未来一定会以另一种方式重新出现在你面前。你关注的人会再提一次,平台会再推一次,或者你在做那件事的时候很自然地就搜到了。知识有个特点:需要它的时候它特别好找,不需要的时候存着也是死的。
所以这道门的本质不是预测未来,而是承认自己能力有限。你不是在判断「这条内容好不好」,你是在判断「我这个人会不会真的用它」。前者关于内容,后者关于你。绝大多数囤积的错误,都错在后半句。
第二道门槛:能不能复述
第二道门槛问的是理解深度:把原文关掉,我能不能用三句话把它讲给别人听?如果讲不出来,说明它还没有变成我的东西,只是暂时借放在我这里。借放的东西,不配长期占用库位。
这个判据来自一个我用了很多年的笨办法:每存一条,就在笔记区手写三行摘要,不许复制原文,不许改写成同义词,必须用自己的话。三行写不出来,我就承认自己没读懂,把它删掉,或者标记成「待重读」放进一个单独的池子,而不是主库。
实际执行时,这道门的通过率低得吓人。我抽查过自己存的八十条「高质量长文」,能当场复述核心论点的只有十一条,接近七分之一。剩下的要么我只记住了标题的情绪,要么我记住的是别人转述的那句话,而不是原文的论证。我们太容易把「看过」当成「读懂」。
复述还有一个副作用:它会暴露伪知识。有些内容读起来极其顺滑,逻辑闭环看似完美,可一旦要你用自己的话重构,你会突然发现中间缺了关键一环——它用修辞掩盖了证据的缺口。这类内容最危险,因为它在库里看起来最漂亮。
我现在的标准是:三句话复述不出来的,不进库;能复述但复述完发现自己并不认同的,也不进库。库不是博物馆,不需要收藏「别人觉得好的东西」,只需要收「我消化过并且认可的东西」。这条标准让我删掉了很多看起来很有分量的长文,但我一次都没有怀念过它们。
第三道门槛:有没有出处
第三道门槛问的是可信度:这条内容能不能追溯到一个可以核对的源头?源头可以是原始论文、官方文件、一手访谈,也可以是某个具体的人在某个具体场合说过的话。如果一条内容只剩下「据说」「研究表明」「有个大佬说过」,它就不该进库。
这道门我以前最不当回事,后来吃了亏。前年我在一篇文章里看到「人每天只需睡四小时就能保持高效」的说法,当时觉得有用就存了,还在一次分享里引用。后来有人问我出处,我翻遍整个库也找不到那份原始研究,只能尴尬地说「网上看到的」。那次之后我才明白,没有出处的知识不是知识,是传言的复印件。
我的做法是给每条入库内容标一个可信度档位:一手来源标 A,可靠二手标 B,只有转述和截图的一律标 C。C 档不直接进主库,先放进「待验证」清单,两周内补不到源头就删。这个动作看起来机械,但它逼着你在存的那一刻就想清楚:我到底信它什么。
出处这件事还有一层价值:它会强迫你回到原文本。很多被广泛转述的「金句」,翻回原文一看,上下文完全是另一个意思。我至少有五次在追溯出处时发现,那句被我奉为圭臬的话,原作者其实是在反驳它,而不是支持它。转述链条每多一环,意思就偏一度。
三道门槛的顺序也有讲究。我的顺序是先问会不会用,再问能不能复述,最后问有没有出处。这个顺序的成本是递增的:第一个问题三秒钟,第二个问题三分钟,第三个问题可能要三十分钟。用便宜的筛子先筛,是最省力的做法,也是最容易坚持下去的做法。
专业分析:收录率与复用率的漏斗关系
把三道门槛连起来看,它其实是一个漏斗。我拿自己 2025 年全年的记录做过一次回溯统计:全年标记「想存」的内容共两千一百四十七条,三道门槛全部通过、真正入库的二百六十八条,收录率百分之十二点五;当年被实际调取使用过的九十六条,占入库量的百分之三十五点八,占最初候选量的百分之四点五。这是一份个人样本,量级仅供参考,但比例关系值得琢磨。
这个结构和经典的漏斗模型完全一致:候选池、过门槛、入库、被复用,每一层都在做减法。企业获客漏斗里,从线索到成交的转化率常见区间是百分之一到百分之五;我这个「从想存到真用」的百分之四点五恰好落在同一个量级。这不是巧合——任何以广度作入口、以深度使用作出口的系统,衰减曲线都长得差不多。
更有意思的是二八法则在这里的变形。通常说百分之二十的内容贡献百分之八十的价值,我的数据更极端:入库的二百六十八条里,被调用三次以上的只有三十一条,占百分之十一点六,却贡献了我全年引用次数的七成以上。也就是说,真正的门槛不是「挡掉不好的」,而是「让那百分之十一更容易被找到」。
一个可对照的案例:我认识的一位做产品研究的朋友,2023 年把公司内部的知识库从「全员自由上传」改成「提交时必须填三栏——使用场景、三行摘要、原始链接」,同时把清理周期定成每周一次、每次二十分钟。半年后他们统计,库内条目从一万四千条降到三千一百条,但内部搜索的一次命中率从百分之三十四升到百分之七十一,平均找资料时间从十一分钟降到四分钟。这是匿名案例,口径为内部工单统计。
可量化的门槛指标我建议盯三个:一是收录率,即入库数除以候选数,健康区间在百分之十到百分之二十之间,超过百分之三十说明门槛形同虚设;二是一次命中率,即首次搜索就找到所需内容的比例,目标七成以上;三是复用密度,即条目被调用次数除以条目总数,低于零点三说明库里沉睡内容过多。三个指标里,一次命中率最能反映真实体验。
执行清单四步:第一步,导出近九十天的收藏,按来源分组,先看清自己囤积的偏好;第二步,对每条做三问打分,三项全过才留,任何一项不过就删或者进待验池;第三步,给留下的每一条补三行摘要和一个可信度档位,补不出来的直接降级;第四步,设一个每周固定二十分钟的清理窗口,只做删和降级,不做新增。四步跑满八周,再回头看那三个指标。
三道门槛放一起,就是一次三十秒的判断
三道门槛听起来麻烦,实际用起来可以压缩到三十秒。我的做法是把三个问题做成一枚固定句式,贴在保存按钮旁边:半年内用在哪、三句话怎么说、源头在哪。三个都答得上就按保存,答不上就按删除。就这么简单,简单到不需要任何工具和任何仪式。
为什么一定要强调三十秒?因为判断的成本一旦超过某个阈值,人就会跳过判断直接保存,而跳过一次之后就会有第二次。这是我在自己身上反复验证过的规律:任何需要「专门找个时间来做」的整理流程,最后都会烂尾。门槛必须短到能在存的那一秒完成,否则它就不是门槛,是装饰。
三十秒里最容易卡住的是第二个问题。复述需要你真的读懂,而读懂需要时间。我的妥协办法是允许「半通过」:如果内容明显值得读、但现在确实没空读,就把它扔进一个叫「待读」的临时池,设七天期限。七天内读不完、复述不出来的,自动作废。临时池不设上限,但它有一条铁律——不许把临时池里的东西搬进主库,除非你完成了复述。
三道门槛还有一个隐含的好处:它让删除变得没那么痛。以前删东西我会心疼,觉得删掉的是可能性;现在我知道,删掉的只是「我以为我以后会用」的幻觉,而真正的可能性会在需要的时候自己回来。心疼消失了,动作就快了,而快本身就是一种可持续。
还有一个容易被忽略的收益:三十秒的判断会让你的注意力变得诚实。当你知道每一条都要回答「用在哪」,你就不会再无意识地往下滑着存。收藏这个动作从「手滑」变回「决定」,从背景噪音变回一次有意识的选择。这个变化本身,比删掉多少条都重要。
「以后再说」是知识库里最贵的四个字
我统计过自己库里内容的时间戳,发现一个很整齐的规律:存进去之后七天内没有被打开过的内容,后续被打开的概率不到百分之三。这个数字比我想象的还要残酷,它意味着「以后再读」基本等于「永远不读」,而「以后再说」这四个字,是所有囤积行为的通用许可证。
为什么是这样?因为一条内容的价值窗口通常很窄。你之所以在某个瞬间觉得它有用,是因为你当时正卡在某个具体的问题里。一旦离开那个情境,它就失去了挂钩,变成一条孤立的文本。三天后再看,你已经想不起当初为什么要存它,只剩下一点模糊的好感。
所以我现在把时效当成第四道隐性门槛:这条内容的价值,是多久之内兑现的?工具类、方法类的窗口长一点,可能半年;新闻、观点、行业动态的窗口往往只有一周。窗口短的,要么立刻用,要么不存。存下来等以后用,等于把鲜奶放进柜子里,等它自己变成奶酪,而它只会变质。
有个反直觉的推论:如果你的库里躺着大量「很久以前存的、至今没打开」的内容,那它们大概率永远不会被打开了。与其留着占位,不如一次性清掉。清理那五千多条的时候,我原本很怕删掉重要的东西,实际删完三个月,我一次都没有后悔过。这个结果本身就说明,它们本来就不重要。
每周二十分钟的清理动作
门槛解决进,清理解决留。我给自己定的节奏是每周日晚上九点,二十分钟,只做三件事:删、降级、补摘要。不看新内容,不做新增,就只是打扫。二十分钟一到就停,哪怕没扫完,剩下的留给下周。设一个硬性停止点,是为了让这件事不变成负担。
具体流程是这样:先按「最近三十天未打开」筛一遍,把结果按体积排序,从最新的开始看;每条扫三秒,能用一句话说清它解决什么问题就留下,说不清就删;拿不准的降级到待验池,两周内不处理自动清空。二十分钟大概能处理一百五十条,比我预想的快很多。
补摘要这一步是给留下的内容「上户口」。三行字:它讲什么、我能用在哪、源头是什么。这一步最费时间,所以我一般只补当周新入库的那几条,老的不动。补完之后我会在标题前面加一个短标记,方便搜索时优先命中。标记不用复杂,两个字就够。
坚持了大概四个月之后,我发现自己找东西的平均搜索次数从五次降到一点七次。原因不在于库变小了,而在于库变干净了——同样的关键词,现在返回的十条里至少有七条相关,而以前十条里能有一条相关就算运气好。搜索质量说到底是信噪比问题,而清理就是在提高信噪比。
还有一个细节:我把清理固定在周日晚上,是因为那是我一周里情绪最平稳的时段。清东西需要一点狠心,而人在疲惫或者兴奋的时候判断会失真。给清理挑一个情绪合适的时段,比给它挑一个空闲的时段更重要,这一点我踩过很多次坑才想明白。
门槛之外,什么东西值得破例
三道门槛再严,也要留几个破例的口子,否则库会变得过于功利,只剩「马上要用」的东西。我给自己留了三类豁免:第一类是长期主义的底层材料,比如基础学科的原典、某个领域的奠基论文,它们的价值不在半年内用得上,而在十年后还在。
第二类是「此刻说不清但心里一动」的东西。有些内容能打中你,但你当下说不出为什么。这类我不删,扔进一个叫「待发酵」的池子,不设期限,也不进主库。它们不占搜索结果的位置,但每隔半年翻一次,往往会捞出几条当年看不懂、现在正好需要的东西。
第三类是关系型内容:某个具体的人分享给我的东西。哪怕它本身没什么价值,它承载的是一段关系,删掉会有心理成本。这类我单独建一个「人情」标签,和知识区分开,不参与清理。承认知识库也承担情绪功能,比假装它只是一台机器要诚实得多。
破例的关键不是多留一些,而是给破例单独建一个房间。豁免内容混在主库里,就会稀释门槛的效力,你会不断用「这条是破例」给自己找台阶;单独放一个池子,主库才守得住严格。我后来的库其实是三个房间:主库走严格三道门,待验池有期限,待发酵池无期限,彼此不通。
FAQ
1.问:三道门槛会不会太严,导致我什么都不敢存?
答:会有一点,这是好事。宁可漏存,不要错存。漏掉的内容在需要时会自己回来,错存的内容则会持续污染你的搜索结果,成本是长期的。门槛的作用不是让你不存,而是让你在存的那一刻多想三秒钟。
2.问:我没有时间给每条内容写三行摘要,怎么办?
答:那就只给通过门槛的那几条写。绝大多数内容在第一道门就被挡掉了,真正需要写摘要的可能不到两成。把写摘要的成本集中到少数值得的内容上,比平均摊给所有内容划算得多。
3.问:已经囤了几千条的老库,要不要全部推倒重来?
答:不用。先从「最近三十天未打开」这一批开始删,通常能砍掉一半以上;剩下的按可信度分三层,只精修最上面那一层。一次清空的心理阻力太大,分三次做,每次二十分钟,更容易坚持下来。
4.问:出处这件事,网上转述的文章找不到原始来源,直接删是不是太浪费?
答:可以先降级不删。放进待验池,给它两周,补不到源头再删。判断标准很简单——如果一条知识你连它从哪来都说不清,那你用的时候也没有底气,早晚要出事。
5.问:这套方法适合团队共用的知识库吗?
答:适合,而且更该用。团队库的信噪比恶化速度远快于个人库,因为每个人都只对自己存的东西负责。把场景、摘要、源头三栏做成提交表单的必填项,是最低成本、最高收益的治理手段。
6.问:清理会不会删掉以后真的有用的东西?
答:会,但概率很低,而且可以补救。我的经验是删掉的内容里真正的后悔率不到百分之二,而那些内容通常在别处还能重新找到。为了百分之二的可能性去忍受九成八的噪音,并不划算。
图片来源:图1 ersi / Pixabay (CC0) · 图2 BaluBFA12 / Pixabay (CC0) · 图3 samirsmier / Pixabay (CC0) · 图4 rickhouchin / Pixabay (CC0) · 图5 cegoh / Pixabay (CC0) · 图6 Leonhard_Niederwimmer / Pixabay (CC0) · 图7 Myriams-Fotos / Pixabay (CC0) · 图8 keithgonzalez / Pixabay (CC0) · 图9 12019 / Pixabay (CC0) · 图10 Nennieinszweidrei / Pixabay (CC0) · 图11 geralt / Pixabay (CC0) · 图12 neelam279 / Pixabay (CC0) · 图13 mattiaverga / Pixabay (CC0) · 图14 WikiImages / Pixabay (CC0) · 图15 ValterM / Pixabay (CC0) · 图16 josibo / Pixabay (CC0) · 图17 stux / Pixabay (CC0) · 图18 Kapa65 / Pixabay (CC0) · 图19 NiklasErnst / Pixabay (CC0) · 图20 Haim_Charbit / Pixabay (CC0) · 图21 Tumisu / Pixabay (CC0) · 图22 geralt / Pixabay (CC0)
本文由 AI 生成,经人类主编终审。
评论(0)