
基本信息
阅读时间:约 15 分钟
字数:约 6050 字
摘要:正向讲 DIKW 只管往上垒,不管站不站得住。本文给出反向路径与三问判别法:行动问、机制问、回溯问,从结论退回原始数据,用四个比率度量,并配执行清单与五条反例复盘。
全文语音
中文
English
日本語
한국어
结论写在最后一页的人:反向追问是怎么开始的
深圳南山,去年 11 月的一个周四下午三点,李思远把一份 42 页的汇报材料发给总监,十分钟后收到一句回复:第三页那个结论,你是怎么得出来的?他盯着屏幕,把材料从头翻到尾,才发现 42 页里有 38 页是截图、表格和引用,只有最后一页写着一句建议把新客引导流程从五步压缩到三步。那份材料他做了整整两周。
我当时第一反应是翻开第二十页那张转化率表格,心想你看数据就在这儿。但总监问的不是数据在哪,是你凭什么从这张表得出那句话。李思远后来跟同事复述这段对话时,用了卡住这个词,他说那一瞬间脑子里是空的,像站在一栋楼的天台上往下看,明明有很多层,却找不到楼梯在哪儿。
这件事的问题不在数据量。他手上确实有六个月的用户行为日志、三轮用户走访记录、两份竞品对照表,原始素材加起来超过 400MB,随便挑一块出来都能讲半小时。问题在于这些东西和最后那句话之间,缺一条能走回去的路——从结论出发往回走,每一步都能说出因为什么所以什么,一直退到某个具体的、可复核的原始数据。
这条往回走的路,就是本文要讲的反向路径。通常讲 DIKW(数据、信息、知识、智慧)都是正向的:数据加工成信息,信息提炼成知识,知识沉淀成智慧,一层层往上垒。但正向路径有个天然的漏洞,它只管往上垒,不管垒上去的东西是不是真的站得住。你完全可以拿一堆没经过核对的数据,垒出一个看起来很像智慧的结论。
反向路径是反过来的:先站在最上面那个结论上,往下追问,一层层往下拆。这个结论对应什么行动,这个行动依赖什么规律,这个规律来自哪组数据。任何一层答不上来,你就知道它断在哪儿了。李思远后来把这套追问做成了三问清单,用了一年多,他说最大的变化不是懂得更多,而是敢删掉更多。
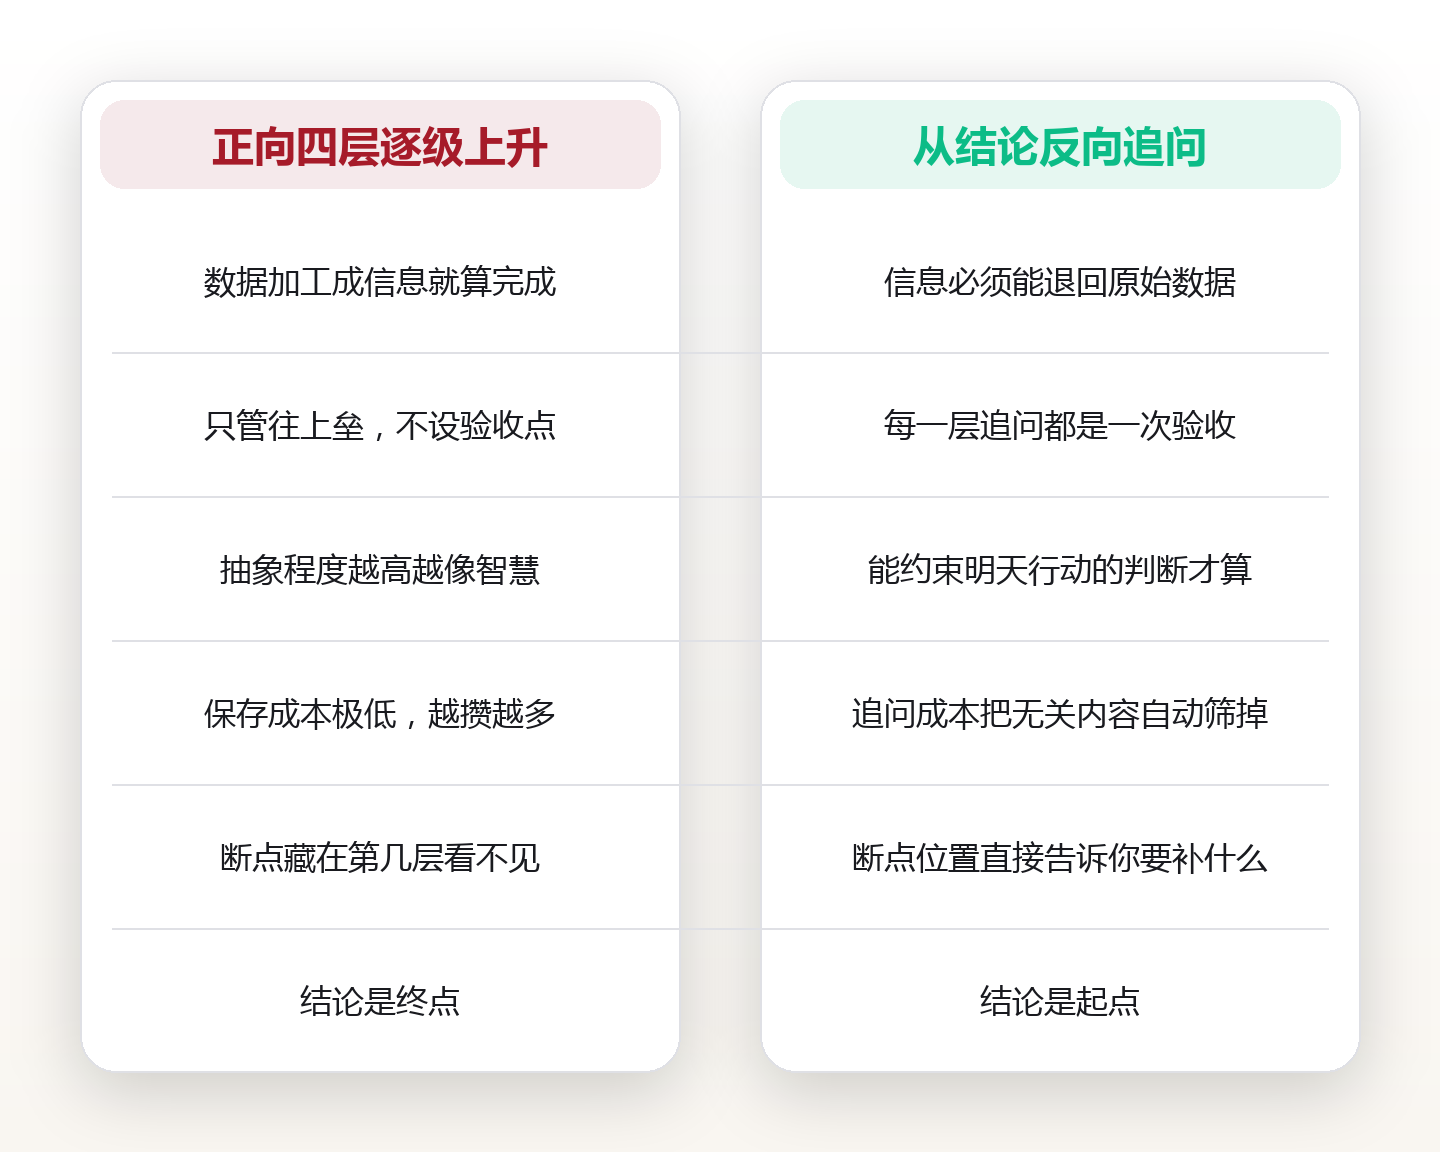
顺着往上垒,最容易在信息层就停住
正向四层的问题在于它没有验收点。数据到信息这一步,只要做了分类、排序、计算,就自然算完成了;信息到知识这一步,需要回答为什么,但没有任何机制强制你回答。所以大多数人的知识库,实际上是一个很大的信息仓库,有结构、有标签、有分类,唯独没有因果。
一个可以自己观察的现象:打开你的笔记软件,搜索用户增长,可能跳出 60 条内容。这 60 条里,有多少条写着怎么做,又有多少条写着为什么这样做会有效、在什么条件下会失效?前者的数量通常是后者的五到十倍(个人笔记库自查的量级,属示意性观察,非严谨统计)。前者是信息,后者才靠近知识。
为什么会这样?因为采集信息的成本极低,生产知识的成本极高。保存一篇长文只需要两秒,而判断这个说法在我的场景里是否成立,需要你自己跑一遍、失败一次、再修一次。成本差了两三个数量级,人的自然选择一定是多存少想,这不是意志力的问题,是成本结构的问题,靠自律很难扭转。
正向路径还有第二个漏洞:它会给你一种越往上越好的错觉。很多人默认智慧是最高层,于是拼命往更抽象、更宏大的方向走,结果一堆笔记写满了长期主义、复利效应、系统思考这类词,抽象到不能再抽象,却没有任何一条能落到明天的具体动作上。抽象不等于智慧,能约束行动的判断才是。
反向路径恰恰是把验收点装进去的设计。它不关心你往上垒了多少,只关心从上往下能不能一路走通。走不通的地方就是断点,断点的位置直接告诉你该补什么:断在最底层说明你连原始数据都没有,只能靠转述;断在中间说明你有素材但没做因果归纳;断在最上面说明你归纳了但没落到行动。
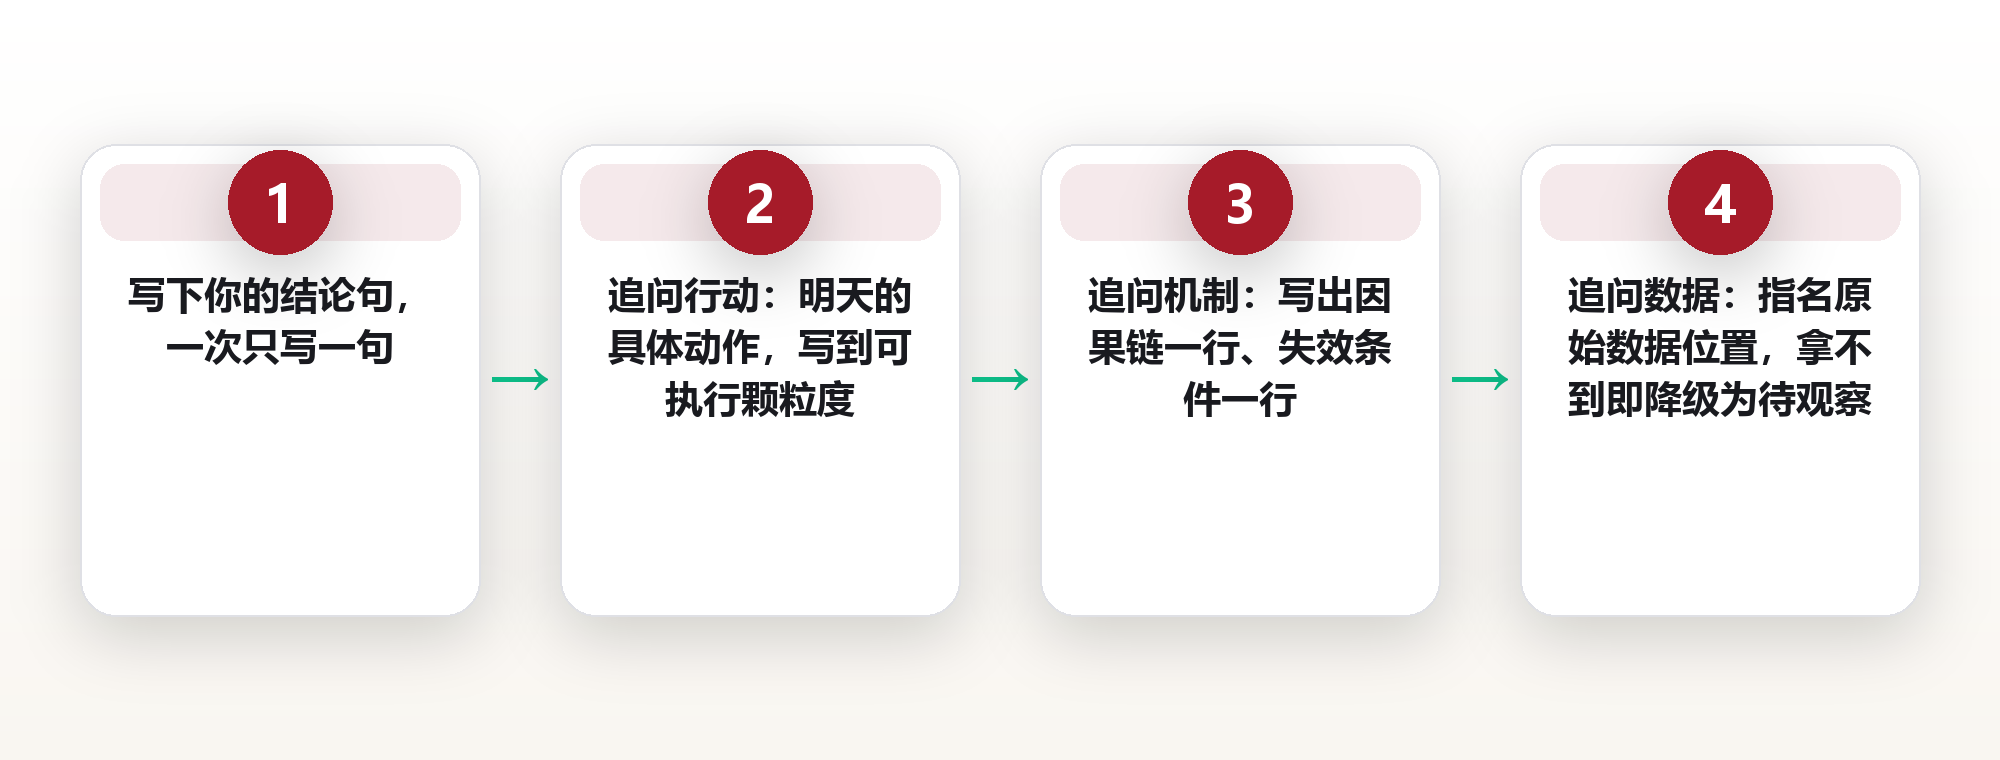
第一问 行动问:如果这个结论为真,明天我做哪件不同的事
三问判别法的第一问是行动问。拿到任何一条所谓的知识,先问:如果它为真,我明天早上到工位以后,会做哪一件与现在不同的事?回答必须是可执行的具体动作,包含时间、对象、程度三样东西,不能是我会更重视、我会调整心态、我会加强关注这类没有动作的词。
举个例子:注意力是当代最稀缺的资源。这句话正确、常见、被引用无数次。用第一问去问它,明天你会做什么不同的事?如果答案是我会少看手机,那还不算可执行,少看多久、在什么时段、用什么替代?要把它推到工作日的九点半到十一点半手机放进抽屉、改用另一台设备放音乐这个颗粒度,才算通过。
通不过第一问的内容,本质上是没有被消费的信息。它进入了你的视野,改变了你的情绪,让你产生说得对、有道理的满足感,却没有改变你的行为。这类内容占据了我们日常信息摄入的绝大部分,它们带来的感受是真实的,带来的改变接近于零,而且这种满足感还会挤掉你真正去做事的时间。
第一问还有个副产品:它会自动帮你筛选。把一条内容推到可执行颗粒度通常需要五到十五分钟,而保存它只需要两秒。这个时间差本身就是过滤器,你不会愿意为一条与自己无关的内容花十分钟,所以最后留下来的,都是真正与你相关的,这比任何标签体系都管用。
李思远的做法是给每条笔记加一个字段,叫行动,只写一句话:如果这条成立,我做某件事。写不出来的,直接标为待观察,三个月后统一清理。他第一年清理掉了 400 多条,占当时总量的六成以上。删的时候手抖,删完发现什么事也没发生,那些条目三个月里一次都没被打开过。
第二问 机制问:它凭什么成立,什么时候会不成立
第二问是机制问,也是三问里最容易被跳过的一问。一个结论通过了行动问,说明它是可执行的,但可执行不等于可靠。你还得回答它凭什么成立,背后的因果链条是什么,中间的传递环节有哪些,以及最关键的:它在什么条件下会失效,失效的表现长什么样。
机制问之所以关键,是因为绝大多数被反复转述的说法,缺失的正是适用边界这一半。多做复盘能加快成长这句话,在很多团队里是真理,在另一些团队里是负资产,如果复盘结果没有改变下一次的决策,它只是把会议时间翻了一倍。两者的差别不在要不要复盘,而在复盘结论有没有回流到决策链。
用机制问去追,会逼你写出那条因果链:A 导致 B,B 导致 C,所以在条件 D 之下,做 A 能得到 C。写得出来,这条内容就从信息升到了知识;写不出来,它就只是一条被很多人重复过的说法,而重复次数和可靠性之间没有任何关系,一百万人转发也不会让它更真一点。
这一问的实操形式很简单:在笔记里写两行,一行写机制,一行写失效条件。失效条件那一行尤其重要,它是区分真知识和口号的分水岭。真知识一定自带边界,因为它来自具体的因果;口号没有边界,因为它来自共鸣,而共鸣是不需要条件的。
有人会问,我怎么知道自己写的机制对不对。答案是:你不需要它永远对,你需要它能被下一次观察推翻。写出机制的最大价值不是得到正确答案,而是得到一个可以被打脸的具体说法。能被推翻的说法才可能进步,永远正确的说法只是口号,口号是没有办法被改进的。
第三问 回溯问:往下退两层,能不能摸到那组原始数据
第三问是回溯问,也是三问里最费劲、也最见真章的一问。前两问都在结论附近打转,第三问要把你一路拽到最底下:这个结论依赖的那条规律,当初是从哪一组观察里来的?那组观察的原始数据现在在哪儿?我能不能自己拿到、自己从头看一遍、自己再算一次?
这一问的杀伤力在于,它会把大量二手结论直接打回原形。你听到的很多判断,是经过三到四次转述的:原始研究、媒体解读、大 V 摘要、你的笔记。每转一次,条件就被削掉一层,数字就被磨圆一次。到了你手上,剩下的往往只有一句顺口的结论,看着很硬,其实底下是空的。
回溯问不问出处是谁,问原始数据在哪。出处只是标签,原始数据才能让你重新算一遍。一份行业报告说某类产品的复购率提升了 40%,你要追的不是报告作者是谁,而是这 40% 的分子分母分别是什么、样本区间是哪几个月、口径里有没有剔除退款订单。
1854 年的伦敦,约翰·斯诺做的正是这件事。当时主流观点认为霍乱由瘴气传播,他提出的是经水传播。他没有停在结论上,而是往回退:逐户走访 Soho 区,把每一户的死亡人数与取水水泵对应起来,画成一张标点地图,最后把结论落到了宽街那一口水泵的具体位置上。史料记载该次爆发的死亡量级为数百人,属历史记录而非现代流行病学统计。
这张图的力量不在它有多精美,而在它是一条完整的反向链:结论是水传播,机制是受污染的水源进入家庭,原始数据是每户的死亡记录与取水点。每一层都能往下退一格,退到可以实地核实的那一格。这也是它比当时所有瘴气论述更有说服力的原因——后者退不回任何可核实的东西。
不过要补一句反面:后来有研究者指出,斯诺介入时疫情本身已在自然回落,移除水泵把手与疫情终止之间的因果强度存在争议。这件事恰恰是三问判别法最好的注脚——机制问和回溯问不是一次性的,结论哪怕再漂亮,也要允许后来的人拿着新数据把它推翻。
专业分析:三问判别法的量化口径、两组框架对比与执行清单
先给三问判别法一个可度量的口径。它不能只停留在感觉上,否则它自己也会变成一条没有失效条件的口号。建议用四个比率来跟踪:可执行率等于通过第一问的条目数除以总条目数,机制完备率等于写了失效条件的条目数除以通过第一问的条目数,回链率等于能指名原始数据位置的条目数除以总条目数,七日复述一致率等于隔七天不看原文复述时与原意一致的比例。个人知识库的回链率基线通常在两成以下(示意性经验量级,非精确统计),可先以五成为半年目标。
为什么要有七日复述这一项?因为记忆的衰减是有量级的。艾宾浩斯 1885 年的自我实验显示,学习后一小时保留约 44%,一天后约 33%,一个月后约 21%(经典实验量级,样本为单人,属早期实验而非现代大样本研究)。而 Roediger 与 Karpicke 在 2008 年发表于 Science 的实验室研究里,一周后重复阅读组的回忆率约在 40% 量级,重复自我检索组约在 61% 量级(样本为大学生,量级为数十人)。两条数据合起来说明同一件事:存下来不等于留下来,能自己说出来才算。
把三问判别法放进坐标系里,它和另外两个知名框架的关系是这样的。第一个是芭芭拉·明托在《金字塔原理》里提出的结论先行、以上统下、MECE,它同样是自顶向下,但目标是表达结构,让听的人更快接受你的结论,验收标准是逻辑分组是否穷尽且互斥。第二个是丰田大野耐一体系里的五个为什么,它也是自顶向下追问,但终点是根因而非行动,经典案例是机器停转追到保险丝、轴承润滑不足、油泵,最后落到滤网杂质。
三者的差别可以这样概括:金字塔原理管的是怎么把结论讲清楚,五个为什么管的是怎么把原因挖到底,三问判别法管的是怎么判断手上的东西值不值得留。前两者作用于已经确认要处理的对象,第三者在最上游做筛选。它们并不互斥,一个成熟的做法是先做三问筛选,再用金字塔原理组织表达,遇到失效再补五个为什么。
真实案例的对比也能说明问题。斯诺的霍乱地图之所以有力量,是因为它同时满足了三问:结论指向一个具体动作,即拆掉那口水泵的把手;机制写出了传递环节,即污染水源进入家庭;原始数据可以实地核实,即逐户死亡记录与取水点。而当时占据主流的瘴气说,一条都过不了,它既没有可执行的具体动作,也没有可描述的传递机制,更退不回任何一组可核实的观察。
落地时的执行清单可以很短,六条就够:一,每条新进笔记必须在三分钟内写完行动、机制、失效条件三个字段,写不全就留在待观察区;二,每周固定三十分钟只做第一问,把待观察区过一遍;三,每月统计一次断点分布,看未通过的条目断在哪一层;四,对回链率为零的条目做批量降级,改为转述存档;五,重要结论隔七天做一次闭卷复述,把结果写进同一条笔记;六,每九十天清一次库,连续两次未通过第一问的条目直接删除。
最后给一个反直觉的判断:三问判别法的主要产出不是你留下了什么,而是你删掉了什么。大多数人的知识管理工作量应该放在减法上,因为加法已经被各种收藏工具做得足够好了。判断你有没有真的在用这套方法的标志也很简单:如果这个月你没有删掉任何一条笔记,那大概率是三问没有真正跑起来,只是多贴了一个标签而已。
反向复盘:五条看起来像知识的内容,逐条退回原位
第一条:注意力是当代最稀缺的资源。第一问就过不了,它给不出任何明天的具体动作,只能推出少看手机这种含糊的意向。要让它升级,必须补上时段、时长、替代物三个参数,补完之后它就从口号变成了一条可执行的安排,也才谈得上对你产生了实际影响。
第二条:这个赛道未来五年还有十倍空间。这条能通过第一问,因为它可以推出加注、进场等动作,但第二问过不了,你写不出十倍从哪来的因果链,更写不出它在什么条件下不成立。它通常断在知识层,本质是一个被包装成结论的推测,推测本身没有错,错的是把它当依据。
第三条:我今年读了 52 本书。这条连三问的门槛都没进,它是典型的数据层堆积。52 这个数字只记录了输入的量,没有记录任何结构。要让它往上走,得回答这 52 本里究竟改变了你哪个具体判断,以及那个判断现在还能不能完整复述出来。
第四条:复盘很重要。第二问勉强能过,机制大概是复盘能把经验转成下一次的约束,但失效条件几乎没人写。而恰恰是失效条件决定了它对你有没有用:如果复盘的产出没有进入下一次的决策会议,它就只是一次耗时两小时的集体回忆。
第五条:费曼技巧最好用。这是一条典型的二手结论,第三问过不了。你很难指名它当初来自哪一组原始观察,更难自己拿到那组数据。这类内容的正确归属是转述存档,可以作为线索,但不能作为你行动的依据,因为你无法判断它对你成不成立。
把这五条放在一起看,规律很清楚:口号断在第一问,推测断在第二问,转述断在第三问,而纯数字压根没有进入三问的范围。断点位置就是处置方式,断在第一问的内容要补参数,断在第二问的内容要补边界,断在第三问的内容要降级,没有进入三问的内容要尽快清理。
把反向路径装进日常:三张表与九十天的检验节奏
第一张表是待观察区。所有新进内容统一先落在这里,不允许直接进正式知识库。每条必须写完行动、机制、失效条件三个字段才能毕业,写不全就一直躺着。这张表的作用是用流程强制你做那五到十五分钟的思考,而不是靠自觉,靠自觉的方案基本都活不过两周。
第二张表是断点台账。凡是未通过三问的条目,记录它断在第几问、大概断在哪一层、当时为什么答不上来。这张表不追求精确,追求的是三个月以后能看出趋势:如果大多数断点集中在第二问,说明你的问题不是素材不够,而是缺少归纳习惯。
第三张表是月度回看。每月花二十分钟统计四个比率:可执行率、机制完备率、回链率、七日复述一致率。四个数放在一起看才有意义,如果可执行率很高而回链率很低,说明你在大量执行没有根据的说法,这比什么都不做更危险,因为它会给你一种很勤奋的错觉。
节奏上建议这样安排:每周一次三十分钟,只做第一问,把待观察区从上到下过一遍;每月一次,做断点分布统计和四个比率的更新;每九十天一次,做一次清库,连续两次未通过第一问的条目直接删除。三次清库之后,你的库会小一半,但能用起来的比例会翻倍。
李思远现在给新同事的培训只有一页纸,上面就三行字。他常说的是那句后来被团队反复引用的话:判断一条内容是不是你的知识,不看它有多正确,看你能不能从它出发,一路退回到你亲手摸过的那组原始数据。退不回去的,写得再漂亮也是别人的。
所以真正的分界线从来不在四层的哪一层上,而在你能不能走通那条往回走的路。正向往上垒,垒多高都不算数;反向往下退,能退到实地的那一步,那才是你自己的东西。收藏量不说明任何问题,能被你删掉的,才是你真正消化过的。
常见问题
1.问:三问是不是太慢了?日常看到的东西根本来不及一条条问。答:三问不是给所有内容准备的,是给进了待观察区的内容准备的。日常刷到的东西八成可以直接略过,真正值得进库的,通常一天不会超过五条,五条各花五分钟是二十五分钟,比刷一小时视频的收益高得多。建议先只对工作相关的结论启用三问,生活类内容暂不纳入。
2.问:一条内容通过了三问,就能保证它是对的吗?答:不能。三问判别法检验的不是对错,而是归属,它检验这条内容有没有落到行动、有没有机制、能不能退回原始数据。通过了三问的判断依然可能错,但它错得可追溯、可被下一次观察推翻,这比永远正确的口号有用得多。
3.问:我手上有几千条笔记,从哪儿开始?答:不要从头清理,那样一定半途而废。做法是按时间倒序取最近九十天的一百条,只对这一百条跑第一问,把通不过的标为待观察。三个月后你会自然发现,早期笔记里真正被你反复调用的其实很少,剩下的可以整批降级为转述存档。
4.问:反向路径和批判性思维有什么不一样?答:批判性思维是一组态度,告诉你不要轻信;反向路径是一组动作,告诉你具体往哪儿追问。三问把不轻信拆成了三个可勾选的动作:写行动、写失效条件、指名原始数据。态度很难执行,动作可以,两者是互补关系,不是替代关系。
5.问:团队协作里怎么让大家用同一套问法?答:把三问做成模板字段,而不是口头要求。在团队的方案模板里固定加三栏:本结论对应的下一步动作、成立机制与失效条件、支撑数据的原始位置。写不全的方案不允许进入评审会。用模板约束比用培训说服有效得多,因为它把追问变成了提交门槛。
图片来源:图1 modernseoul / Pixabay (CC0) · 图2 fietzfotos / Pixabay (CC0) · 图3 theharpreetbatish / Pixabay (CC0) · 图4 4174332 / Pixabay (CC0) · 图5 si_kor / Pixabay (CC0) · 图6 DavidClode / Pixabay (CC0) · 图7 RheaHoldstock / Pixabay (CC0) · 图8 Zhanat86 / Pixabay (CC0) · 图9 ciobanucatalina / Pixabay (CC0) · 图10 adibalea / Pixabay (CC0) · 图11 ambquinn / Pixabay (CC0) · 图12 Pexels / Pixabay (CC0) · 图13 JillWellington / Pixabay (CC0) · 图14 candecegriffin / Pixabay (CC0) · 图15 JillWellington / Pixabay (CC0) · 图16 Madeinitaly / Pixabay (CC0) · 图17 FilipFilipovic / Pixabay (CC0) · 图18 jarmoluk / Pixabay (CC0) · 图19 Themil / Pixabay (CC0) · 图20 pasja1000 / Pixabay (CC0) · 图21 qimono / Pixabay (CC0) · 图22 Firmbee / Pixabay (CC0) · 图23 jarmoluk / Pixabay (CC0) · 图24 brenkee / Pixabay (CC0) · 图25 pcdazero / Pixabay (CC0) · 图26 markus53 / Pixabay (CC0) · 图27 reginasphotos / Pixabay (CC0) · 图28 Michael_Pointner / Pixabay (CC0) · 图29 Couleur / Pixabay (CC0) · 图30 7523944 / Pixabay (CC0) · 图31 Rianne_SchillerMclean / Pixabay (CC0) · 图32 TheDigitalArtist / Pixabay (CC0) · 图33 MiraCosic / Pixabay (CC0) · 图34 Dimhou / Pixabay (CC0) · 图35 MiraCosic / Pixabay (CC0) · 图36 focusonpc / Pixabay (CC0)
本文为认知与方法论科普,不构成任何投资建议。
评论(0)