
基本信息
阅读时间:约 11 分钟
字数:约 4542 字
摘要:倍速听书省下的是时间,损失的是加工。本文用理解率与留存率的量级数据、CAPE 权衡模型、四类内容场景适配矩阵与三遍法,给你四把可当场校准的尺子,划出音频与文本的适配线。
全文语音
中文
English
日本語
한국어
1.0 倍不是基准线,被压缩的从来不是时间
林澈今年 29 岁,在杭州做产品经理。每天早上 7 点 42 分,他会在地铁 2 号线的第三节车厢找到一个靠门的位置,把耳机塞进耳朵,按下播放键。他听的是一本讲地方财政的书,一章 28 分钟。他把速度调到了 1.5 倍,这样能在到站之前听完,还剩 4 分钟刷一眼工作群。
「我算过一笔账,」他说,「一年下来,我用倍速多听了四十多本书的时长。这个数字让我有点上瘾。」
三个月后,部门做季度分享,轮到他讲一本刚读完的书。他张嘴的那一刻愣住了:他记得那本书讲了地方政府和土地,记得里面有个很有意思的比喻,但具体是哪句话、哪一组数字,他一句也想不起来。末了他说的是:「这本书挺好看的,推荐大家去看。」
问题不在于他听得少,而在于他从来没量过损失。倍速听书真正的成本,不是音质变差,也不是耳朵累,而是你把一段本来需要工作记忆参与加工的信息流,压成了一条滑过去的声波。时间省下来了,加工却没有发生。
这篇文章想做一件很具体的事:给倍速听书和播客收听,划一条能被你自己的数据校准的场景适配线。它不是要告诉你该听多快,而是要给你四把尺子,让你自己量出「我在这本书上到底损失了多少」。
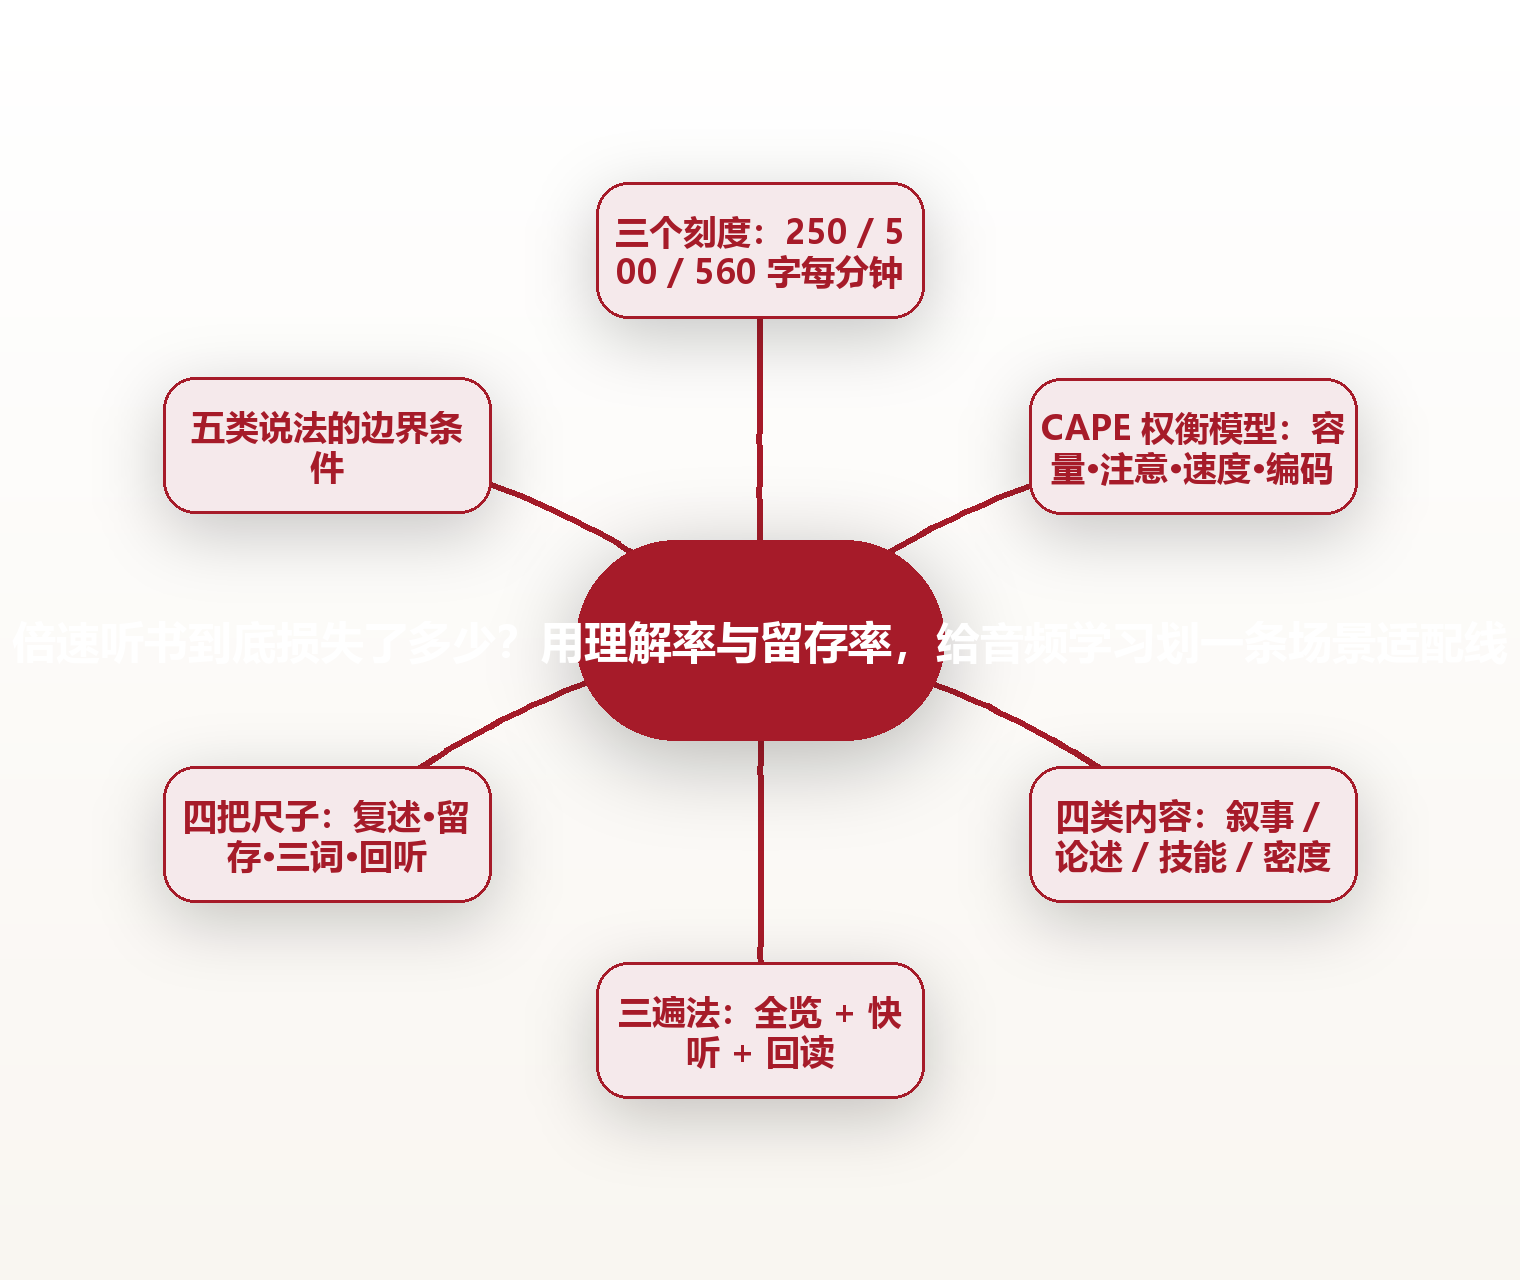
速度表上的三个刻度:250、500、560
第一个需要澄清的常识是:中文有声书的播讲语速,通常在每分钟 240 到 280 字之间。这个区间来自有声制作行业公开的录制规范口径,不是随手估的。也就是说,1.0 倍速下,你的耳朵每分钟接收大约 250 个字。
第二个刻度:成年人中文默读速度,公开阅读研究的常见区间是每分钟 400 到 600 字。很多人第一次看到这个数字都会愣一下——原来我们安静看书的时候,速度早就超过正常播讲了。
第三个刻度:把 250 字每分钟乘以 2,得到的是 480 到 560 字每分钟,恰好落在成年人默读速度的区间里。换句话说,2.0 倍速听起来很激进,但它只是把音频拉到了你眼睛早就习惯的速度。
这就是倍速很常被误解的地方。它不是一个超速开关,它首先是一个追赶开关。从 1.0 到 2.0,你未必是在压榨大脑,你可能只是在弥补听觉通道天生比视觉通道慢的那一段。
但接下来这个差别才是关键:眼睛有回看键。读到一句话没懂,你会自然地把视线往回跳半行,这个动作的成本几乎为零。耳朵没有。音频的回看要用手去拖进度条,拖过头了还得往回拖,一次回拖平均要花 6 到 10 秒。速度越快、卡点越多,回拖的代价就越容易吃掉倍速省下的时间。
专业分析:CAPE 权衡模型与两条留存曲线
先看一组量级数据。据公开教育心理学期刊的综述口径,把课程音频从 1.0 倍提升到 1.5 倍,即时理解率的下降幅度通常在个位数百分比量级,大致落在 3% 到 8% 之间;提到 2.0 倍时,下降幅度扩大到约 10% 到 20%;超过 2.5 倍之后,下降幅度可能达到 25% 以上。需要强调,这是多项研究汇总后的量级区间,不是某一次实验的精确结论,个体差异相当大。
一个更具体的可辨识案例:据公开报道,美国加州大学洛杉矶分校 Dillon Murphy 团队曾就课程视频的播放速度做过对照观察,结果显示 1.5 倍速组的即时回忆表现与 1 倍速组差距很小,2 倍速组则出现了明显下滑,2.5 倍速组的下滑幅度更大。这项观察的意义不在于给出标准答案,而在于指出一个拐点——损失不是线性增加的,它在某个速度之后会突然变陡。
要解释这个拐点,需要三个已经存在了很多年的模型。第一个是 Paivio 的双重编码理论:信息如果同时走语言和图像两条通道,记忆痕迹会比单通道更牢固。第二个是 Baddeley 的工作记忆模型:语音回路的容量有限,而且衰减很快,大约几秒就会清空。第三个是 Mayer 的多媒体学习认知理论:学习效果取决于必要加工是否真的发生,而不是信息有没有经过你的耳朵。
把三者放在一起对比,会发现它们对倍速的判断并不完全一致。双重编码理论关心的是表象有没有建起来,工作记忆模型关心的是缓冲有没有被挤爆,多媒体学习理论关心的是加工有没有发生。所以倍速对三者的打击顺序也不同:先挤爆缓冲,再打断加工,末了让表象建不起来。这也解释了为什么拐点不是平滑的——它是三个机制依次失效叠加出来的结果。
在这三个模型之上,我更愿意用一个可以直接操作的框架来安排自己的收听,我叫它 CAPE 权衡模型。C 是 Capacity,工作记忆容量,取决于你当时的状态,通勤挤地铁时它明显偏低;A 是 Attention,注意力资源,取决于环境干扰;P 是 Pace,播放速度;E 是 Encoding,编码深度,也就是你打算听完后做到什么程度——能复述、能讲给别人听,还是能用它做一个决定。四个变量里,只有 P 是你随手可调的,另外三个决定了 P 的上限。
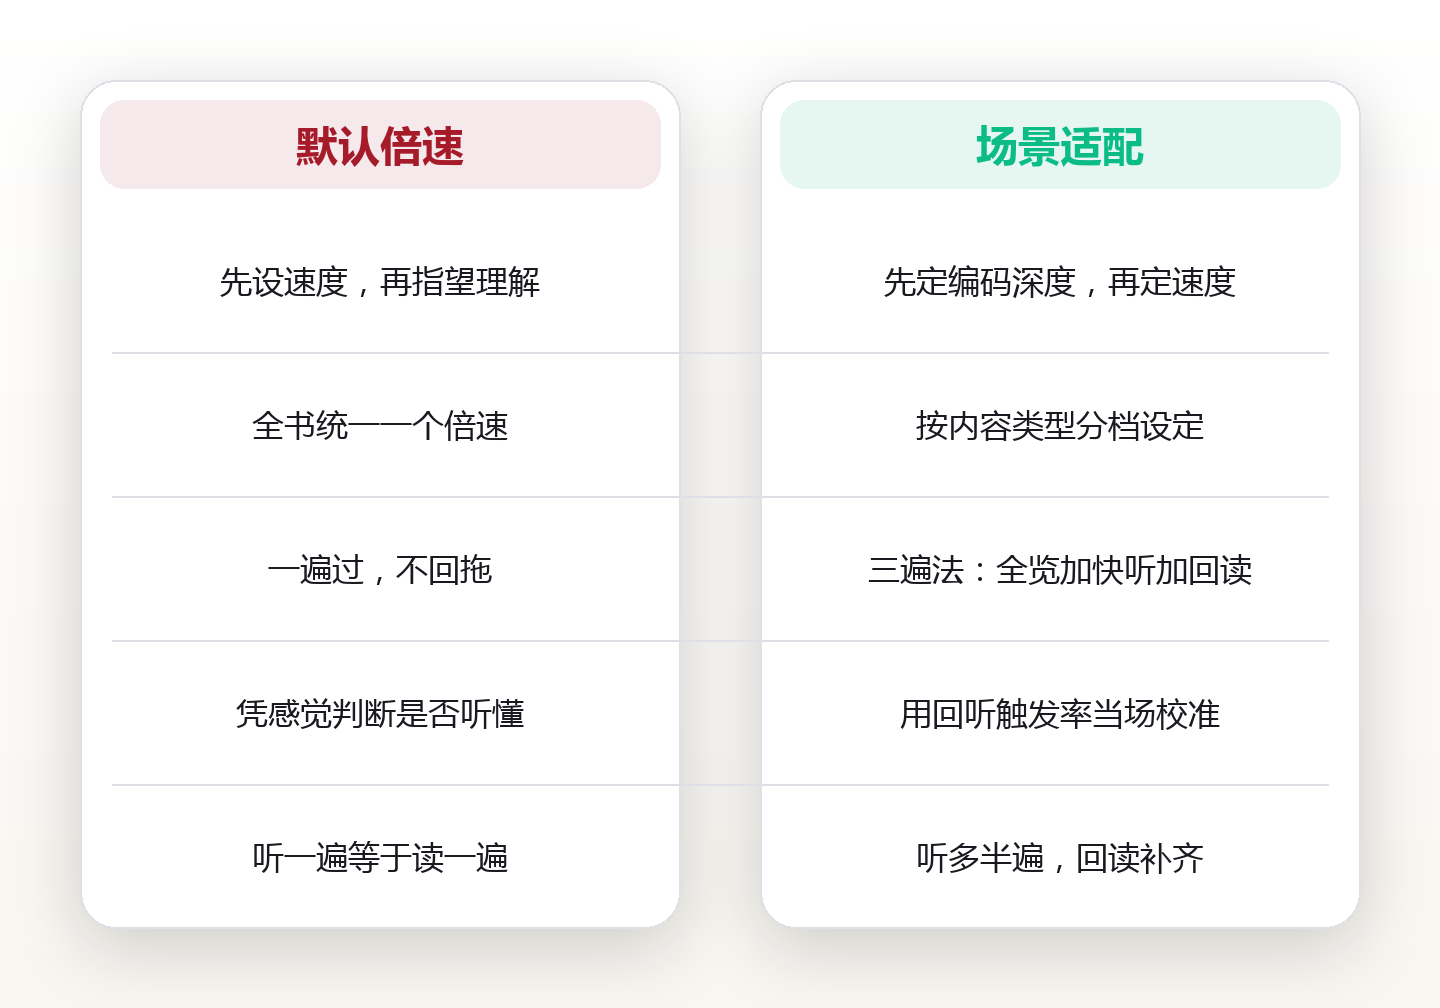
CAPE 的使用规则很简单:先给 E 定档,再看 C 和 A 的当天状态,末了才决定 P。很多人搞反了——先定 P,再指望 C 和 A 自己跟上。可落地的度量指标有四个:30 秒复述率,听完不看笔记用 30 秒讲出主干,能说出的要点数除以预设要点数;24 小时留存率,第二天早上凭记忆写要点再与当天记录对比;三词笔记覆盖率,每章只允许记三个词,事后看这三个词能否勾回整章;回听触发率,每听 1000 字主动回拖的次数,超过 2 次即说明当前速度已越过你的拐点。执行清单:固定一本书连续记录两周;每次只改一个变量;四个指标填进同一张表;出现连续两次回听触发率超标就把速度降 0.2 档。
场景适配矩阵:什么时候该听,什么时候该读
与其争论音频能不能替代阅读,不如先把内容按信息密度和冗余度分成四类,再分别决定通道。
第一类是叙事型,比如小说、回忆录、人物传记。这类内容的冗余度很高,大量篇幅用于铺陈氛围和情绪,主线通常不超过三条。它对速度相当宽容,1.5 到 2.0 倍是常见的舒适区,而且听比读更合适——播讲的语气本身就是信息的一部分。
第二类是论述型,比如商业畅销书、历史普及、社会观察。这类内容有明确的论点加案例结构,冗余度中等。1.2 到 1.5 倍比较稳妥,超出之后容易丢掉论证的衔接,只记住一个个孤立的例子。
第三类是技能型,比如工具书、方法论、实操课程。这类内容里有很多需要动手的序列步骤,听的过程中你需要停下来记,甚至停下来做。建议 1.0 到 1.2 倍,并且接受听一半、读一半的混合方式。
第四类是密度型,比如专业教材、论文解读、数据密集的行业报告。这类内容几乎每句话都含新信息,冗余度极低,它不适合纯听觉通道——不是慢不慢的问题,而是耳朵没法跳读、没法对照图表。这一类的结论很直接:回到文本,至多用音频做预习。
把这四类排成一行,你会得到一条清晰的适配线:冗余度越高,越适合音频,也越能承受倍速;信息密度越高,越适合文本,也越经不起倍速。这条线不是拍脑袋定的,它是从 CAPE 模型里推出来的——冗余度高意味着工作记忆有喘息空间,P 就可以往上调。
三遍法:把倍速从默认值变成可选项
如果你只想要一个能马上用的做法,我推荐三遍法。它不追求一遍听懂,而是把听和加工拆成三次不同的动作。
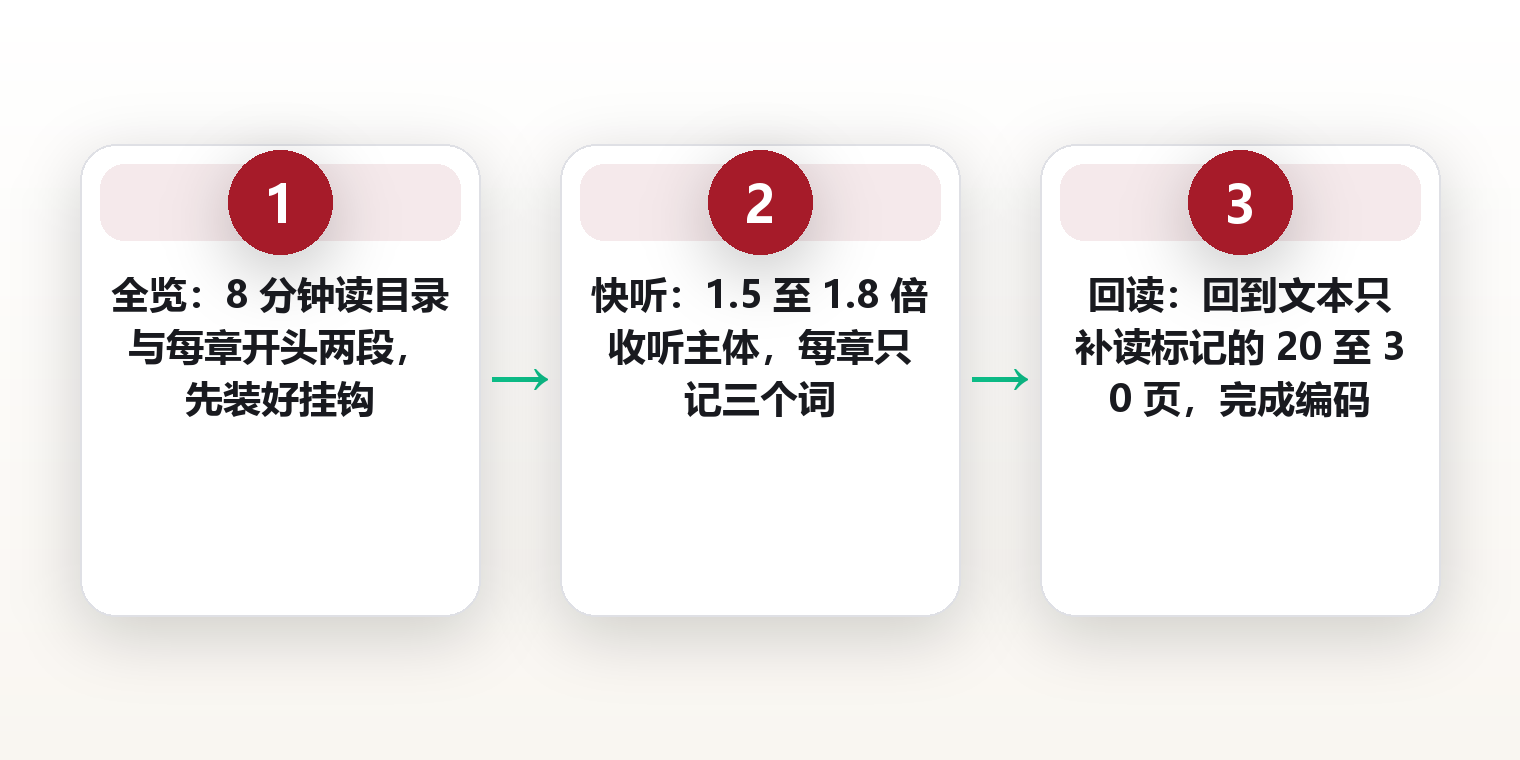
第一遍是全览,1.0 到 1.2 倍,甚至可以用目录或章节摘要代替。这一遍的任务只有一个:搞清楚作者的主干有几段、段与段之间是什么关系。全览一本 40 分钟的书,用 8 分钟读完目录和每章开头两段就够了。这一遍你不是在省时间,你是在给后面的快听装一个挂钩——没有挂钩,细节无处可挂。
第二遍是主体收听,1.5 到 1.8 倍。这一遍因为有第一遍的骨架,你的工作记忆不再需要同时处理结构和内容两件事,速度可以放心往上调。边听边做一件事:每章只允许写下三个词。三个词的限制会逼你去抓主干,而不是抄句子。
第三遍不是听,是回到文本。只看你在第二遍标记过的位置,通常是三个词勾不回来的那几段。对一本 300 页的书,这一遍往往只需要读 20 到 30 页。很多人跳过第三遍,于是三周后只剩下一句「这本书挺好看的」。
三遍法的总耗时,通常比从头到尾 1.0 倍听一遍多出 15% 左右,但留存率的差别值得这点投入。更重要的是它改变了倍速的位置:速度不再是收听前随手设的一个默认值,而是第二遍才出现的一个可选项。
播客和有声书,是两套耳朵
把播客和有声书当成同一种东西,是另一个很常见的误判。它们在信息密度和冗余度上几乎是相反的两极。
有声书是朗读。它把一个已经成稿的文本逐字念出来,句子经过了编辑,几乎没有口头冗余。这意味着单位时间内的新信息密度很高,也意味着它经不起太高的倍速。1.0 到 1.4 倍是多数人的舒适区,超过 1.5 倍之后,丢的往往不是细节,而是句子之间的逻辑连接词——「然而」「也就是说」「反过来看」,这些词恰恰是作者思考的关节。
播客是对话或口播。它有大量的语气词、重复、铺垫、跑题和自问自答,冗余度通常显著高于有声书。同样是 1.5 到 2.0 倍,播客的损失往往比有声书小得多。这也是为什么很多人听播客能开到 2 倍,听有声书开到 1.5 倍就觉得累。
但播客内部也要分层。独白型播客结构清晰,冗余度中等;访谈型播客的密度取决于嘉宾——遇到表达精炼的嘉宾,2.0 倍可能会漏掉不少;遇到习惯铺垫的嘉宾,2.0 倍反而刚好。一个简单的判断方法:听 5 分钟,数一数这 5 分钟里出现了几个新概念,超过 6 个就降 0.2 档。
还有一个容易被忽略的变量是口音与音质。非母语播讲、有背景音乐、地铁上的环境噪声,这三种情况都会额外占用工作记忆。同样的倍速,在安静房间里和早高峰车厢里,实际负担能差出一档。所以倍速不该是固定值,它应该是你在按下播放键那一刻,根据环境现场调出来的一个数。
四把尺子:把损失量出来
前面提过四个指标,这里把它们变成可以直接执行的动作。四把尺子的价值在于,它把「我是不是听懂了」这种模糊感觉,换成了四个能被记录的数字。
第一把尺子是 30 秒复述。每听完一章,暂停播放,用手机录 30 秒语音,讲出这一章讲了什么。回放时数一数你讲出了几个要点。如果一本书你预设每章有 3 个要点,实际只能讲出 1 个,那么当前的倍速对你来说已经超出了有效区间。
第二把尺子是 24 小时留存。第二天早上,在打开书之前,凭记忆写下昨天那一章的三个要点。公开记忆研究的经典量级是,无复习情况下 24 小时后的留存大致在 30% 到 40% 之间。如果你的数字明显低于这个区间,问题多半不在倍速,而在于你从来没做过提取练习。
第三把尺子是三词笔记。每章只允许写三个词,写在手机备忘录里。一周后回看,如果这三个词还能勾回整章的内容,说明编码是有效的;如果三个词变成了三个孤立的名词,说明你记的是标签而不是结构。
第四把尺子是回听触发率。这一把实时性很突出。每听 1000 字,如果你主动回拖超过 2 次,说明速度已经越过了你的拐点,你的大脑在反复发出「刚才那句没加工完」的信号。这一把的好处是不需要等到第二天,当场就能判断。
五个流行说法的边界
关于倍速,流传着很多听起来很有道理的说法。它们大多不是错的,而是缺了边界条件。把边界补上,这些说法才好用。
说法一:1.0 倍总是比倍速记得牢。边界在于,只有在你真的把注意力放在内容上时这个说法才成立。同样是 1.0 倍,一边刷手机一边听,效果通常不如专注地听 1.5 倍。注意力是 CAPE 里的 A,它比 P 更能决定结果。
说法二:倍速只影响细节,不影响主干。这个说法在 1.5 倍以内大致成立,到 2.0 倍以上就不成立了——丢掉的连接词会直接影响你对主干关系的理解,你记住的可能是一堆正确的碎片和一个错误的结构。
说法三:听一遍等于读一遍。这是很常见的误判。读的时候你会不自觉地停顿、回跳、在页边写东西,这些动作都是加工。听的时候如果没有刻意暂停,这些加工基本不会发生。所以听一遍更接近读的半遍。
说法四:越快越省时间。省下的时间会被回拖和重听吃掉一部分。一个简单的算法:一章 30 分钟,1.0 倍听完 30 分钟,1.5 倍听完 20 分钟,但如果需要回拖 6 次、每次 8 秒,实际是 20 分 48 秒,仍然省;如果回拖 20 次,优势就没有了。
说法五:倍速可以训练大脑,越练越快。这个说法有一半是真的:长期练习确实会提高你对高语速的耐受度。但耐受度不等于理解率——你能习惯 2 倍速的声音,不代表你在 2 倍速下的理解率能回到 1 倍速的水平。训练的是耳朵,不是加工深度。
常见问题
1.问:通勤时到底该开多少倍速?
答:先判断内容类型。叙事类和对话类播客可以从 1.5 倍起步,论述类 1.2 到 1.5 倍,技能型和密度型内容不建议纯听。然后用第四把尺子当场校准:听 5 分钟,如果回拖超过 2 次就降 0.2 档。不要设一个固定值常年不动,环境噪声变化时它应该跟着变。
2.问:倍速听过的书,需要重听一遍吗?
答:不建议整本重听,成本太高。更划算的做法是用三遍法的第三遍,只回到文本,读你在收听时标记过的那几段。通常一本书只需要补读 20 到 30 页,远低于重听一遍的时间。
3.问:孩子听有声书可以用倍速吗?
答:儿童的语音加工速度和词汇自动识别程度与成年人不同,同样的倍速对他们的负担更大。如果是为了培养兴趣,1.0 倍更合适;如果是复习已经熟悉的内容,可以适度提高到 1.2 倍。观察指标用回听触发率——孩子频繁要求再听一遍刚才那段,就是超速的信号。
4.问:倍速听音频和倍速看视频,损失的机制一样吗?
答:不完全一样。视频有画面通道,双重编码还能部分起作用,所以视频对倍速的耐受度通常高于纯音频。纯音频只有一个通道,一旦语音回路被挤爆就没有备份。这也是为什么同样 1.5 倍,看视频可能没感觉,听纯音频就开始漏。
5.问:有没有一个倍速对所有人都合适?
答:没有。CAPE 模型里只有 P 是你随手可调的,另外三个变量——你的状态、你的环境、你打算听到什么程度——每个人每天都不同。真正的普适解不是某个数字,而是那四把尺子:用它们量两周,你会得到属于自己的适配线。
图片来源:图1 hansbenn / Pixabay (CC0) · 图2 hansbenn / Pixabay (CC0) · 图3 hansbenn / Pixabay (CC0) · 图4 DeltaWorks / Pixabay (CC0) · 图5 Toby_Parsons / Pixabay (CC0) · 图6 janeb13 / Pixabay (CC0) · 图7 DRIVAR / Pixabay (CC0) · 图8 rofisch / Pixabay (CC0) · 图9 Hans / Pixabay (CC0) · 图10 Hans / Pixabay (CC0) · 图11 Kanenori / Pixabay (CC0) · 图12 4657743 / Pixabay (CC0) · 图13 Pok_Rie / Pixabay (CC0) · 图14 SplitShire / Pixabay (CC0) · 图15 WTM-Consulting / Pixabay (CC0) · 图16 Couleur / Pixabay (CC0) · 图17 WilliamCho / Pixabay (CC0) · 图18 sunnivalode97 / Pixabay (CC0) · 图19 allybally4b / Pixabay (CC0) · 图20 Alexas_Fotos / Pixabay (CC0) · 图21 mikuratv / Pixabay (CC0) · 图22 pen_ash / Pixabay (CC0) · 图23 dragh / Pixabay (CC0) · 图24 TerriAnneAllen / Pixabay (CC0) · 图25 zivica / Pixabay (CC0) · 图26 ewa69 / Pixabay (CC0) · 图27 lin2015 / Pixabay (CC0) · 图28 Sponchia / Pixabay (CC0) · 图29 jools_sh / Pixabay (CC0) · 图30 StockSnap / Pixabay (CC0) · 图31 Pezibear / Pixabay (CC0) · 图32 Foundry / Pixabay (CC0) · 图33 MiraCosic / Pixabay (CC0) · 图34 Dimhou / Pixabay (CC0) · 图35 MiraCosic / Pixabay (CC0) · 图36 focusonpc / Pixabay (CC0)
本文提及的研究数据为公开文献与公开报道的量级区间,用于说明趋势,不构成对个体学习能力的判定依据。
本文由 云上有品 整理发布,仅供个人学习方法参考。
评论(0)