基本信息
阅读时间:约 15 分钟
字数:约 6077 字
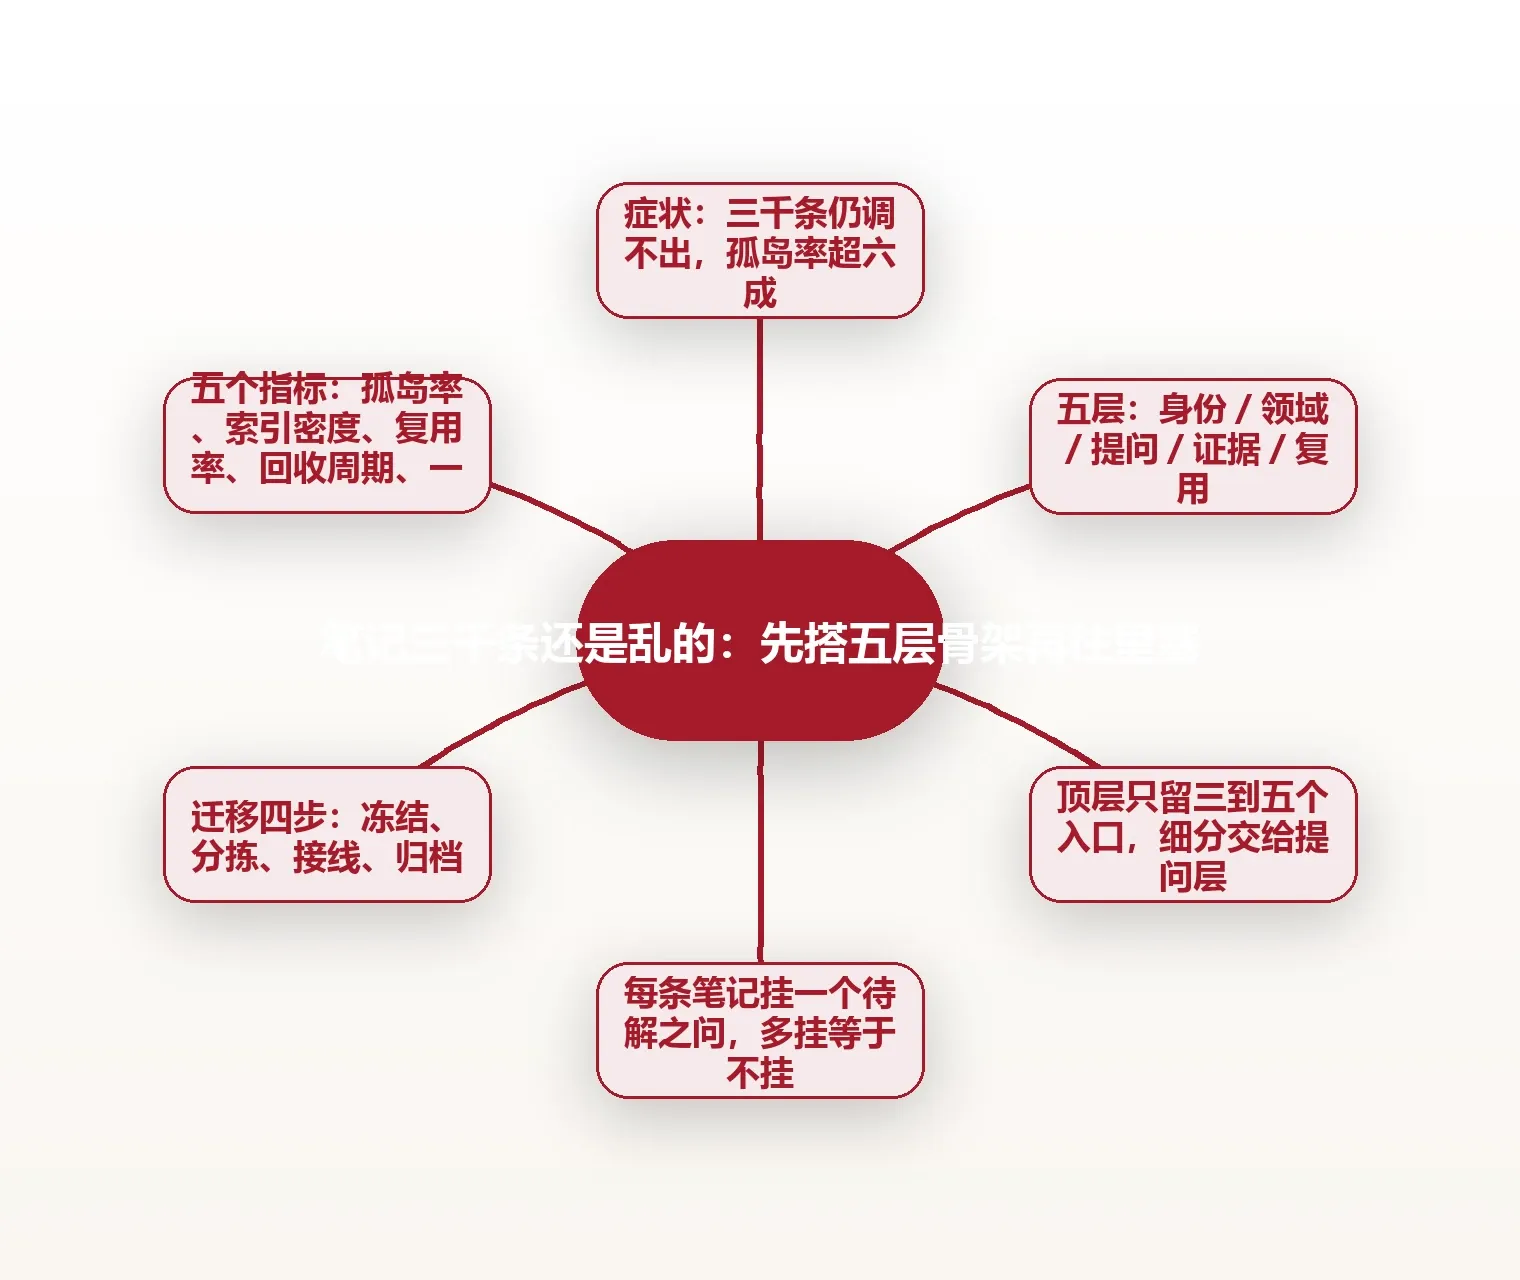
摘要:三千条笔记仍然调不出来,问题不在记录量,而在顶层骨架。用「五层骨架」(5LS)先定身份、领域、提问、证据、复用五层,再让笔记往里长:附量级数据、与 PARA/卡片盒的对比、五个度量指标、五步执行清单与四步迁移路径。
全文语音
中文
English
日本語
한국어
专业分析:存得越多,越调不出来
2025 年秋天,一位在深圳做硬件产品的读者把笔记库导出包发给我做诊断:3127 条笔记,46 个文件夹,118 个标签,最长的一条 9400 字,最短的一条只有「TF 卡选型」五个字。真正的问题不在数量,而在一份很朴素的统计——随机抽取 300 条笔记,其中 183 条在导出后 90 天内没有任何一次打开记录,占比 61%;有内部链接的笔记只有 214 条,不到 7%。他的原话是「我明明记了很多,为什么每次写方案还是要重新查一遍」。这句话恰好点出了分水岭:记录解决的是「有没有」,骨架解决的是「能不能在需要的那一分钟被取出来」。
先看三个量级,把「乱」这件事量化。其一,麦肯锡 2012 年发布的《The social economy》报告口径显示,知识工作者平均每天约 1.8 小时用于搜索与收集信息,接近工作周的两成(来源类型:咨询机构行业报告,量级约为两成工时);也就是说,检索成本不是摩擦,而是主要成本项。其二,卢曼(Niklas Luhmann)的卡片盒终身积累约 9 万张卡片,据此产出 70 余本著作与 400 余篇论文(来源类型:学术传记与档案馆整理统计,量级约为每千张卡片对应近一本书的产出);他的规模一直往上走,产出也一直往上走,从来没有出现过「三千条就乱」的断点。其三,艾宾浩斯遗忘曲线的经典结论是,无复习条件下 24 小时的留存约为三分之一(来源类型:实验心理学经典研究,量级约为一天丢掉三分之二)。三条数据合起来只有一个指向:损耗发生在「取用」和「回流」两个环节,而不是「录入」环节;继续加大录入,只是在放大损耗的基数。
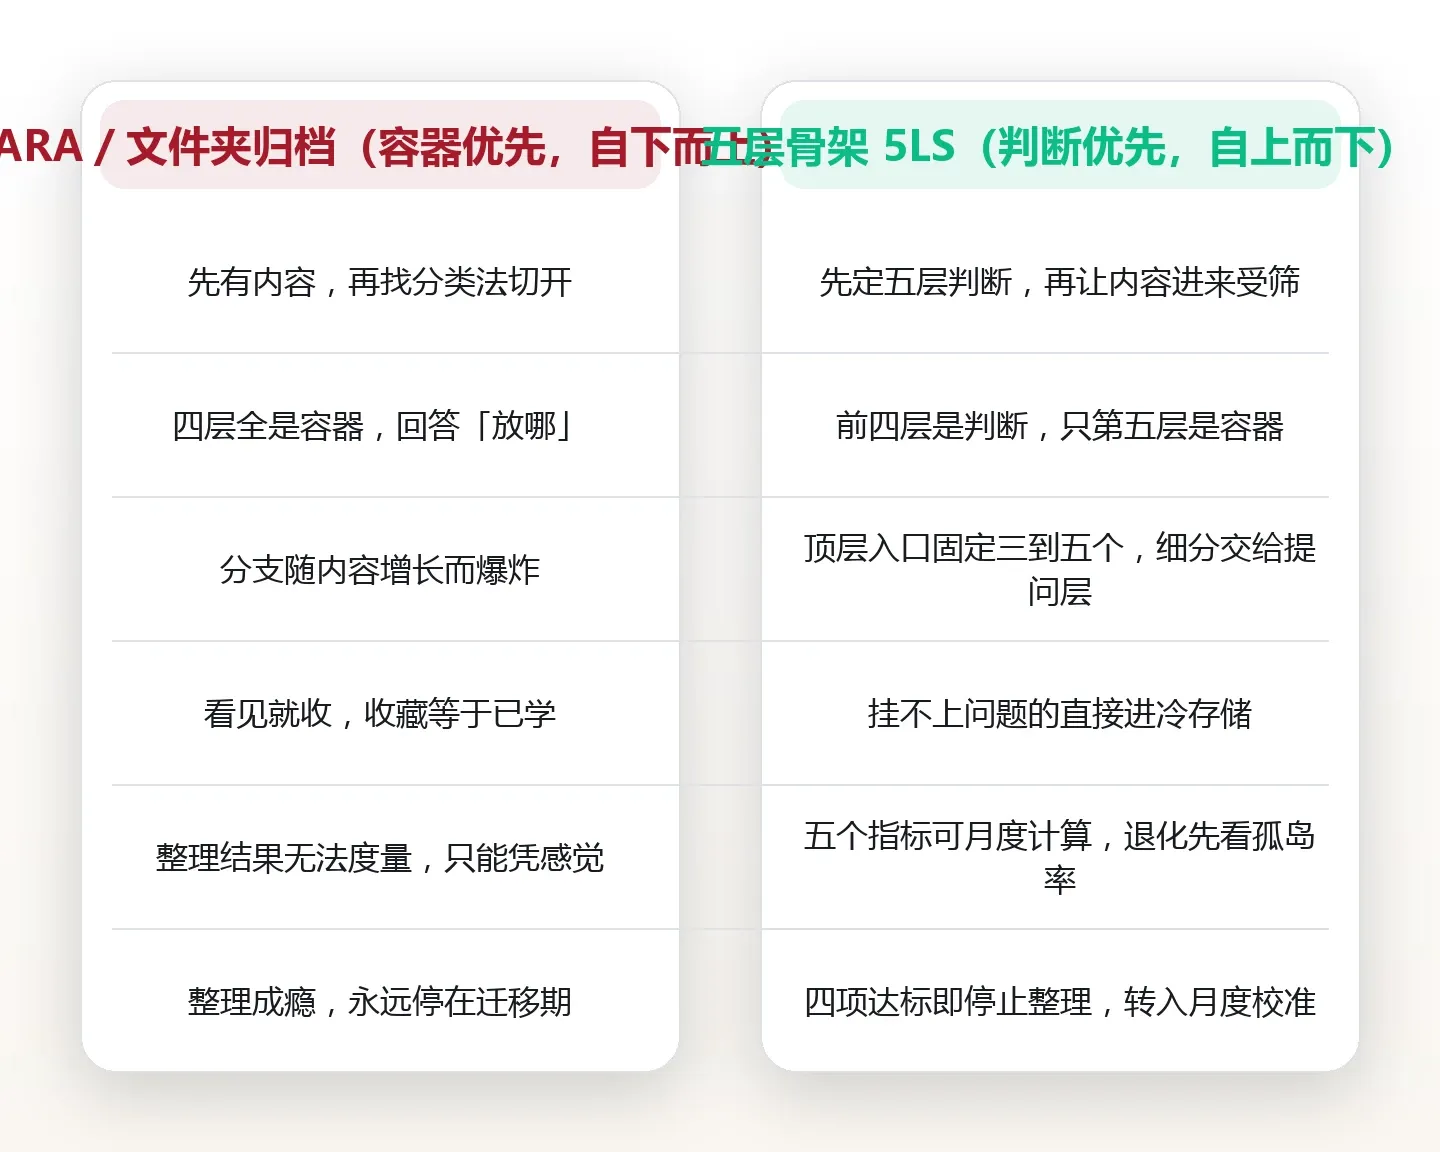
针对这一点,我把它整理成一个可命名的顶层框架——「五层骨架」(Five-Layer Spine,简称 5LS),自下而上分为身份层、领域层、提问层、证据层、复用层。它和流传最广的 PARA(项目/领域/资源/归档)最根本的差别在于:PARA 的四个格子都是「容器」,回答的是「这条笔记放哪」;5LS 的前四层都是「判断」,回答的是「这条笔记凭什么存在」,只有第五层才是容器。另一个常被拿来对比的是卡片盒(Zettelkasten),卡片盒的强项是连接与涌现,弱项是没有为「什么不该进盒」设门槛;5LS 把门槛前置到第二层和第三层,连接反而变成门槛的副产品。换句话说,PARA 让你把东西放整齐,卡片盒让你把东西连起来,5LS 先让你决定什么东西有资格进来。
案例可以看卢曼本人,但要看对。外界常把他描述成「靠双向链接涌现智慧」的浪漫样本,实际档案馆整理出的结构相当工程化:一是有主题词索引,二是编号采用「分支续号」而不是流水号,三是有独立的文献卡片层。三者对应到 5LS,恰好是领域层、提问层、证据层。他并没有三千条乱笔记,他有一套从第一天就在运行的骨架,卡片只是往骨架里长出来的枝叶。反过来看那位读者的库:46 个文件夹是按「来源」分的(微信、网页、PDF、课程),118 个标签是按「情绪」分的(重要、待读、灵感),两层都没有回答「我为什么需要它」。骨架缺位时,数量只会把混乱放大成噪音。
落地要先能度量。五个指标,每月花十分钟就能算:孤岛率(既无入链也无出链的笔记占比,健康区间低于 20%)、索引密度(每 100 条笔记的有效链接数,健康区间 60 至 120)、复用率(当季被引用进产出的笔记占比,健康区间高于 8%)、回收周期(从记录到首次被引用的中位天数,目标短于 45 天)、一次命中率(三次检索内找到目标的比例,目标高于 80%)。这五个数不需要任何插件,导出 Markdown 后用脚本统计即可;关键是每月看一次趋势,因为骨架的退化永远先体现在孤岛率上。
执行清单按顺序做,不要并行:第一步,冻结新增,一周内只读不记,切断「边整理边灌入」的死循环;第二步,写出一句话的领域声明,支柱不超过五根;第三步,从复用率最高的 50 条笔记开始,反向补问题锚点;第四步,把剩下没有被任何问题锚点认领的笔记整体移入冷存储,不删除、不整理;第五步,设置每月一次的骨架校准,只调指标不动内容。五步走完,通常能在一个月内把一次命中率从三成推到七成以上,而笔记总量一条都不会少。
五层骨架:先定顶层,再谈收纳
绝大多数人的整理是自下而上的:先有一堆笔记,再找一个分类法把它们切开。这条路在数量低于三百条时可行,超过一千条基本走不通,因为分类法的分支数会随内容增长而爆炸——46 个文件夹、118 个标签就是这么长出来的。顶层框架反过来:先用不超过一页纸决定「我长期要回答哪几个问题」,再让笔记进来接受筛选。骨架的稳定性来自它变化极慢,五年才需要改一次,而笔记的内容每个月都在变。
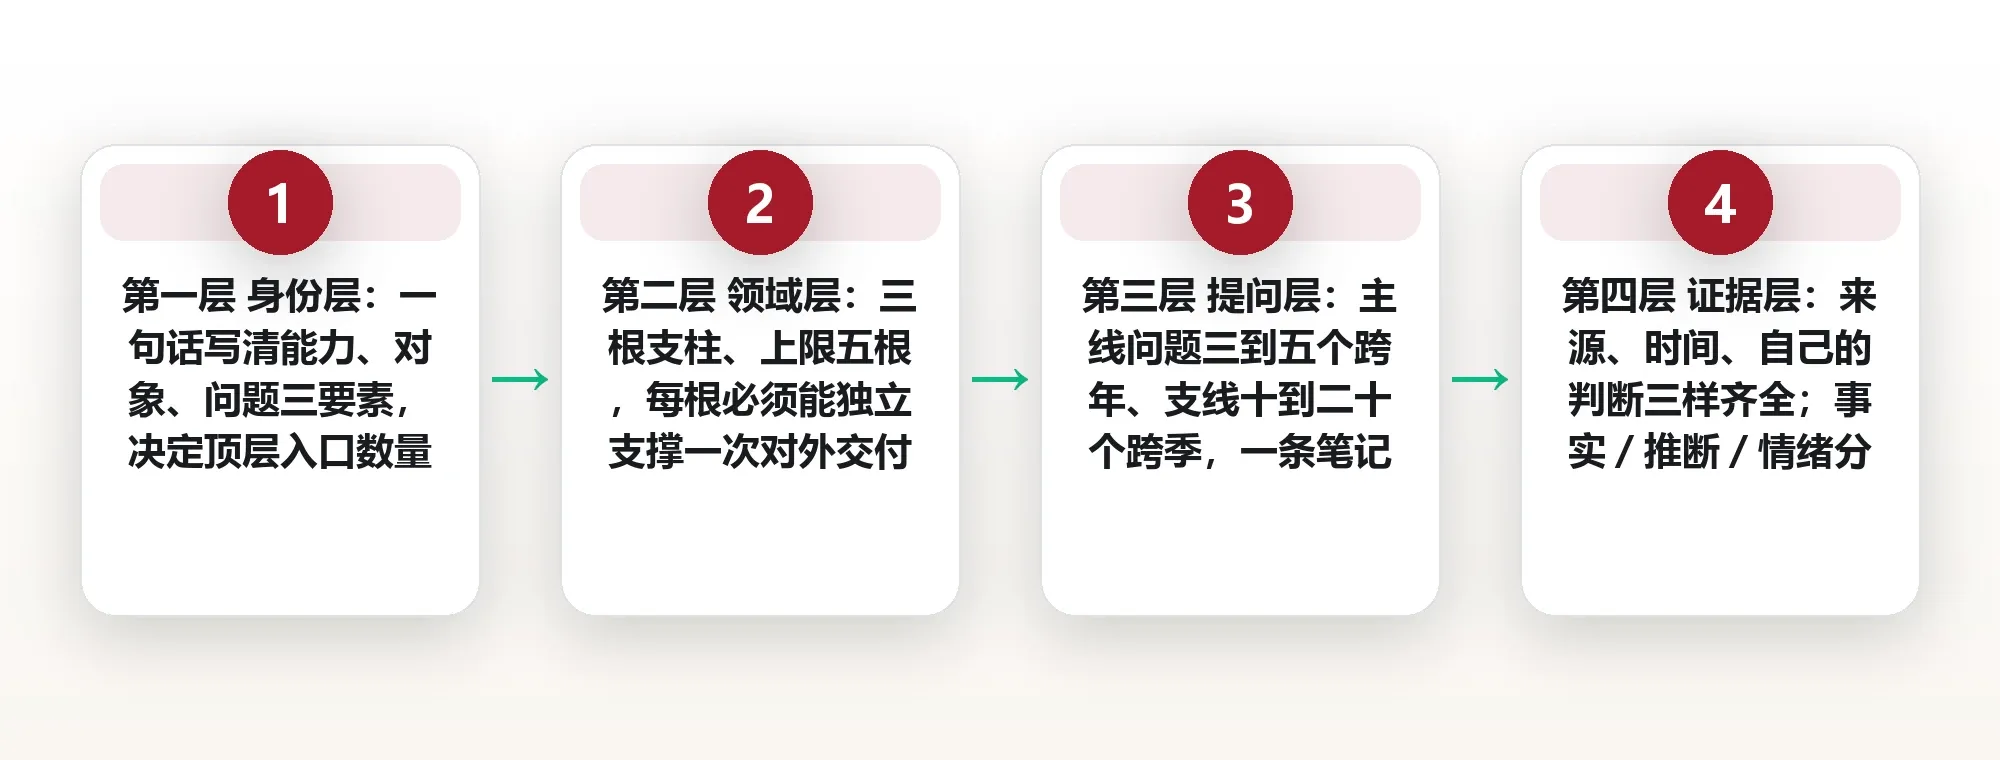
五层各管一件事,一句话能说清:身份层回答「我是谁、我服务谁」,决定入口的数量;领域层回答「我在哪三个方向上持续下注」,决定支柱的数量;提问层回答「这条笔记在解哪个具体问题」,决定笔记的颗粒度;证据层回答「这条笔记凭什么可信」,决定可复用的上限;复用层回答「它会在哪次产出里被调用」,决定它会不会变成孤岛。五层是串联关系,不是并列关系:上一层没定,下一层就会退化成标签游戏。
为什么顶层只留三到五个入口?工作记忆的容量约束是硬的。认知心理学里常被引用的「四±一」量级意味着,人在做即时判断时能同时握住的类别不超过四五个(来源类型:认知心理学综述,量级约为四项)。入口超过五个,选择成本会超过收纳收益,人就会退回「先扔进去再说」的默认行为。所以宁可粗,不可细;细分交给第三层的提问去承担。
另一个常见误区是把骨架当成建筑图纸,画得越精细越好。骨架的作用不是描述所有内容,而是拒绝大部分内容。一个能用的骨架,验收标准很朴素:三秒钟能判断一条新笔记该不该进、该进哪一层;如果需要想五分钟,说明这一层设计得太细了。判断口径可以极简——这条笔记能不能挂到某个具体问题上?挂不上就去冷存储;挂得上但找不到证据,就先留在提问层待补。
要接受一件事:骨架定下来之后,绝大多数旧笔记是「不进来」的。这不是浪费,而是筛选的正常结果。三千条笔记里真正有价值的部分往往只有两三百条,其余是当时的情绪、临时的链接、重复的摘抄。骨架的价值恰恰在于它敢让九成内容留在外面,把注意力压在那剩下的一成上。
身份层:一句话决定入口数量
身份层只需要一句话:我用什么能力,为谁,解决哪一类问题。例如「我用供应链建模能力,为中小制造商,解决库存周转与交付承诺之间的矛盾」。这句话看起来虚,但它直接决定入口数量——只服务一类人,入口就只需要一个;服务三类人,入口最多三个,绝不能更多。
身份陈述有三种典型错位。把职位当身份,换岗即失效;把兴趣当身份,兴趣迁移则骨架整体崩塌;把平台当身份,离开平台就一无所有。可用的身份陈述必须同时包含「能力、对象、问题」三个要素,缺一项,这套骨架大概撑不过一年。
身份层还能治「收藏幻觉」。收藏的本质是「我未来可能用得上」,而身份层把它换成「我未来一定会用在哪」。前者没有边界,后者有边界。一个人如果写不出身份声明,问题通常不在知识管理,而在方向;这种情况下再精巧的骨架,也只是把迷茫整理得更好看。
具体动作是把身份卡写在库的首页,不超过 60 字,每次想加一个新领域之前先读一遍。这条建议在读者反馈里最容易执行,也最容易被跳过,因为它不像「整理」那样有即时反馈。但它决定后面四层的全部边界。
身份会变,所以每 12 个月复核一次。身份变化时,允许把旧层保留为「历史层」——不删除,但降权、不进主索引、不参与推荐。这样迁移成本可控,也不会因为一次转向就把过去全部作废。
领域层:三根支柱,多于五根等于没有
领域层就是支柱。经验值是三根,上限五根。为什么不是越多越好?因为每增加一根支柱,你要维护的索引、要跟踪的信源、要更新的判断都会线性增加,而一个人的可持续维护带宽是有限的;超过五根,通常会出现「每根都懂一点、每根都不能交付」的状态。
判断一根支柱是否合格,标准是它能不能独立支撑一次对外交付——一次方案、一篇文章、一次咨询、一个产品功能。支撑不了,说明它还是兴趣,不是支柱。兴趣可以无限多,支柱必须能被交付验证,这是两者唯一可靠的分界线。
三根支柱之间最好有一个共用的底层能力,这样跨支柱的连接才有意义。比如做供应链的人,三根支柱可以是库存模型、供应商谈判、履约数据,共用的底层是「约束条件下的取舍」。有共用底层,跨支柱的笔记才能互相喂;没有共用底层,所谓跨领域只是并置,看上去很宽,实际互相不动。
支柱的命名要能被检索,且不含情绪。「成长」「思考」「杂项」这类词必须禁用,因为它们既是分类又是垃圾桶,任何东西都能塞进去。好的支柱名字通常带一个动词和一个对象,比如「拆解库存模型」「跟供应商谈年度框架」。
领域层每年做一次动作:统计每根支柱在过去一年的产出量。产出为零的支柱降级为兴趣,产出集中在少数几件事上的支柱则考虑再切分。这一步不做,骨架会在三年内变成一张好看但没人用的地图。
提问层:每条笔记挂一个待解之问
骨架里最容易缺、也最决定成败的是第三层。领域层给出的是方向,提问层给出的是抓手。一条笔记如果没有挂在一个具体问题上,它就只是一段被保存的文字,权重等同于零。
问题的合格标准是具体、可验证、有时限。好问题长这样:「在订单波动正负三成的情况下,安全库存该按周还是按双周复核?」坏问题长这样:「如何做好库存管理?」前者可以挂五十条笔记并最终收敛成一个答案,后者会吞掉五千条笔记且永不收敛。
提问层要分级:主线问题三到五个,跨年;支线问题十到二十个,跨季;临时问题随时开随时关。只有主线与支线进骨架,临时问题用完即归档。这一条能挡掉七成左右的碎片涌入,效果比任何过滤器都好。
一条笔记只挂一个问题。多挂等于不挂。如果一个想法确实同时服务两个问题,就写成两条,各自表述侧重。这个动作看起来笨,但它保证了检索路径唯一——路径一旦分叉,人就会在岔口反复犹豫,最后干脆不检索。
提问层每季度清理一次:已解决的问题沉淀成一条「结论卡」,问题本身归档。这样骨架不会随时间膨胀,反而会越来越薄。骨架变薄的速率,是可以用来判断这套系统是否在运转的一个侧面信号。
证据层:一条合格笔记的最低配置
一条笔记能不能被复用,取决于它有没有携带证据。没有证据的笔记,每次复用都要重新验证一次,验证成本等于重做,于是它必然变成孤岛。这就是为什么很多人的库里躺着大量「看起来很有道理」的摘抄,却一条也用不上。
可接受的证据大致四类:原始数据(截图、导出表、日志)、一手引用(原文页码、访谈记录)、可复现的操作步骤、明确的来源与时间。最低配置是「来源、时间、一句自己的判断」,三样齐全才算合格笔记。三样缺一样,就先别标为已整理。
在笔记里要把事实、推断、情绪分开。事实写「据某年某报告」,推断写「我判断」,情绪写「我感觉」。这个习惯的价值在于,半年后回看时你知道自己当时是在哪个层面下的结论,不会被自己当年的语气带偏。
证据会衰减。数据会过期,方法不会。给数据类笔记标一个显式的有效期,到期自动降级为「历史参考」,可以继续引用但要注明时点。这是防止用三年前的结论指导今天决策的最低成本手段,也是很多人反复踩的坑。
现在大量笔记是对话产物,尤其要标注「未经核实」。把模型输出直接当证据,是当下最高频的隐性污染:它读起来通顺、结构完整、引用看似严谨,但可能整段是生成的。凡是来源无法回溯到一手材料的内容,一律先放进待核区。
复用层:从存档到产出的一次闭环
前四层都是投入,第五层才产生价值。复用层只回答一个问题:这条笔记会在哪次交付里被调用?答不上来,它就不该长期占用索引位置。这不是功利,而是让知识管理有一个能自我维持的理由。
复用有三种形态:直接引用,原文进方案;结构复用,框架进模板;反例复用,作为反驳材料。第三种最容易被忽略,却往往最有价值——一条能当反例的笔记,说明你已经形成了判断,而不只是收集了信息。
机制上要从产出倒推,而不是从笔记找用途。做法是列出未来 90 天要交付的五件事,给每件事反向建一张「弹药清单」,再从库里挑笔记填进去。填不满的地方就是知识缺口,比任何自我评估都准。
复用率是骨架健康度的领先指标。孤岛率上升,通常出现在复用率下降之后的两个月;所以每月先看复用率,能提前一个季度发现问题,而不是等到某次交付彻底卡住才回头整理。
从复用到复利,关键是回写。每次交付结束后,至少把新增的判断写成一条结论卡,挂回对应的问题上。一次交付如果只消耗知识、不生产知识,那它对你的库来说是净流出,长期看库会越来越空。
三千条旧笔记的迁移:冻结、分拣、接线、归档
第一步是冻结。第一周只读不记,理由是显而易见的:一边整理一边灌入,等于在漏水的桶里舀水。冻结期还会带来一个副作用——你会发现大部分「必须马上记下来」的冲动,其实三天后就消失了。
第二步是分拣,但不要逐条读。按「最近 12 个月打开过/没有打开过」先切两堆,前者进候选池,后者整体进冷存储。经验上这一步能砍掉六到八成,而且几乎不会误伤,因为真正在用的笔记不可能一年都不碰。
第三步是接线:给候选池里的每条笔记补一个提问锚点,补不上的降级处理。这一步最慢,建议每天 30 条,两周完成。慢是必须的,因为接线本质上是在做判断,判断没法批量。
第四步是归档与冷存储策略。冷存储不是删除,而是降权:不进搜索主索引、不参与推荐、不被随机召回。保留它的理由很实在——有些笔记的价值要三年后才出现,删掉就再也没有了,而降权的成本几乎为零。
迁移后的验收看四个数:孤岛率、索引密度、复用率、一次命中率。四项达标就停止整理,转入月度校准。很多人卡在「总觉得还能再整理一点」,结果永远在迁移期,从未进入使用期,这是最贵的失败方式。
常见问题
1.问:三千条笔记一定要全部整理完吗?答:不需要,也不应该。迁移的目标不是让每条笔记都归位,而是让「需要时能取到」的比例升上去。按上面的四步走,真正进入骨架的通常只有两三百条,其余留在冷存储里不碍事。整理的目标是可用,不是整洁。
2.问:五层骨架和 PARA、卡片盒能不能一起用?答:可以,但顺序不能反。先用 5LS 定骨架和门槛,再用 PARA 管项目周期内的临时聚合,用卡片盒管连接与涌现。反过来先建 PARA 文件夹,你会发现文件夹数量会随内容爆炸,最后还是回到「不知道放哪」的老问题。
3.问:写不出身份声明,还能先搭骨架吗?答:可以先搭下面两层。身份层缺位时,领域层最多定到「我在学什么」,提问层照样可以正常运转。但要知道,缺了身份层,骨架会偏向「输入型」,长期容易变成只进不出;等方向清楚了,第一件事是补上这句话。
4.问:用 Notion、Obsidian 还是飞书,会影响骨架吗?答:几乎不影响。工具决定的是操作的摩擦,骨架决定的是判断的顺序。同一个人在三个工具里搭同一套 5LS,效果差异主要来自他愿不愿意每天花十分钟接线,而不是来自软件本身。先用顺手的,别为了骨架换工具。
5.问:多久校准一次,一次花多久?答:每月十分钟看五个指标,每季度一次大清理,每年一次身份复核。三条时间线叠在一起,全年投入不到二十小时。如果某个月发现校准要花两小时以上,说明骨架设计过细,应该砍层而不是加人加时间。
图片来源:图1 terski / Pixabay (CC0) · 图2 Felix-Mittermeier / Pixabay (CC0) · 图3 Agape-frequency / Pixabay (CC0) · 图4 AndreaGibhardt / Pixabay (CC0) · 图5 qimono / Pixabay (CC0) · 图6 dimitrisvetsikas1969 / Pixabay (CC0) · 图7 Annabel_P / Pixabay (CC0) · 图8 Tama66 / Pixabay (CC0) · 图9 Leonhard_Niederwimmer / Pixabay (CC0) · 图10 quangnaruto / Pixabay (CC0) · 图11 terski / Pixabay (CC0) · 图12 652234 / Pixabay (CC0) · 图13 Pexels / Pixabay (CC0) · 图14 LisaRedfern / Pixabay (CC0) · 图15 Julius_Silver / Pixabay (CC0) · 图16 BMeyendriesch / Pixabay (CC0) · 图17 KELLEPICS / Pixabay (CC0) · 图18 xusenru / Pixabay (CC0)
本文为信息分享与方法论科普,不构成任何专业建议,请结合自身情况判断。
本文由 AI 生成,经人类主编终审。
评论(0)