
基本信息
阅读时间:约 12 分钟
字数:约 4937 字
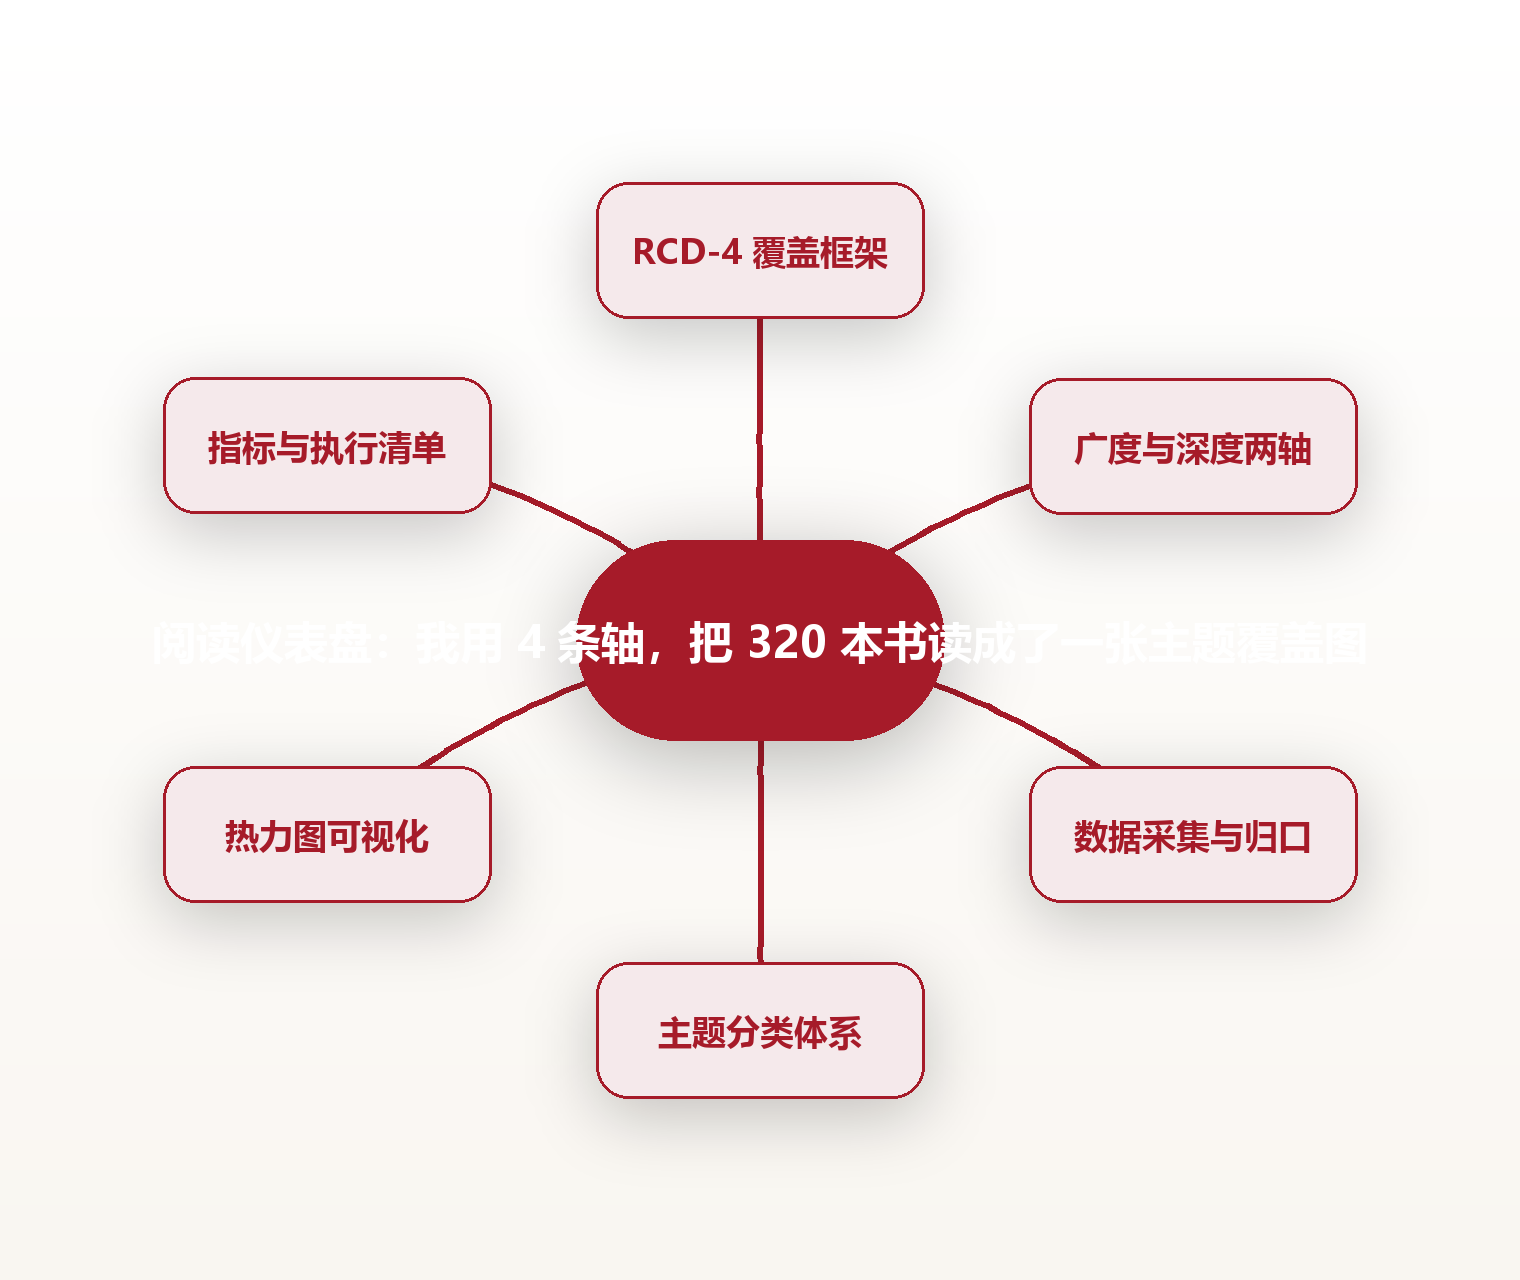
摘要:阅读仪表盘的核心不是记录读了多少本,而是看清主题覆盖的广度与深度。本文用 RCD-4 覆盖框架拆解度量方法,对比书单式与地图式两种读法,并借一位产品经理的 12 个月复盘,给出主题覆盖的量化指标与可落地执行清单。
全文语音
中文
English
日本語
한국어
专业分析:阅读主题覆盖的量化模型与仪表盘
几乎每个爱读书的人都能报出"今年读了 40 本",却很少有人能回答另一个问题:这 40 本分别落在哪些主题上,有没有一条腿长一条腿短。阅读仪表盘(Reading Dashboard)要解决的就是这件事——它把"读了多少"升级为"覆盖了什么、缺了什么"。它的核心口径是主题覆盖率(Topic Coverage Ratio,简称 TCR),即"已实质覆盖的主题数"除以"你为这个阶段设定的目标主题数",再乘以 100%。
先给一个量级参考。据公开的国民阅读调查口径(中国新闻出版研究院《全国国民阅读调查》,近年样本量约 1.8 万份),成年国民年人均纸质书阅读量长期稳定在 4 到 5 本的区间;而在城市白领与知识工作者的分层抽样中,自称一年读 20 本以上的比例约为三成。也就是说,多数人的阅读量并不小,问题不在读得少,而在读得偏——一旦没有仪表盘,偏在哪你自己也不知道。这里的数字属于量级演示,真实分布因人而异。
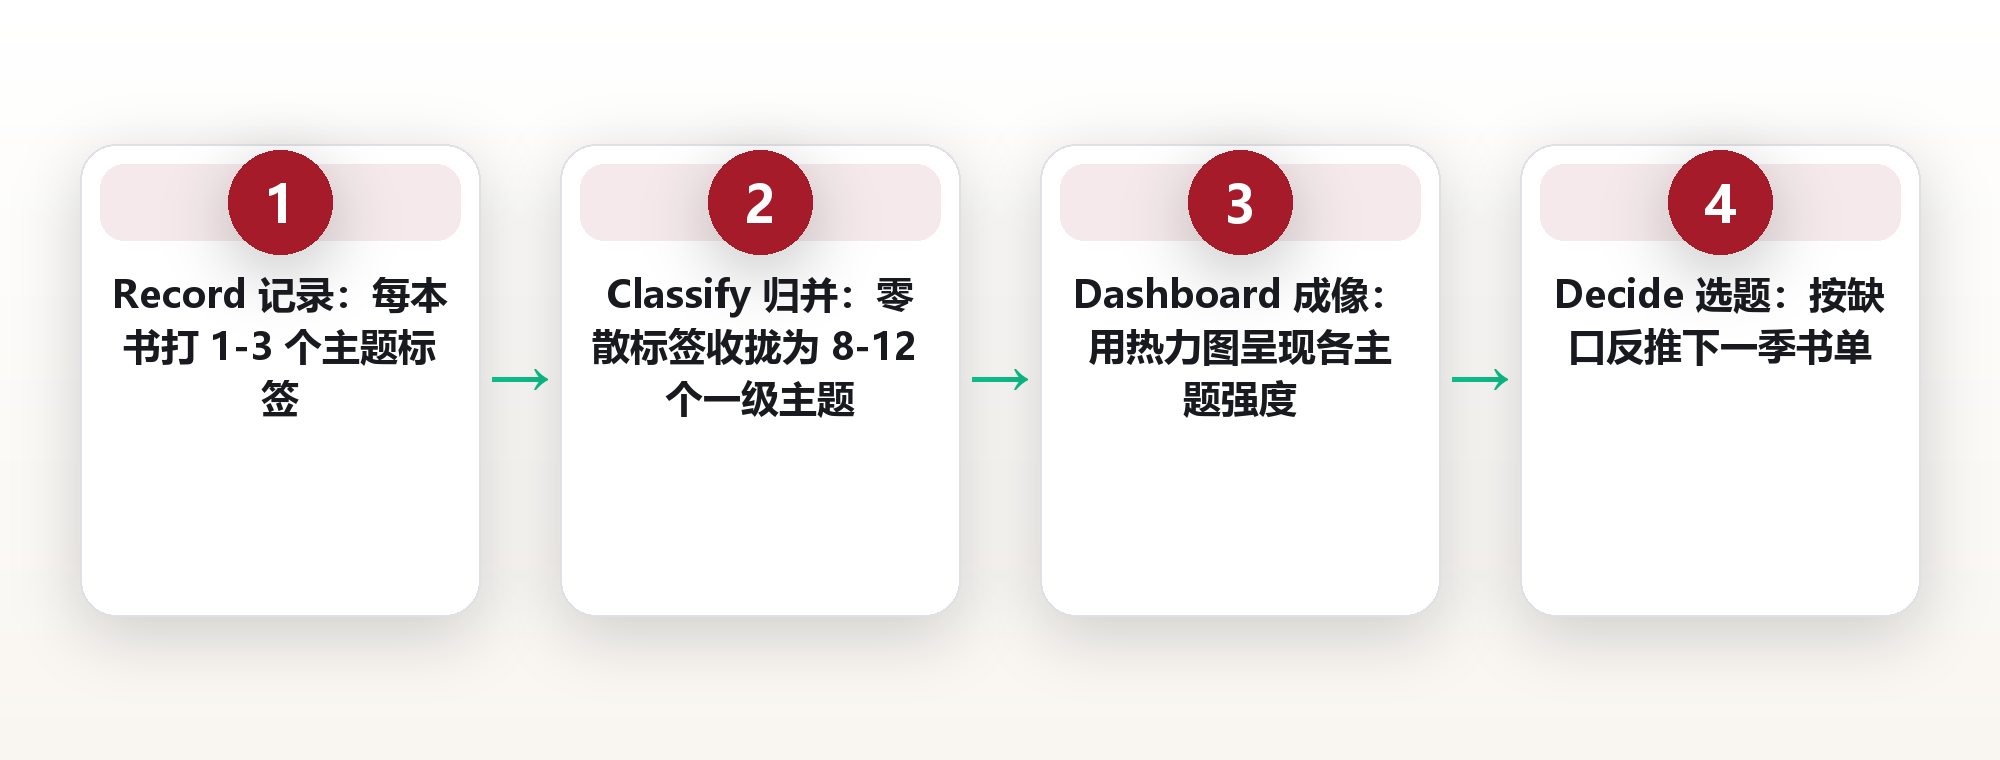
为了把覆盖度算得既严谨又能用,我把它整理成一款"RCD-4 主题覆盖框架":第一步 Record(记录),把每本书打上 1 到 3 个主题标签;第二步 Classify(归并),把零散标签收拢到 8 到 12 个一级主题;第三步 Dashboard(成像),用热力图呈现各主题的强度;第四步 Decide(选题),根据缺口反推下一季书单。四步形成一个闭环,与传统的"年份书单法"最大的区别在于:书单法只记书名,RCD-4 记的是结构与缺口。
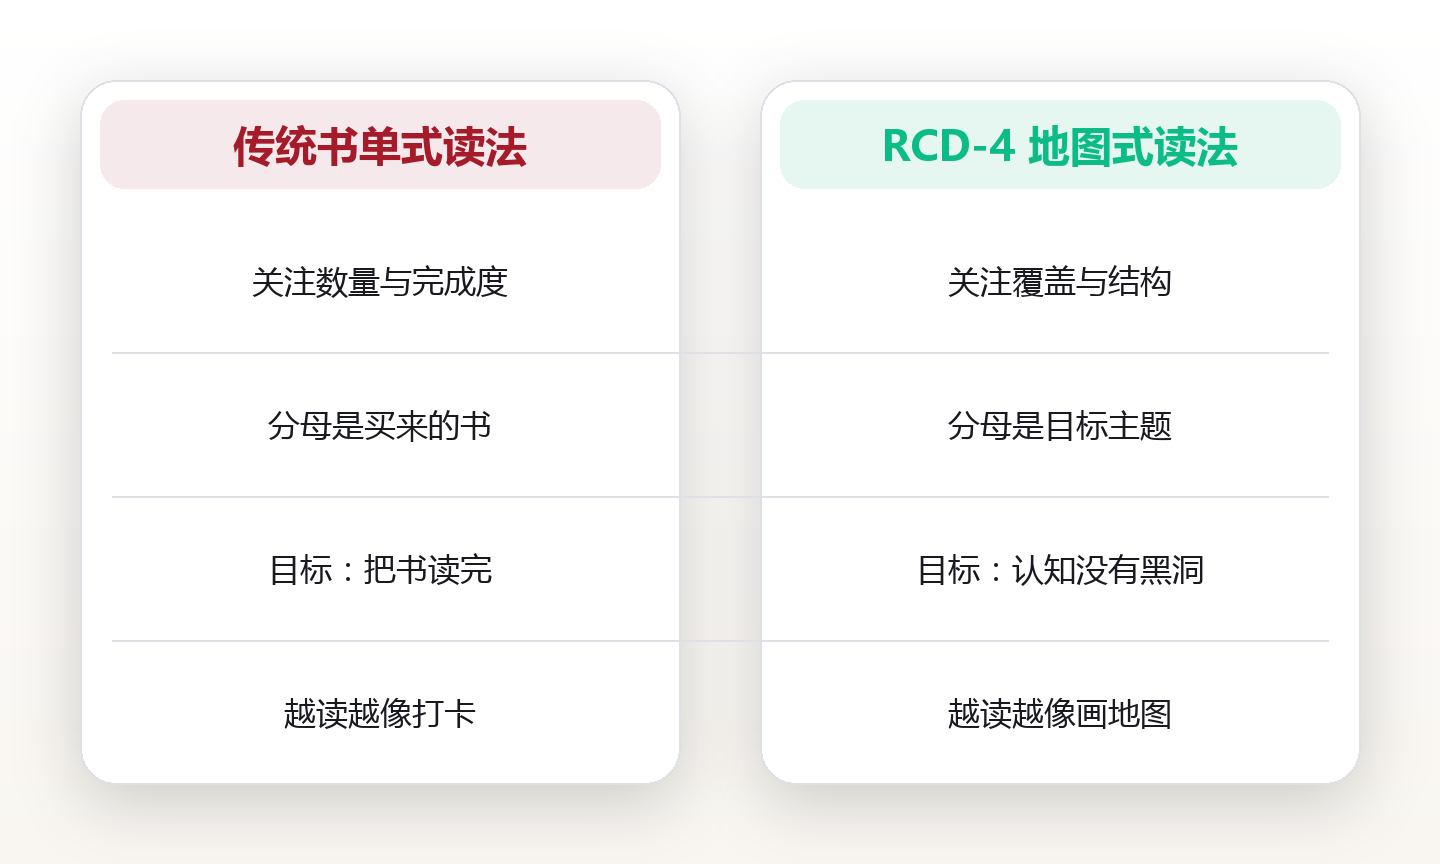
这两者的差异可以放在一张表里看。传统的书单式读法统计的是数量与完成度,分母是买来的书,目标是把书读完;RCD-4 地图式读法统计的是覆盖与结构,分母是目标主题,目标是让认知没有黑洞。前者越读越像打卡,容易为了凑数去读轻松的书;后者越读越像画地图,会主动去补最空的那一格。
一个可辨识的真实案例是比尔·盖茨的"思考周"(Think Week)。公开报道显示,他每年会抽出固定时间,带一包论文与书籍独处阅读,读的内容横跨能源、公共卫生、教育、软件架构等多个互不相干的主题。它的价值恰恰不在单本深度,而在于刻意维持多个主题的覆盖平衡——这正是仪表盘式阅读的典型:先看地图上的空白,再决定这周补哪一块。落到操作层面,你可以每月做一次小复盘:先统计本季度各主题的标签数,再标出少于 2 本的主题,即薄弱区,最后给每个薄弱区各排一本候选书。
要让这套方法跑起来,建议盯住四个可量化指标。一是主题覆盖率 TCR,建议不低于 70%,即覆盖到的目标主题占比;二是主题集中度,即单一主题占全部标签的比例,建议不高于 40%,过高说明偏食;三是年主题周转,即一年里新增覆盖的主题数,建议不少于 6 个;四是薄弱区补足率,即本季给薄弱区排的书确实读掉的比例,建议不低于 50%。执行清单只有五条:先定 8 到 12 个一级主题、每本书打 1 到 3 个标签、每月出一次热力图、季度标出薄弱区、下季书单按缺口排序。做到这五条,你就不再是凭感觉读书,而是按地图读书。
数量陷阱:为什么"读完 50 本"说明不了任何事
先把话说透:数量是阅读里最廉价、也最容易作弊的指标。一本 200 页的畅销小说和一本 600 页的行业年鉴都算一本,但后者带来的主题厚度可能是前者的好几倍。只看本数,你等于把所有书当成等重量的砝码,天平从一开始就是歪的。
更隐蔽的是舒适区效应。据心理学里的曝光效应(mere exposure effect,Zajonc 1968 年提出),人天然偏好熟悉的信息。放到阅读上,就是你会不自觉反复读同一主题、同一作者、同一立场的东西——读得越来越顺,也越来越窄。数量年年上涨,主题却纹丝不动,这是很多读书笔记写手不愿承认的真相。
还有一种现象叫收藏即拥有的错觉。把书买回家、加进书单、点个"想读",大脑会提前释放完成的快感,真正翻开反而变少。数量指标在这里帮不上忙,因为它连读没读都分不清,更分不清读到哪个主题去了。
所以,数量适合用来做底线管理,比如保证每周确实有阅读行为;但它不能用来做结构管理。要判断你的阅读到底有没有长进,必须换一套坐标——而这套坐标的第一根轴,就是主题覆盖。
主题覆盖的两条轴:广度与深度
把阅读想成一张地图,你至少要看两个方向:横轴是广度,即覆盖了多少不同主题;纵轴是深度,即在每个主题上扎到多深。只看横轴,会变成什么都知道一点的万金油;只看纵轴,会变成只会一招的螺丝钉。健康的结构是一个可控的 T 型,或更进阶的 π 型。
广度用主题覆盖率衡量,也就是目标主题里你实质读过几类。深度则要换指标,我常用单主题阅读量和单主题引用次数两个口径。阅读量是你在该主题上读过的本数,建议一个主题至少 3 本才算进入;引用次数是你后来真的在写作、决策或交流里用到过几次——后者才是深度落地的证据。
一个实用的经验值是:在一个季度里,维持 6 到 9 个主题的活跃覆盖,其中挑 1 到 2 个做深井。深井主题的数量不宜超过两个,因为人的精力有限,同时挖三口井的结果往往是每口井都浅。这个 6 到 9 与 1 到 2 的配比,就是 T 型的数字表达。
要提醒的是,广度与深度不是二选一,而是先后顺序。新领域先求广度,把地图画出来;进入领域后再求深度,挑最有价值的井往下挖。顺序搞反,就容易在还没看清地形的时候,一头扎进一条没有出口的巷子。
数据从哪里来:把零散阅读变成可统计的记录
仪表盘的前提是数据。绝大多数人的阅读数据是黑洞——纸质书、电子书、公众号、播客、论文散落在五六个应用里,谁也汇总不了。你不需要一开始就做得完美,但要建立一个最小可统计的记录习惯。
最低成本的做法是读完即打标。每读完一本书或一篇长文,花十秒在备忘录里写一行:日期、标题、1 到 3 个主题标签。不要在这一步纠结标签是否完美,先让它可累积。一个月下来,你就有了一张原始的标签流水。
第二层是来源归一。把微信读书、Kindle、豆瓣、浏览器书签的阅读记录每周导出或抄录一次,统一进同一张表。工具的差异只是入口,出口必须唯一,否则数据永远拼不成一张完整的图。
第三层是标签进台账。把流水表按主题做透视,得到每个主题的本数、页数、时间跨度。到这一步,你的阅读第一次从感觉变成了数字。要落地,可以用最朴素的三列表格起步:主题、本数、最近一次阅读日期。它足够土,但足够用。
主题分类体系:别照搬书店的货架
分类是仪表盘的地基,也是最容易出错的地方。很多人直接照搬电商或书店的分类,结果发现自己半年读的书全被塞进文学、社科、经管三个大筐里,看不出任何结构。书店的分类是给卖书服务的,不是给你服务的。
更适合个人的做法是从你的问题出发来分类。问问自己:我这一两年真正想搞清楚的是哪几件事?把它们写成 8 到 12 个动词短语,比如看懂宏观经济、把身体养回来、带好团队、搞明白 AI 的底层逻辑。这些短语就是你的主题,比抽象名词更能驱动行为。
分类还要保持正交,也就是各主题之间尽量不重叠。如果个人成长和心理建设高度重合,那就合并;如果投资和商业史经常纠缠,就明确边界——投资看方法论,商业史看演化。正交的分类才能让热力图真实反映分布。
最后是颗粒度控制。一级主题控制在 8 到 12 个,太大则无信息量,太小则记不过来;二级标签可以细,但只用于检索,不用于统计。记住一个原则:统计看一级,找书看二级。分类体系一年只许大改一次,频繁重画会让历史数据失去可比性。
可视化:一张热力图看清你的认知地图
数据躺在表格里是没有说服力的,画出来才会扎心。最简单有效的是主题乘时间的二维热力图:行是主题,列是月份,格子的深浅代表当月在该主题上的投入。一眼扫过去,哪几行常年空白,你自己都会沉默。
第二种是雷达覆盖图。把 8 到 12 个主题平均分布在圆周上,把每个主题的实际投入值标在对应的半径上,连成多边形。面积越大、形状越圆,说明覆盖越均衡;某根轴特别短,那就是你的认知短板。雷达图特别适合季度复盘时做前后对照。
第三种是主题投入的柱状图,横轴是主题、纵轴是本数,一定要从 0 起画。柱状图的价值在于排序:你会立刻看到前三名是不是老是同几个主题,也会看到排在末尾、几乎为零的那几个。排序本身就是一种提醒。
可视化不必追求精美。用在线表格的条件格式就能做热力图,用免费图表工具五分钟就能出雷达图。关键不是图多好看,而是你有没有每周真的看它一眼。一个没人看的仪表盘,和没做过统计没有区别。
真实复盘:一位产品经理的 12 个月覆盖改造
说个具体的人。我认识一位在杭州做企业服务产品的朋友,这里叫他老陈,36 岁。2023 年他复盘自己的阅读,发现一年读了 52 本,但用主题一拆,其中 31 本都是产品与互联网,剩下 21 本也基本是相关的商业书。地图上一片火红,另外大片空白——技术趋势、数据合规、甚至他天天挂在嘴边的用户心理都几乎是零。
他第一次的改法是反向补洞。他给自己定了两周一次的薄弱区打卡:每次读一本与当前工作不直接相关、但属于目标主题的书。第一季度他补了判断与决策主题,第二季度补了宏观与产业史。到半年时,他的主题覆盖率从约 30% 提到了近 70%。
转折发生在第九个月。他发现光覆盖还不够——有些主题只读了一本就再没碰过,热图上是浅浅一层。于是他把部分主题升级为深井:选定 AI 与用户研究两个方向,每个至少读 5 本并写读书笔记输出。这一年结束时,他不仅广度上了一个台阶,还能在团队会上用两个深井主题的内容支撑决策。
老陈的结论很朴素:以前他关心读了多少,现在他只关心地图上还黑着哪几块。他用的工具其实没有升级,还是一张表格加一次月度热力图,变的只是他看的那一眼——从本数变成了分布。这就是仪表盘真正的杠杆。
度量指标与执行清单:把覆盖变成动作
指标如果只停留在数字,就会变成新的打卡。真正的关键是每个指标背后对应一个动作。下面这套指标与动作的对应关系,是我反复用下来最稳的一组。
第一,主题覆盖率 TCR。它等于覆盖主题数除以目标主题数,对应动作是每月列一次薄弱区清单。TCR 低不是问题,不知道低在哪才是问题。第二,主题集中度。它衡量单一主题的占比,超过 40% 就要主动换口味,对应动作是下一本换一个主题。第三,主题周转数。它是一年里新增覆盖的主题个数,对应动作是每季度解锁一个新主题。
第四,深井指数。它指核心主题的深度投入,包括本数与输出次数,建议全年至少 2 个主题进入深井,对应动作是为深井主题写一篇笔记或复盘。第五,薄弱区补足率。它是你给薄弱区排的书里真正读掉的比例,对应动作是把薄弱区排在书单最前面,先读它。
执行清单可以压缩成一张便签:一是定 8 到 12 个主题;二是每读完一本打 1 到 3 个标签;三是每月出热力图看一次;四是季度标薄弱区并排书;五是每年选 1 到 2 个主题下深井;六是薄弱区永远排书单第一。六条全做到,覆盖管理就闭环了。它不需要额外买软件,只需要你愿意把读什么这件事,交给数据来决定一次。
四个被忽略的偏差
即使有了仪表盘,统计本身也会撒谎。第一个偏差是标签漂移:同一个词,你年初和年末的理解不一样,导致早年数据和新数据不可比。解法是给每个主题写一句定义,改定义时在台账里留一行备注。
第二个偏差是页数幻觉。厚书容易让人觉得读得很值,但一本 600 页的注水书,信息量可能不如一本 150 页的好书。别用页数当深度的唯一代理,改用你后来用了几次。第三个偏差是来源偏食:全是公众号短文、全是短视频解读,看似覆盖了很多主题,其实都是别人嚼过的二手结论。要刻意保留一定比例的一手书籍与原始材料。
第四个偏差最隐蔽,就是统计本身吃掉阅读时间。为了记录而记录、为了图表好看而选轻松的书,就把手段当成了目的。健康的信号是:你花在记录上的时间始终远小于花在阅读上的时间,而且你会主动去补地图上最空的那一格。一旦反过来,就该把仪表盘关掉两周,先把手上的书读完。
识别这四个偏差的方法很简单。每季度复盘时,问自己三句话:我的标签定义变了吗?我是不是在用页数自我安慰?我最近读的东西里,有多少是一手信息?答完这三句,偏差基本就现形了。
把仪表盘变成下一季的选书清单
仪表盘的终点不是一张好看的图,而是一张能执行的选书清单。方法可以很固定:先看热力图上哪些主题连续三个月是空白,把它们写进必补区;再看哪些主题柱状图最高,判断是继续深挖还是已经饱和。前者决定广度的动作,后者决定深度的动作。
给清单排优先级时,我常用一个缺口乘价值的二分法。缺口大且对你当下目标重要的主题,排第一;缺口大但暂时不重要的,排第二;缺口小且重要的,排第三;又小又不重要的,直接砍掉。这样清单就不会无限膨胀,而是始终聚焦在真正该补的地方。
还要给读法留出弹性。补广度时,允许自己读得快、读得浅,甚至只读综述和导读;下深井时则要反过来,慢一点、做笔记、写输出。用同一套速度去读所有书,是另一种形式的偷懒——把地图画清楚之后,速度应当由主题的角色决定,而不是由心情决定。
最后,别忘了让清单服务生活,而不是绑架生活。阅读是手段,理解世界、做出更好的判断才是目的。当你有一天不再需要翻表格,也能大致说出自己地图的形状,这套仪表盘就算真正内化成了本能。到那时,图可以简化,习惯要留下。
一句可以抄在便签上的话:你读了多少本,世界并不关心;你补上了哪几块空白,你自己会知道。从今天开始,别再问今年读了几本,先问地图上还黑着哪一块。
常见问题
1.问:主题覆盖率要统计到多细才合适?答:一级主题控制在 8 到 12 个,统计只看一级;二级标签只用于找书,不进入热力图。细到某一位哲学家、某一个具体模型的粒度,会让统计失去意义,也坚持不下去。
2.问:纸质书和电子书混着读,数据怎么归口?答:出口必须唯一。设定一张统一台账,每周把各来源的记录抄录或导出一次,只保留日期、书名、1 到 3 个标签三列。工具可以多个,出口只能一个,否则永远拼不成一张图。
3.问:读得少的人要不要做仪表盘?答:要,但可以更轻。一个月只读两三本的人,用季度热力图即可,不必每月复盘。仪表盘的目的是看清结构,不是增加负担,频率应当随阅读量缩放。
4.问:如何判断一个主题该继续深挖还是换新的?答:看两个信号。一是你还能否轻松产出新的观点或笔记,能则继续;二是该主题是否仍服务于你当下的目标,是则保留。两个信号都消失,就该把资源转去补地图上更空的那一格。
5.问:统计了一段时间发现主题太集中,先改哪一步?答:先改下一本书。不要试图一次性重排整年书单,只要保证下一本属于薄弱区即可。结构的改变靠的是连续的微小选择,而不是一次性的宏大计划。
图片来源:图1 jarmoluk / Pixabay (CC0) · 图2 MonicaVolpin / Pixabay (CC0) · 图3 geralt / Pixabay (CC0) · 图4 romansolar / Pixabay (CC0) · 图5 sdg_Rai / Pixabay (CC0) · 图6 Sunriseforever / Pixabay (CC0) · 图7 Sunriseforever / Pixabay (CC0) · 图8 DGlodowska / Pixabay (CC0) · 图9 Pexels / Pixabay (CC0) · 图10 29277261 / Pixabay (CC0) · 图11 Pexels / Pixabay (CC0) · 图12 Kost9n4 / Pixabay (CC0) · 图13 allybally4b / Pixabay (CC0) · 图14 satynek / Pixabay (CC0) · 图15 RoyBuri / Pixabay (CC0) · 图16 analogicus / Pixabay (CC0) · 图17 Yummymoon / Pixabay (CC0) · 图18 YHBae / Pixabay (CC0) · 图19 SplitShire / Pixabay (CC0) · 图20 giselavankreij / Pixabay (CC0) · 图21 allybally4b / Pixabay (CC0) · 图22 Michel_Marburg / Pixabay (CC0) · 图23 WimdeGraaf / Pixabay (CC0) · 图24 Michel_Marburg / Pixabay (CC0) · 图25 Ylanite / Pixabay (CC0) · 图26 Alexas_Fotos / Pixabay (CC0) · 图27 lukgehr / Pixabay (CC0) · 图28 Ylanite / Pixabay (CC0) · 图29 Wolfgang_Hasselmann / Pixabay (CC0) · 图30 divotomezove / Pixabay (CC0) · 图31 cp17 / Pixabay (CC0) · 图32 MaxxGirr / Pixabay (CC0) · 图33 zivica / Pixabay (CC0) · 图34 lin2015 / Pixabay (CC0) · 图35 ahmetyuksek / Pixabay (CC0) · 图36 Ralf1403 / Pixabay (CC0) · 图37 Ri_Ya / Pixabay (CC0) · 图38 strichpunkt / Pixabay (CC0) · 图39 3342 / Pixabay (CC0) · 图40 Leolo212 / Pixabay (CC0) · 图41 MiraCosic / Pixabay (CC0) · 图42 Dimhou / Pixabay (CC0) · 图43 MiraCosic / Pixabay (CC0) · 图44 focusonpc / Pixabay (CC0)
本文为信息分享与方法论科普,不构成任何专业建议,请结合自身情况判断。
本文由 AI 生成,经人类主编终审。
评论(0)