
基本信息
阅读时间:约 11 分钟
字数:约 4429 字
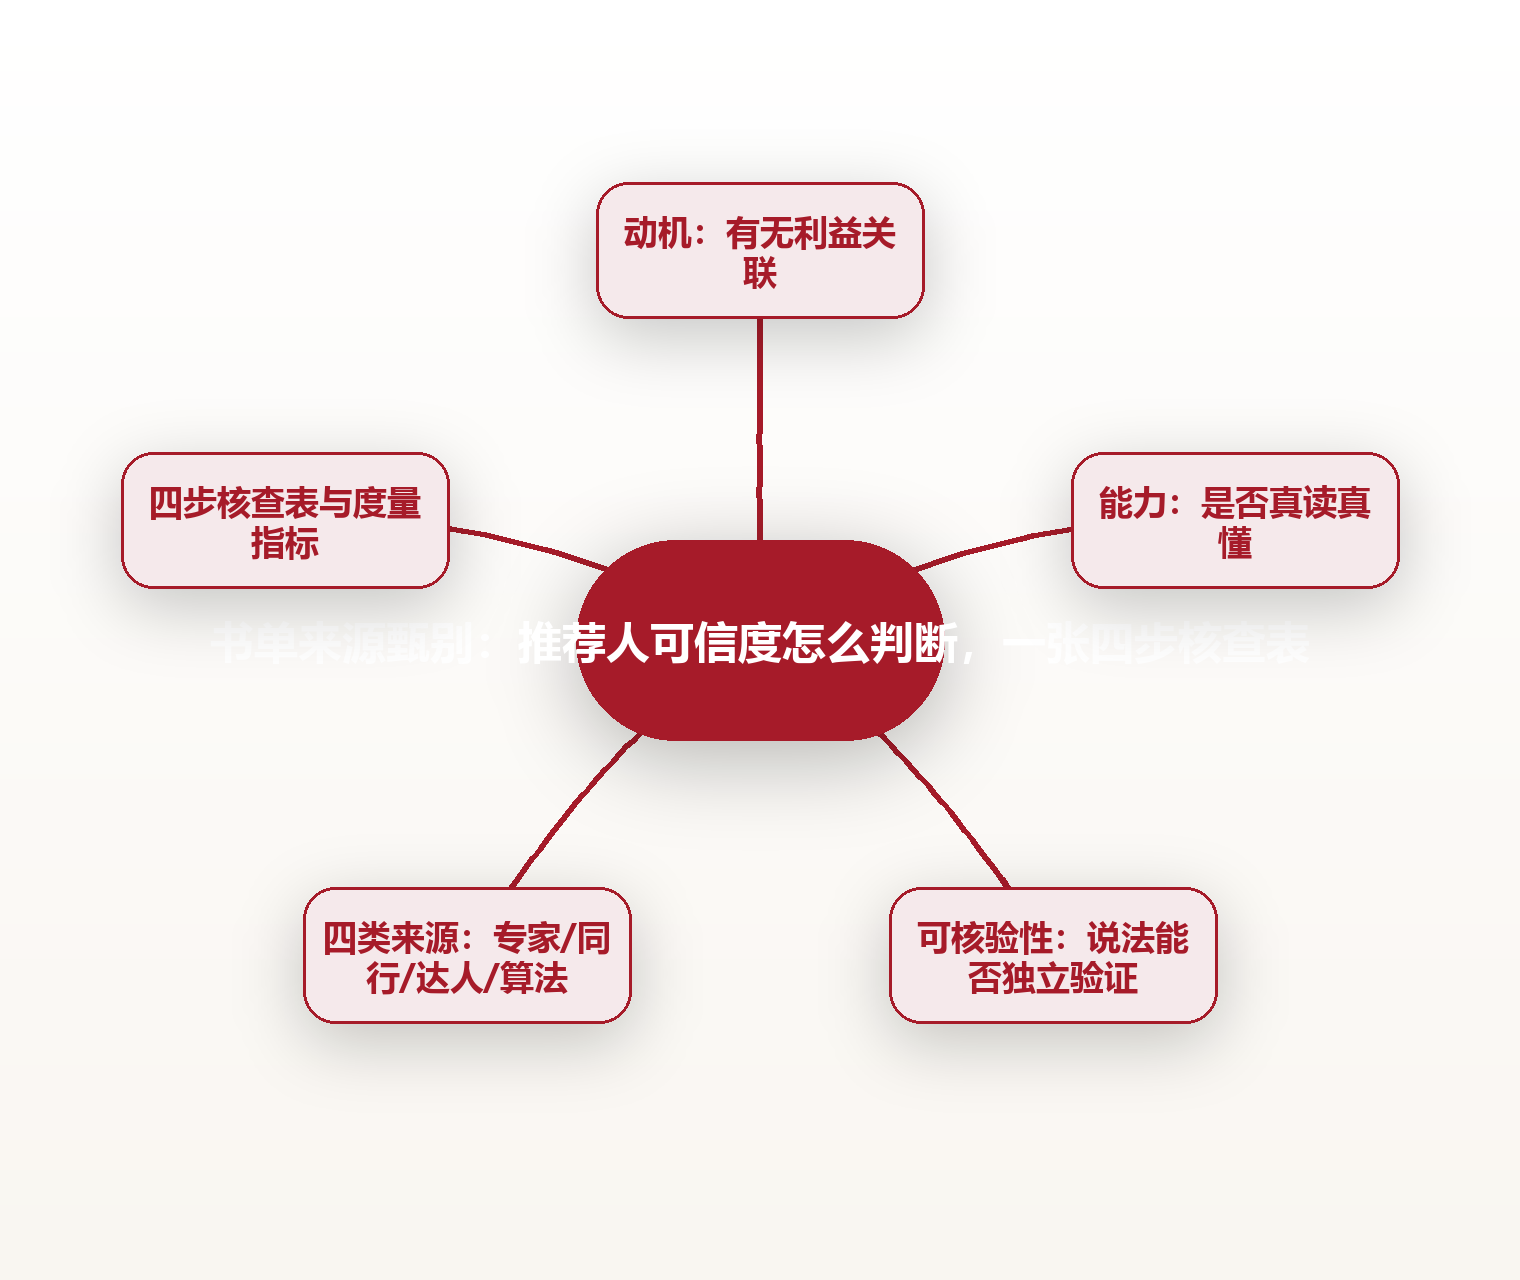
摘要:书单越推越多,可信的却越来越少。本文用推荐人可信度三支柱模型——动机、能力、可核验性,拆解专家、同行、达人与算法四类来源的优劣,给出一张四步核查表和可量化指标,帮你把“谁推荐”从光环还原成可逐条核对的判断。
全文语音
中文
English
日本語
한국어
专业分析:推荐人可信度的量级、框架与案例
把话说在前面:书单本身不是毛病,问题在于书单背后站着谁。「谁推荐」这件事的分量,往往比「推荐了什么」更重。先看量级。多家图书电商与内容平台的公开口径显示,读者在选书时参考「他人推荐」的比例长期居高,在各类购书动因中通常排在前两位;换句话说,决定你点开一本书的,多半不是书本身,而是一个被信任的名字。这不是要否定推荐,而是提醒一句:推荐的可信度有量级、有结构,可以被拆开逐条来看。
再看一组关于内容生产端的观察。据内容行业的公开调研口径,图书与知识类内容里,带有「书单」「荐书」「年度最佳」这类标签的条目,在推荐流中的占比逐年上升;与此同时,真正读完并给出结构化评价的比例并不高,大量荐书内容停留在「名字加一句金句」的层面。这意味着读者面对的,是一个供给暴增、但平均加工深度下降的市场。供给越充裕,来源甄别就越值钱。
还有一组来自阅读行为研究的方向性结论:读者对一本书的最终评价,会明显受到推荐来源的锚定。同一本书,被权威渠道以「必读」口吻推荐,和被陌生人随手提及,读者的初始期待与阅读投入完全是两回事。也就是说,推荐人不仅影响你读不读,还会悄悄影响你读完之后的判断。这一点,恰恰是来源甄别最容易被忽略的地方。
在这三组数据之上,可以立一个命名框架:推荐人可信度三支柱模型,即动机、能力、可核验性(Motivation、Competence、Verifiability,简称 MCV)。支柱一是动机,问的是这个人推荐给我,他有没有利益关联;支柱二是能力,问的是他有没有读进去、有没有这行的判断力;支柱三是可核验性,问的是他说的能不能被独立验证。它和更常见的权威背书法,也就是看头衔、看平台、看流量,分属两套逻辑:权威背书法把信任外包给身份标签,MCV 则把信任拆回到可检查的三件事。两者的差距在于,前者一旦标签被伪造就会整体失灵,后者即使换成一个陌生人,你也能逐条核对。

一个真实可辨识的案例,是亚马逊早期那场被广泛报道的刷评风波。二〇一〇年代,平台上大量商品的好评来自付费水军或作者亲友,评论数与评分一度成为最有说服力的推荐信号。后来平台陆续查处并下架了大批虚假评论,高分这个指标的含金量随之被重新定价。这件事的通用教训很直接:所有只靠单一身份信号的信任,都会被逐利者用同样的信号攻破。荐书也是一样,当「大 V 推荐」「年度书单」「销量冠军」本身变成可以购买的资源,单看这些标签就已经不够了。
要把可信度判断变成可管理的东西,先得有指标。建议至少盯四个:一是关联披露率,你参考的推荐人里,有多少会主动说明自己与作者、出版社或平台的关系;二是可核验率,他给的理由里有多少能被你另找一处独立来源印证;三是具体度,他的推荐里有多少关于内容本身的细节,比如结构、论证、适用人群,而不是情绪与金句;四是反向率,他会不会明确说这本书不适合谁、哪一部分可以跳过。前三个帮你筛掉噪音,第四个最能区分真读过和没读过。配套执行清单是:一次只信任一个来源;先查动机再看能力;所有强推荐都留一条独立核验;把只夸不批的内容降权;定期回看自己关注列表里,谁的推荐命中过你真实的阅读体验。
为什么书单会越推越水
内容供给过剩,是书单质量下滑的第一推力。当荐书从出版社的营销动作,变成人人可做、可带货、可涨粉的通用内容品类,门槛就被彻底拉平了。写一条书单不需要读完整本书,摘几句短评、拼几张封面、配一个吸引人的标题,就能获得不错的曝光。供给端的成本被压到极低,需求端的辨别成本却没有同步下降,于是「水」的部分自然淹没「干」的部分。
平台机制在放大这一趋势。推荐流的逻辑奖励能被快速消费的内容,而一条书单最容易被消费的形态,恰恰是名字加一句金句加一个情绪。深度书评需要读者花时间,浅书单只需要读者扫一眼,后者在数据上更容易赢。于是创作者会主动向「浅」收敛,这不是谁的道德问题,而是机制塑造出来的选择。
更隐蔽的是二次搬运。一个书单被反复转述、洗稿、重排,原始观点与出处一层层剥落,最后留在你眼前的,是一个没有作者、没有时间、没有语境的「经典书单」。你无法追责,也无法核实,只能凭感觉信或不信。这种无源内容,正是来源甄别最该警惕的对象。
所以「越推越水」不是错觉,而是供给、机制、搬运三层共同作用的结果。理解了这一点,你就不会再把「这份书单看起来很全」当成可信的证据,而是会本能地先问一句:它是谁写的、什么时候写的、为什么写。
四条硬信号:判断推荐人是否可信
第一条信号是说得具体。真读过一本书的人,往往能说清它的结构、它最有力的那一章、它在哪一处露怯。满篇形容词、通篇金句的推荐,多半还停留在封面和简介。具体度不是文采问题,而是「是否真的进去过」的证据。
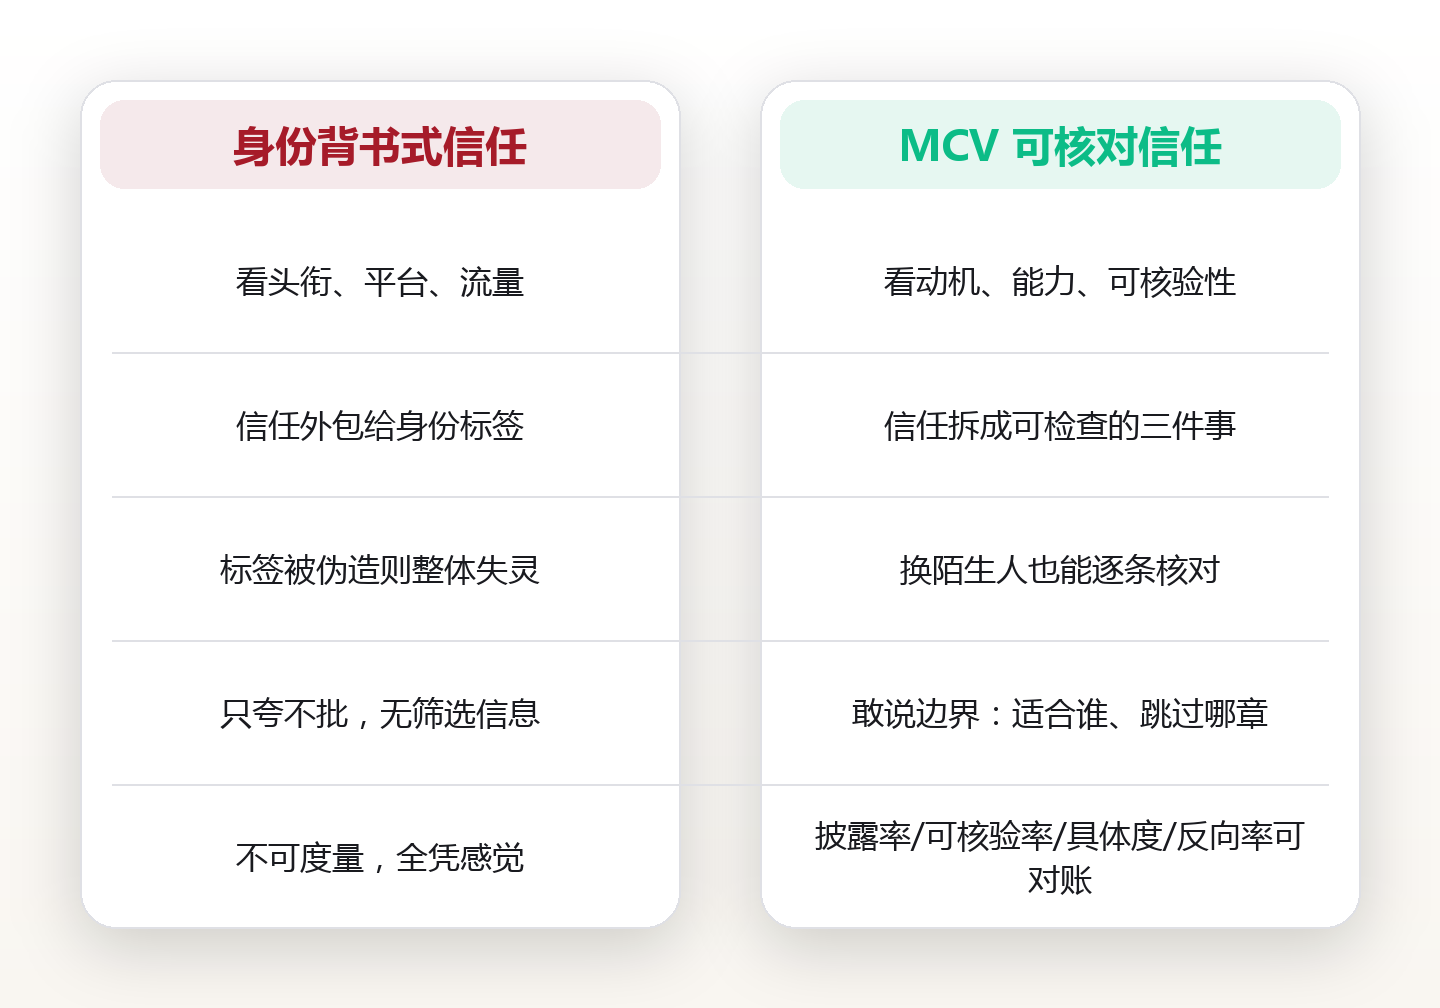
第二条信号是敢说不。可信的推荐人会主动划边界:这本书适合谁、不适合谁、哪几章可以跳过、和哪本书观点相冲。只夸不批的推荐,等于没有给出任何筛选信息——如果一本书处处都好,那推荐本身就失去了分辨力。
第三条信号是来源可追。他引用的数据、案例、观点,能否找到出处?他提到的同类书,是否形成了一个自洽的谱系?一个推荐人如果总是孤零零抛出一个名字,从不交代它与别的书的关系,你就很难判断他的判断力究竟在哪一层。
第四条信号是动机透明。他有没有说明自己与这本书的关系,是朋友、是合作、是推广、还是纯粹喜欢?透明不等于没有利益,透明意味着你可以据此调整信任的权重。一个坦承「我和作者认识」的推荐,反而比一个假装客观的推荐更值得参考。
推荐人类型大对比:专家、同行、达人与算法
专家型推荐人,通常是研究者、从业者或资深编辑。优势是判断力深,能给出专业坐标;风险是视野偏窄,容易只看重自己领域认可的标准,也可能受同行关系牵绊。
同行型推荐人,是和你处境接近的人,比如同岗位、同阶段、同困惑。优势是适配度高,他知道你缺什么、能读懂什么;风险是容易陷入同温层,你们的知识盲区彼此重叠。
达人型推荐人,靠内容运营积累起影响力。优势是表达好、更新快、覆盖面广;风险是动机复杂,带货、涨粉、合作都可能影响推荐的真实性,需要格外留意有没有披露。
算法型推荐,由平台依据你的行为推给你。优势是效率高,能发现意外之喜;风险是它优化的是停留时长而不是你的成长,容易把你困在「看得爽但没长进」的循环里。
四类没有绝对优劣,关键在配比。一个健康的书单来源结构,应当是专家给坐标、同行给适配、达人给信息、算法给意外,再叠加你自己的核验。任何单一来源长期独占,都会带来偏差。
利益结构:荐书背后的动机拆解
荐书这件事,天然带着几层可能的利益:流量、关系与金钱。流量上,书单是内容平台里性价比很高的选题,因为它自带清单感,容易被收藏和转发。关系上,编辑、作者、出版社、平台运营之间常有互相捧场的默契。金钱上,联盟链接、带货分成、付费推广则是更直接的动机。
这些动机本身不等于坏。出版链条需要被看见,创作者也需要回报。问题出在是否披露。当一段推荐不说明自己处在哪一层利益里,读者就会被默认引导去相信它是一份纯分享,判断因此失真。
你可以用一个简单问句拆解动机:如果这本书不火,他还会推吗?如果答案是否定的,那这段推荐的信息量就要打折。反过来,一个愿意推荐冷门好书、并说明理由的人,往往比只推荐畅销书的人更有判断力。
把动机看清之后,你依然可以采纳推荐,只是会带着权重去采纳:透明分享的权重高,带披露的推广权重中,无披露的强推权重低。信任不是二元的信或不信,而是可以分级的。
一个洗稿书单的复盘
可以做一次追踪练习来练眼力:随手找一条常见的「人生必读一百本」书单,顺着它去找源头。多数情况下你会发现,它和几个月前、几年前的版本高度重合,措辞几乎一样,只是封面换了、标题换了、署名换了。
再往下查,会看到更典型的操作:把几本畅销书和几本看上去很经典的书混在一起,形成一种既接地气又有格调的错觉。真正读过的书、真正相关的书,反而未必入选,因为入选标准不是「值得读」,而是「看起来值得转发」。
这类书单的危险不在具体书目,而在于它训练你接受一种清单式信任:只要凑够数量、排好顺序、配上权威口吻,就默认可信。久而久之,你会跳过「是谁在说、他凭什么说」这一步。
值得注意的是,洗稿书单里往往夹着几本真正的经典。它们的入选理由不是内容,而是知名度——因为写上它们能提升整份书单的「格调」。可对读者来说,这种混搭最难对付:你没法因为一半是好书,就相信另一半也值得读。区分真假的方法,还是回到动机、能力与可核验性这三根支柱,逐本去问「为什么是它」。
复盘出来的结论很朴素:与其收藏第十份相似的必读书单,不如认真跟定两三个动机清楚、敢于划边界的推荐人,把他们当坐标,再自己走出去核验。
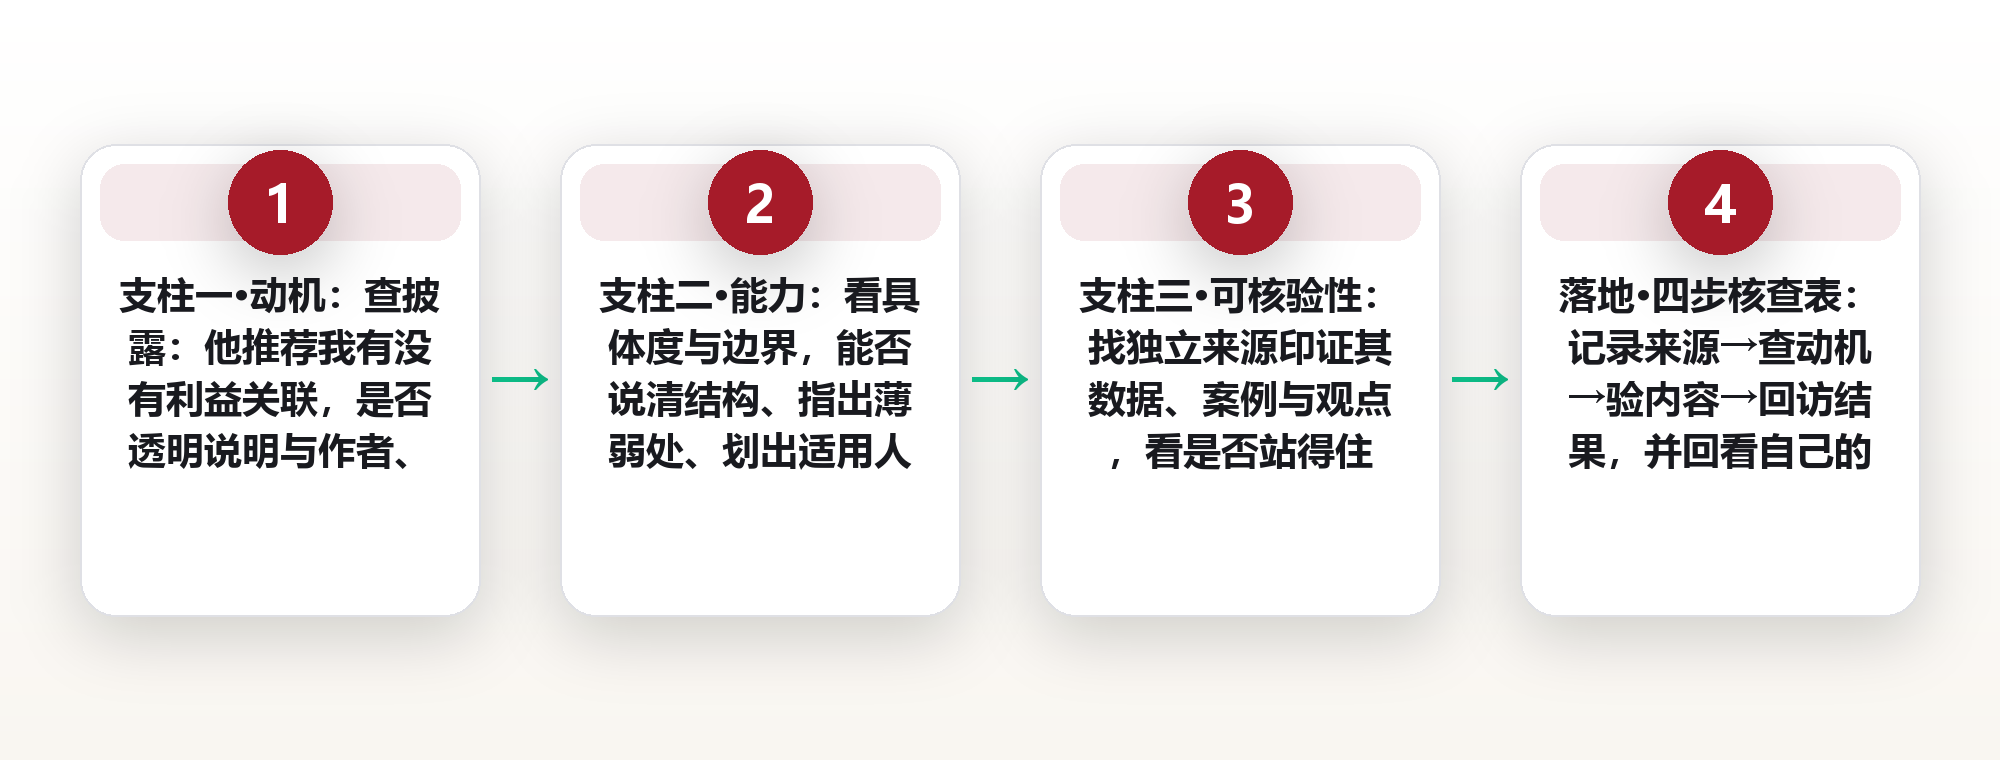
把可信度判断落成一张核查表
第一步,记录来源。每当你因为一条推荐想读一本书,先写下推荐人、平台和时间。这个动作只要几秒,却能在日后帮你看出:谁的推荐你真正读完了,谁的推荐你总是虎头蛇尾。
第二步,查动机。花一分钟看推荐人有没有披露利益关系、是不是长期只推某一家、有没有明显的带货链接。动机不透明,就给这条推荐打一个折扣。
第三步,验内容。找一处独立来源,另一篇书评、一段作者访谈、一次试读都可以,对照推荐里的说法,看它是否站得住。能被外部印证的具体描述,才是有价值的推荐。
第四步,回访结果。读完以后,回头给这条推荐打分:它说的和你的真实体验差多远。积攒几十条这样的记录,你就拥有了属于自己的来源可信度榜,它比任何平台的榜单都更贴你。
三个容易踩的误判
误判一,把头衔当成判断力。职务、学历、平台认证代表的是过去,不是对这本书的判断。一个头衔再高的人,若通篇只说「必读」「震撼」,仍然没有给你任何可用的信息。
误判二,把销量当成质量。销量反映的是被看见的程度,而不是内容对你有用的程度。畅销书里既有真金,也有大量被营销推起来的水花,用销量代替判断,等于把筛选外包给市场情绪。
误判三,把「我读过」当成「我推荐对了」。人的记忆会美化自己投入过时间的选择。如果你已经花了几小时读完一本书,再回头评价它,很容易因为沉没成本而高估。承认这一点,才能更冷静地看待自己和别人的推荐。
这三条误判有一个共同点,都是拿一个省力的外部信号,替代了本该自己做的那点核验工作。避开它们不需要多高的智力,只需要在点头之前,多问自己一句:我依据的到底是什么。
从一本书到一个书单:来源分级实操
先给来源分级。可以把所有推荐来源分成三级:一级是动机透明、能划边界、可核验的;二级是有价值但需要打折的,比如带货达人;三级是无源、无署名、纯搬运的。分级之后,采信权重自然不同。
再控制数量。一级来源不用多,两三个就够,因为它们提供的是坐标系;二级来源用来扩面,帮你发现可能不会自己去找的书;三级来源干脆不看,它们的唯一作用是消耗你的注意力。
然后做交叉验证。同一本书,如果同时被一个一级来源和另一个独立来源以不同理由推荐,可信度就明显上升;如果只在某一个来源反复出现,就要多留一个心眼。
最后是更新。来源不是一次评定就永久有效的。一个人今天的推荐可信,不代表三年后仍然可信。定期回看你那本来源可信度榜,把长期偏离的降级,把新出现的靠谱来源补进来,这套体系才会越用越准。
说到底,书单来源甄别的核心,不是学会怀疑一切,而是把信任拆成可以核对的部分。推荐人依旧值得听,只是从今往后,你听的不再是一个光环,而是他给出的动机、能力与可核验性。
常见问题
1.问:是不是所有带推广性质的荐书都不可信?答:不是。推广本身是出版链条的一部分,关键是它有没有被披露,以及推荐里除了说服力,还有没有可核验的具体信息。披露清楚、内容扎实的推广,依然值得参考。
2.问:我喜欢的博主推荐了很多书,怎么判断他有没有真读?答:看具体度和边界。真读过的人能说清结构、指出薄弱处、划出适用人群;只堆金句、只夸不批、从不说「不适合谁」的,多半停留在封面和简介。
3.问:专家推荐就一定比普通人靠谱吗?答:不一定。专家的优势在判断深度,风险在视野偏窄和同行关系;普通人的优势在处境接近、适配度高,风险在盲区重叠。更稳的做法是配比使用,而不是迷信单一身份。
4.问:算法推荐到底能不能用?答:能用,但要设边界。算法擅长发现你没想到的书,却会优化你的停留时长而不是成长。把它当发现工具而不是判断工具,再用一级来源去过滤,它就变好用了。
5.问:建立来源可信度榜是不是太麻烦?答:初期要花点时间,但它会越用越省。你只需要记录来源、打分、更新三步,几周之后,它会替你自动挡掉大量噪音,把注意力还给真正值得读的书。
图片来源:图1 Leroy_Skalstad / Pixabay (CC0) · 图2 yogendras31 / Pixabay (CC0) · 图3 jandenouden / Pixabay (CC0) · 图4 AlisaDyson / Pixabay (CC0) · 图5 Ri_Ya / Pixabay (CC0) · 图6 knk1190 / Pixabay (CC0) · 图7 JillWellington / Pixabay (CC0) · 图8 ysen / Pixabay (CC0) · 图9 sasint / Pixabay (CC0) · 图10 tien_ttm / Pixabay (CC0) · 图11 Javad_esmaeili / Pixabay (CC0) · 图12 mostafa_meraji / Pixabay (CC0) · 图13 sasint / Pixabay (CC0) · 图14 Afragozo1023 / Pixabay (CC0) · 图15 tien_ttm / Pixabay (CC0) · 图16 srjqhzl / Pixabay (CC0) · 图17 Ralphs_Fotos / Pixabay (CC0) · 图18 stux / Pixabay (CC0) · 图19 stux / Pixabay (CC0) · 图20 stux / Pixabay (CC0) · 图21 PIRO4D / Pixabay (CC0) · 图22 skorchanov / Pixabay (CC0) · 图23 ngtghaivanamg / Pixabay (CC0) · 图24 modernseoul / Pixabay (CC0) · 图25 PAVM / Pixabay (CC0) · 图26 stevepb / Pixabay (CC0) · 图27 strichpunkt / Pixabay (CC0) · 图28 neelam279 / Pixabay (CC0) · 图29 brenkee / Pixabay (CC0) · 图30 김경복 / Pixabay (CC0) · 图31 Willystanley / Pixabay (CC0) · 图32 aaron00023 / Pixabay (CC0) · 图33 congerdesign / Pixabay (CC0) · 图34 beasternchen / Pixabay (CC0) · 图35 Oldiefan / Pixabay (CC0) · 图36 AdinaVoicu / Pixabay (CC0) · 图37 MiraCosic / Pixabay (CC0) · 图38 Dimhou / Pixabay (CC0) · 图39 MiraCosic / Pixabay (CC0) · 图40 focusonpc / Pixabay (CC0)
本文为信息分享与方法论科普,不构成任何专业建议,请结合自身情况判断。
本文由 AI 生成,经人类主编终审。
评论(0)