基本信息
阅读时间:约 15 分钟
字数:约 5980 字
摘要:同一批数据,换个观察窗口就能得出相反结论。本文把样本拆成入口筛、留存筛、记录筛三道闸门,用统计效力与最小可检测效应算出「你能看见多大的差别」,并给出缺席者盘点表与五个日常习惯。
全文语音
中文
English
日本語
한국어
专业分析:样本被筛过两次,一次在入口,一次在记录
先把结论放在最前面:你手上的样本,几乎从来不是随机掉下来的,而是被一层层筛过之后剩下的那一小撮。所以样本量意识的第一问不是「够不够多」,而是「谁不在这里」。一个数字的可信度,取决于它的分母有多完整,而不取决于它的位数有多长。
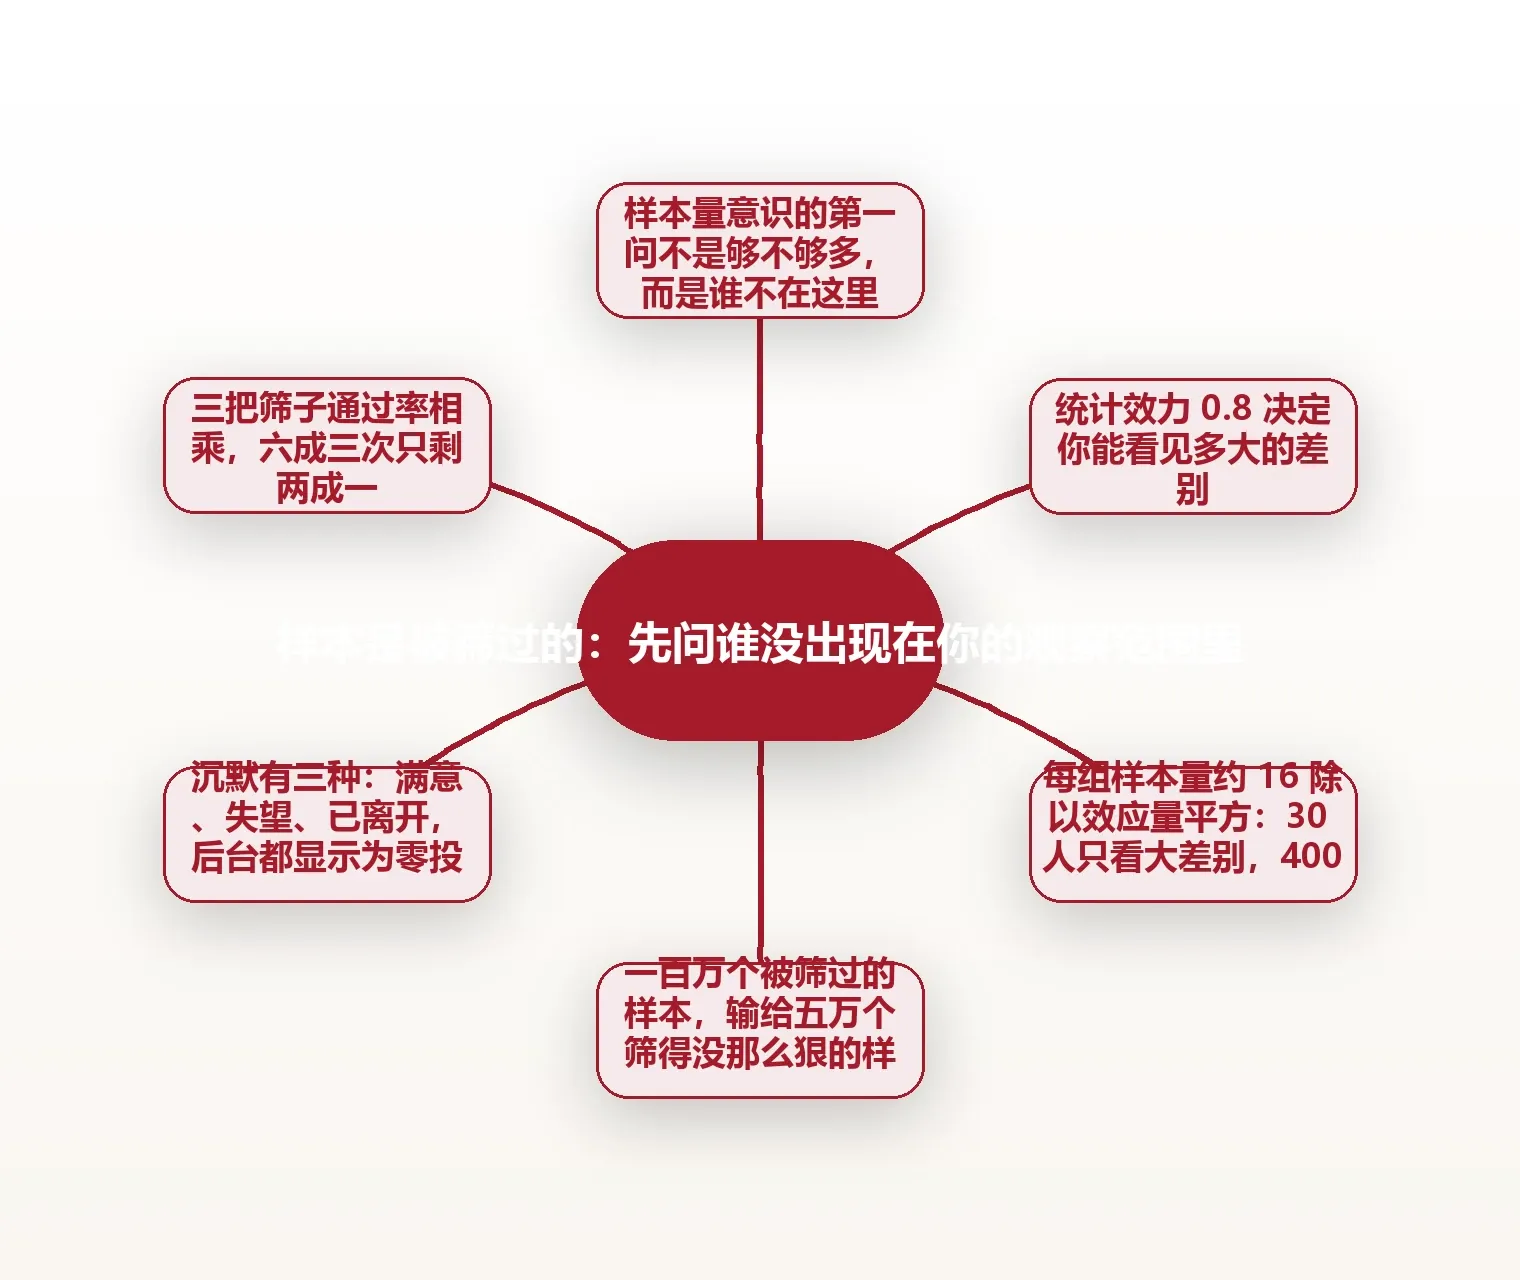
第一组数据关于统计效力。在零假设检验的惯例里,显著性水平取 0.05、效力取 0.8 是常见配置:前者控制「把没有的差别看成有」的概率,后者控制「把真的差别漏掉」的概率。两组均值比较的粗略样本量关系是每组约 16 除以效应量的平方,效应量用标准化差值 d 表示。换算下来,d 等于 0.8 的大效应每组约 25 人,d 等于 0.5 的中等效应约 64 人,d 等于 0.2 的小效应约 400 人。这是理想独立同分布假设下的下限,真实业务数据方差更大、噪声更多,通常还要再乘 1.5 到 2 倍。
把公式读进业务,含义会很扎人:如果你的观察只有二三十个样本,你能看见的只有「大到不可能被忽略」的差别。凡是你觉得「好像有点变化但说不清」的地方,多半不是判断力不够,而是观察能力不够。样本量决定了你能看见的最小差别,这条线叫最小可检测效应,它比 p 值有用得多。
第二组数据关于「样本大不等于样本对」。《文学文摘》在 1936 年美国大选前寄出约一千万份问卷,回收两百多万份,样本规模是当时任何民调的数十倍,却把结果预测反了;同期盖洛普用约五万份按配额抽取的样本,方向判断正确。区别不在数量,而在名册:杂志的邮寄名单来自电话簿与汽车登记,那个年代拥有电话和汽车的人系统性偏富。两百多万个被筛过的样本,输给了五万个筛得没那么狠的样本。
第三组是一个可以自己算的例子,用来说明效力如何决定「阳性结果」的可信度。假设一千个待检验的猜想里只有一百个是真的,显著性水平 0.05、效力 0.8:真猜想里能被检出约 80 个,假猜想里会误报约 45 个,于是所有阳性结果中真阳性约占 64%。把效力降到 0.2,检出的真猜想只剩 20 个,真阳性占比掉到 31%。同一批数据、同一个显著性门槛,只因观察能力不同,结论的可信度差了一倍。这就是统计效力真正的含义:它不只影响「能不能发现」,还影响「发现的东西里有多少是真的」。
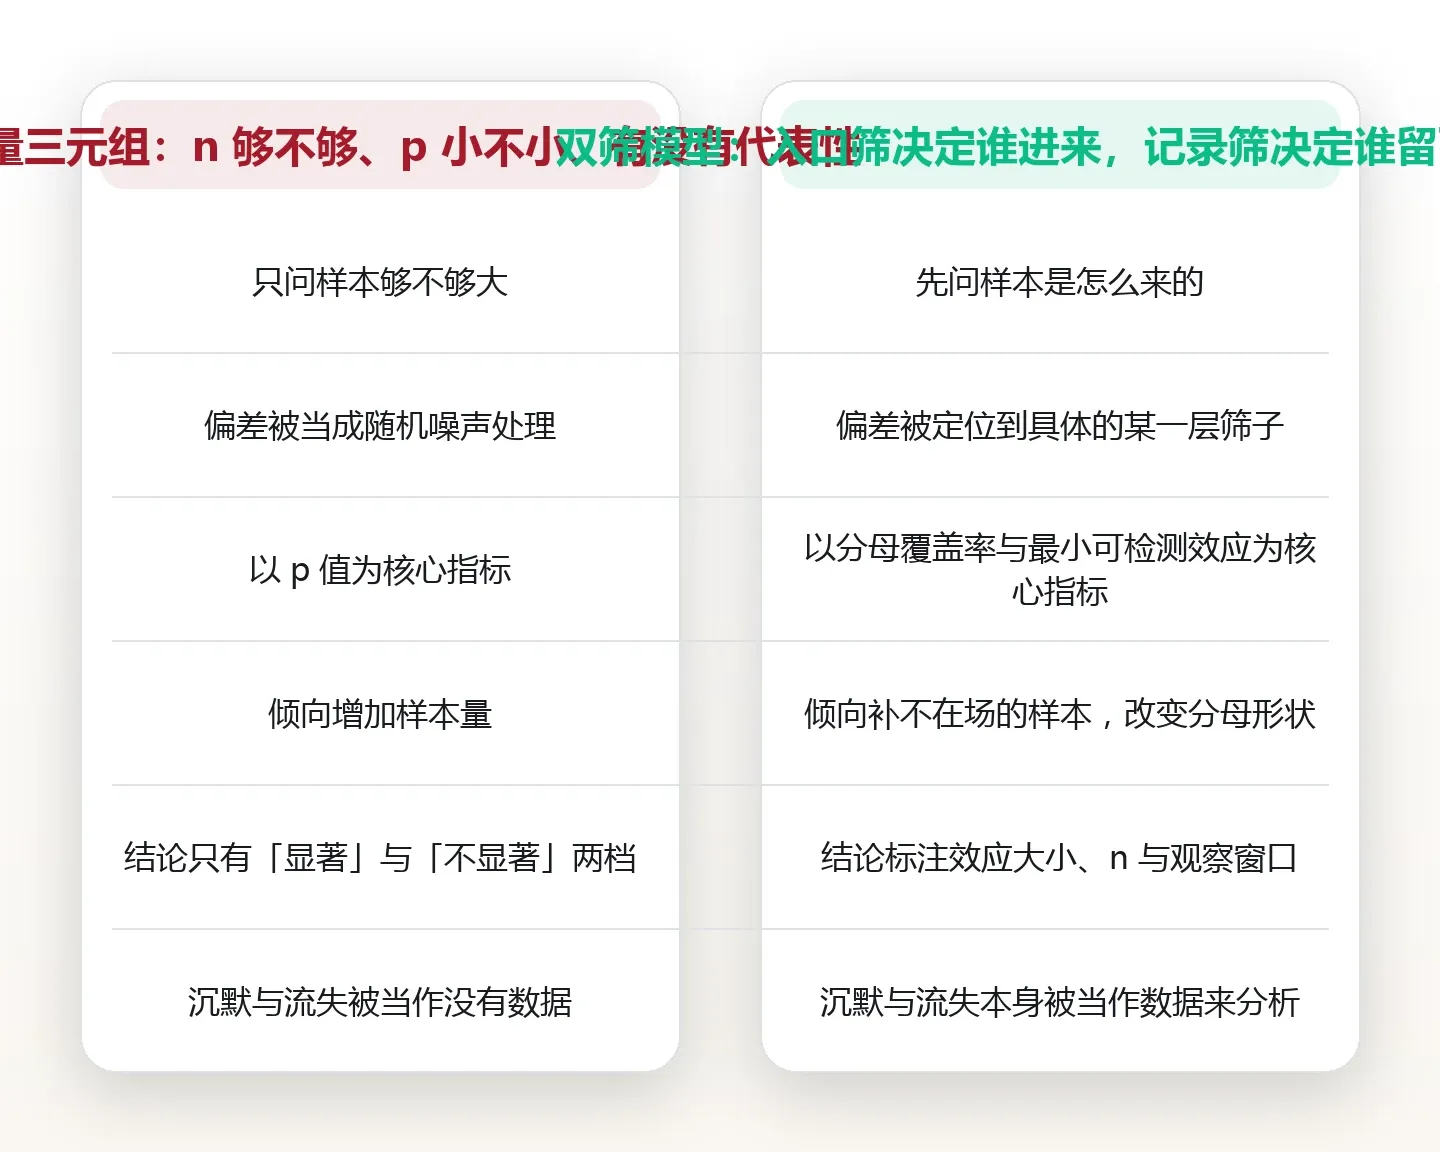
框架对比。旧的分析习惯是「样本量三元组」:n 够不够、p 是否小于 0.05、样本有没有代表性。三个问题各问各的,偏差被当成噪声处理。本文用的是一套双筛模型,把一次观察拆成两道闸门:入口筛决定谁有机会进入你的视野,记录筛决定谁在系统里留下痕迹。每道闸门配一个可测指标,入口筛看分母覆盖率,记录筛看痕迹率。旧框架问「样本够不够大」,双筛模型问「样本是怎么来的」;后者能定位偏差发生在哪一步,前者只能告诉你结果可疑。
一个真实可辨识的案例。二战期间,哥伦比亚大学统计研究小组的亚伯拉罕·瓦尔德接到一项任务:根据返航飞机的弹孔分布,建议在哪里加装甲。数据画出来很一致,机翼和机身弹孔密密麻麻,发动机几乎干净。直觉结论是加固弹孔最多的地方,瓦尔德的结论相反:该加固发动机,因为发动机中弹的飞机回不来。这不是受控实验,而是一段被反复引用的历史推理,它的价值在于结构:当样本只能从「活下来」的那一侧抽取时,样本内部的分布描述的是筛选规则,不是风险本身。
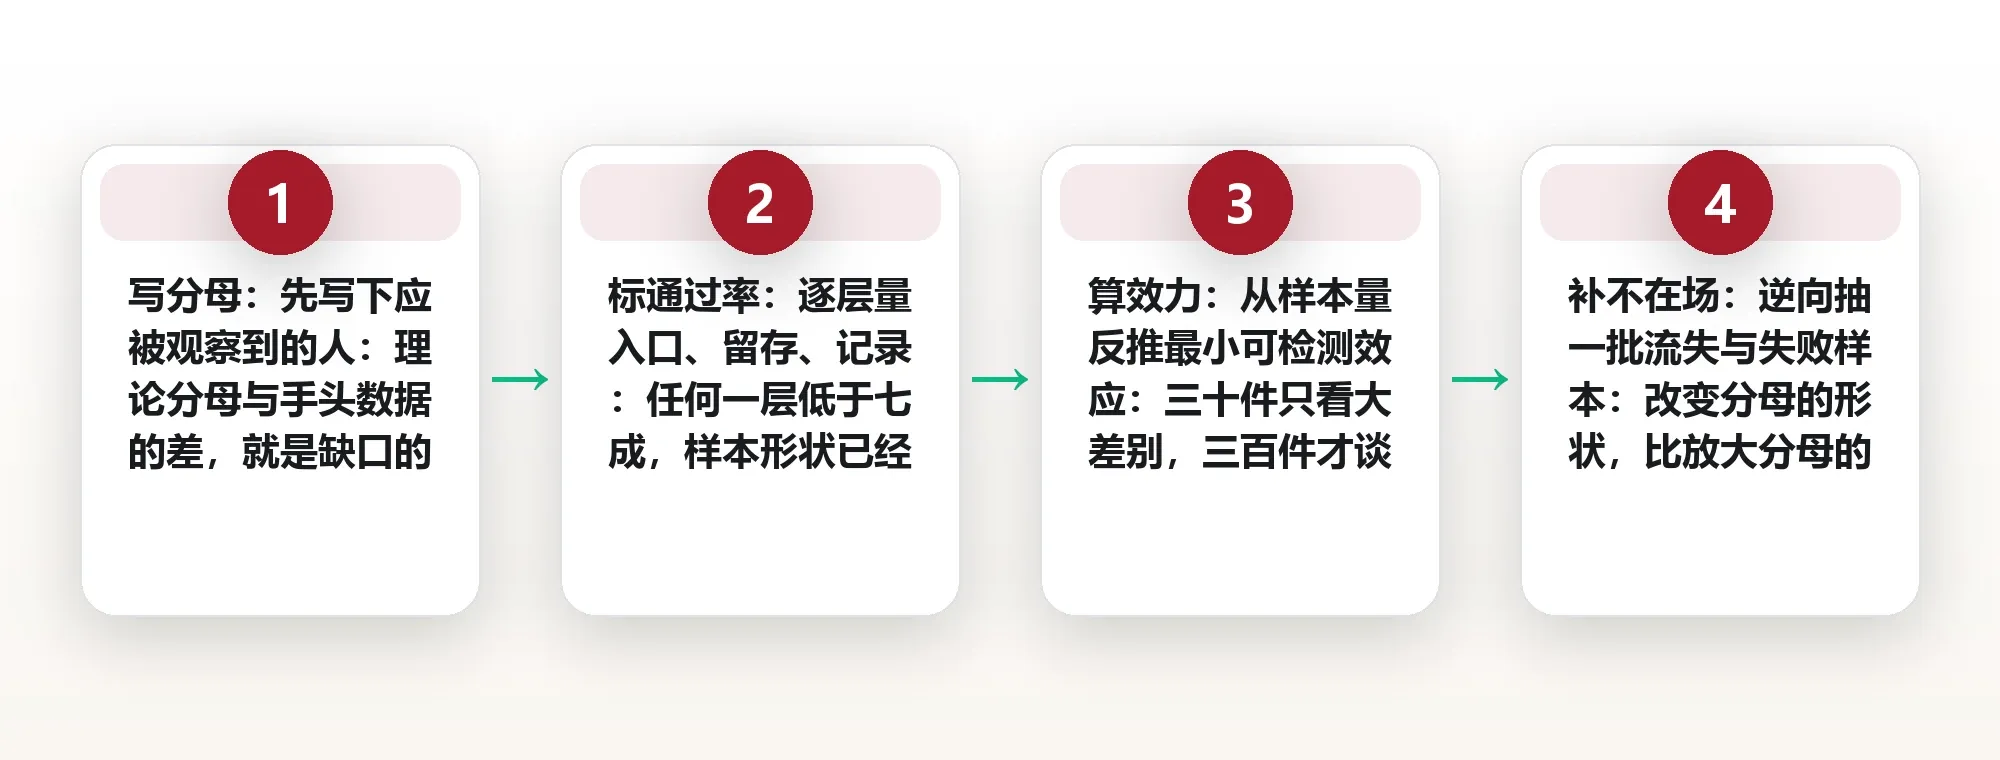
落地成指标,可以抓五个:分母覆盖率,即实际被观察到的人数占应被观察到人数的比例;痕迹率,即进入观察后留下可用记录的比例;最小可检测效应,即当前样本量能可靠识别的差异下限;退出者与留存者的关键指标差,用来判断留存筛是否偏斜;结论翻转率,即同一问题在不同窗口复测后结论反向的比例。前两个属于入口,第三个属于能力,后两个属于稳定性。执行清单只有五条:先把分母写出来;再标出每一层筛子的通过率;用最小可检测效应回推样本是否够用;专门抽一批「不在场」的样本做对照;最后在结论旁注明 n 与观察窗口。
无声的分母:为什么「没人反馈」不是好消息
「没人反馈」是样本量意识最容易失守的地方。反馈系统的分母天然被筛过:只有愿意开口的人会留下痕迹,而愿意开口的人与沉默的人,往往不是同一批人。
沉默至少分三种。第一种是满意的沉默,用得好但懒得说;第二种是失望的沉默,觉得说了也没用,直接降低使用频率;第三种是已经离开的沉默,连问卷入口都看不到。三种沉默混在一起,在后台显示为「零投诉」,业务含义却完全不同:第一种可以暂时不管,第二种是流失的前兆,第三种已经流失。
服务业的经验值可以参考:公开投诉或正式反馈的比例通常在百分之一到百分之五这个量级,具体随行业与渠道差异很大。意思是每一百个不满意的顾客里,能被你听见的只有一到五个。所以「零投诉」不能推导出「零不满」,只能推导出「不满尚未越过开口门槛」。这两个结论在决策上差得很远:前者让你维持原样,后者让你去查门槛在哪里。
心理机制上,这是可获取性偏差在起作用:容易被想起的信息被当成有代表性的信息。会议室里说话最大声的三个人,会不知不觉被当成「用户的意见」,而他们其实只是「愿意在会上说话的人」里的一个样本。
定性场景里的样本量意识,版本略有不同:不是问「够不够多」,而是问「有没有问到最不该被漏掉的那一类」。一份八人访谈,如果覆盖了重度用户、轻度用户和刚流失的用户,比三十份只发给活跃用户的问卷更有信息量。分母的形状,比分母的大小更早决定结论的方向。
三种筛子:入口筛、留存筛、记录筛
把筛选拆开看,通常能找到三把筛子,而它们的通过率是相乘的关系,这一点最容易被忽略。
第一把是入口筛,决定谁有机会进来。只在应用内发问卷,天然排除了已经卸载的人;只统计有账号的订单,天然排除了游客下单;只访谈合作伙伴推荐的客户,天然排除了难缠的那一批。入口筛的问题不在样本数量,而在于它决定了你永远看不到某类人。
第二把是留存筛,决定谁留到了你观察的那一刻。任何一次「现在的用户怎么样」的调研,分母都是活到今天的人。用了两周就放弃的人不在这份数据里,而他们往往才是问题最集中的地方。
第三把是记录筛,决定谁被写进了系统。周会只记推进顺利的项目,工单系统只收正式提报的问题,复盘文档只写已经上线的功能。没有被记录的部分不是不存在,只是没有变成可分析的数据。
三把筛子的通过率相乘,结果会比直觉小得多。假设每把筛子留下六成的人,三层之后只剩百分之二十一点六,也就是说,你以为在看「全部用户的反馈」,实际上在看五分之一。这就是为什么很多团队明明「数据挺多」,判断却总是偏:数据量在分子上堆得再高,也补不回分母上的窟窿。
统计效力:你的样本量能看见多大的差别
统计效力的定义很朴素:如果差别真的存在,你的观察能把它认出来的概率。惯例取 0.8,意思是真有一把牌,你有八成机会看见它。这个惯例来自科恩对行为科学效应量的系统性梳理,不是自然定律,但它给出了一个可对话的默认值。
更有用的用法是反着算。用每组约 16 除以效应量平方这条粗略关系,可以从样本量反推出你能看见的最小差别:每组 30 人,能稳定识别的效应量大约在 0.73;每组 100 人,降到 0.4;每组 400 人,才到 0.2。换成人话:三十个人的观察,只能分辨「相当大」的差别,中间地带的波动在统计上与噪声无法区分。
所以「不显著」这三个字常被误读。它说的是「以当前样本量,没有足够证据认为存在差别」,不是「不存在差别」。这两句话在决策上的分量完全不同,写成前一句是诚实,写成后一句是越界。
两个常见错误值得单独点出来。一是事后效力:拿已经跑完的数据去算「当时有多大概率能发现」,这个数字在数学上与原检验一一对应,不提供新信息,只是把 p 值换了个说法。二是把 p 值大小当效应大小:p 小只说明「不太可能是巧合」,不说明「差别很大」,样本足够大时,一个无关紧要的差别也能得到很小的 p 值。
真正该问的是三个数:效应有多大、这个效应在业务上算不算重要、样本量能不能稳定地把它认出来。三个数缺一个,结论就只能算半成品。
幸存者偏差的现代版本:榜单、评价与复盘会
瓦尔德的故事每代人都会重演一遍,只是换了场景。今天的三把筛子,藏在三个很日常的地方。
榜单是第一个。销量榜统计的是上架成功的商品,下架、断货、被算法折叠的都不在榜上。用榜单去反推「什么样的商品会成功」,等于用幸存者反推生存条件,得到的往往是最容易被看见的特征,而不是真正起作用的特征。
评价是第二个。一家店四点八分,分母是下单并愿意评价的人,不是浏览过的人。低分被筛掉的方式很隐蔽:不满意的人常常直接不评价、退款或再也不来,他们留下的不是一星,而是空白。空白在均分里没有重量,却在业务里最重。
复盘会是第三个,也是最贵的一个。只复盘上线项目,未上线、被砍掉、做到一半停掉的项目不进会议室。于是组织年复一年地从成功项目里总结方法论,而这些方法论在失败项目里可能同样存在。缺的不是方法,是分母。
第四个场景在人事决策里。看被提拔的人有什么特质,很容易得出「要有某种特质」的结论;但如果不知道同样具备这种特质却没被提拔的人有多少,这个结论就没有基准率支撑。凡是「成功者名单」型的数据,第一步都是补一个分母,而不是再找几个成功者。
缺席者盘点:把「谁不在」写成一张表
把「谁不在」变成动作,最省力的办法是做成一张四列的表:谁应该在这里、谁实际在这里、在哪一步掉的、掉队的那批人有什么共同点。
这张表的价值在于,它把模糊的「样本可能有偏」变成了可执行的追问。第一列逼你写下理论分母,第二列是你能拿到的数据,两者的差就是缺口;第三列把缺口定位到某一把筛子上;第四列决定你要不要专门补一批样本。
具体操作上,逆向抽样比增加样本量便宜得多。与其把问卷从一千份发到五千份,不如专门找五十个已经流失、已经退款、已经放弃的人聊一次。前者把分母的形状原样放大,后者才改变形状。这是投入产出比最高的一步,也是最常被跳过的一步。
一个常被忽略的细节是记录口径。同一件事,客服系统记「工单」,社群记「吐槽」,销售记「客户提过」,三套口径互不相通,合并时又会因为字段缺失丢掉一部分。口径不统一,等于在记录筛上又叠了一层随机筛,而且这层筛子不可见。
盘点缺席者的产出不该是一份更长的报告,而是一句更短的结论:这次观察漏掉了哪一类人,漏掉的方向会让结论偏高还是偏低。能说清这句话,样本量意识才算真正落地。
先定最小可检测效应,再决定要不要下结论
大多数分析失败在顺序上:先拿到数据,再从数据里找结论,最后才回头问「这个样本够不够」。正确的顺序是反过来的,而且第一步与数据无关。
第一步,先定「多大的差别才算重要」。这不是统计问题,是业务问题:转化率提升两个百分点值不值得改版,客单价差三十元算不算显著,响应时间慢半天会不会影响续约。这个门槛必须在看数据之前写下来,否则任何结果都能被解释成「有点意思」。
第二步,用这个门槛反推需要的样本量。如果最小重要差别对应的是小效应,需要的样本会成倍增加;如果只有大效应才算重要,几十个样本就够用。样本量不是越大越好,是够用就好,而「够用」的定义完全由第一步决定。
第三步,如果样本不够,改设计而不是改结论。可行的四条路:延长观察窗口以积累样本;用配对比较消除个体差异带来的噪声;按关键变量分层,把组间可比性提上来;同一对象多次测量取均值,压低随机波动。这四条都在减少噪声,而不是在增加样本。
顺序对了,你会发现很多争论其实没有分歧:一方在说「差别存在」,另一方在说「以我们的观察能力看不见」,两者可以同时为真。把这两句话分开写,比争论谁对谁错有用得多。
时间维度上的筛选:观察窗口本身就是筛子
还有一把筛子藏在时间维度里,而且它最不容易被看见:你选择的观察窗口,本身就是一次筛选。
窗口太短,会看见季节性而误认为是趋势。一周的数据看不见月末的结算高峰,三天的数据看不见周末的行为差异,一个季度的数据看不见年度预算周期。窗口与业务节律不匹配时,你测到的是节律,不是变化。
窗口的位置也会偏。新品上线首周的数据里混着新鲜感效应,用户因为「新」而多点了几下;六个月后的数据里混着疲劳效应。同一批人、同一个功能,两个窗口能给出相反的结论,而两者都是真的。
更隐蔽的一种是事件驱动观察:只在出问题时拉数据,于是样本永远是事故样本。这样的样本在描述事故时非常有效,在描述常态时几乎无效,但两者在报告里长得一模一样。
对策不复杂:把抽样节奏固定下来,按固定周期取数,同时保留一部分随机窗口的抽查。固定周期防漏,随机窗口防偏。时间窗是筛子里最便宜的一把,也是最容易被忘记的一把。
把样本量意识变成日常动作:五个可执行习惯
把上面这些收成日常动作,只需要五个习惯,每个都能在一句话内完成。
第一,任何数字先问分母。听到「转化率提升了」,先问基数是多少;听到「用户很满意」,先问被问的是哪一批用户。分母一露头,很多数字会自动变得谦虚。
第二,任何结论标注 n 与窗口。写「二十三个样本、观察两周」,比写「经过调研发现」诚实得多,也让后来的人知道这条结论的适用范围。标注成本很低,收益是整条结论链的可追溯性。
第三,任何「大家都说」追问「谁没说」。会议上的共识往往只是在场者的共识;把「谁没被问到」当成固定追问,能挡掉相当一部分误判。
第四,任何对比先估最小可检测效应。不用精确,估个量级就够:三十个样本大概只能看见大差别,三百个样本才谈得上中等差别。第五,任何复盘先列缺席者。失败项目、流失用户、被折叠的选项,先列出来再讨论方法论。这五个习惯的共同点是不增加工作量,只改变提问顺序;而提问顺序,往往就是结论质量的上限。
常见问题
1.问:样本量到底多少才算够?答:没有通用数字,它由你能接受的最小重要差别决定。粗略换算,每组三十个样本大致只能识别大效应,每组三百个才谈得上中等效应。先写清「多大差别才算重要」,样本量才有答案;先看样本量再找结论,答案永远是模糊的。
2.问:只有几十个样本,是不是就什么都不能说?答:可以说,但要换一种说法。把「我们发现」改成「目前看到的迹象是」,并明确这是待验证的假设,同时用另一类证据交叉印证,比如访谈、日志或历史数据。判断可以下,措辞必须标出边界,这样后续被推翻时,成本可控。
3.问:怎么判断我的样本有没有被筛过?答:先写分母。列出口筛、留存筛、记录筛三层的通过率,任何一层低于七成,就说明样本形状已经明显偏斜,需要专门补一批「不在场」的样本。分母写不出来,本身就是最强的信号:你并不知道自己在看谁。
4.问:用户不回问卷,能不能说明他们不在意?答:不能。沉默至少有三种,满意的沉默、失望的沉默、已经离开的沉默,三者在后台都表现为零回复,业务含义却完全不同。正确做法是抽取一部分沉默者做定向回访,先分清沉默的类型,再谈结论。
5.问:样本有偏差,是不是把量加大就能修掉?答:不能。增加样本只会把已有的形状按比例放大,偏的方向不会自己转正。样本量解决的是「能不能看见」,样本结构解决的是「看见的是谁」,两个问题必须分开处理,顺序上先修结构,再谈数量。
图片来源:图1 woodypino / Pixabay (CC0) · 图2 MinoltaMichi / Pixabay (CC0) · 图3 jonathansautter / Pixabay (CC0) · 图4 Waldemar_RU / Pixabay (CC0) · 图5 955169 / Pixabay (CC0) · 图6 StockSnap / Pixabay (CC0) · 图7 fluf / Pixabay (CC0) · 图8 moshehar / Pixabay (CC0) · 图9 fietzfotos / Pixabay (CC0) · 图10 wal_172619 / Pixabay (CC0) · 图11 Bergadder / Pixabay (CC0) · 图12 xiSerge / Pixabay (CC0) · 图13 Agape-frequency / Pixabay (CC0) · 图14 trinhkien91 / Pixabay (CC0) · 图15 marcellosokal / Pixabay (CC0) · 图16 MemoryCatcher / Pixabay (CC0) · 图17 Berger-Team / Pixabay (CC0) · 图18 mostafa_meraji / Pixabay (CC0) · 图19 KELLEPICS / Pixabay (CC0) · 图20 reallywellmadedesks / Pixabay (CC0)
本文为信息分享与方法论科普,不构成任何专业建议,请结合自身情况判断。
本文由 AI 生成,经人类主编终审。
评论(0)