基本信息
阅读时间:约 30 分钟
字数:约 15,563 字
摘要:市场担心:猎头服务是招聘周期的放大器——企业一收紧编制,中高端岗位的委托先停,猎头收入跟着掉。这个判断不算错,但它把一个更需要分辨的问题掩盖了:当收入增速从两位数掉到个位数时,究竟是委托单量在减少,单均佣金在下降,还是顾问产能没跟上?三个原因对应三种完全不同的应对,而市场通常只给出一个笼统的「招聘景气下行」。含糊的判断之所以流行,是因为它无法被证伪。
| — | 摘要与核心预期差 |
| 01 | 全景拆解:五段链条与钱怎么走 |
| 02 | 上游:候选人与人才数据,谁掌握定价权 |
| 03 | 中游:交付组织,产能隐藏在在岗结构里 |
| 04 | 下游:用人企业的预算,边际变化先出现在账期 |
| 05 | 瓶颈识别:★咽喉点在交付产能,不在数据 |
| 06 | 供需与竞争格局:量在涨,价在跌 |
| 07 | 公司映射与证据复筛:六类参与者各自卡在哪一环 |
| 08 | 当期位置:财报季该盯的三个读数 |
| 09 | 外部读数校验:宏观变量只给假设划边界 |
| 10 | 结论与观察指标 |
| A | 数据来源与证据表 |
| B | 证明链台账 |
| C | 数据档次与假设参数 |
摘要与核心预期差
市场担心:猎头服务是招聘周期的放大器——企业一收紧编制,中高端岗位的委托先停,猎头收入跟着掉。这个判断不算错,但它把一个更需要分辨的问题掩盖了:当收入增速从两位数掉到个位数时,究竟是委托单量在减少,单均佣金在下降,还是顾问产能没跟上?三个原因对应三种完全不同的应对,而市场通常只给出一个笼统的「招聘景气下行」。含糊的判断之所以流行,是因为它无法被证伪。
我们认为:猎头服务财报的第一性问题不是需求强弱,而是收入池的五个乘数里哪一个在边际上先动。收入池可拆成就业基数、中高端岗位占比、年主动流动率、平均年薪与加权佣金率五项 [9],前三个由用人企业的编制与流动决定,后两个由职位定价与议价结构决定。把这五项各自定住之后,2023 年收入池约 1,329.1 亿元、2026 年约 1,447.3 亿元,三年累计 8.9%、年均 2.9% [9]。这个增速远低于「中高端招聘复苏」的想象,原因是乘数互相抵消:岗位占比与年薪在上行,流动率与佣金率在下行。
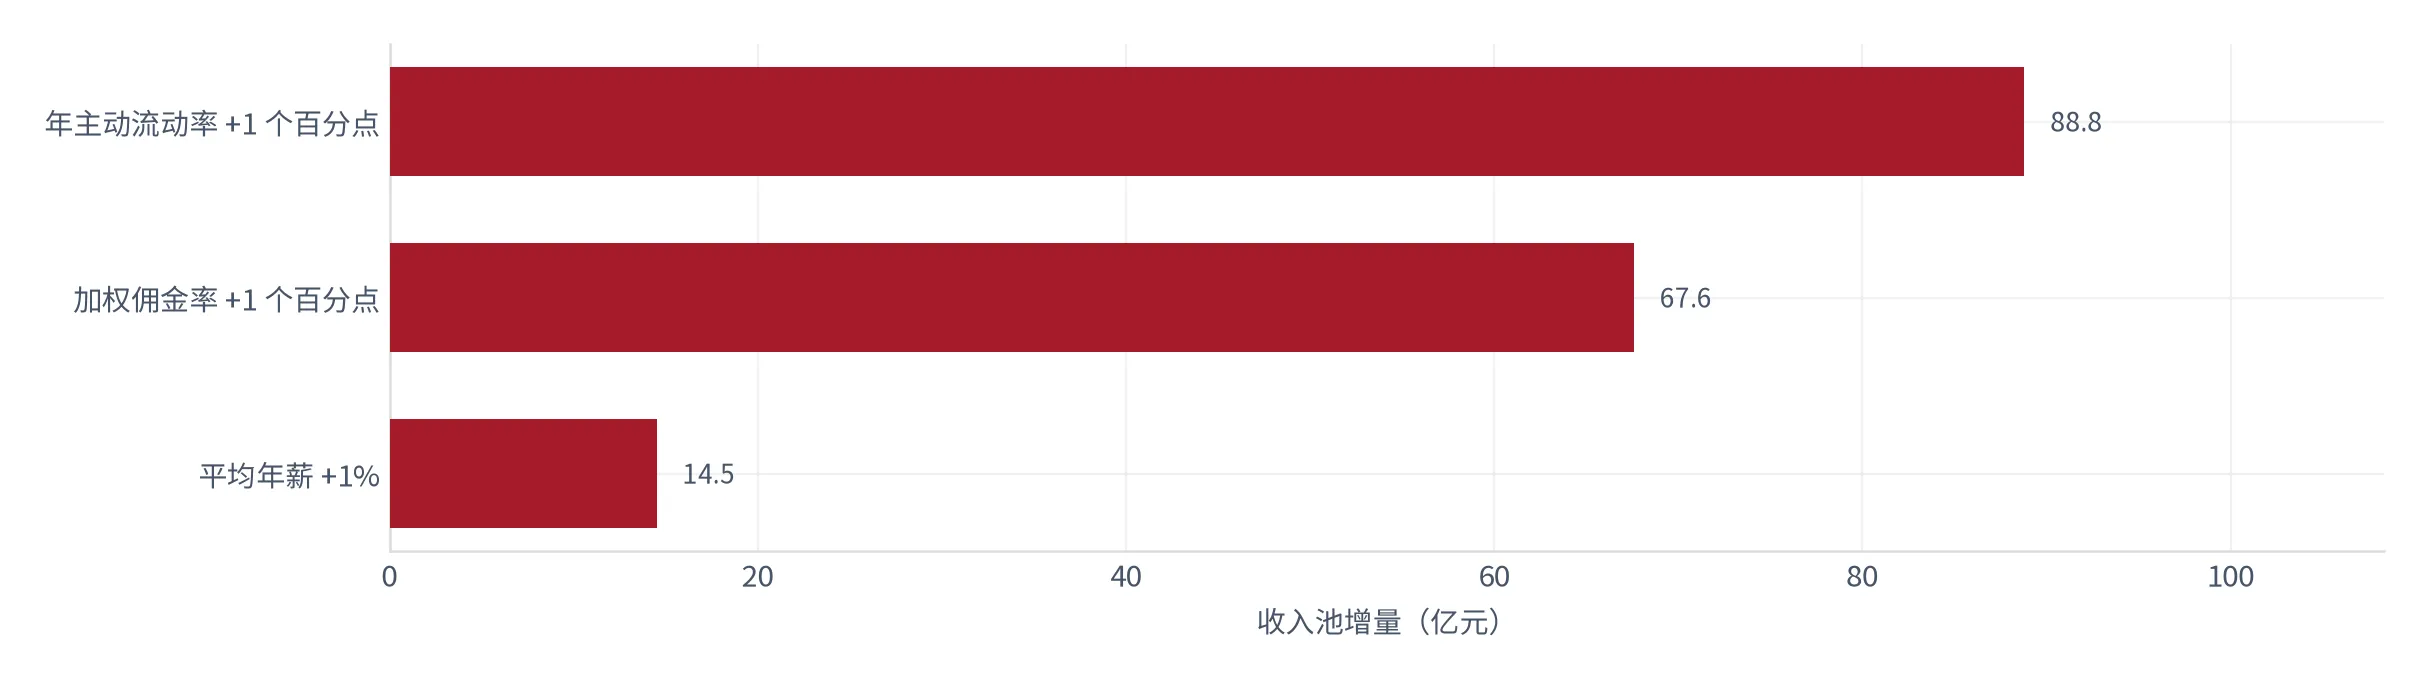
- 收入池的真正驱动量是流动率,不是佣金率。以 2026 年基准做弹性测算,年主动流动率每上行 1 个百分点,收入池增 88.8 亿元;加权佣金率每上行 1 个百分点只增 67.6 亿元;平均年薪每上行 1% 仅增 14.5 亿元 [15]。盯佣金率(猎头是不是在降价)是次要读数,盯流动率(企业是不是在换人)才是主要读数。
- 瓶颈不在数据,在交付产能。五段链条按供给弹性打分:顾问交付产能 1.3 分、合规与数据安全 2.2 分、候选人与人才数据 2.7 分、客户关系与采购预算 3.1 分、技术栈 4.2 分 [14]。前者与次低项相距 0.9 分,是唯一越过分组阈值、可以做强排序的环节。这是本报告与「数据为王」叙事最大的分歧:数据可以买,能独立交付百万年薪岗位的顾问买不到。
- 财报上最容易被误读的读数是毛利率。单均佣金 10.2 万元里,交付成本 4.42 万元、毛利 5.78 万元、毛利率 56.7% [11]。它看起来像软件公司的水平,实际是人力密集型服务的定价结果,稳定性取决于在岗结构而非技术——在岗系数只有 76%,意味着名义产能有三成常年无法交付 [13]。把它当护城河,会在流失率上行时被打穿。
本篇增量:把「猎头财报」从一句景气判断改造成一张可复算的坐标。五个乘数各有取值、公式与单位;三情景给出 2027 年区间;敏感性给出三个参数的权重;红队章交代这套坐标何时失效。同时标注一处硬缺口:上市服务商的分部收入与顾问人数无法逐季取得,本报告因此不做公司级数字推断,只做环节级定位。缺少分部披露却给出公司级毛利率的点评,是把产业口径冒充成了财报口径。
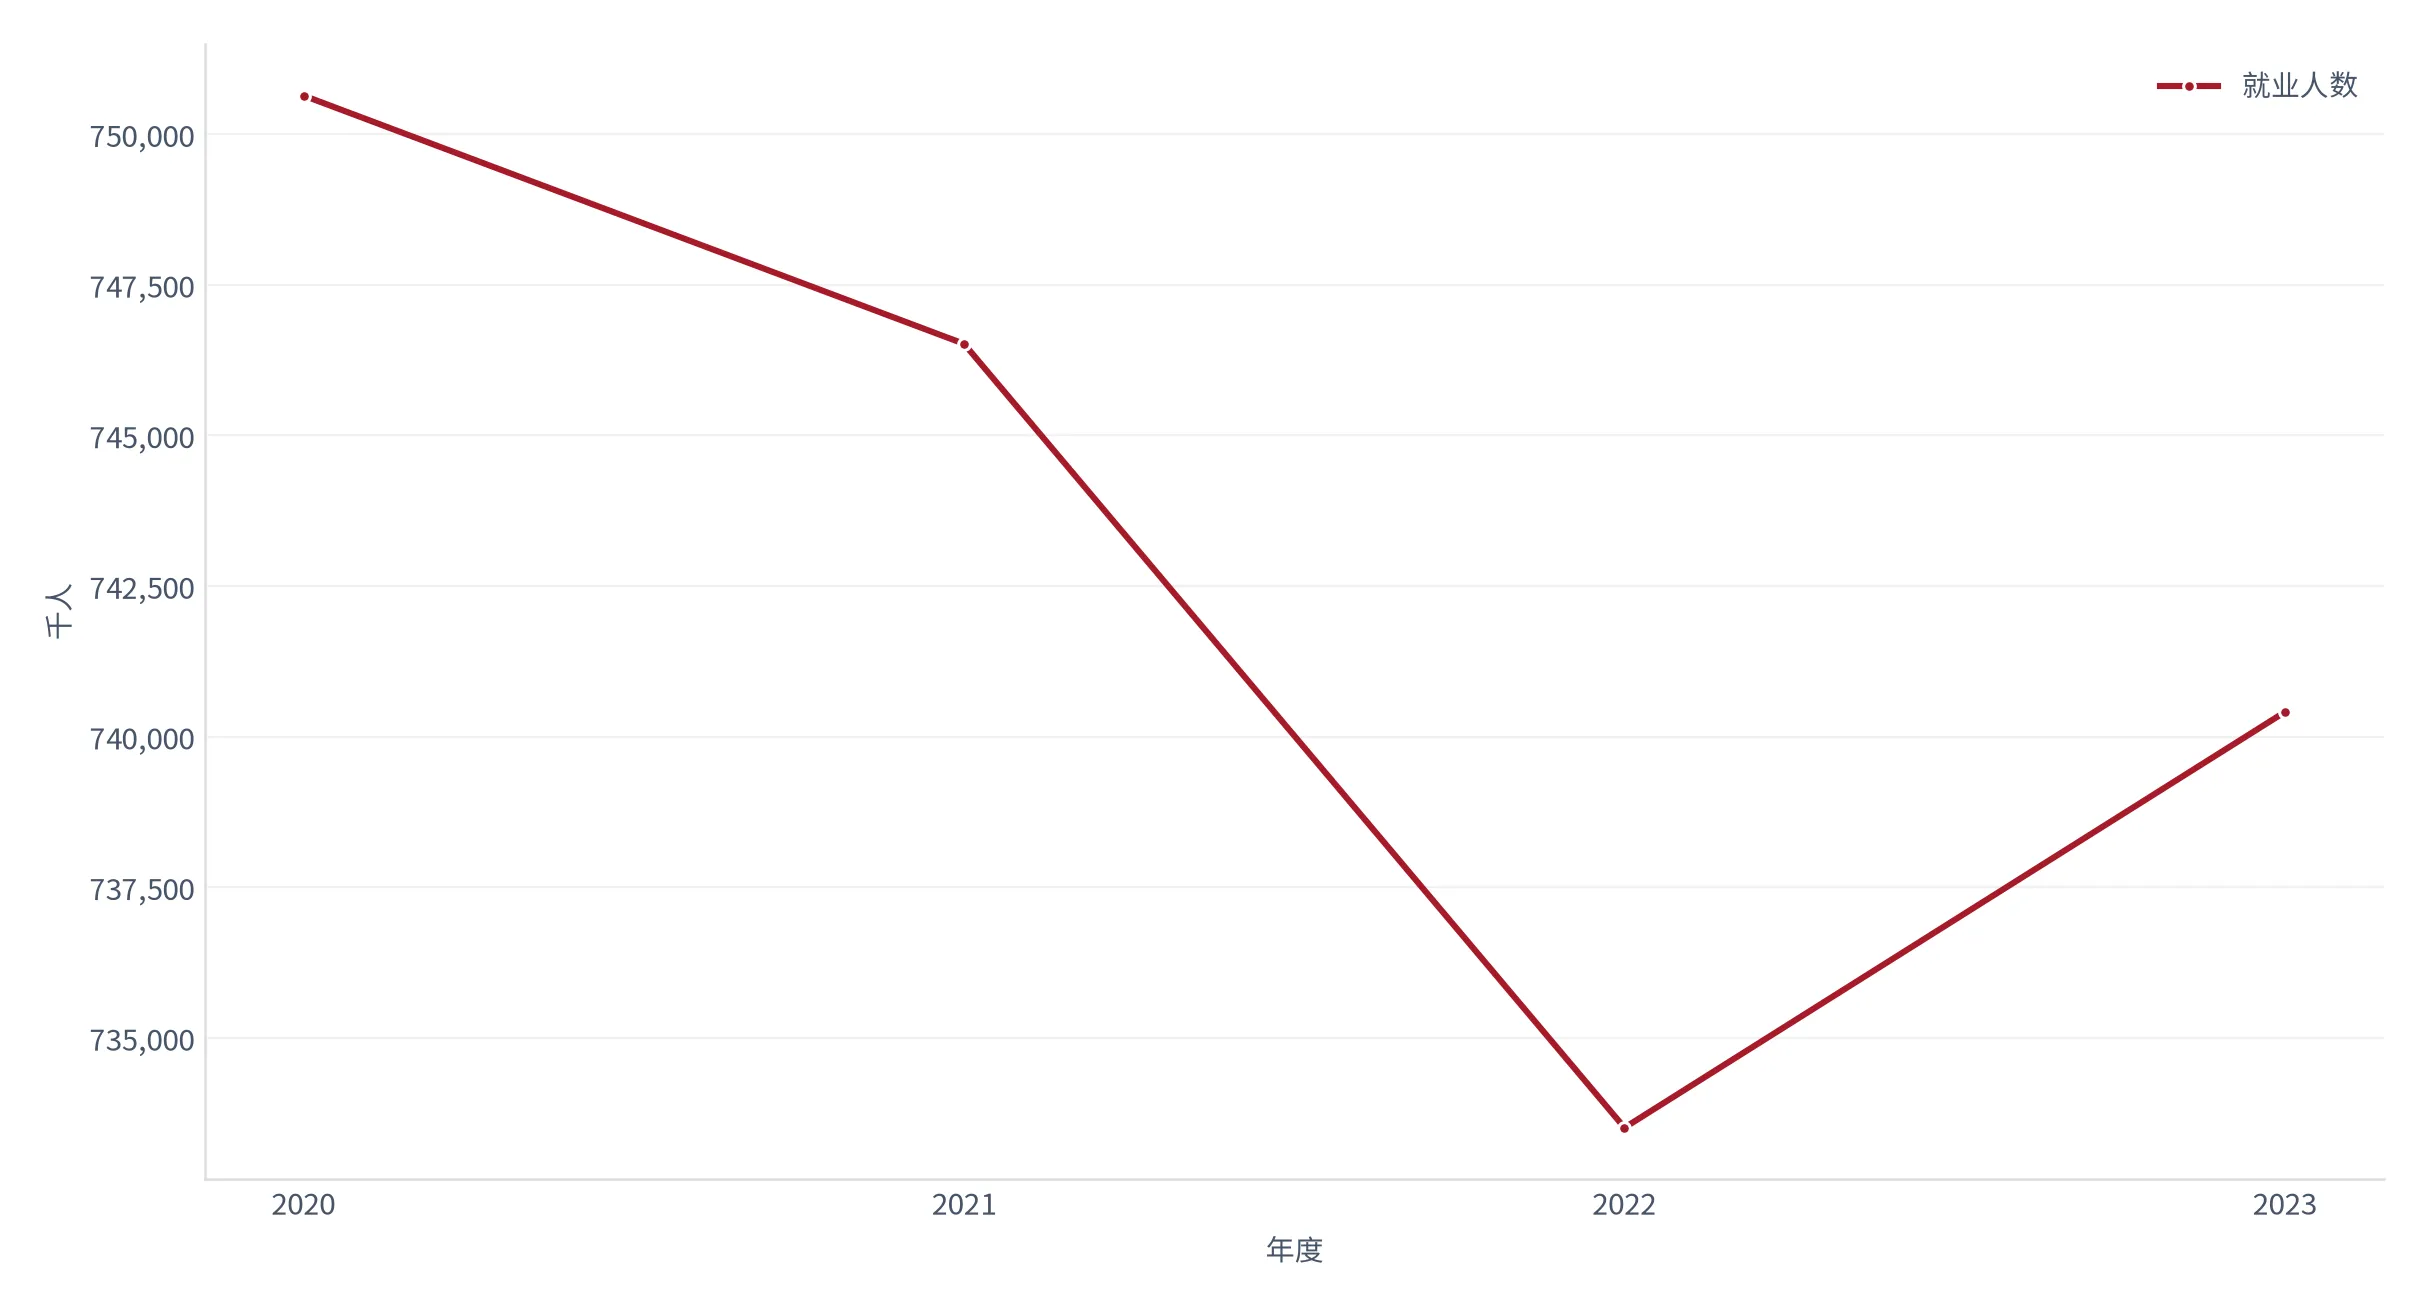
从就业人数开始,因为它是收入池里唯一一个单家企业改变不了的乘数。2020 年 750,640 千人、2023 年 740,410 千人 [2],四年净减 1.36%,2023 年比上年回升 0.94%。这说明就业基数几乎不动,收入池的波动不可能来自它。把慢变量当解释变量是产业研究最常见的伪归因,本报告的分工是:就业基数只用来定水平,解释变化交给流动率与佣金率。所有收入池数字都是产业口径,不把几家上市公司的报表加总。
01全景拆解:五段链条与钱怎么走
把「一个岗位空缺」到「一个人到岗」的全过程拆开,可以分出五段:候选人与人才数据、顾问交付产能、客户关系与采购预算、技术栈、合规与数据安全。五段有明确先后:客户关系决定单量,候选人数据决定可选集,顾问产能决定能不能交付,技术栈决定单位成本,合规决定这门生意能不能持续做。每一段的重要性有两种:一种是对结果的影响,一种是对扩张的约束。客户关系影响最大但约束最小,多签一个客户只需销售时间;顾问产能影响居中但约束最大,一个能独立交付百万年薪岗位的顾问要三到五年养成。
| 环节 | 在做什么(大白话) | 为什么重要 | 代表参与者类型 | 环节毛利率 | 价值流向 |
|---|---|---|---|---|---|
| 候选人与人才数据 | 把在职者的履历、动向与薪酬整理成可反查的池子 | 决定可选集宽度,池子越深越能接难单 | 数据订阅商、垂直社区、猎头自建库 | 68%(测算)[14] | 向社区付费,向中游收订阅费 |
| 顾问交付产能 | 说服候选人面试、说服客户给 offer | 全程唯一不能被流程替代 | KA 制头部服务商、区域精品店 | 56.7%(测算)[11] | 向顾问付薪酬,向客户收佣金 |
| 客户关系与采购预算 | 进入供应商名单并拿到岗位委托 | 决定单量,是收入的唯一入口 | 综合人力资源服务商、驻场招聘方 | 22%(测算)[14] | 让渡佣金率换取年度框架 |
| 技术栈 | 用系统压低匹配与触达的单位成本 | 决定规模化的边际成本曲线 | 招聘系统供应商、人才图谱工具商 | 74%(测算)[14] | 向中游收订阅费与席位费 |
| 合规与数据安全 | 背调、授权、个人信息合规 | 决定这门生意能不能继续做 | 背调机构、合规服务商 | 41%(测算)[14] | 向中游按人次收费 |
毛利率这一列要小心读。68% 的数据订阅毛利与 56.7% 的交付毛利不是同一种东西:前者是软件的边际成本,后者是人力定价的结果。并排放进一张表,容易得出「上游更赚钱所以上游更好」,但这个结论站不住——上游收入池只有交付服务的十分之一量级,客户就是中游,中游一旦自建库就砍掉这块采购。
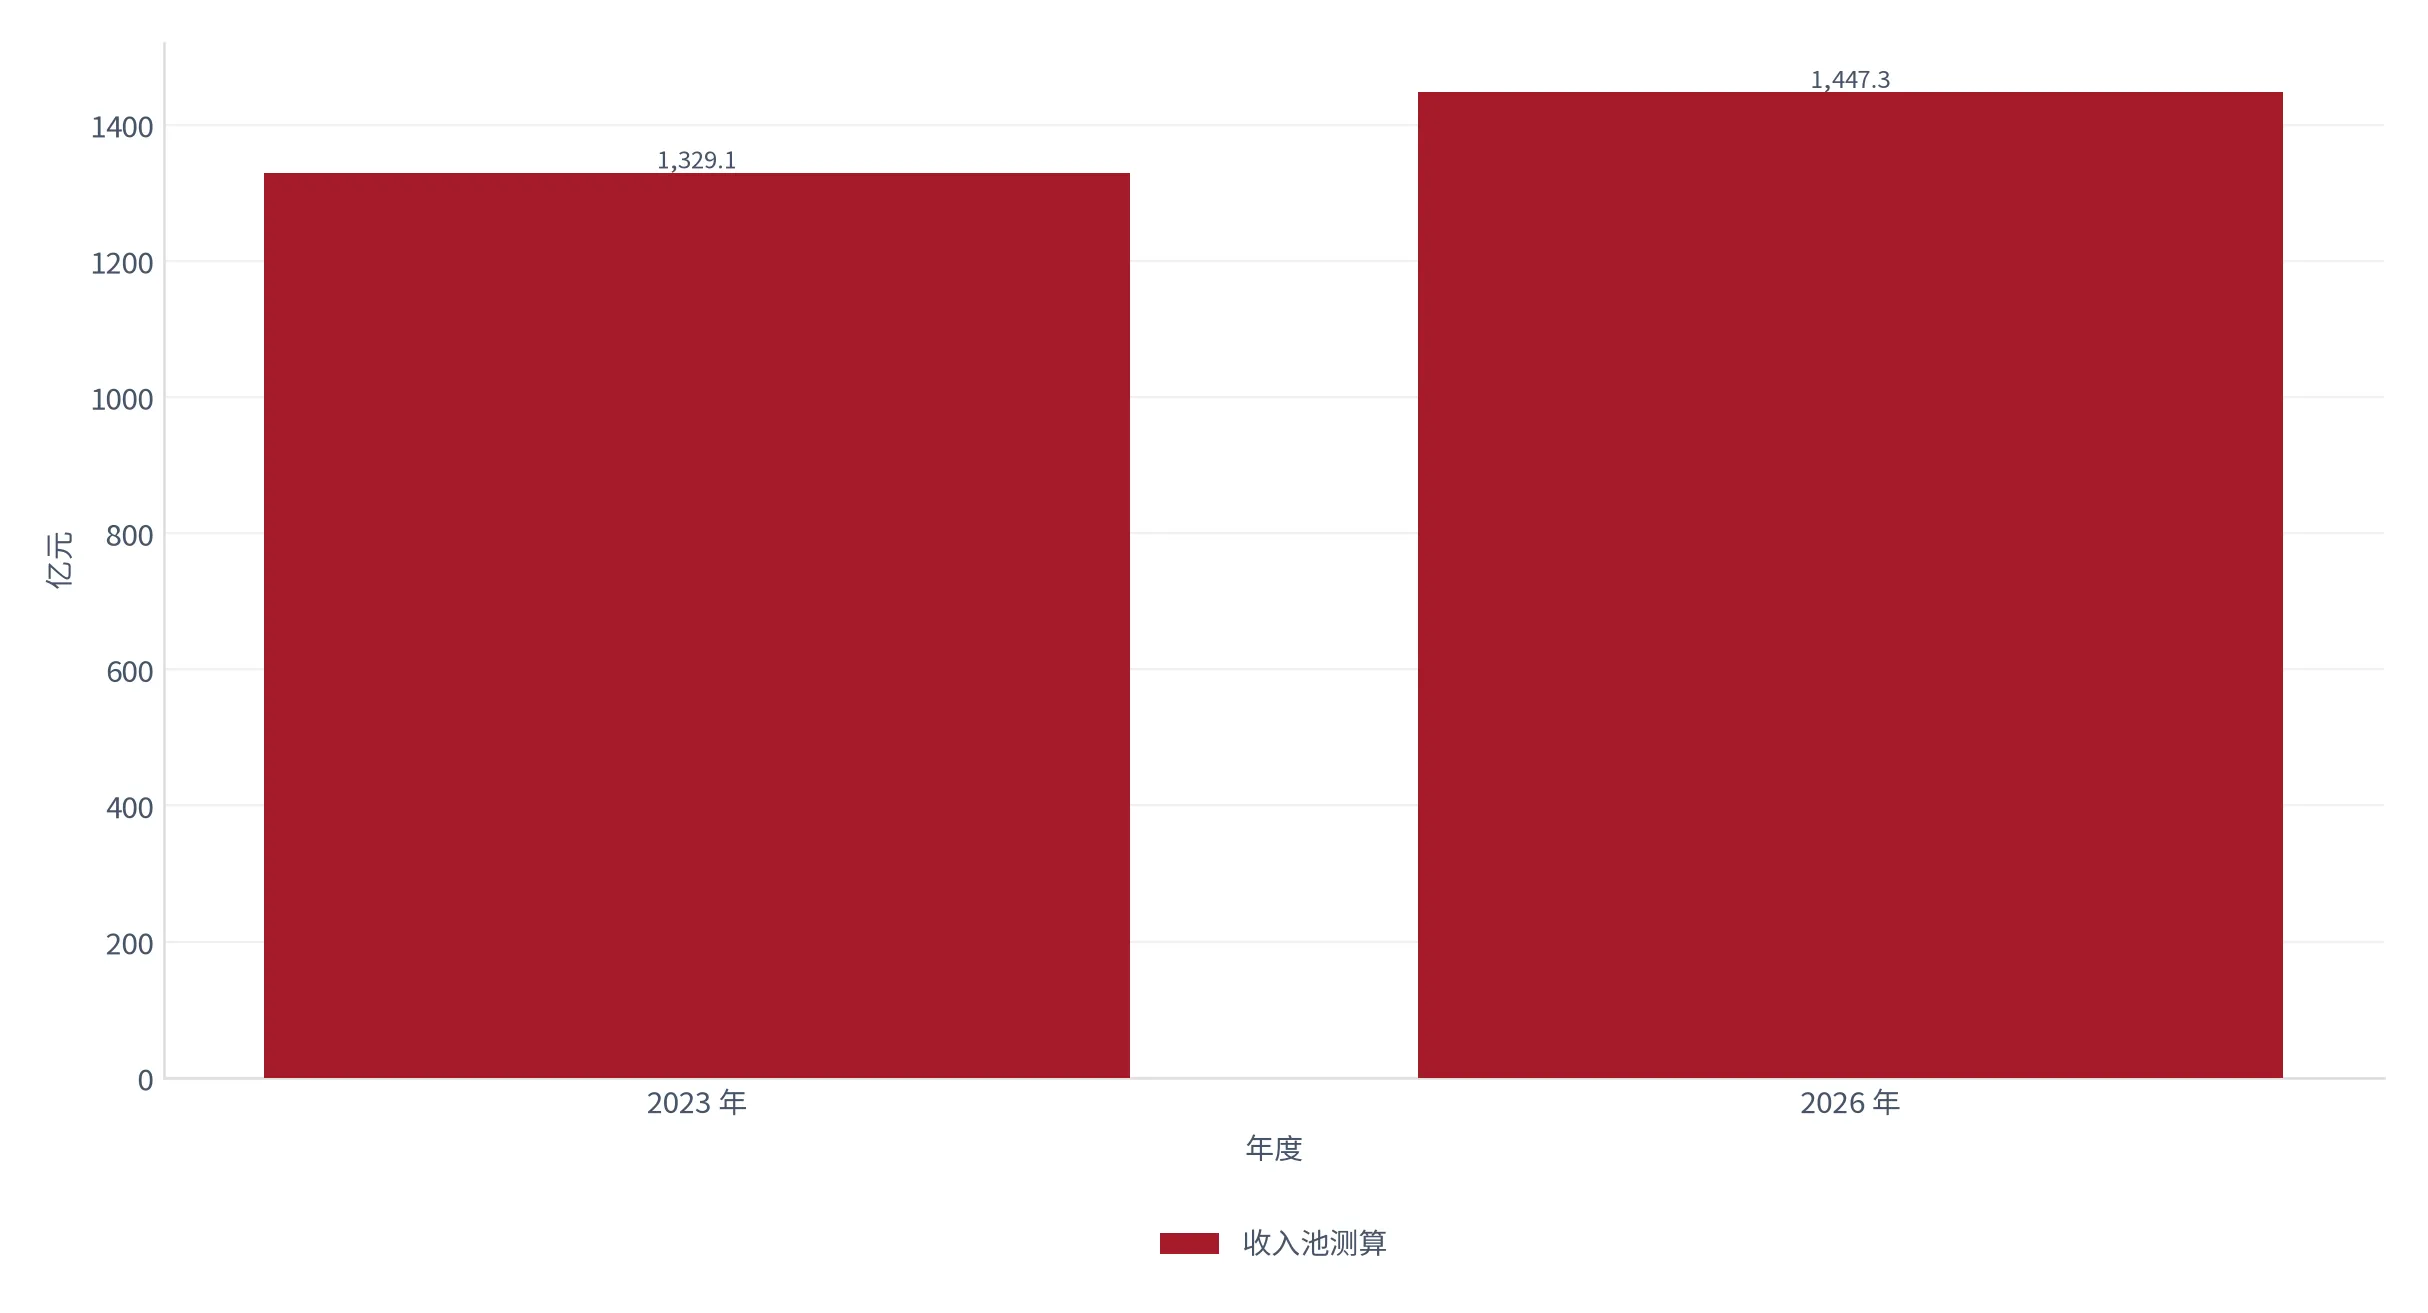
2023 年由就业 7.4041 亿人、岗位占比 1.10%、流动率 16.0%、平均年薪 47.1 万元、加权佣金率 21.66% 连乘得 1,329.1 亿元;2026 年由 7.38 亿人、1.15%、16.3%、48.9 万元、21.40% 连乘得 1,447.3 亿元 [9]。推动上行的是岗位占比与平均年薪(+3.8%),拖累的是佣金率(-0.26 个百分点)与就业基数(-0.33%)。四个方向相反的力叠加,三年只增 8.9%。市场感受不到这个温和,因为感受来自单量——单量三年增 6.1%,比金额更慢,两个数字都不刺激,但都意味着量在涨、价在跌。
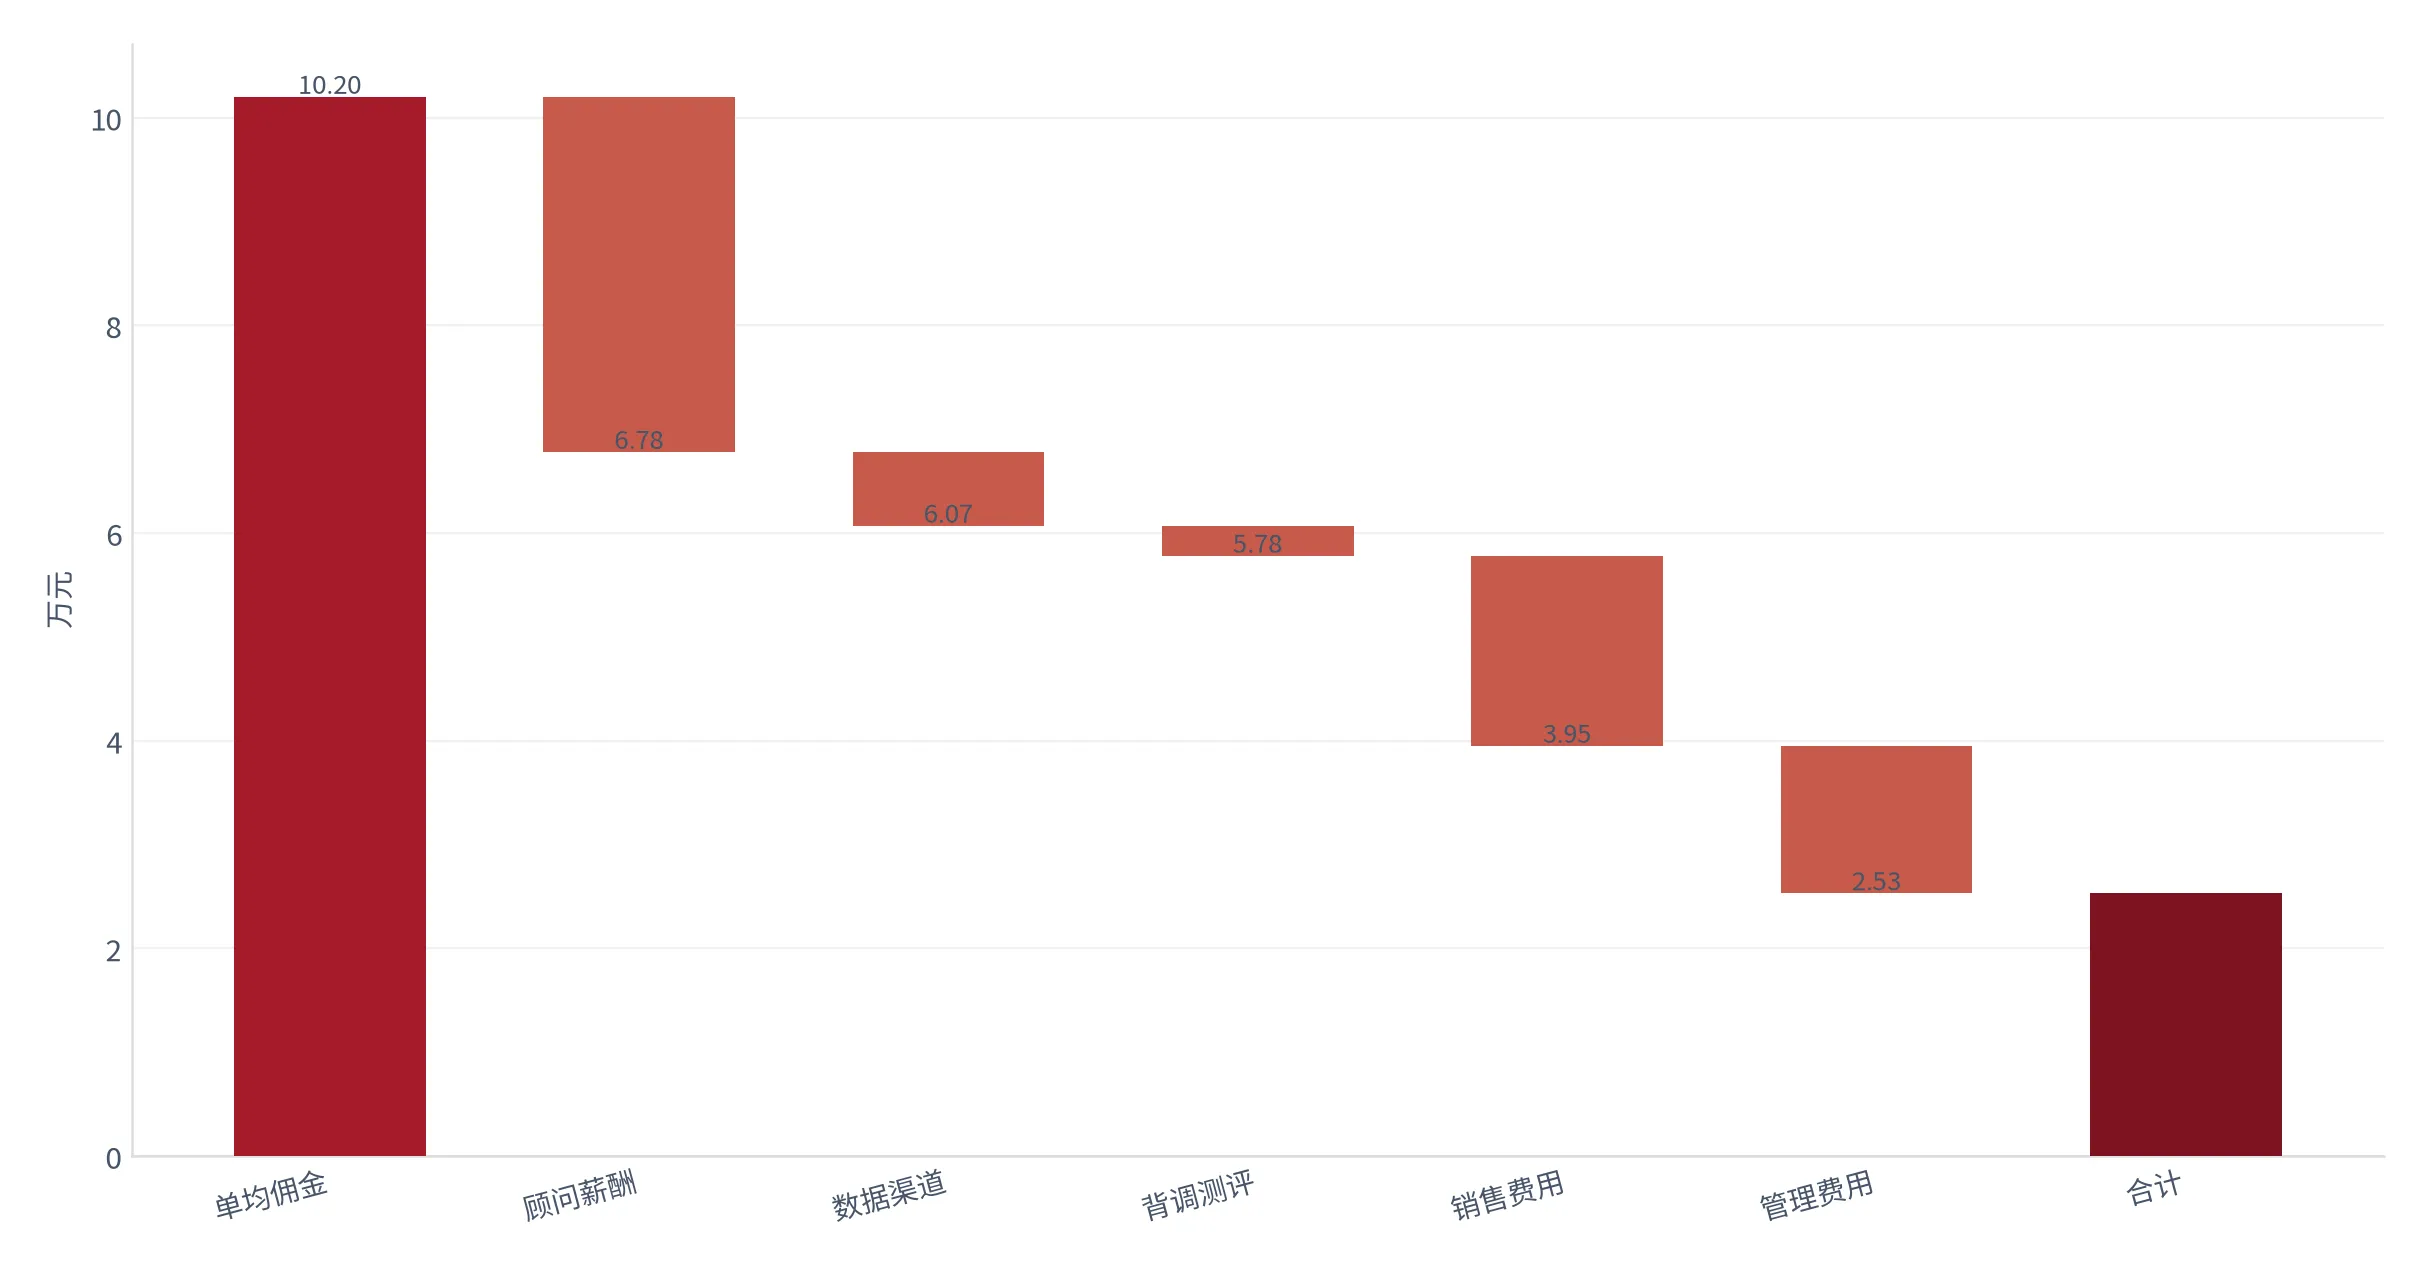
单均 10.2 万元佣金,扣顾问薪酬分摊 3.42 万元、数据与渠道 0.71 万元、背调与测评 0.29 万元,得毛利 5.78 万元;再扣销售费用 1.83 万元、管理费用 1.42 万元,得经营利润 2.53 万元,对应毛利率 56.7%、经营利润率 24.8% [11]。顾问薪酬占交付成本的 77.4%,这是这门生意的本质:它把顾问时间重新定价,溢价来自信息不对称与判断力,不来自资产。四段成本里只有顾问产能既管成本又管收入——交付不出来,佣金根本不会产生。这种双向作用的位置通常就是瓶颈。
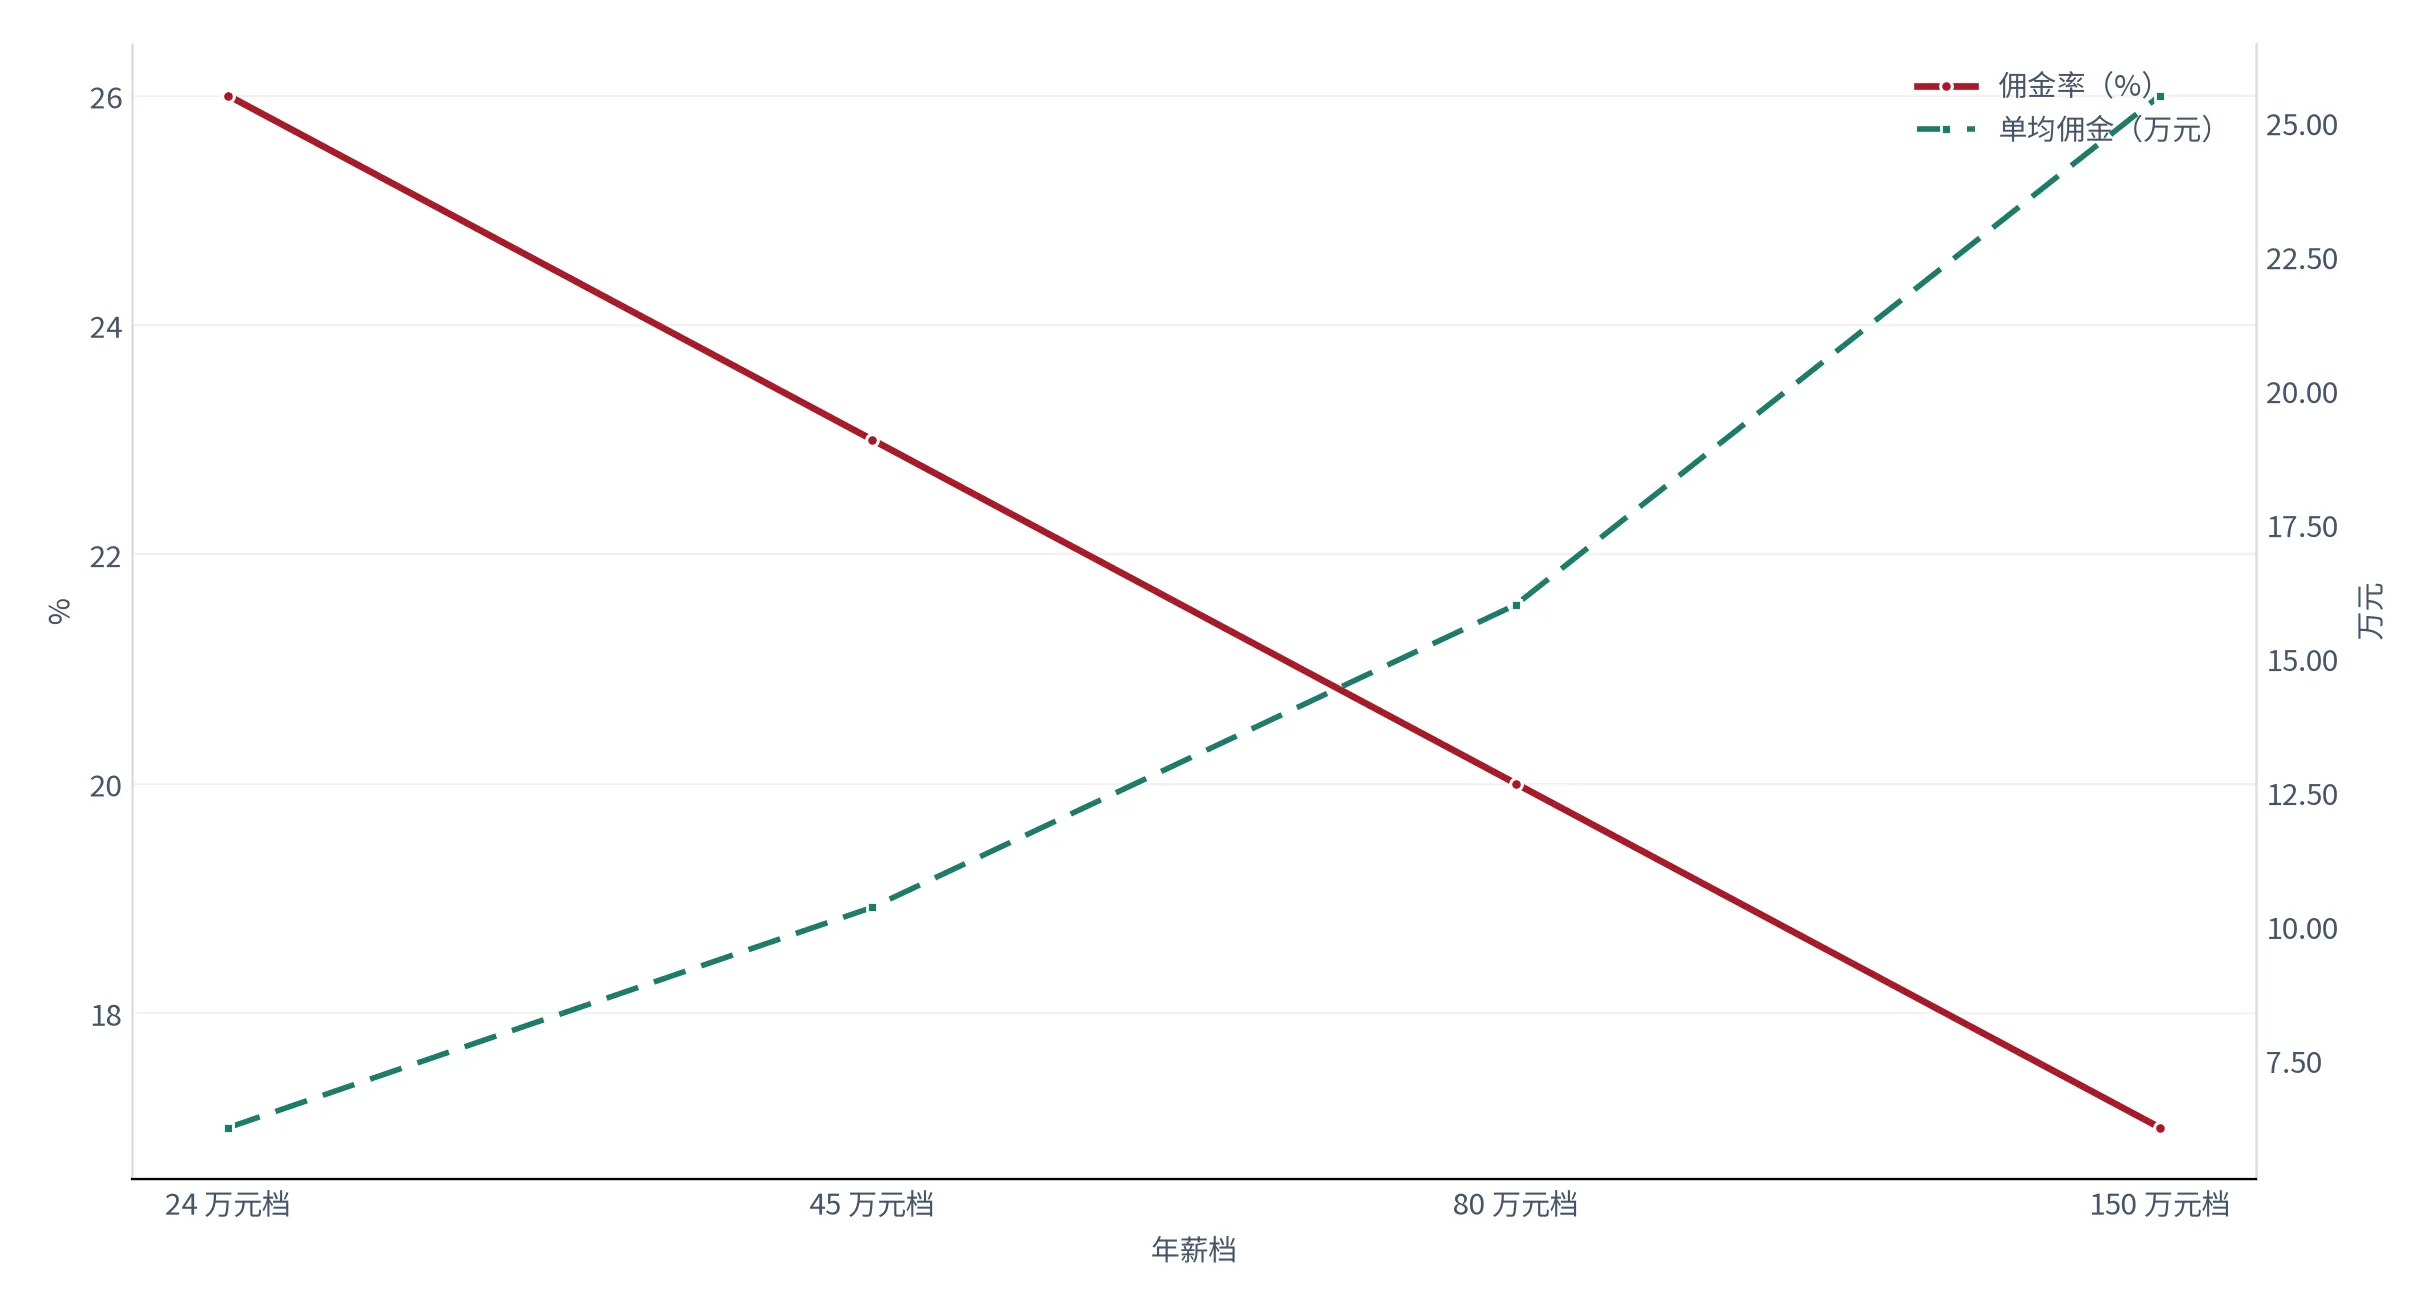
佣金率随年薪递减:24 万元档 26%、45 万元档 23%、80 万元档 20%、150 万元档 17%,单量结构 50%/28%/15%/7%,加权 21.66% [9]。高薪档费率低的理由是议价:大额委托走年度框架与多家比价;中低档更接近急单,费率就高。推论很反直觉:结构向高端迁移时,收入池增长会被费率下行部分抵消。2026 年正是这个情形——占比升了,费率也降了。
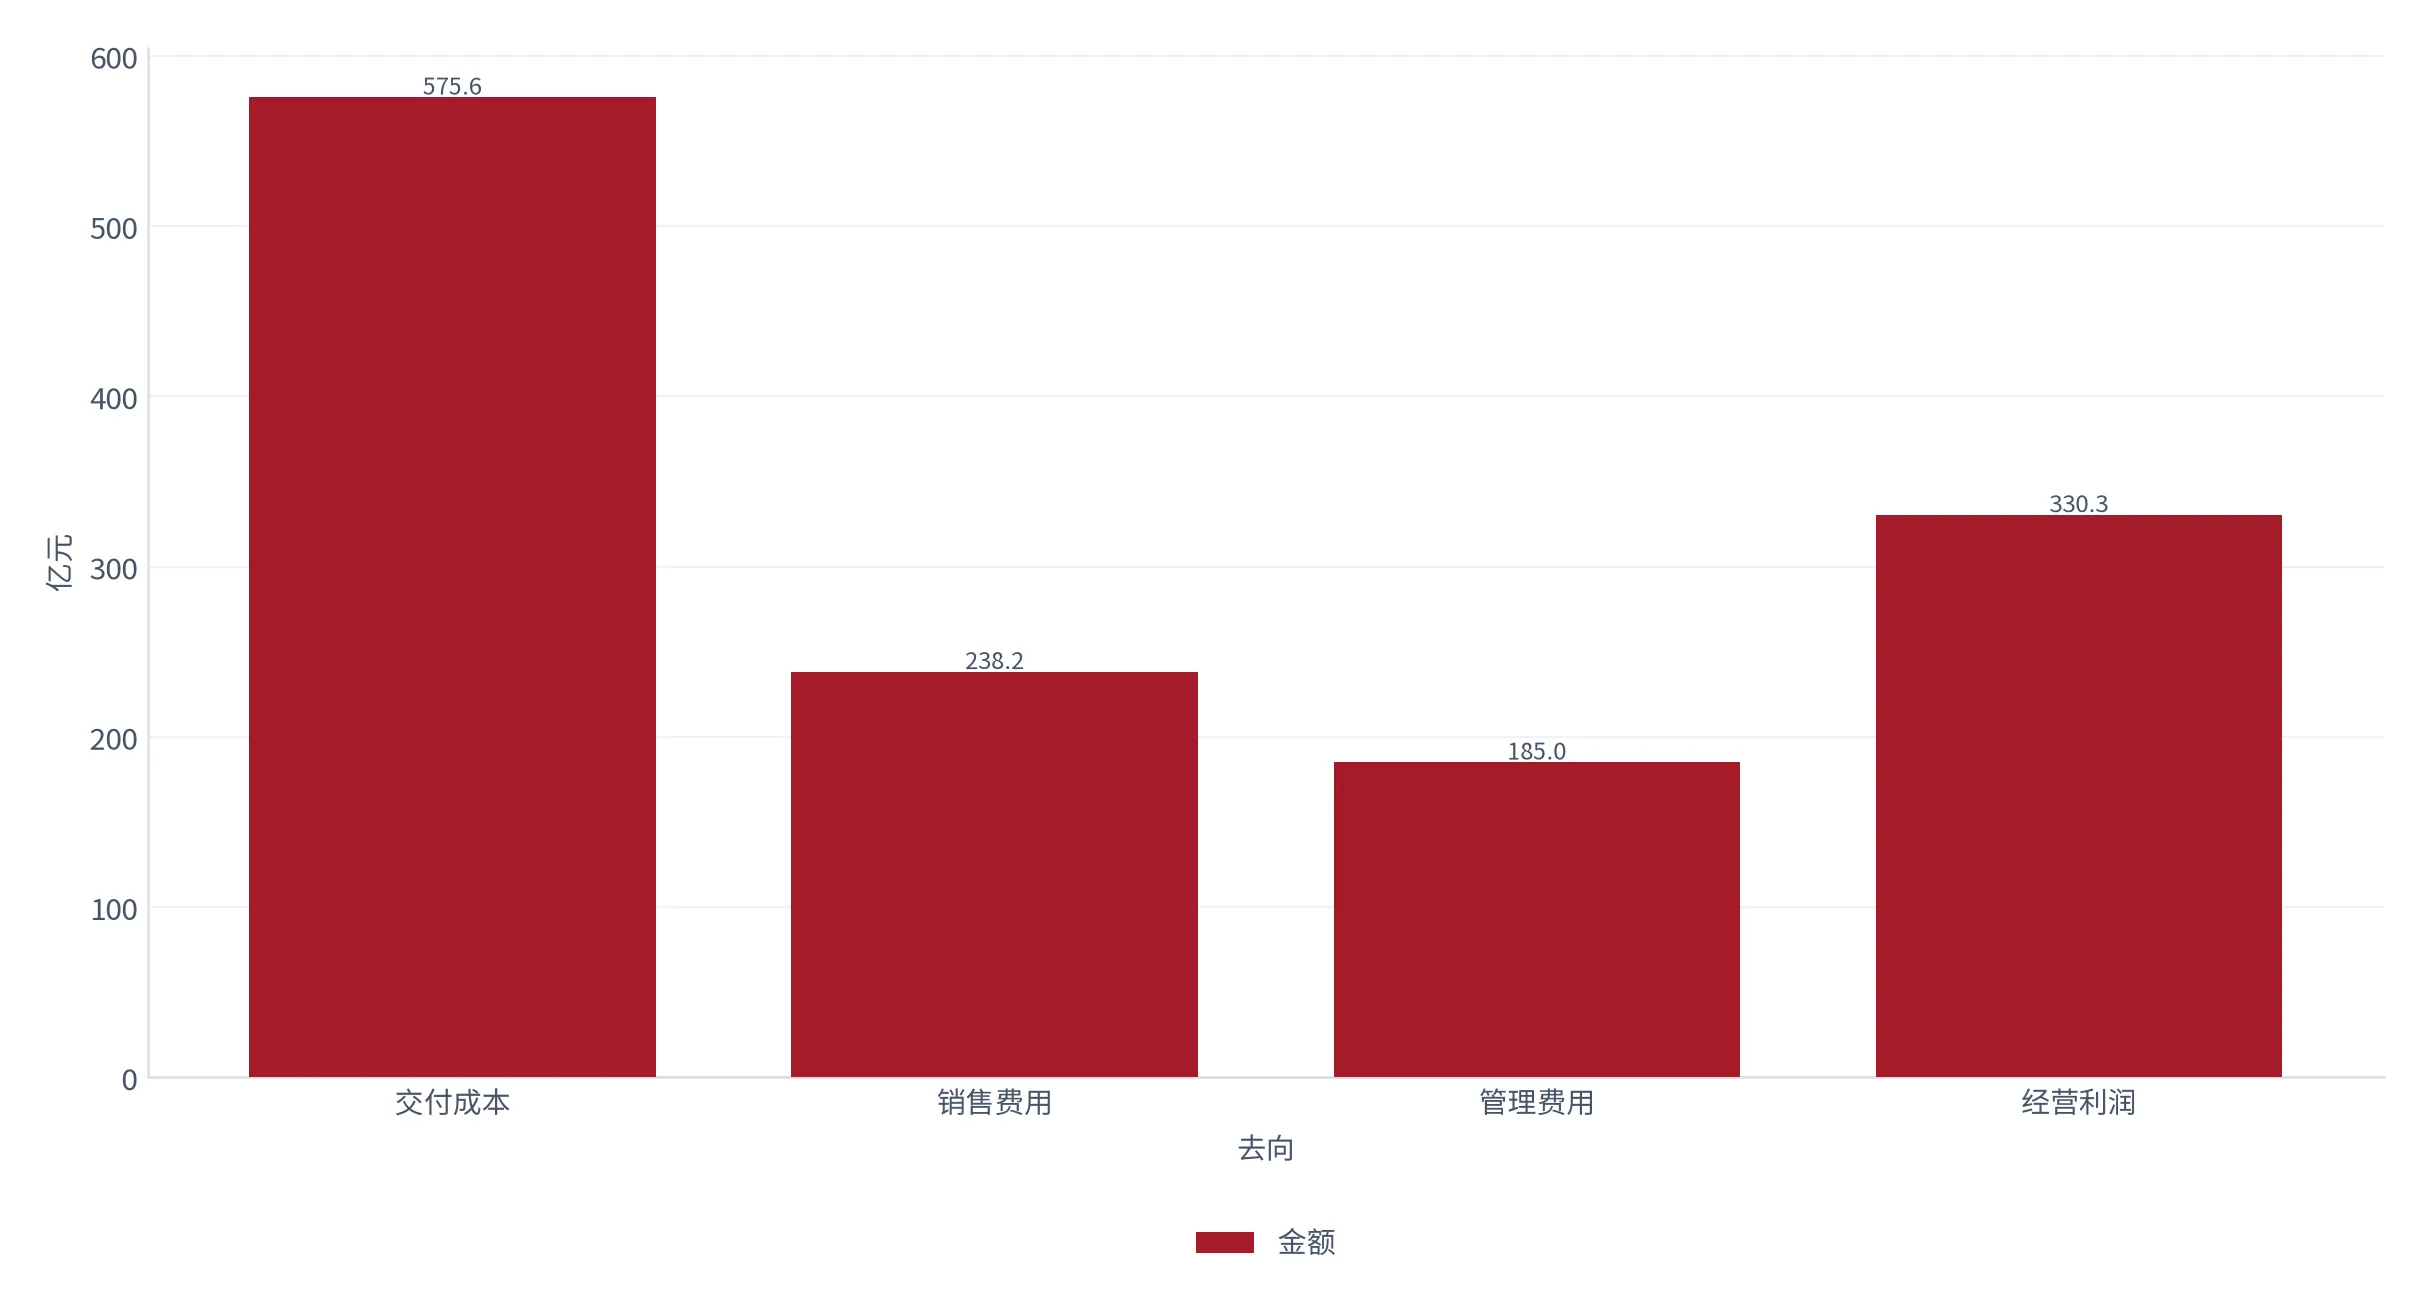
放大到全行业:交付成本 575.6 亿元、销售费用 238.2 亿元、管理费用 185.0 亿元、经营利润约 330 亿元 [11]。全行业一年只留下约 330 亿元营业利润,而链条上五个环节分食同一块佣金——任何一段要提价,都得从另外几段挤出来。这就是为什么猎头的价格战不打在佣金率这一栏,而打在「交付成本由谁承担」这一栏:把顾问成本从固定薪酬改成提成制,等于把毛利风险转移给顾问个人。
02上游:候选人与人才数据,谁掌握定价权
上游常被误解成「简历库」。真正的资产不是简历数量,而是三条同时成立的信息:这个人在不在岗、愿不愿意动、动的时候接受什么条件。第一条公开渠道就能拿到,第二条靠长期触达,第三条只有做过同类岗位成交才知道。壁垒因此不在存量,在更新频率与成交记忆——存了五百万份但半年没更新的库,实际可用量可能不到五十万份。
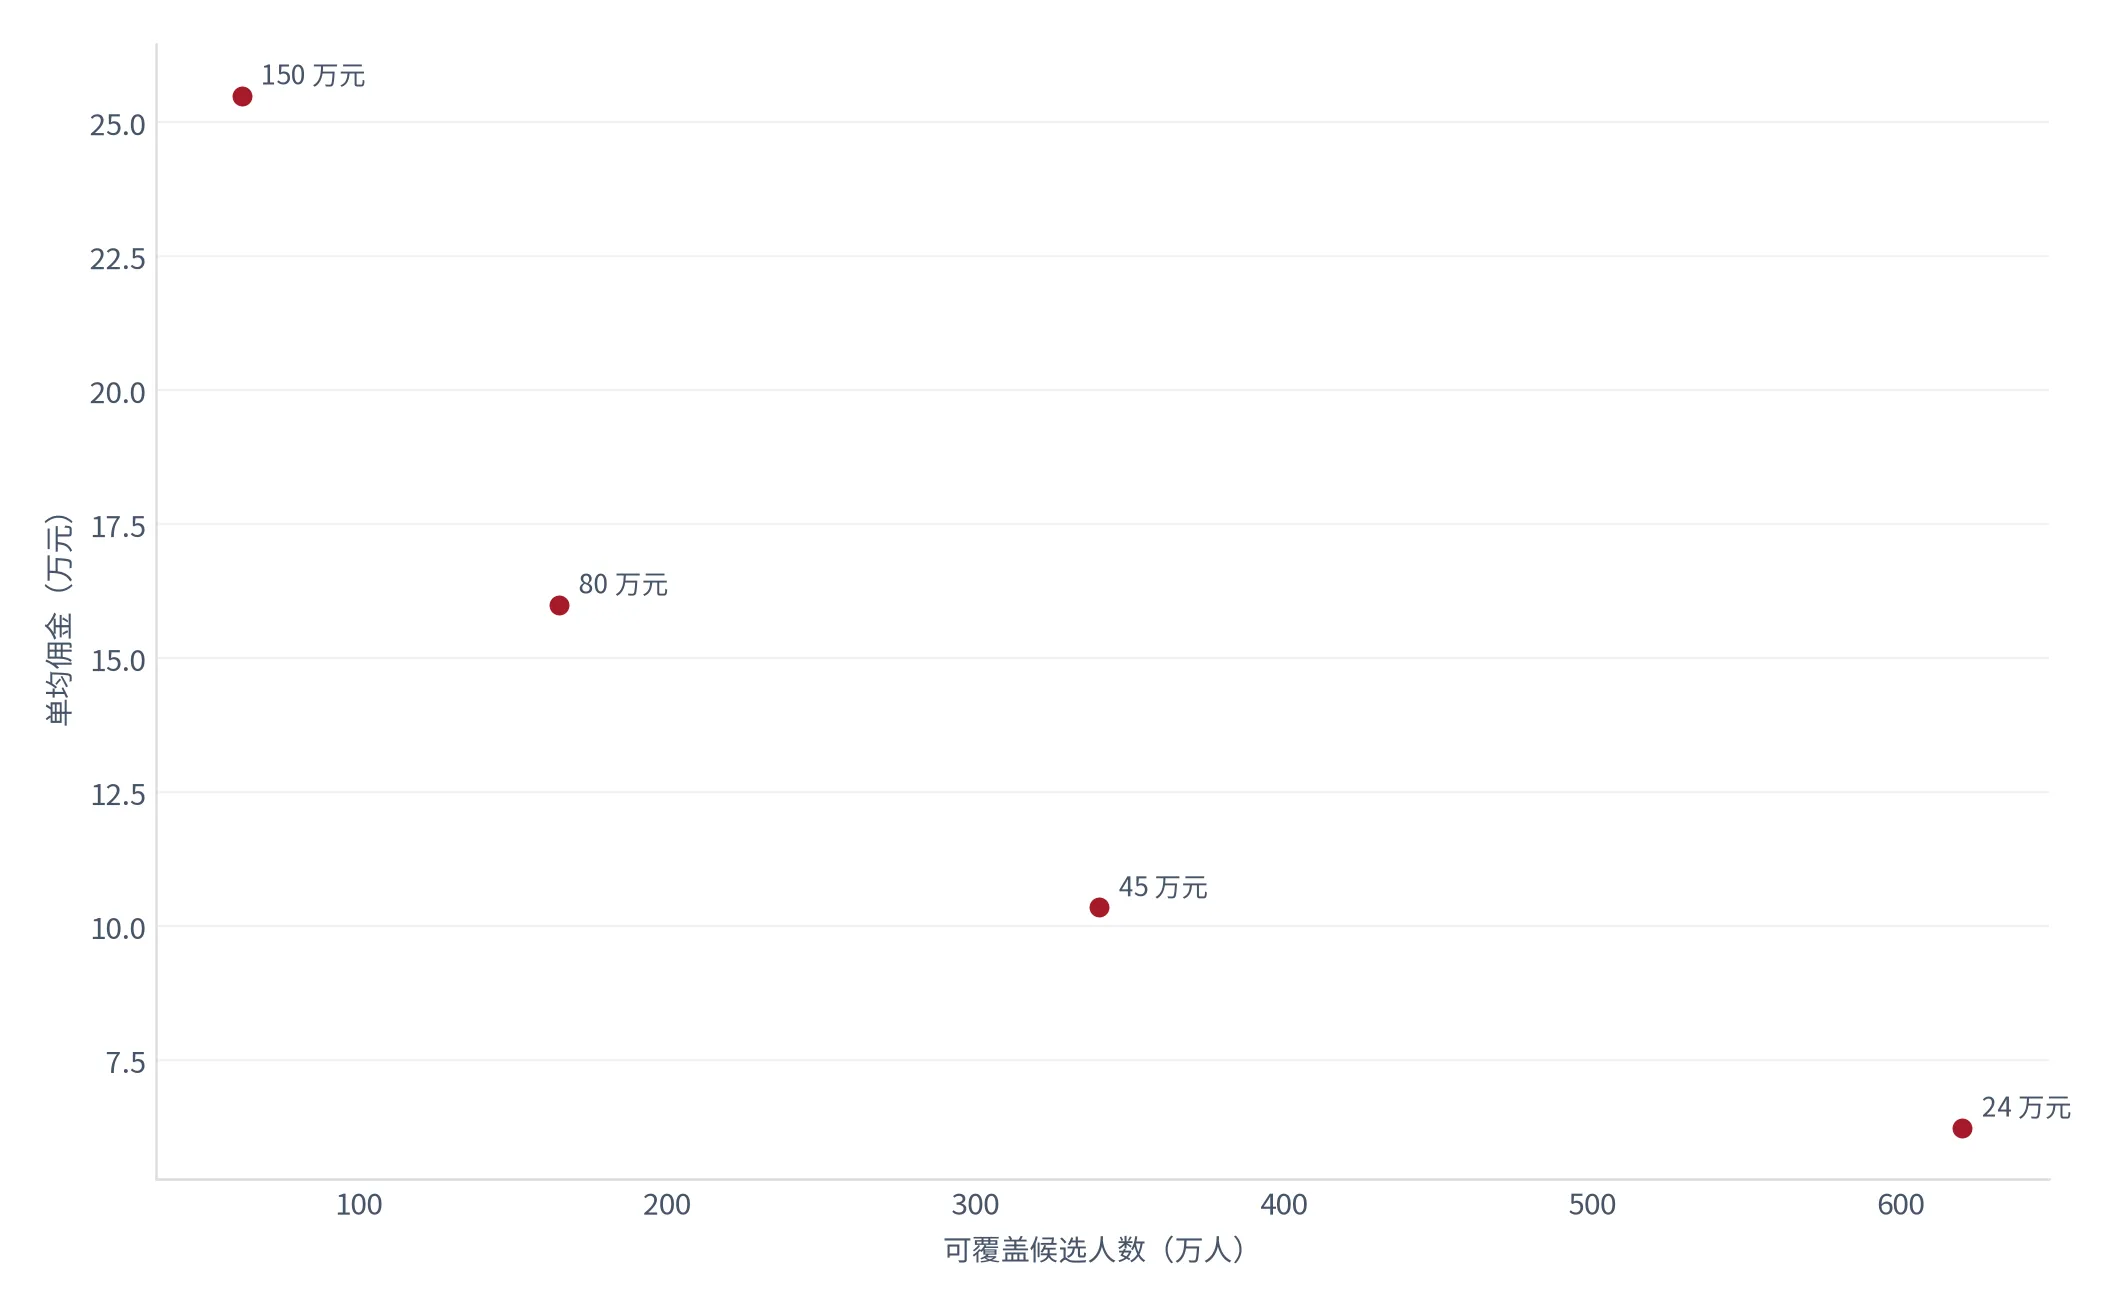
把这条逻辑量化,就是候选池深度与单均佣金的反向关系:四档年薪的可覆盖人数为 620 万、340 万、165 万、62 万人,对应单均佣金 6.24 万元、10.35 万元、16.0 万元、25.5 万元 [9]。池子越深,单均佣金越低,不是因为高端猎头更贪心,而是池子浅的岗位没有替代路径,客户只能接受更高溢价。两段斜率接近(缩水 45% 对涨 66%,缩水 62% 对涨 59%),说明稀缺性溢价是线性的。推论很直接:收入结构向高端迁移而单均佣金没有相应上行,说明在以便宜换单量,不是在收割稀缺性。
上游的第二个特征是它的客户就是中游。数据订阅商把库卖给猎头公司,猎头公司一旦自建库就砍掉这笔采购,所以上游的议价能力有天花板:它的收入增速必须慢于中游的规模增速,否则中游会用自建替代采购。这解释了为什么上游毛利率高(68%)[14] 而收入池只有交付服务的十分之一量级——高毛利与大规模在这个环节不可兼得。还有一层约束来自合规:个人信息规则收紧后,「长期跟踪在职者动向」的合法边界变窄,合规环节毛利率 41%、供给弹性 2.2 分 [14],它决定候选池能以多快的频率更新。把合规当成本项会低估它对供给弹性的影响,当护城河又会高估它的排他性,本报告将其列为并列观察项,不进咽喉点候选。
03中游:交付组织,产能隐藏在在岗结构里
中游是链条上唯一同时决定成本与收入的环节。它的产能不是一个数字,而是三个数字的乘积:多少顾问在岗、每人一年能交付多少单、这些单平均值多少钱。第三个由上游稀缺性决定,前两个由组织决定。财报点评最容易犯的错,是把「顾问人数增长」当成「产能增长」——人数只说明招募做得动,不说明在岗多久、能不能独立交付。
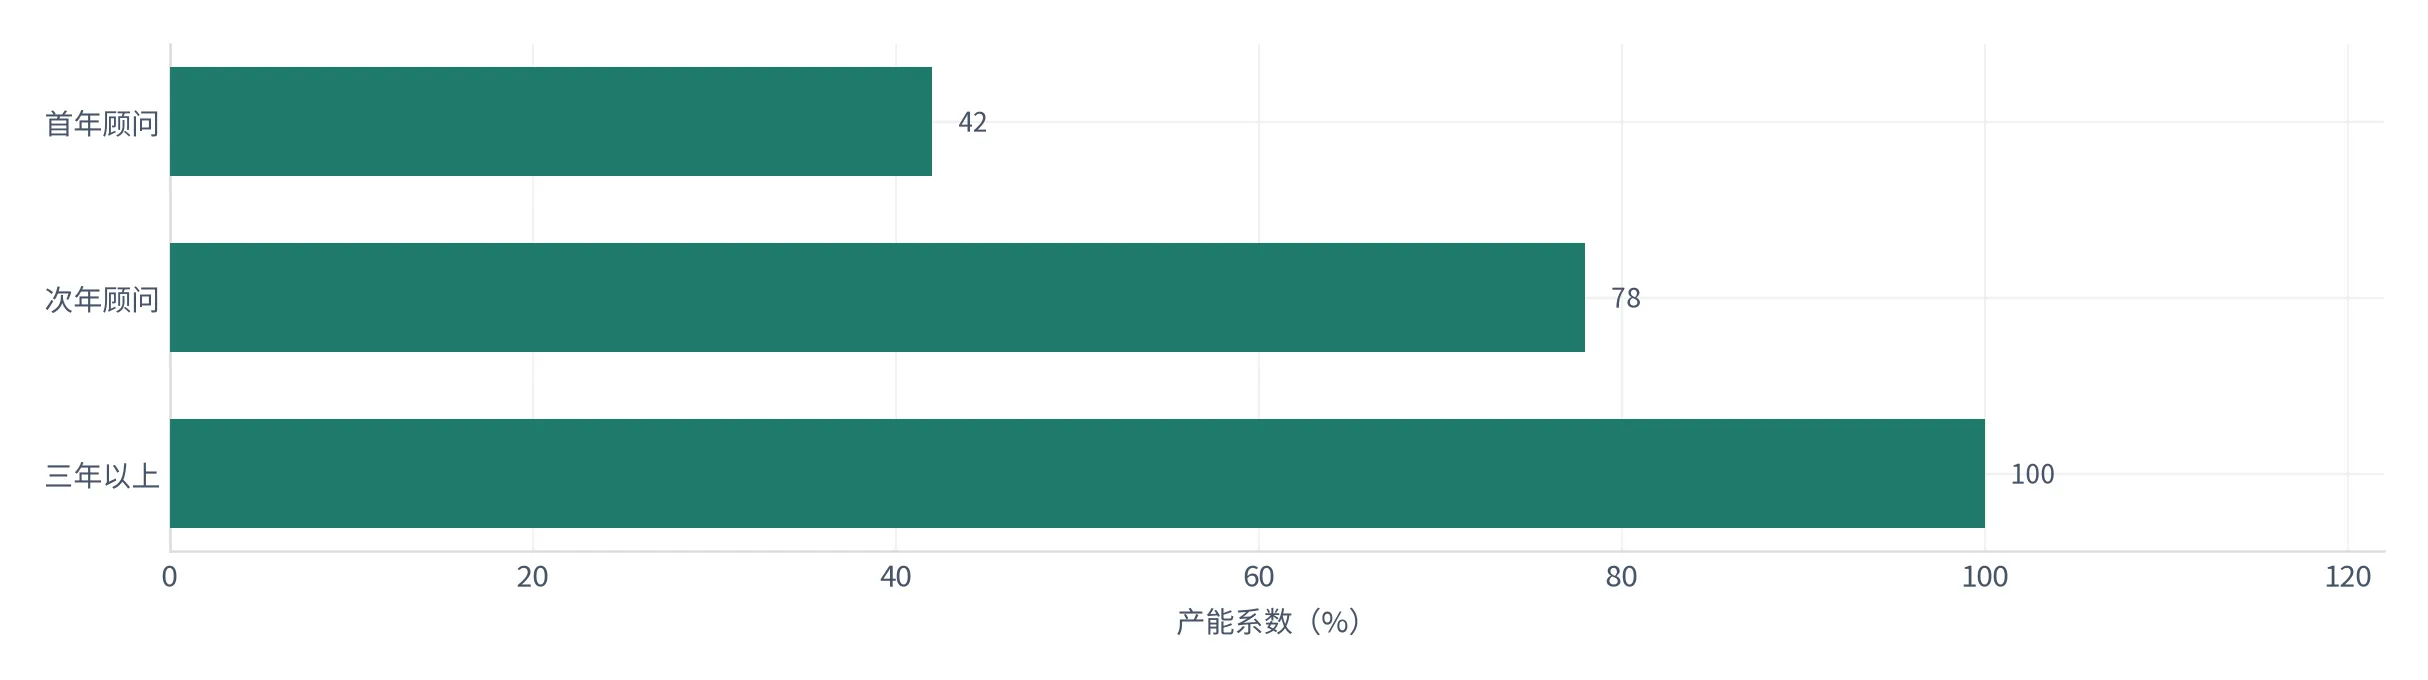
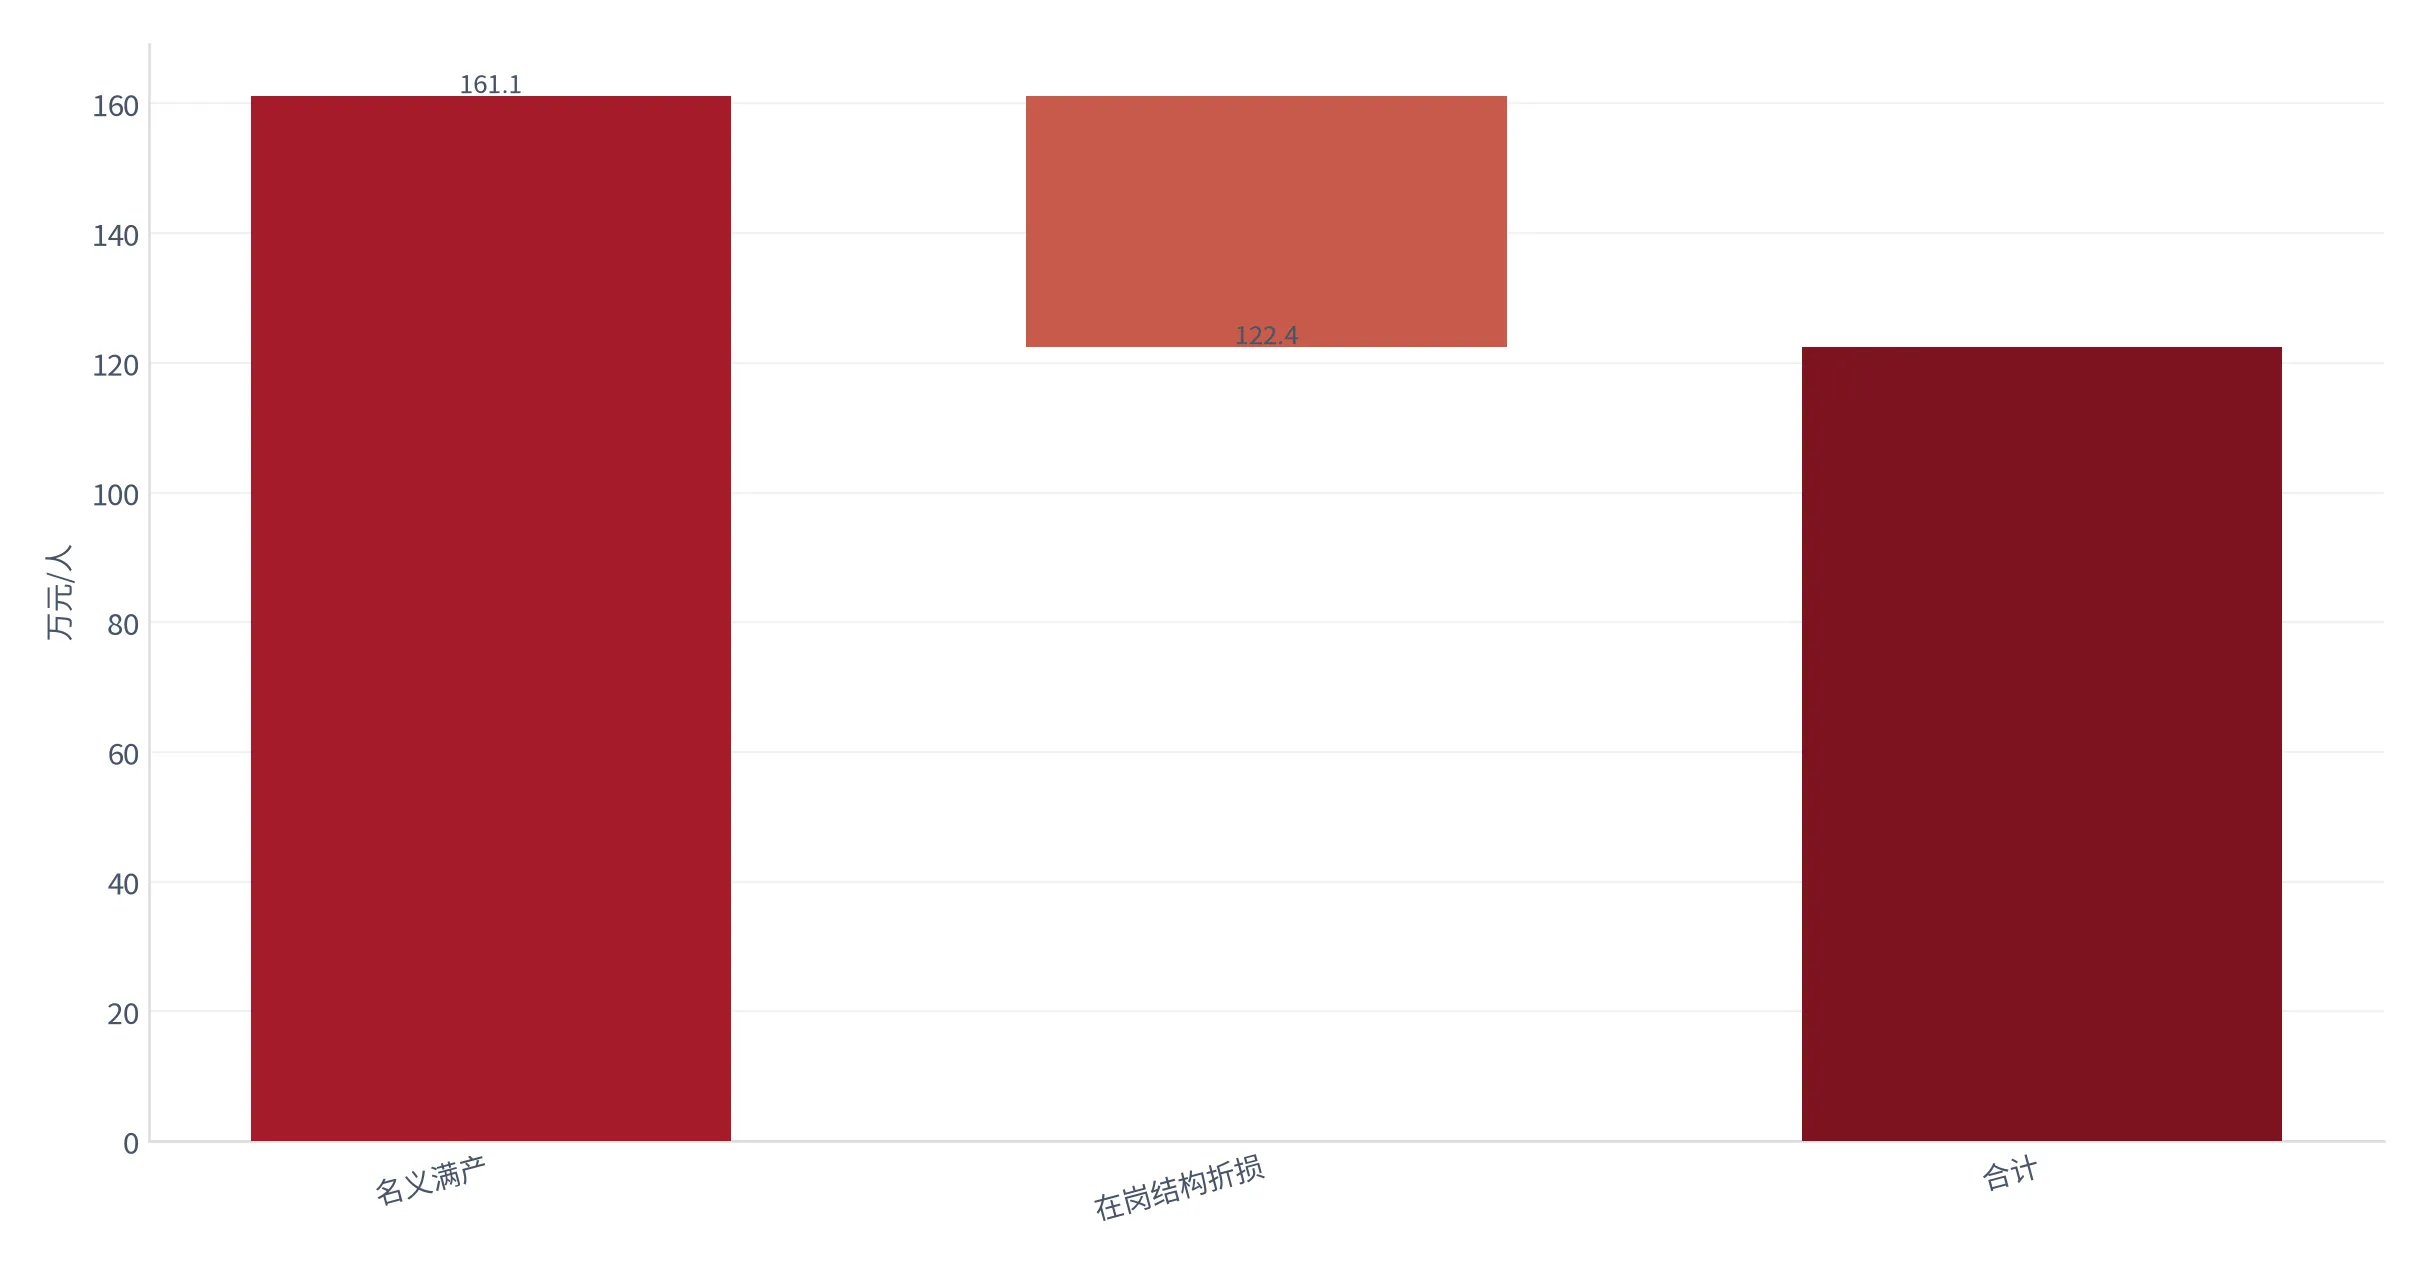
本报告的测算:首年顾问产能系数 42%、次年 78%、三年以上 100%,按 30%、30%、40% 的结构加权得在岗系数 76.0%,名义满产 161.1 万元/人,实际 122.4 万元/人 [13]。首年只有 42%,因为交付能力依赖对某行业岗位图谱的熟悉度,需走完整个成交周期才能建立——这 38.7 万元的落差不出现在利润表任何一行,却决定毛利率的稳定性。另一面是工时:单均交付耗时 76 小时、年有效工时 1,760 小时,理论 23.2 单对实际 12 单,工时利用率 51.8% [10]。两个读数分母不同、不可相乘,但方向一致:产能有一半闲置在流程里。
第二个隐藏产能的变量是流失。年流失率 26%、流失者平均在岗 9.4 个月,净产能损失按「流失率乘在岗缺口」算为 5.6% [13]。5.6% 折算成金额是 74.4 亿元,相当于全行业经营利润的 22.5%,所以顾问留存率是比招募速度更重要的读数:招募在给池子加水,流失在池底开孔。流失的成本不止产能——单顾问重置成本按招募 1.9 万元、培训 0.9 万元、空岗损失 0.7 万元合计 3.5 万元,年流失 2.82 万人对应 9.9 亿元,相当于经营利润的 3.0%。这笔钱分散在销售费用与管理费用两栏,单看不显眼,合起来就是财报里那句「费用率上升」。
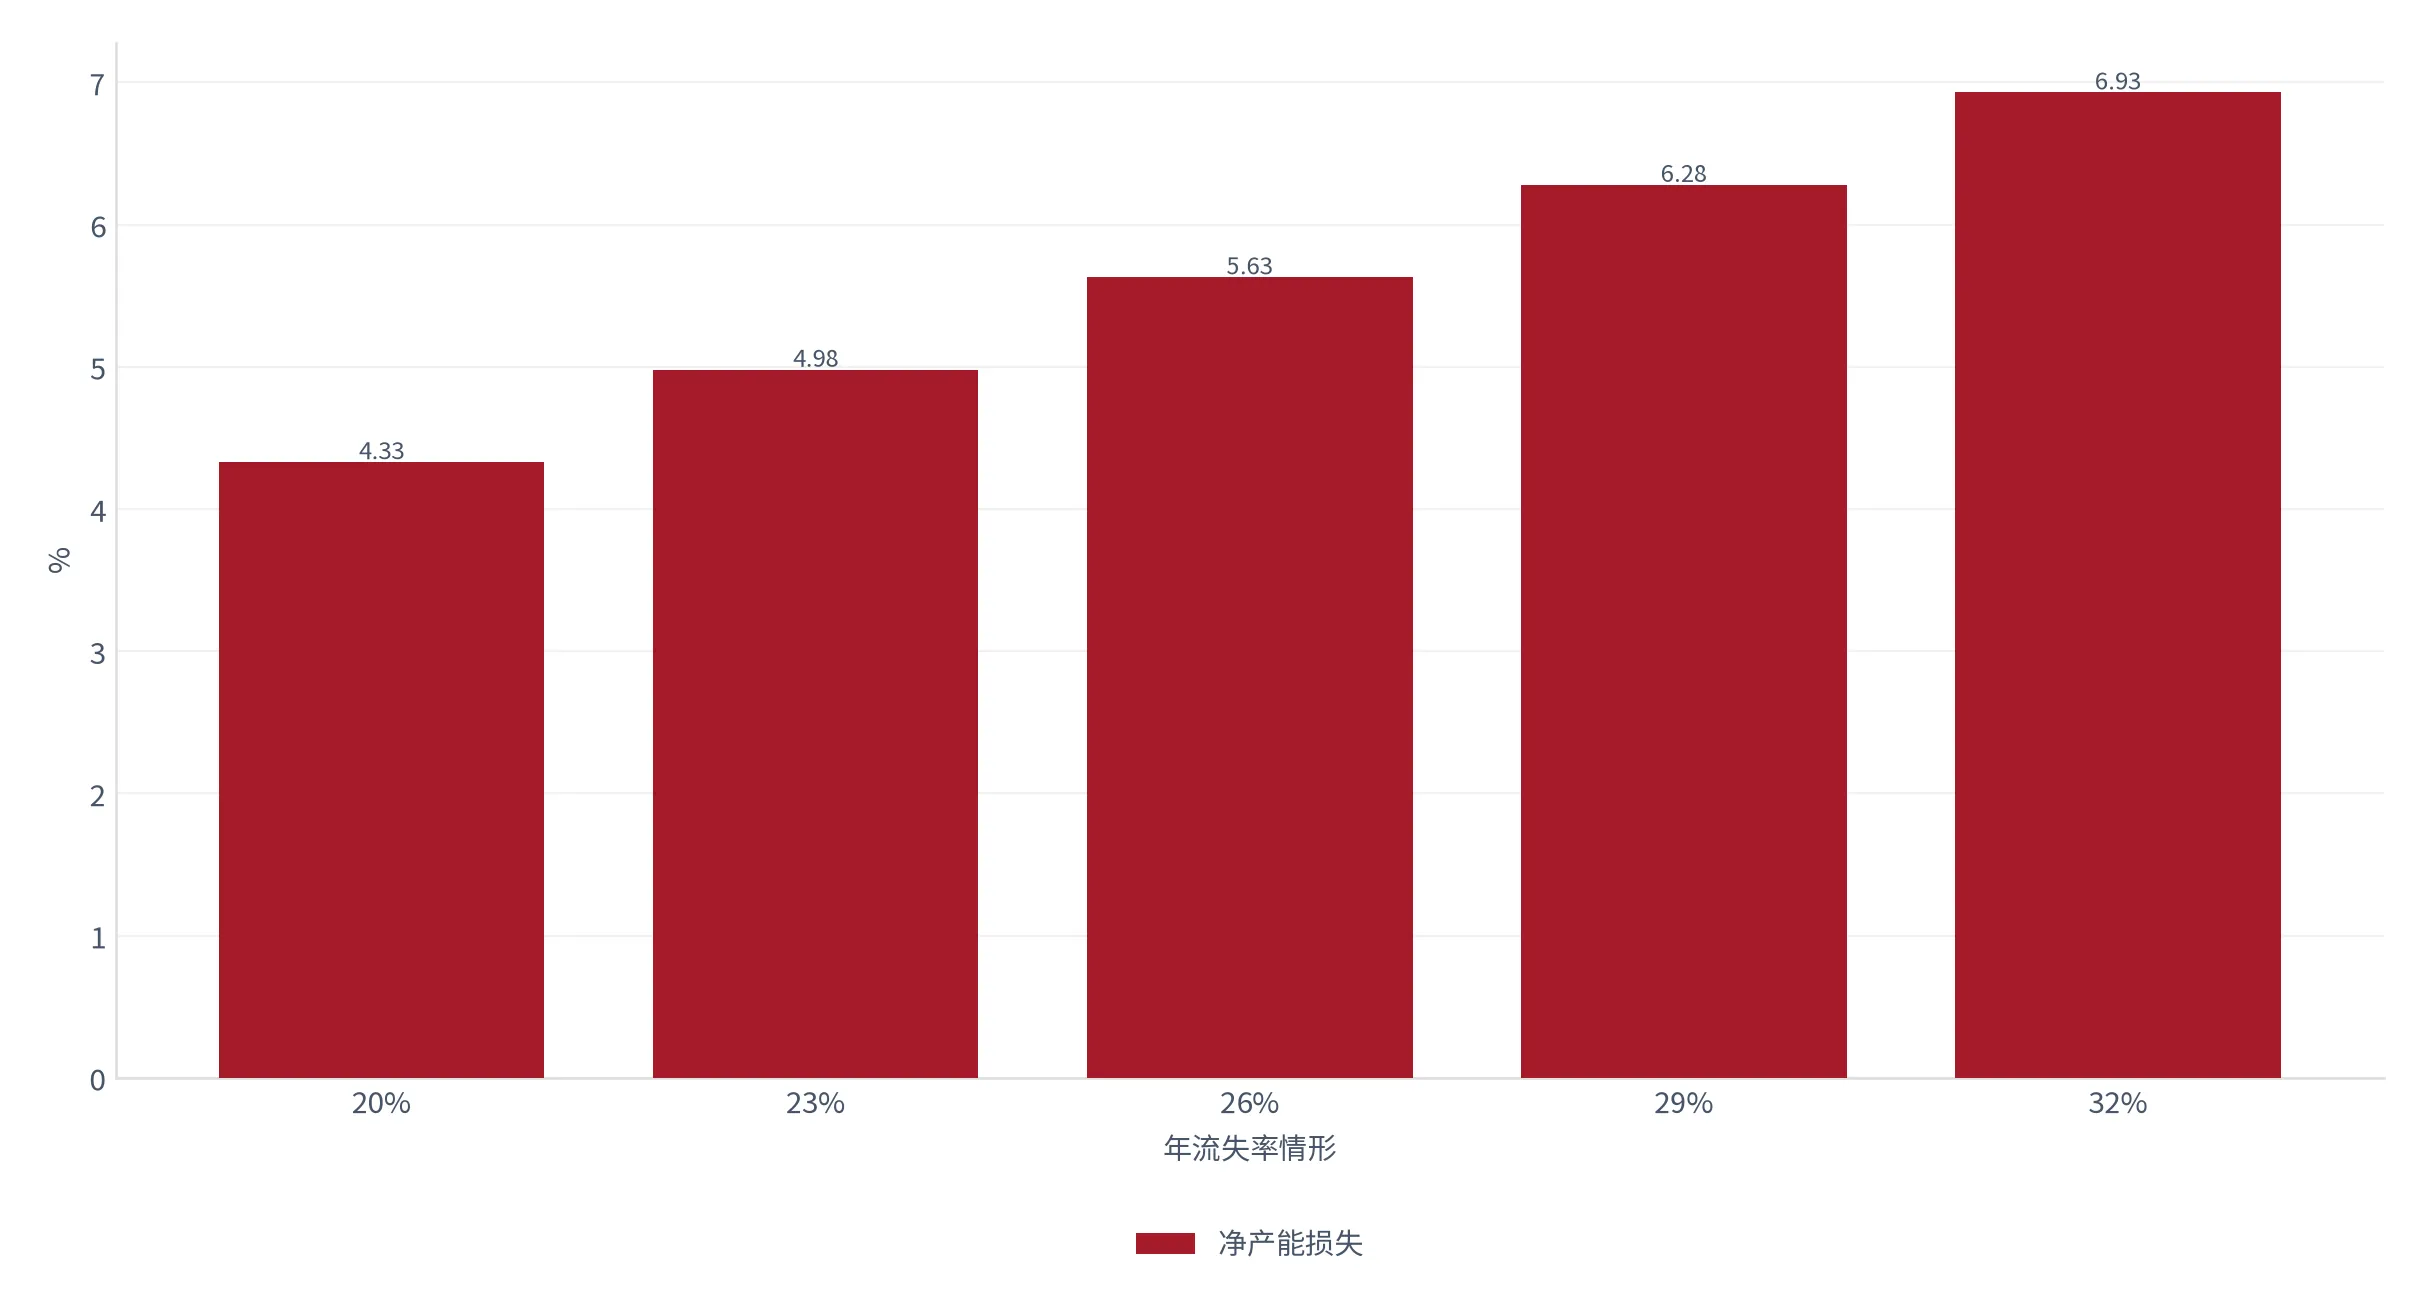
把流失率从 20% 拉到 32%,净产能损失区间 4.33% 至 6.93%,跨度 2.6 个百分点,对应金额差约 34.6 亿元 [13]。也就是说,在同样的人数与同样的单均佣金下,仅人力稳定性差异就足以让两家的经营利润率相差 10 个百分点以上。这就是本报告把在岗结构放在正文而不放附录的原因:它是产能的真实刻度,人数只是名义刻度。
04下游:用人企业的预算,边际变化先出现在账期
下游决定单量,但下游的边际变化不会第一时间出现在单量上。企业收紧招聘预算时,第一个动作往往不是取消委托,而是拉长付款周期、增加比价环节、把年度框架改成逐单审批。这三个动作对收入的影响是滞后的,对应收账款的影响是即时的。所以财报季里最灵敏的读数不是收入增速,是应收账款周转天数。
客户结构把这件事放大了一倍。年招聘预算 5,000 万元以上的 KA 客户,客户数占比 12%、收入占比 58%、佣金率 19%、账期 96 天、续约率 78%;中小客户对应 88%、42%、25%、41 天、46% [12]。两类的逻辑相反:KA 用低费率换稳定量,中小客户用高费率换即时回款。12% 的客户贡献 58% 的收入,意味着收入波动主要由少数客户的年度预算决定,而这 12% 的客户同时拥有最强议价能力——集中度与议价能力在这里是同源的,不是两个独立风险。
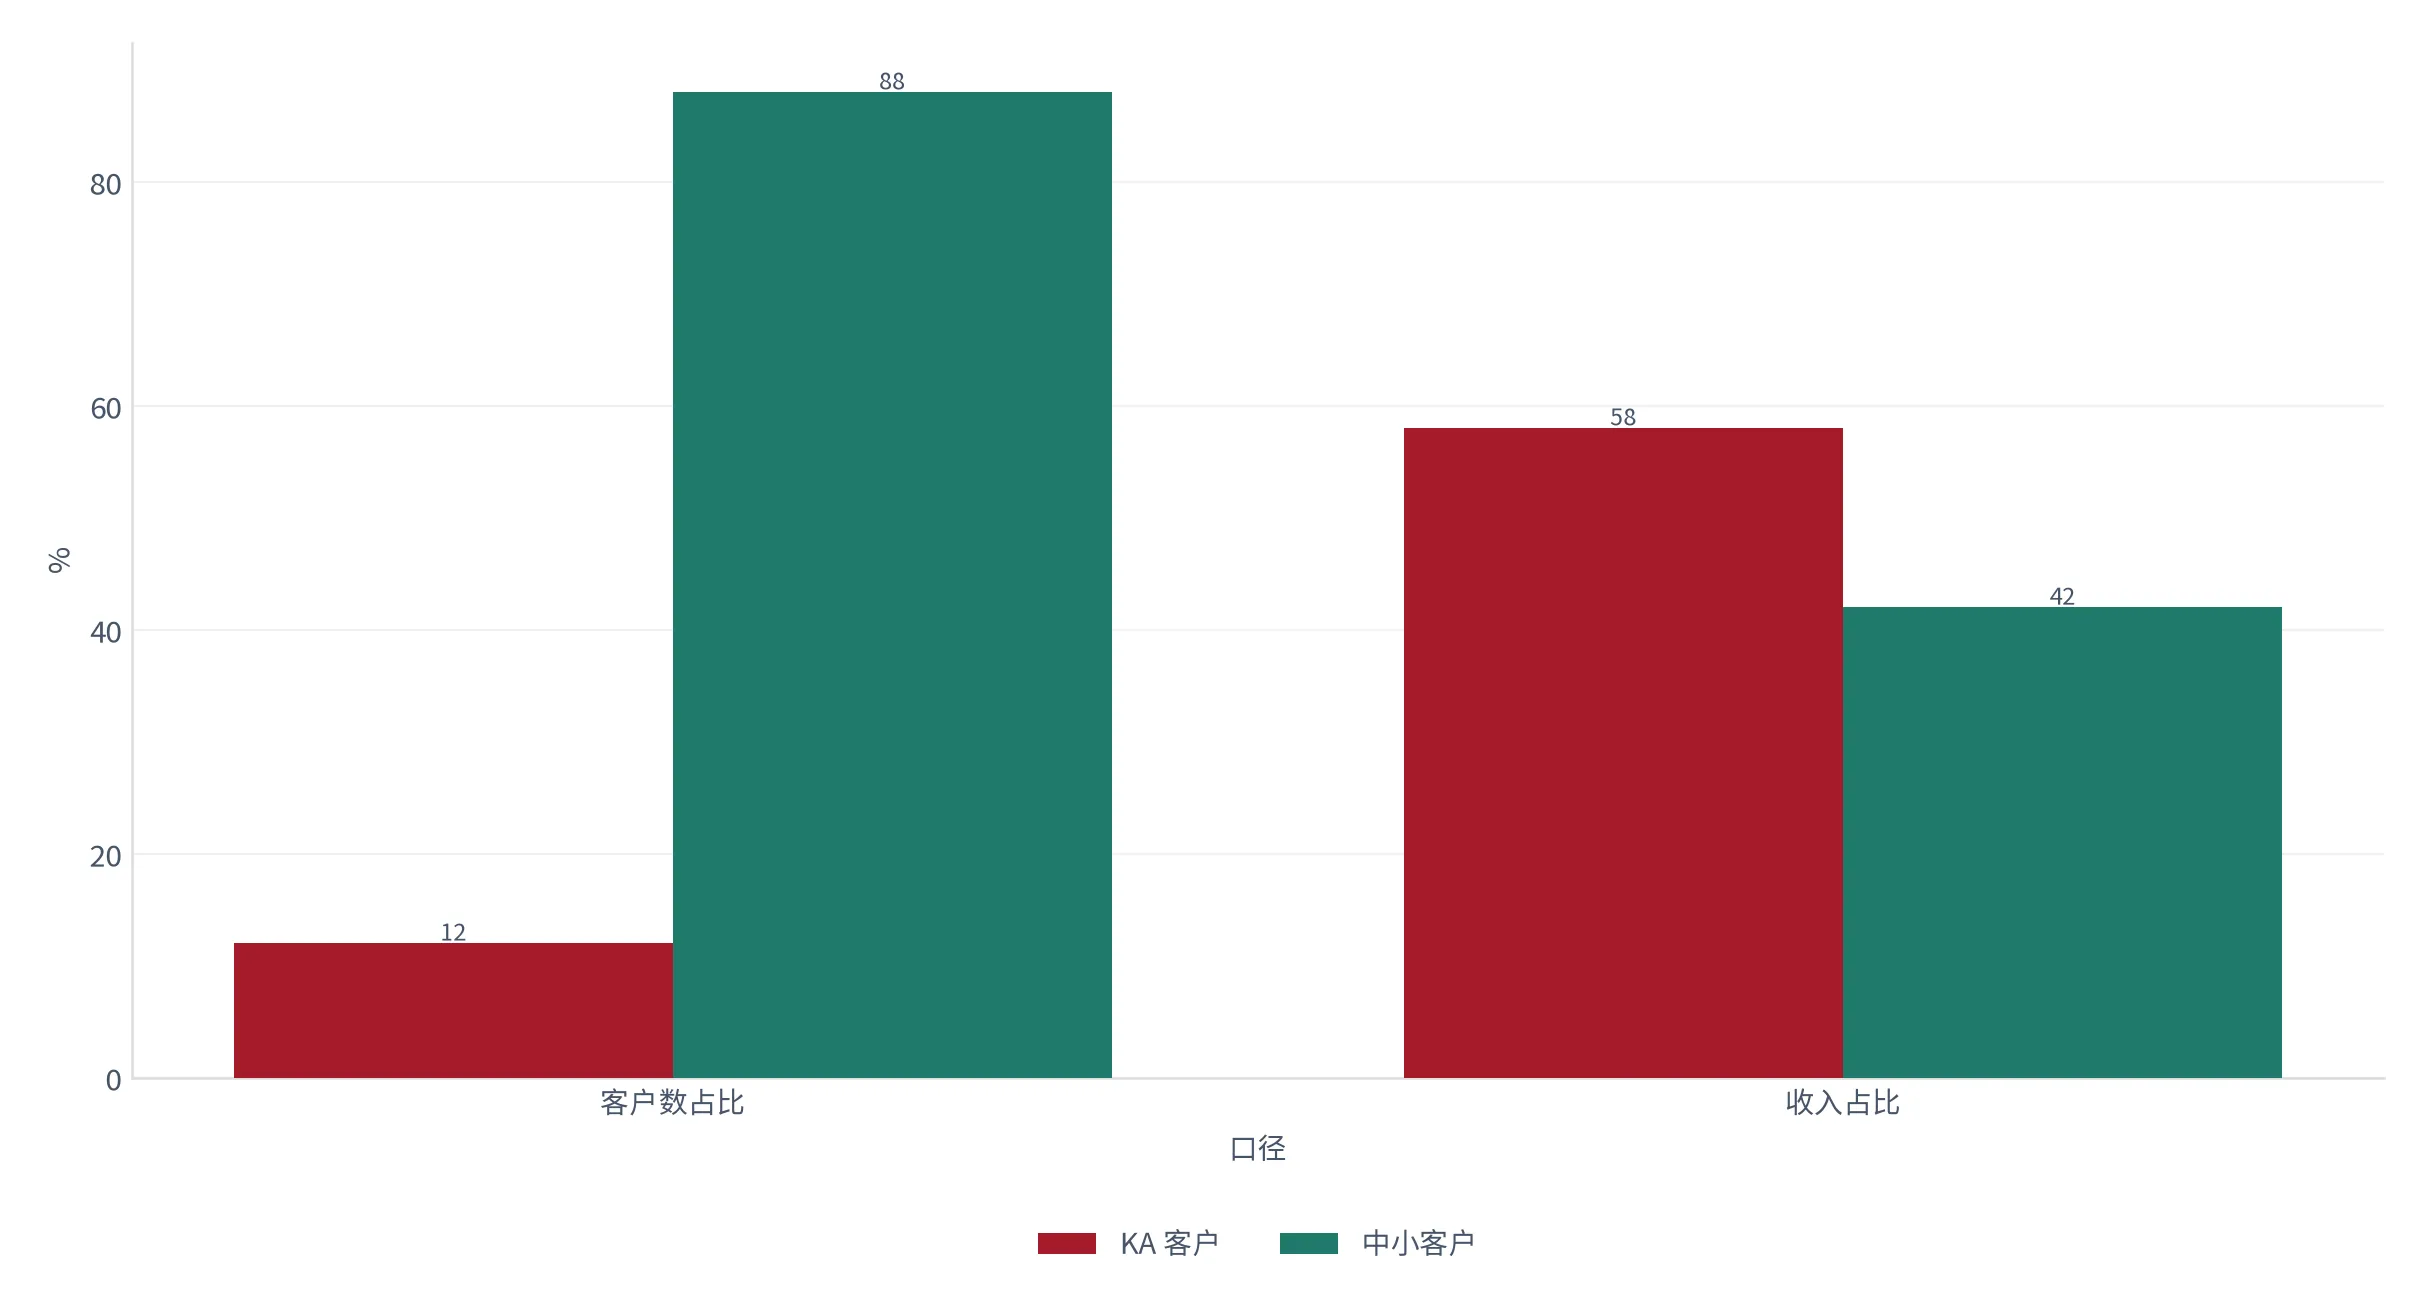
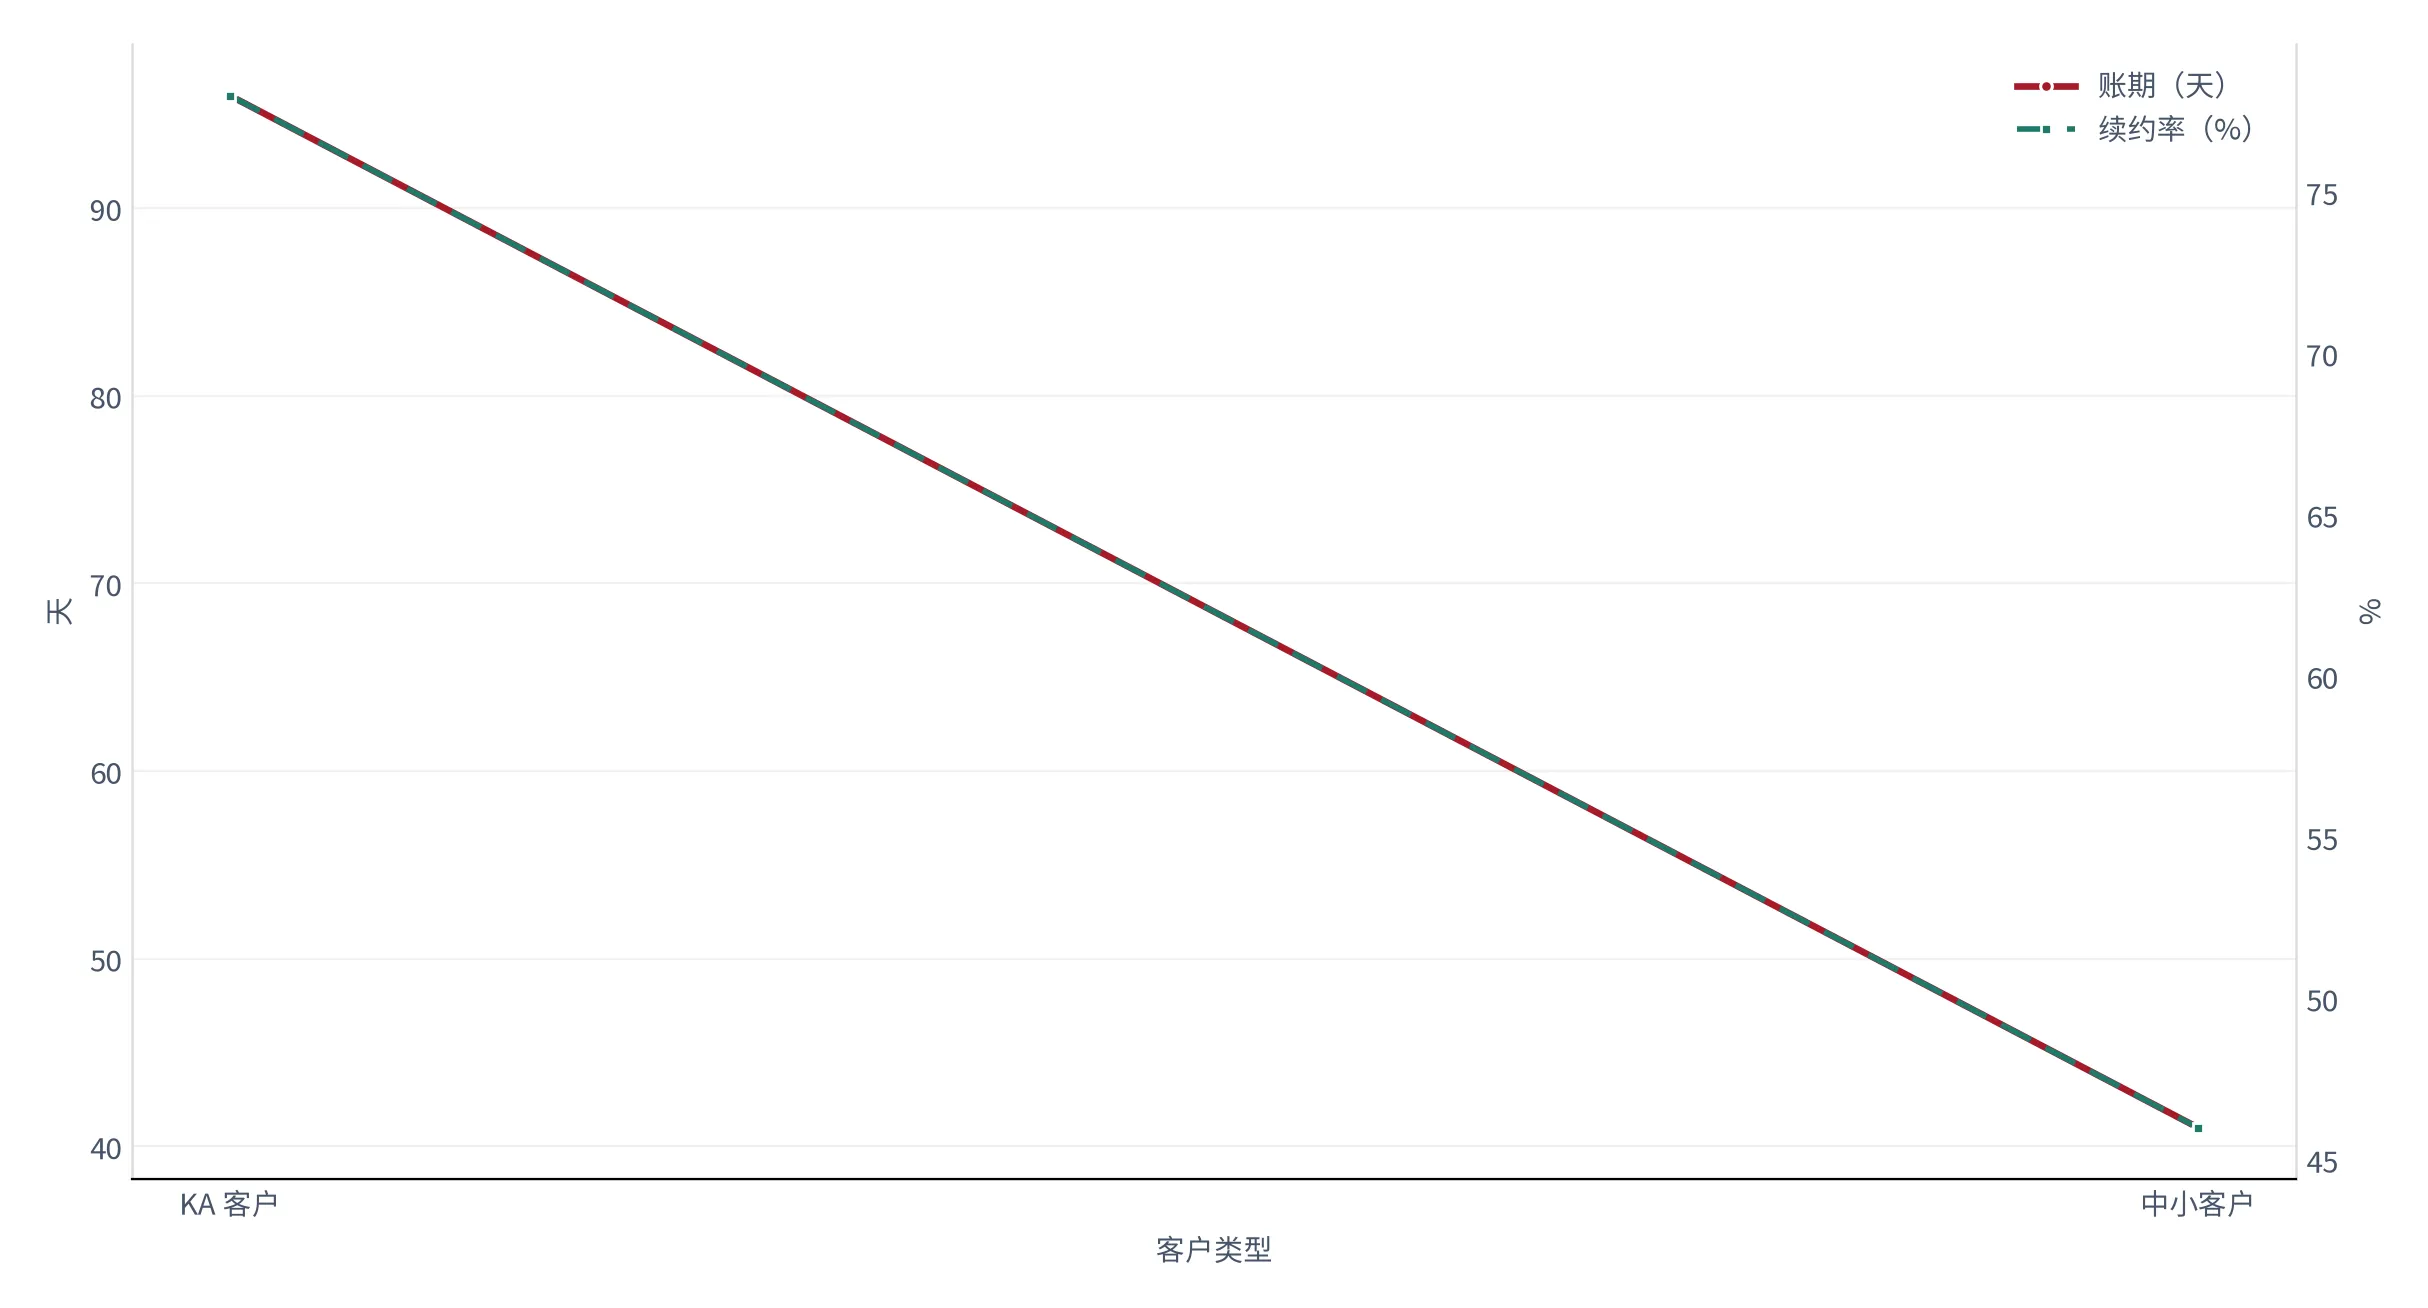
账期与续约率的对照是一个交换关系:KA 账期 96 天、比中小客户长 55 天,但续约率 78%、高 32 个百分点。多等 55 天换可预期的复购,上行期划算,下行期致命。
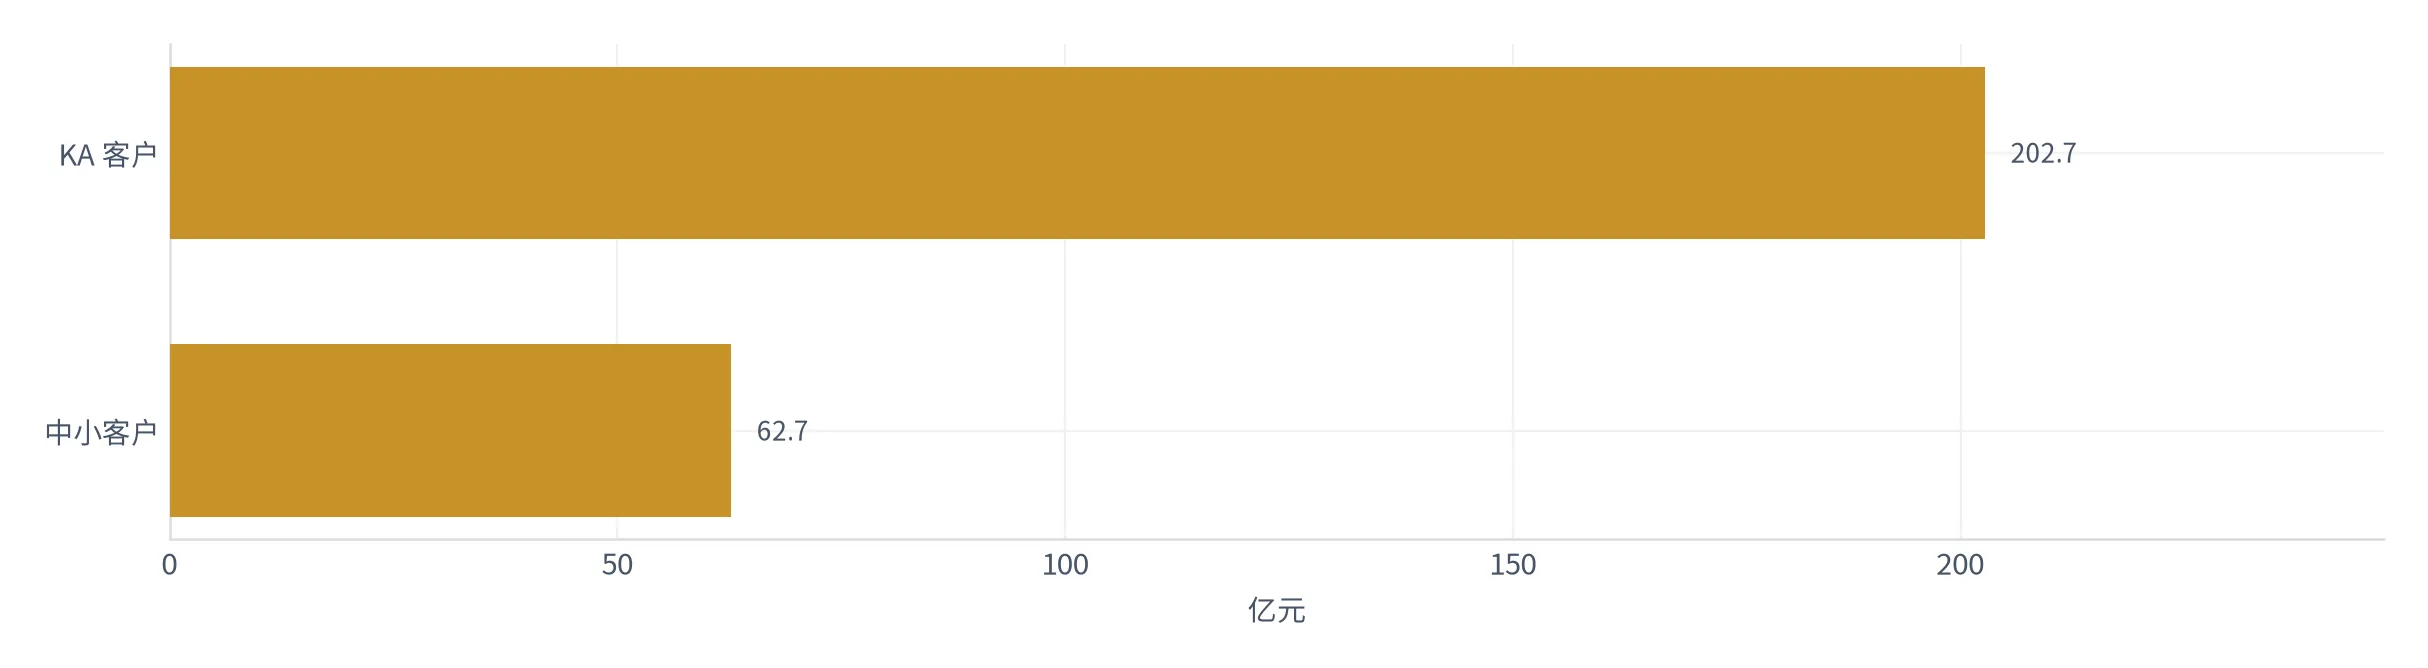
把账期折算成占款:加权账期 72.9 天,对应应收占款 265.3 亿元,其中 KA 202.7 亿元、中小 62.7 亿元 [12],相当于收入池的 20.0% 与经营利润的 80.3%——猎头表面是轻资产,实际是重应收。这一章放在瓶颈章之前,因为下游变化是瓶颈判断的输入:若只是账期拉长而单量不变,瓶颈仍在交付产能;若单量也在收缩,瓶颈会移到客户关系。两种情形的解法完全不同。
05瓶颈识别:★咽喉点在交付产能,不在数据
瓶颈的标准不是「哪一段最重要」,而是「哪一段最难扩」。难扩有两个特征:依赖需长期积累的要素(人、信任、成交记忆),且替代方案要么不存在、要么成本更高。两个特征同时具备才叫瓶颈;只有第一个是壁垒,只有第二个是痛点。这一章把五段链条放进四个筛子里过:高增长、高利润、高壁垒、供给受限。
| 候选环节 | 高增长 | 高利润 | 高壁垒 | 供给受限 | 结论 |
|---|---|---|---|---|---|
| 候选人与人才数据 | ✓ 2 | ✗ 1 | ✗ 1 | 待验证 1 | 准瓶颈但可被自建替代 |
| 顾问交付产能 | ✓ 2 | ✓ 2 | ✓ 2 | ✓ 2 | ★咽喉点 |
| 客户关系与采购预算 | ✗ 1 | ✓ 2 | ✓ 2 | ✗ 0 | 有壁垒但不限制扩张 |
| 技术栈 | ✗ 1 | ✗ 1 | ✗ 1 | ✓ 2 | 供给受限但门槛低 |
| 合规与数据安全 | ✗ 1 | ✗ 1 | ✓ 2 | 待验证 1 | 并列观察项 |
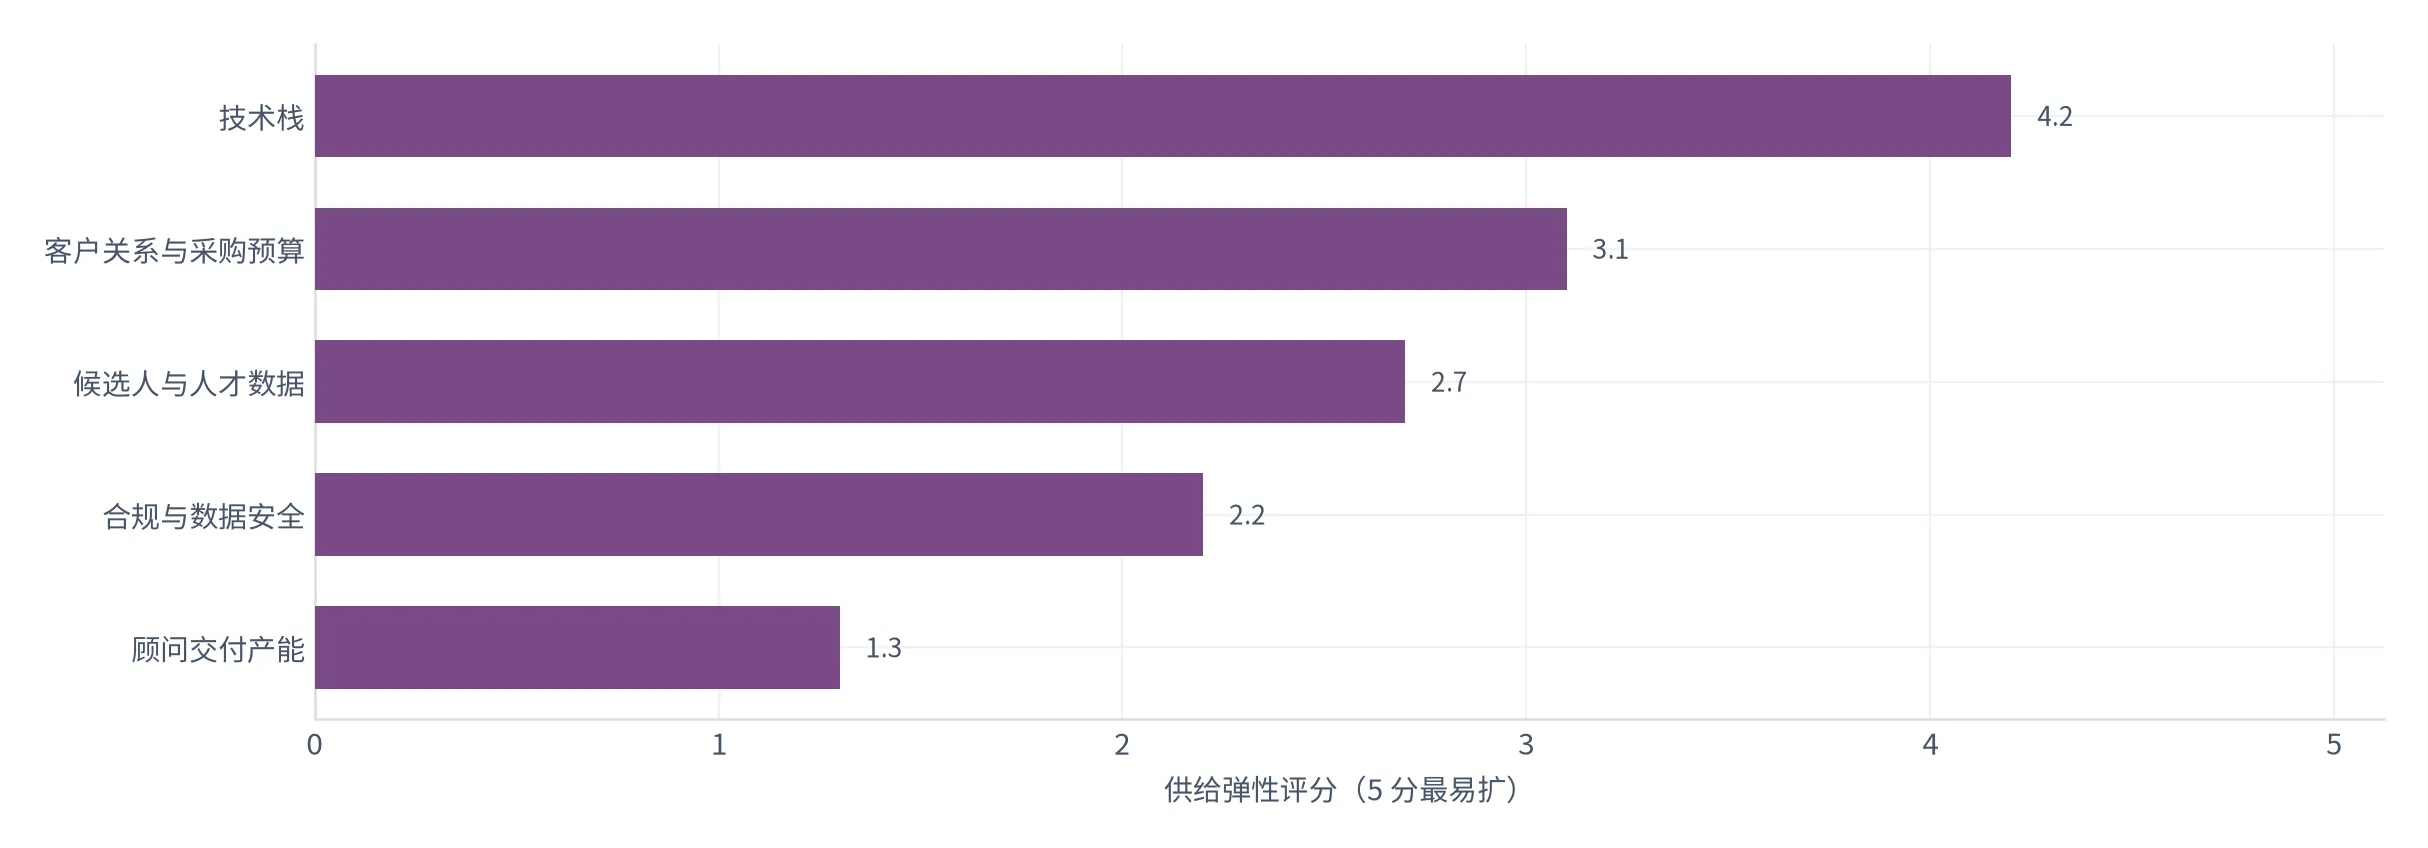
四维全给 2 分的只有顾问交付产能 [14]。这不是巧合:它同时具备需求刚性(岗位空缺必须有人补)、产能受限(顾问养成三到五年)、替代困难(判断与说服无法被流程替代)三个条件,正好是瓶颈的定义。弹性评分的排序是技术栈 4.2 分、客户关系 3.1 分、候选人与人才数据 2.7 分、合规 2.2 分、交付产能 1.3 分 [14],最低项与次低项相差 0.9 分,越过 0.8 分的分组阈值,因此可以做强排序——与本报告处理的其他行业不同,那些行业最低两项分差常不到 0.5 分,只能并列处理。分差本身就是结论强度的一部分。
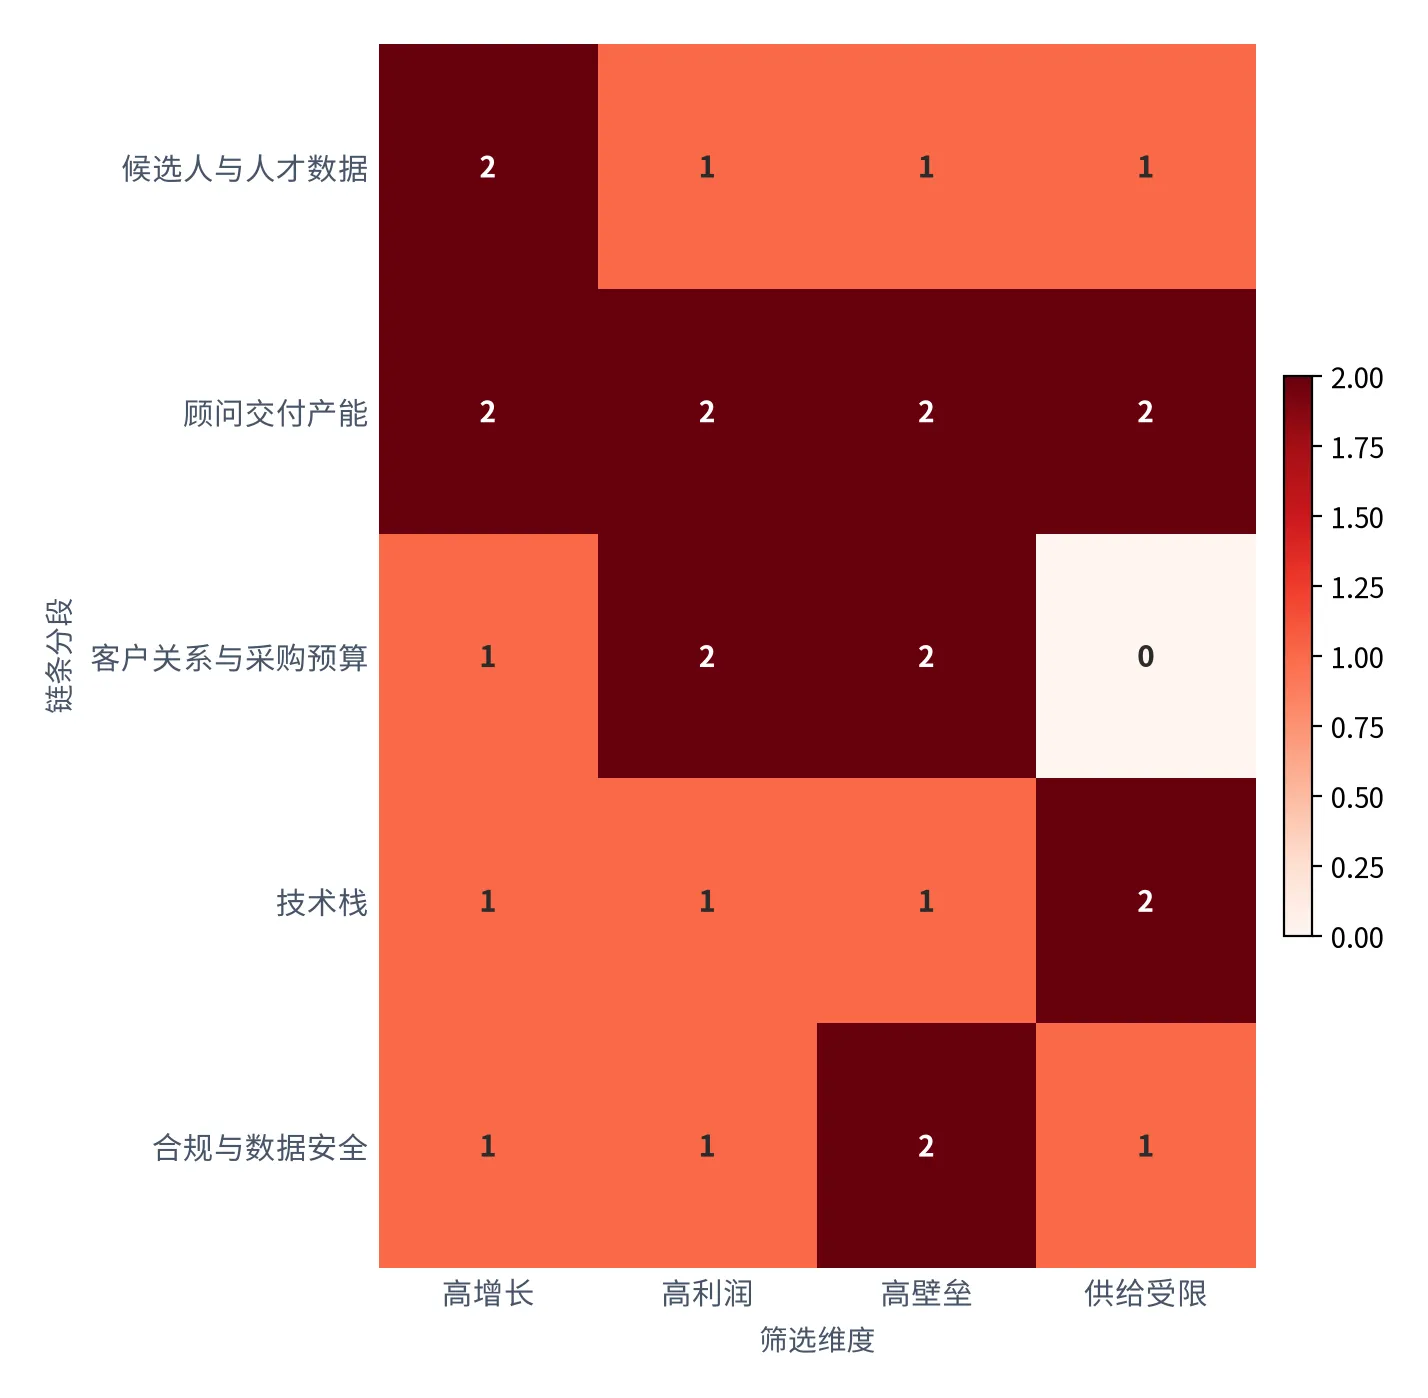
矩阵暴露的最短一块不是交付产能,是客户关系的「供给受限」0 分:行业进入门槛在客户端几乎为零。而交付产能的「供给受限」是 2 分。两者相加得到核心判断:这是一个进入容易、做大很难的行业。
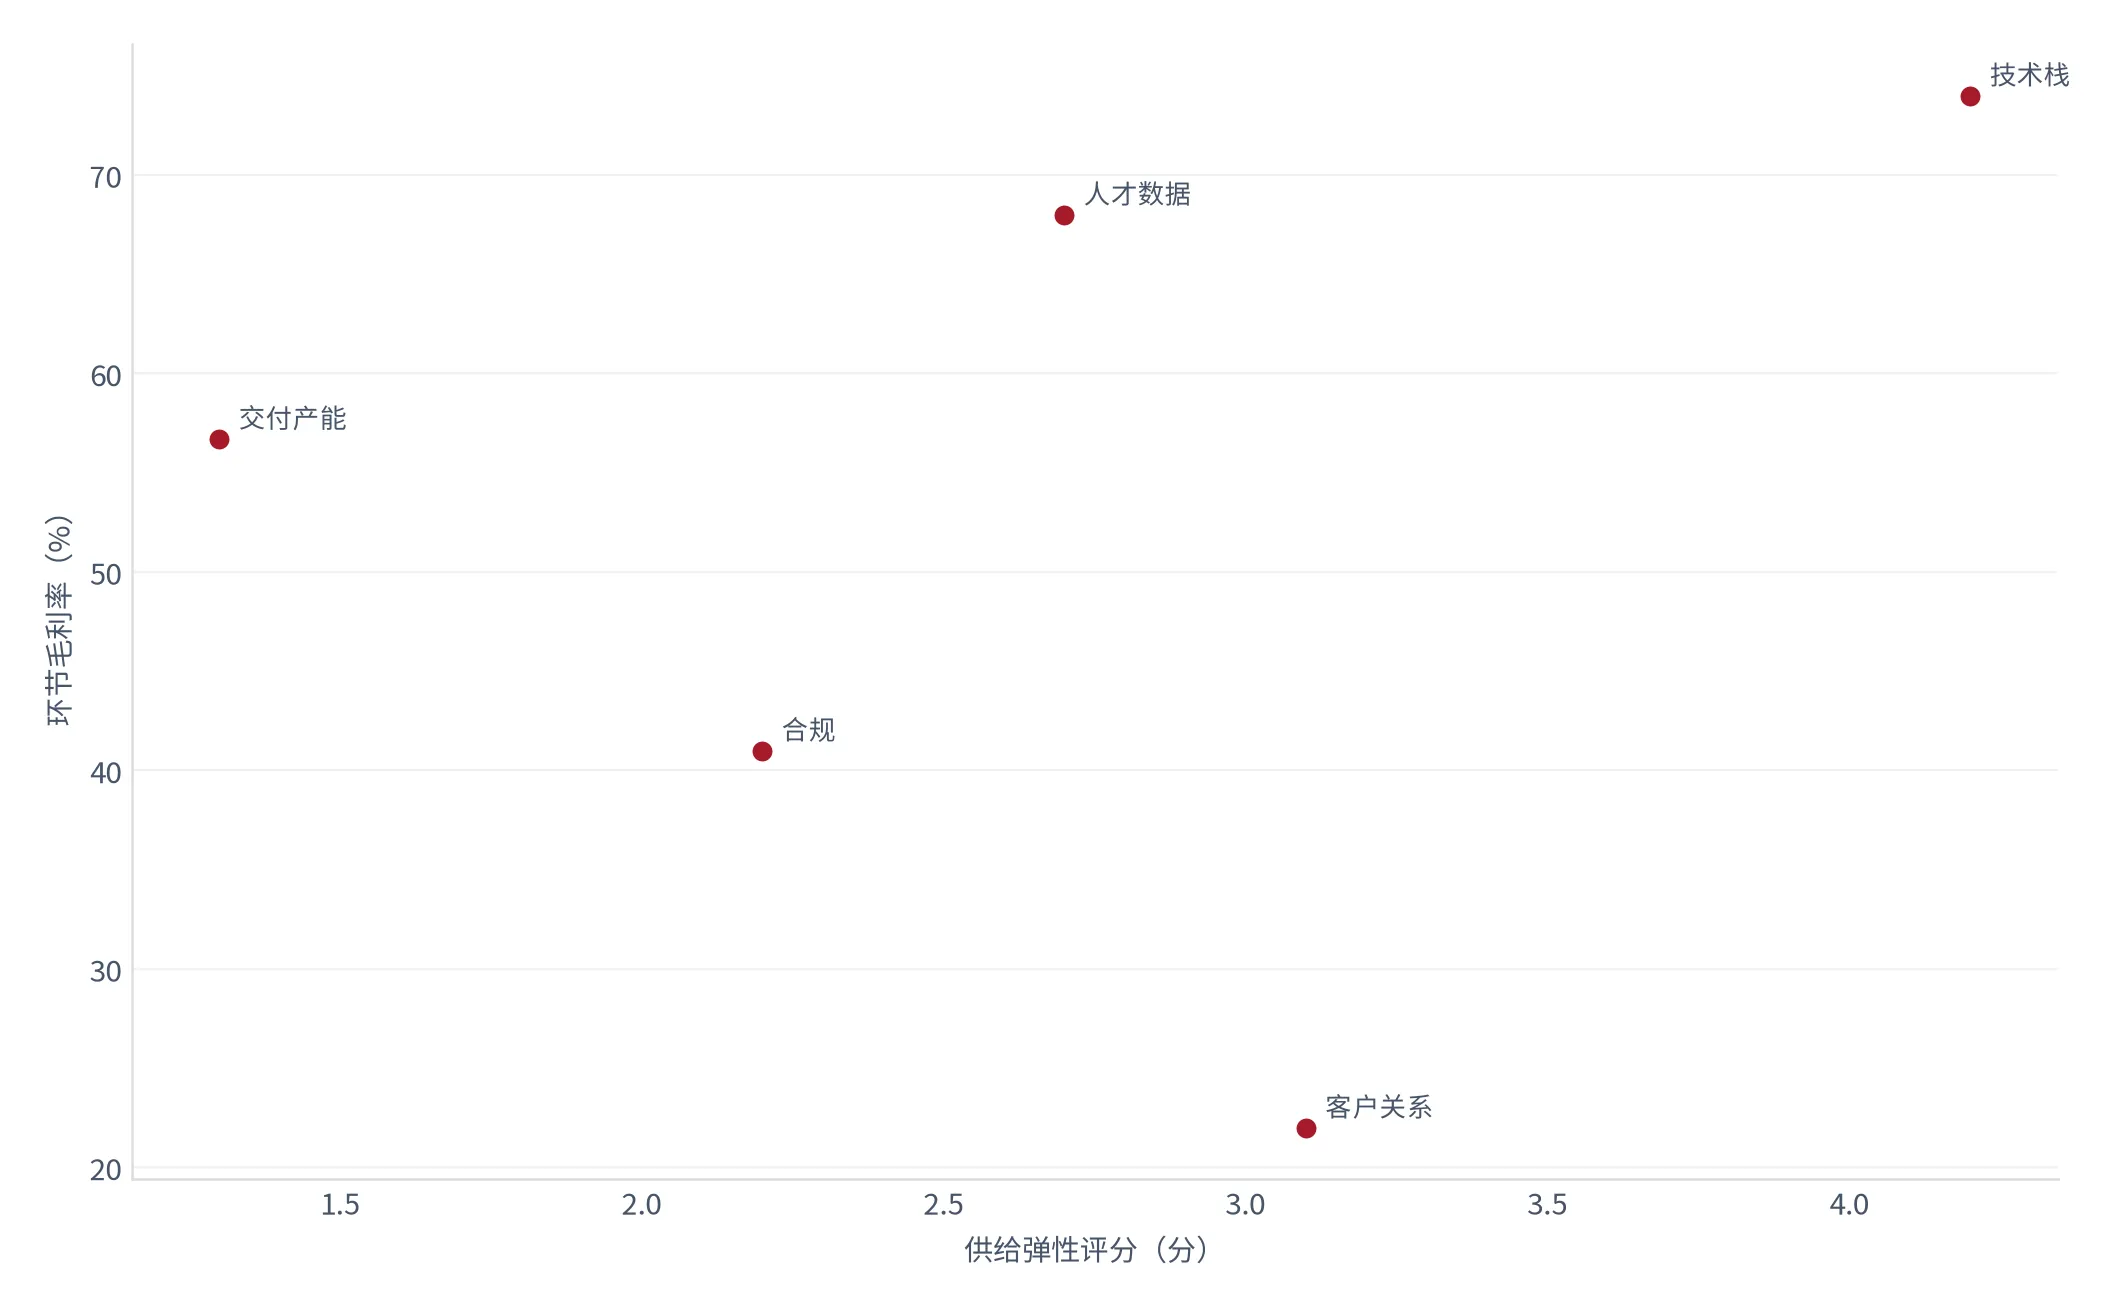
把毛利率与弹性放在一张图上,四个点沿一条向下倾斜的线排列:技术栈 74% 对 4.2 分、候选人数据 68% 对 2.7 分、交付产能 56.7% 对 1.3 分、合规 41% 对 2.2 分 [14]。前三个点连成清晰的负斜率——越难扩的环节毛利越低,与「瓶颈应有高毛利」的直觉相反。原因是定价权在客户手里:难扩的环节承担成本,容易扩的环节拿走溢价。这条规律有条件:它成立的前提是价格由客户定、产能由供给侧定;若行业进入卖方市场,斜率会翻正。所以★咽喉点是成本意义上的瓶颈,不是定价意义上的瓶颈——前者压毛利,后者提毛利,报表表现完全不同。
06供需与竞争格局:量在涨,价在跌
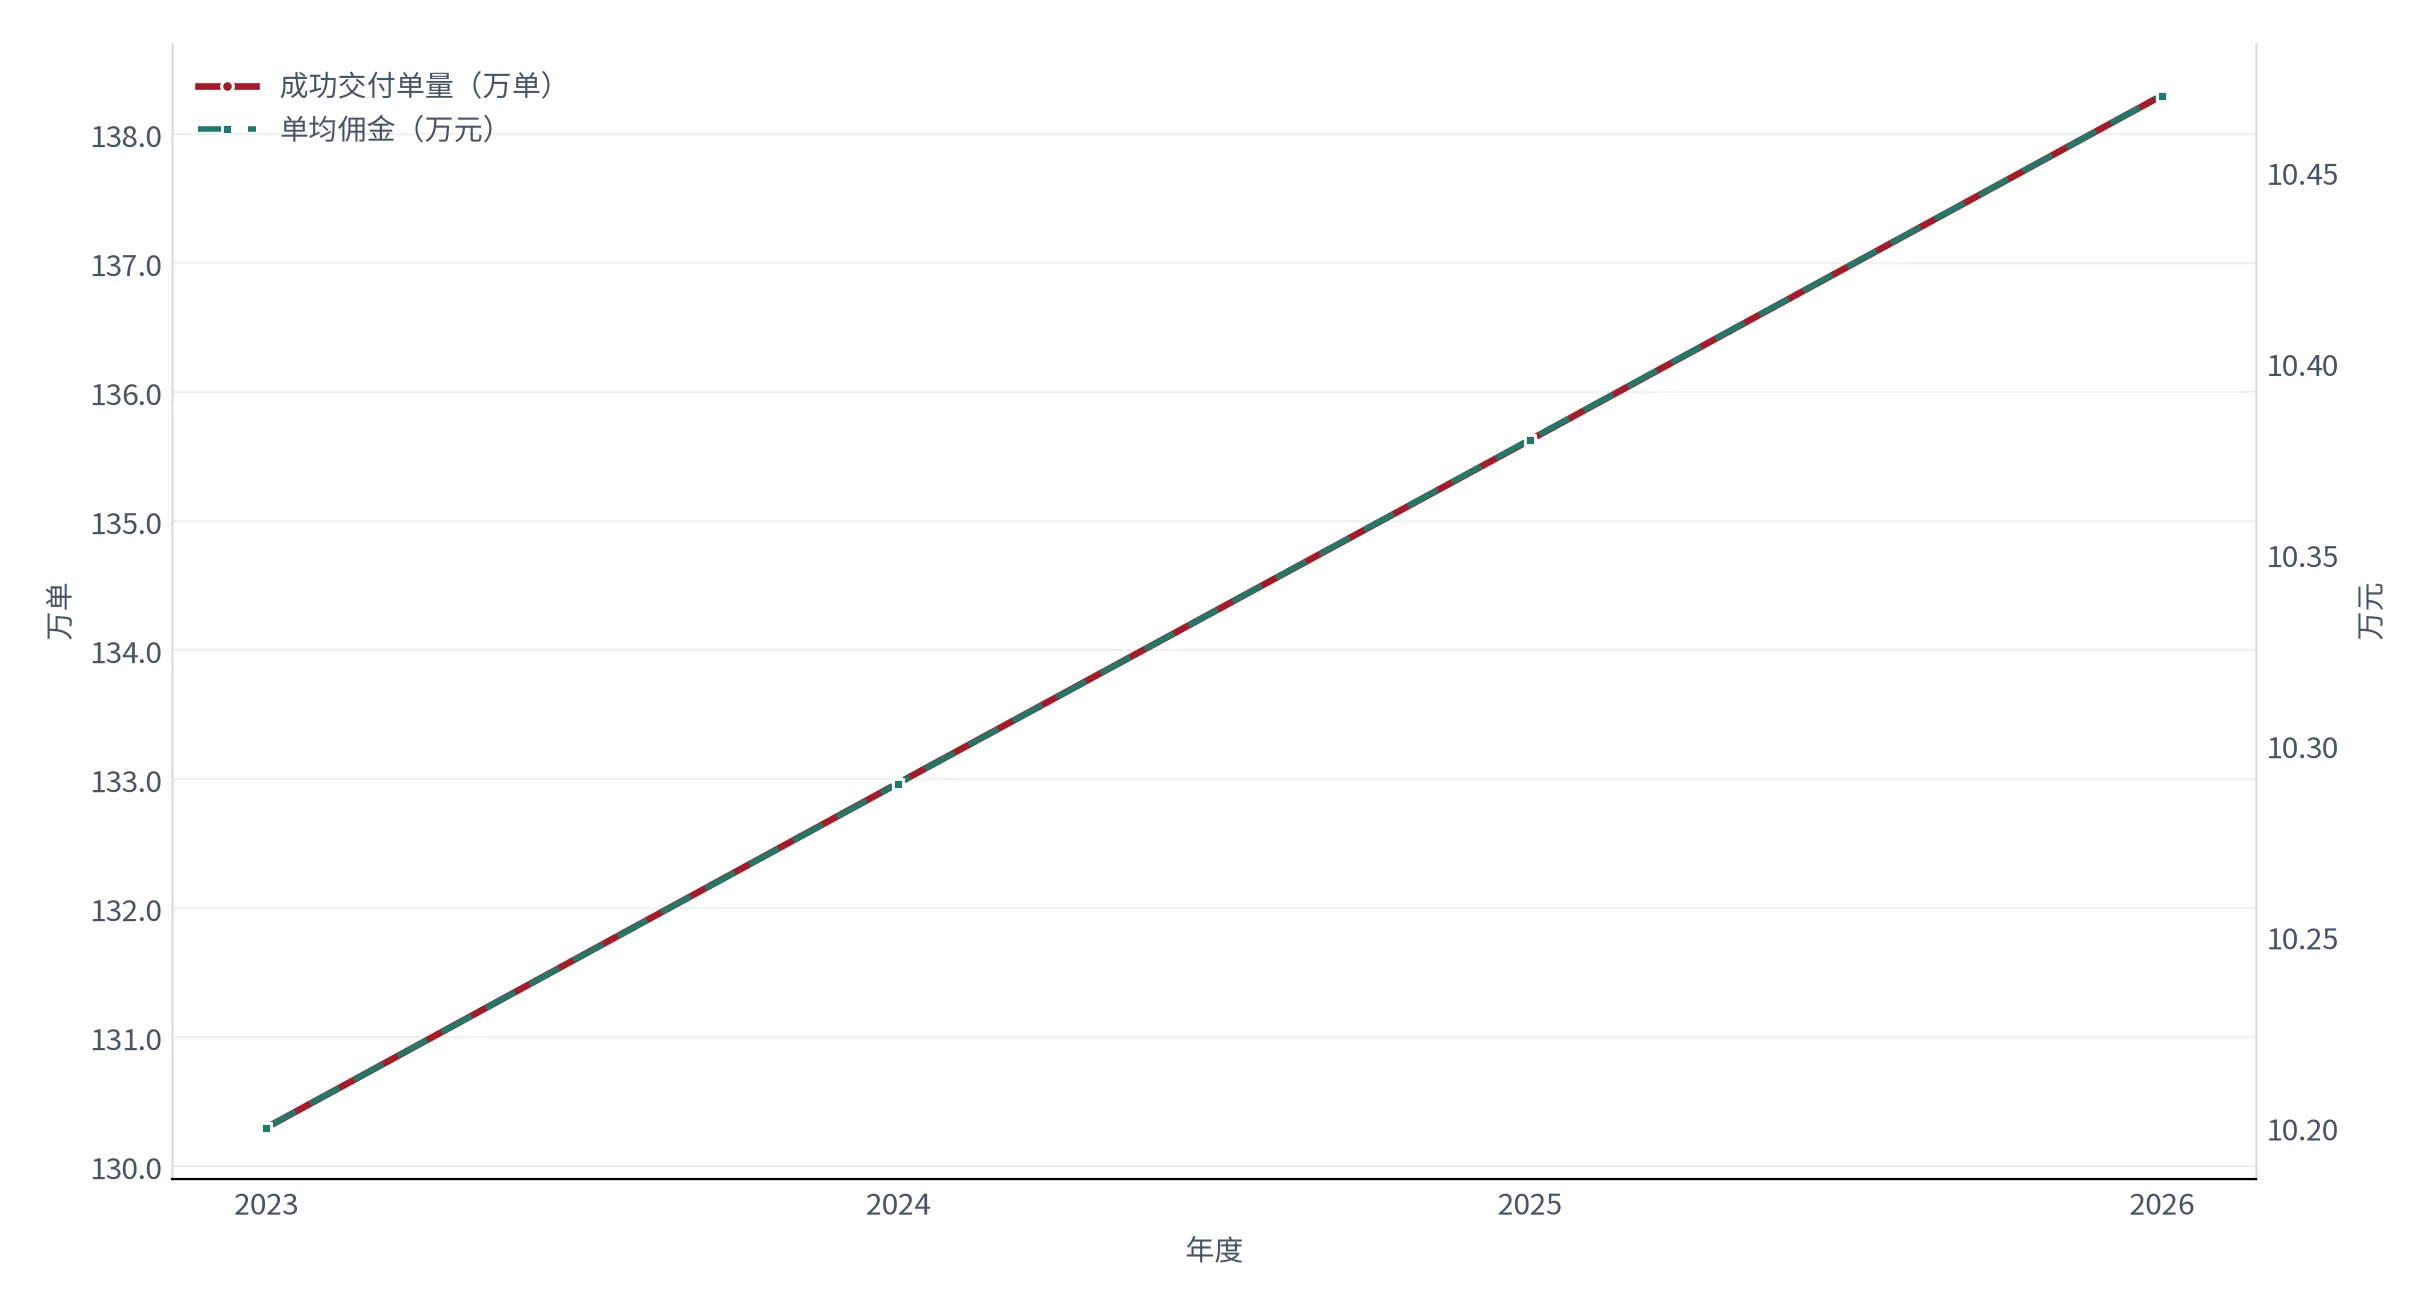
需求为什么不快:单量从 2023 年 130.3 万单走到 2026 年 138.3 万单,三年累计 6.1%;单均佣金从 10.2 万元走到 10.47 万元,累计 2.6% [9],两者相乘才有 8.9% 的收入增长。所谓复苏在数据上是量的温和修复,不是价的重估。2024 与 2025 按两端点线性插值,这一点必须交代,因为插值会平滑掉真实波动。供给难扩有三个约束:顾问养成周期、成交记忆的地域与行业属性、客户名单准入周期。只有第三个能用销售投入加速,所以这个行业的集中度始终不高——不是需求分散,是供给无法被资本快速复制。
替代风险有两处:员工内推与人才库直招会把中低端岗位收回企业自建团队;平台型撮合用标准化流程处理年薪 30 万元以下的岗位。两处都在低单均佣金区,而那正是单量最大的地方——24 万元档占单量的 50% [9]。所以替代不会削弱高端寻访,但会削掉收入池的底部。
| 参与者类型 | 相对份额 | 客户结构 | 佣金率 | 经营利润率 | 优势来源 | 主要风险 |
|---|---|---|---|---|---|---|
| KA 制头部服务商 | 收入占比约 58% [12] | 大型企业年度框架 | 19% | 高于链条均值 | 名单准入与交付稳定性 | 客户集中与账期 |
| 区域按职位交付商 | 收入占比约 42% [12] | 中小企业逐单比价 | 25% | 低于链条均值 | 响应速度与本地关系 | 费率下行与回款 |
| 数据与测评供应商 | 交付服务的十分之一量级 [14] | 中游服务商 | 订阅制 | 高(毛利 68%) | 更新频率与成交记忆 | 中游自建替代 |
| 平台型撮合方 | 缺口 | 低年薪岗位 | 低于 15% | 缺口 | 标准化与规模 | 低区被直招替代 |
这张表刻意留了三处空白:平台型撮合方的份额与利润率标为缺口,因为公开渠道没有可核验的分部数据。留白是纪律而不是偷懒——把没有的数字写成有,比不写更糟。表的用法因此被限定:它只能判断「不同参与者卡在哪一环」,不能比较谁更赚钱,后一个问题需要报表数据,而报表口径与产业口径不可混用。
07公司映射与证据复筛:六类参与者各自卡在哪一环
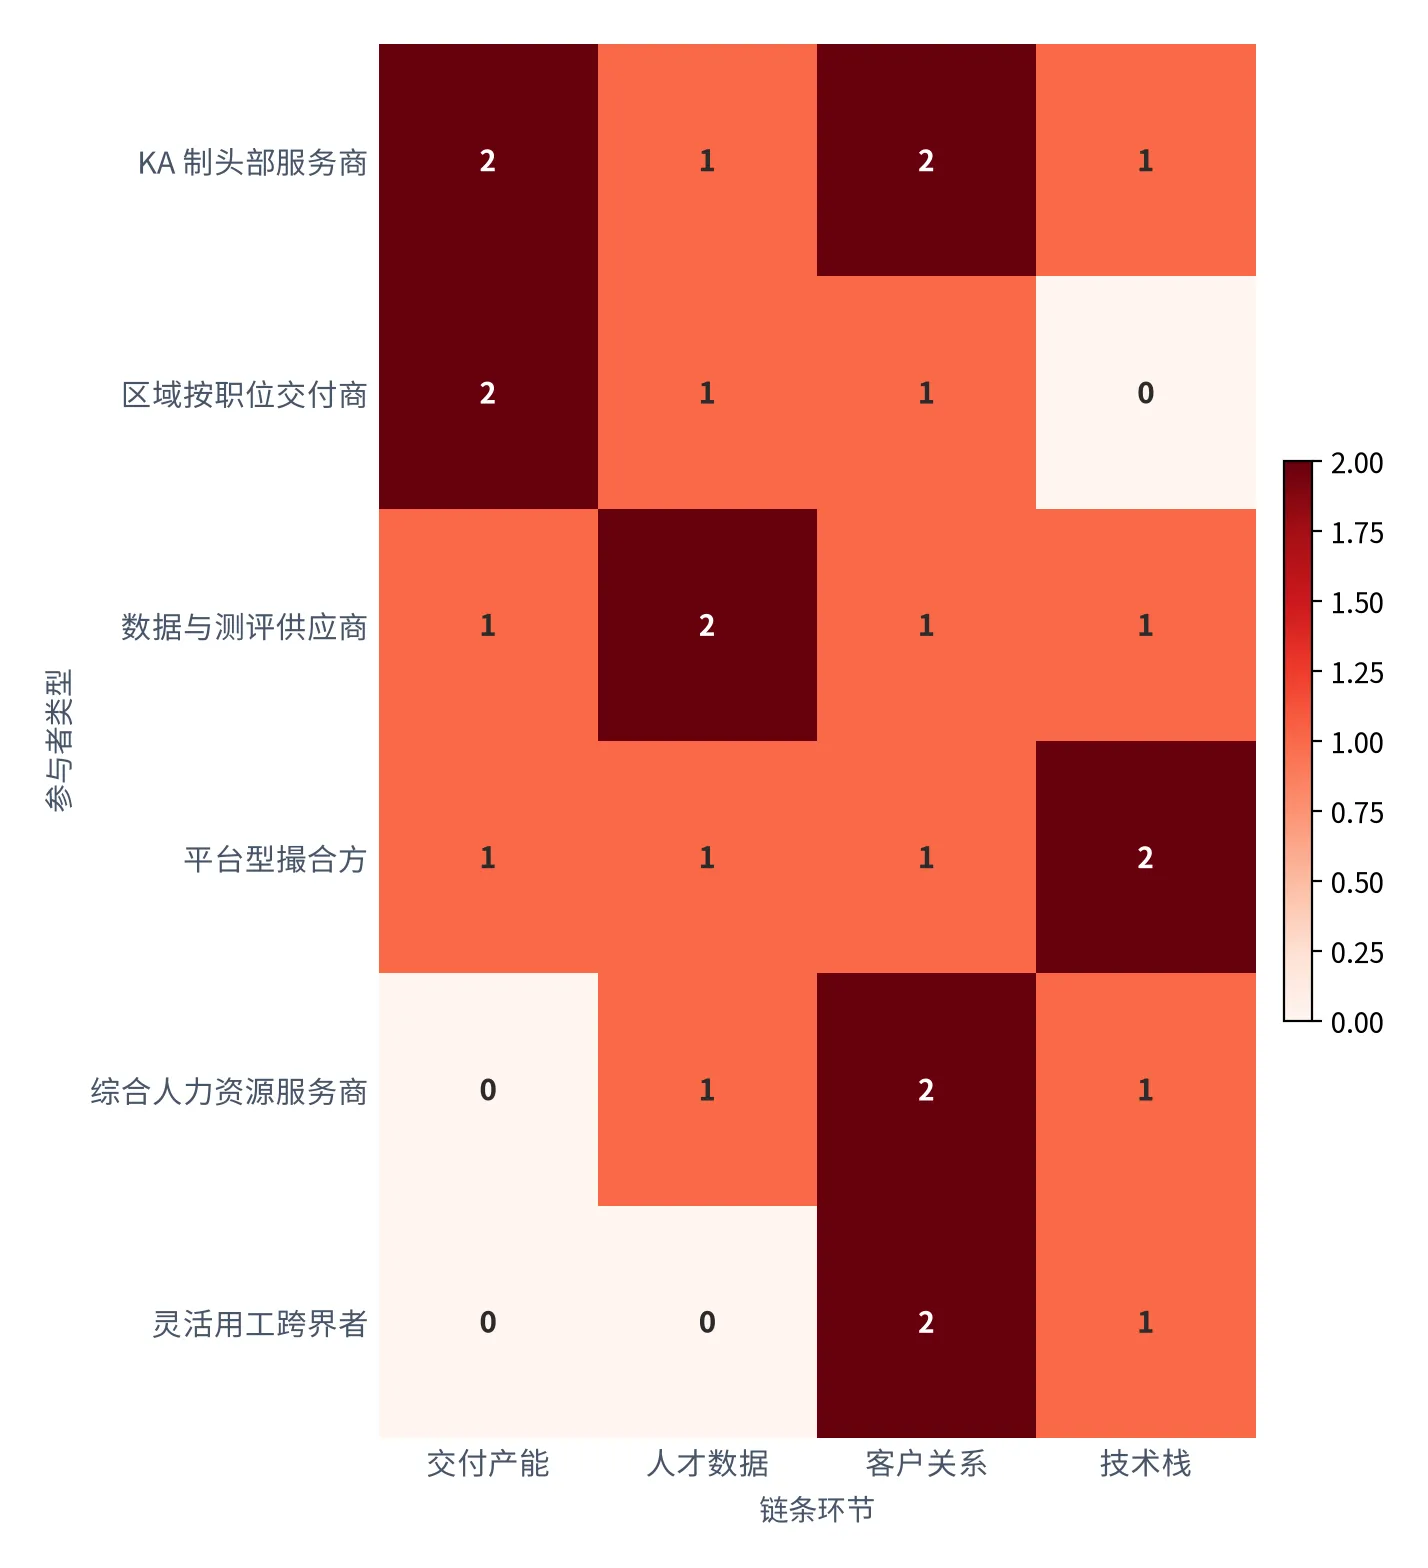
公司映射不是列名单,是把每类参与者放回链条,然后回答六个问题:对应哪一环、业务纯度多高、公开证据说了什么、属于哪一档、不能证明什么、初步归类是什么。第六个问题最难也最常被跳过——只写能证明什么,读者会以为证据比实际更宽。
| 参与者类型 | 对应环节 | 业务纯度 | 公开证据内容 | 证据等级 | 现有证据不能证明什么 | 初步归类 |
|---|---|---|---|---|---|---|
| KA 制头部服务商 | 客户关系+交付产能 | 中(含驻场与灵活用工) | 年度框架客户与交付稳定性 | [T3] | 单顾问产能与分部毛利率 | 瓶颈内、毛利受客户压制 |
| 区域按职位交付商 | 交付产能 | 高 | 本地客户与响应速度 | [T3] | 跨区域复制能力 | 瓶颈内、规模受限 |
| 数据与测评供应商 | 人才数据+合规 | 高 | 订阅制与更新频率 | [T3] | 被自建替代的速度 | 瓶颈外、受益于交付需求 |
| 平台型撮合方 | 技术栈 | 高 | 标准化流程与低费率 | [T3] | 低区留存与履约质量 | 瓶颈外、替代风险最高 |
| 综合人力资源服务商 | 客户关系 | 低(多业务并行) | 供应商名单与驻场规模 | [T3] | 猎头业务的分部盈利 | 瓶颈外、靠规模不靠弹性 |
| 灵活用工跨界者 | 客户关系+合规 | 低 | 用工合规与结算能力 | [T3] | 与寻访业务的协同程度 | 观察线索、非本链条瓶颈 |
六类里只有前两类真正落在咽喉点上。这不是说其他四类没价值,而是价值来源不同:数据与测评供应商受益于交付需求增长,但它自己不是瓶颈;平台型撮合方用技术栈替代交付产能,方向正确却恰好撞在低区被直招替代的那一块;综合服务商与灵活用工跨界者靠客户关系与合规吃饭,与产能弹性无关。把六类混在一起比「谁更好」,是把不同的生意放在同一把尺子上量。还要交代证据边界:六类的公开证据全部是业务描述级,没有任何一条分部财务数据,所以映射只能做到环节定位,做不到个体评价。要让个体评价成立,需要顾问人数与在岗结构、分摊到猎头业务的分部毛利率、KA 客户续约率三样,三样都在缺口里。
08当期位置:财报季该盯的三个读数
财报季只盯三个读数,按权重从高到低是委托单量、单均佣金、顾问在岗系数。三者分别对应收入池的三个乘数,也分别对应三种解释:单量下滑是需求问题,佣金下滑是议价问题,在岗系数下滑是组织问题。三种问题的应对完全相反,所以必须先分清是哪一种,再谈严不严重。排序有算术依据:流动率每上行 1 个百分点增 88.8 亿元,佣金率每上行 1 个百分点增 67.6 亿元,平均年薪每上行 1% 只增 14.5 亿元 [15],相差 1.31 倍与 6.1 倍。流动率最敏感,是因为分母小(16.3%),同样 1 个百分点的相对变化更大——这是分母效应,不是需求强弱的证据。
三个读数的可得性差别很大,必须交代:单量在部分服务商的分部披露里能看到,多数只披露收入;单均佣金要靠收入除以单量倒算,前提是口径一致;在岗系数几乎无法从公开渠道取得,只能用顾问人数与人均回款做代理。所以「盯三个读数」在实务上会退化成「盯一个半」。还有一个时序问题:预算收紧时先动的是账期(前文测算的 72.9 天)[12],再是单量,最后才是佣金率被迫下调。读数的观察顺序是账期、单量、佣金率、在岗系数,而权重顺序是流动率、佣金率、平均年薪。顺序与权重不一致并不矛盾:前者是信息到达的先后,后者是影响的大小,混为一谈会在账期刚动时就宣布需求崩塌。
09外部读数校验:宏观变量只给假设划边界
这一章刻意放在分析之后。宏观数据的正确用法是校验假设,不是开篇定调——开篇摆一堆价格与就业数字,会让读者以为经济环境决定了结论,实际上它们只做一件事:给三个外生参数(年薪水平、费率、就业基数)设定一个不自相矛盾的取值。下面的五个读数没有一个直接讲猎头,但每一个都在给参数划边界。
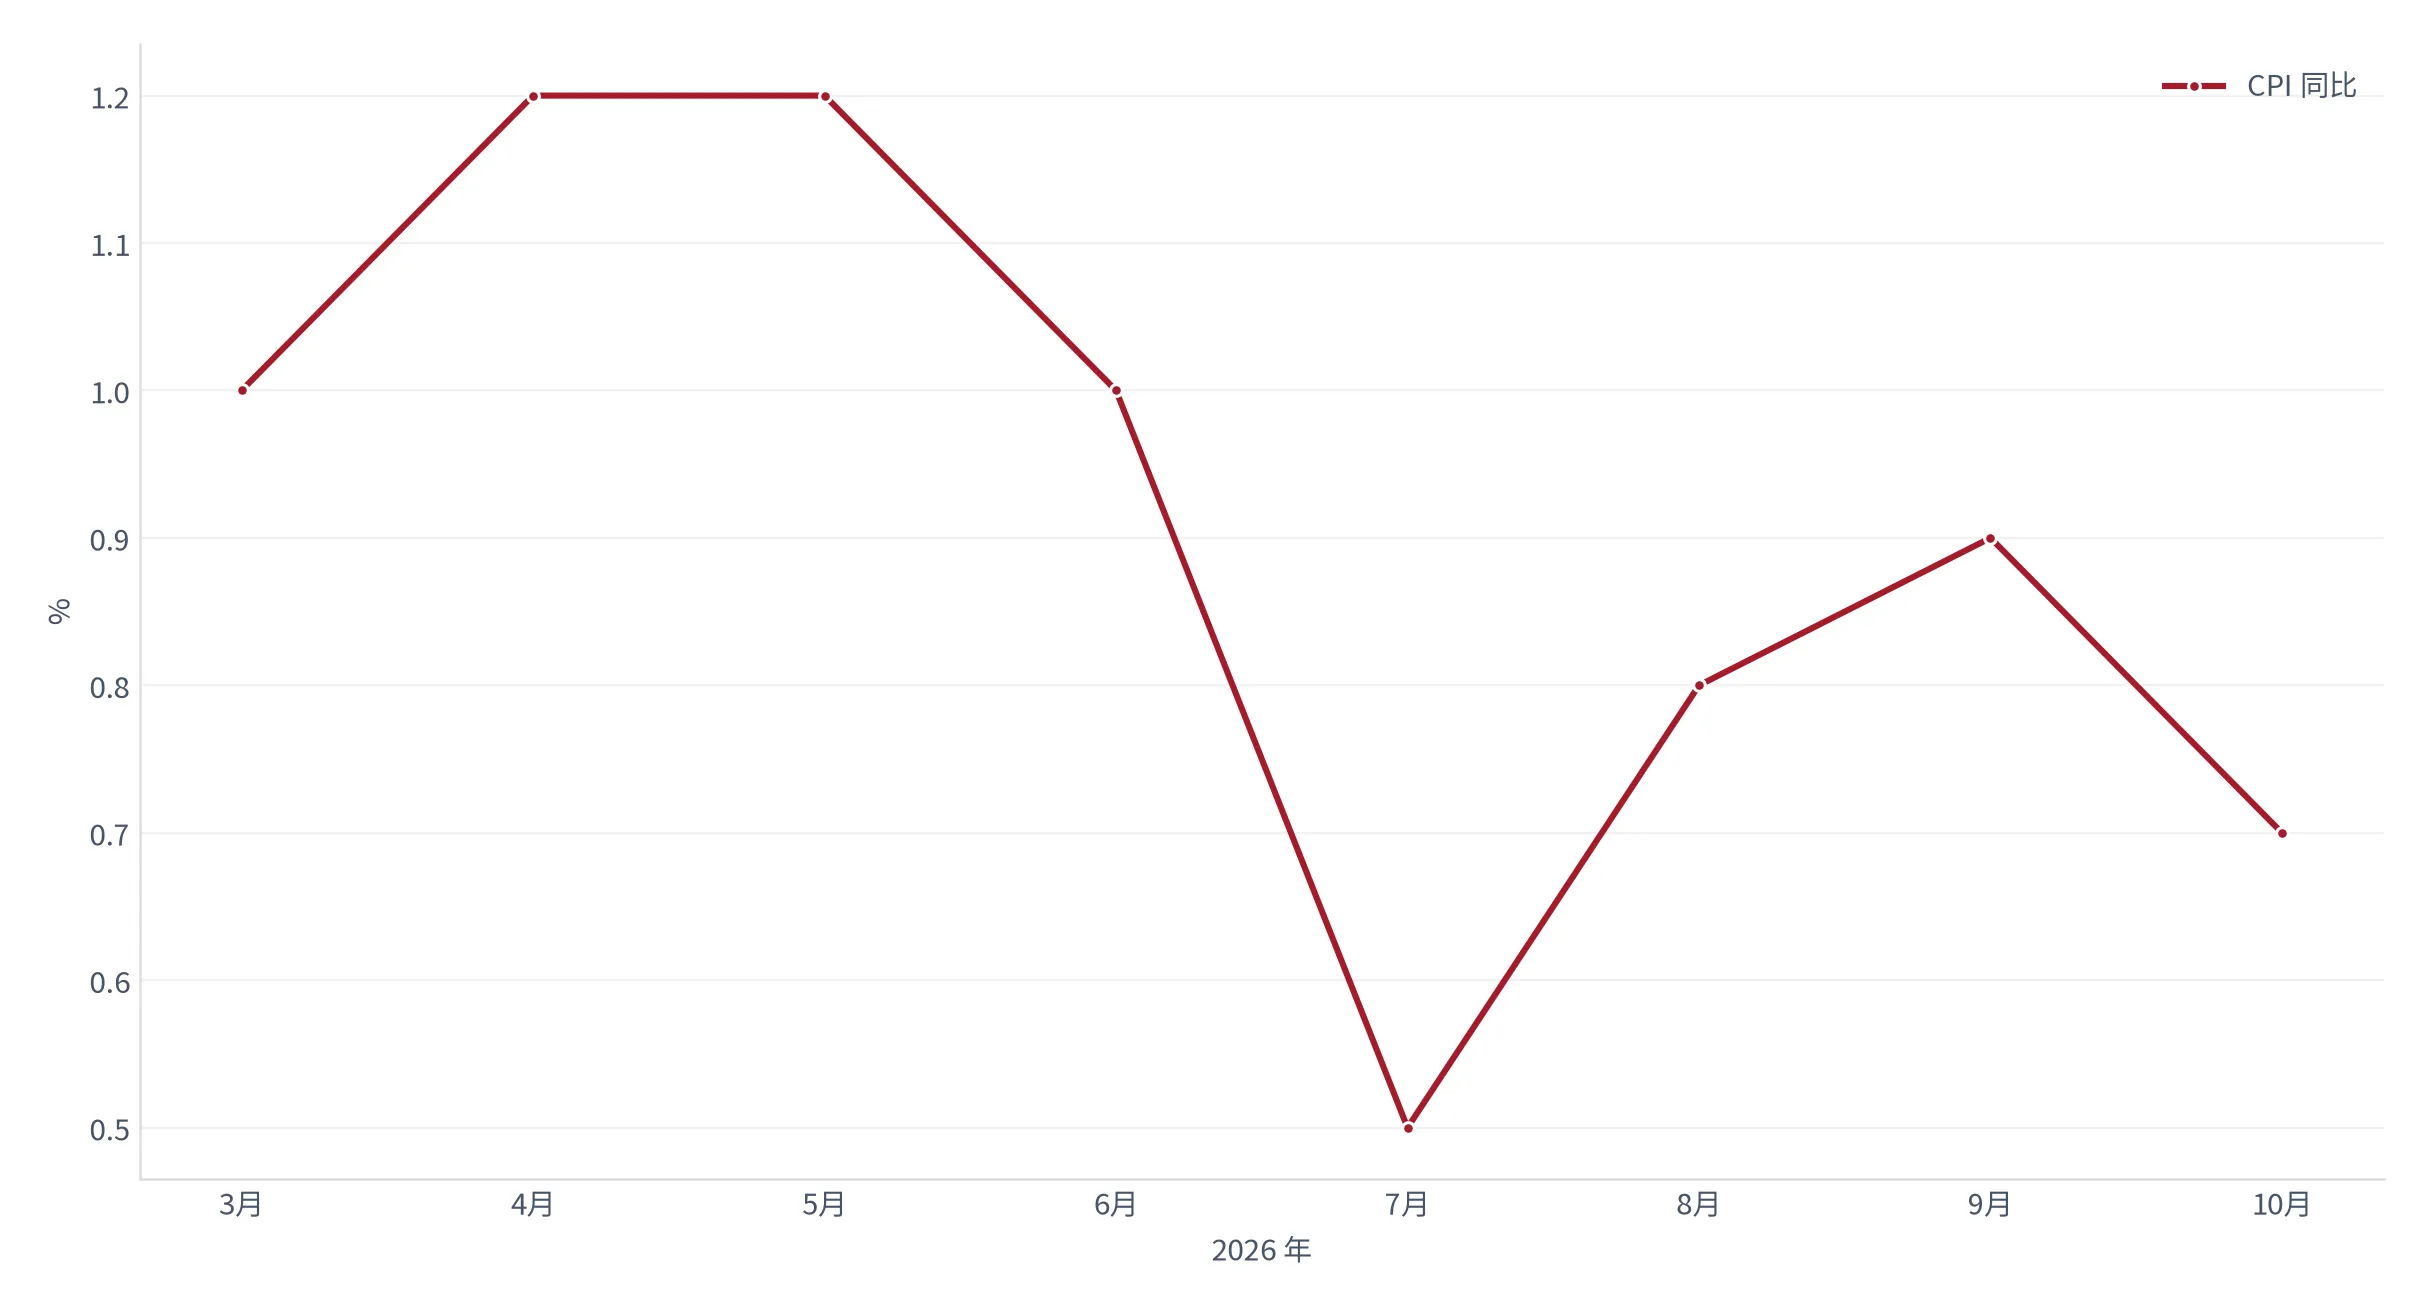
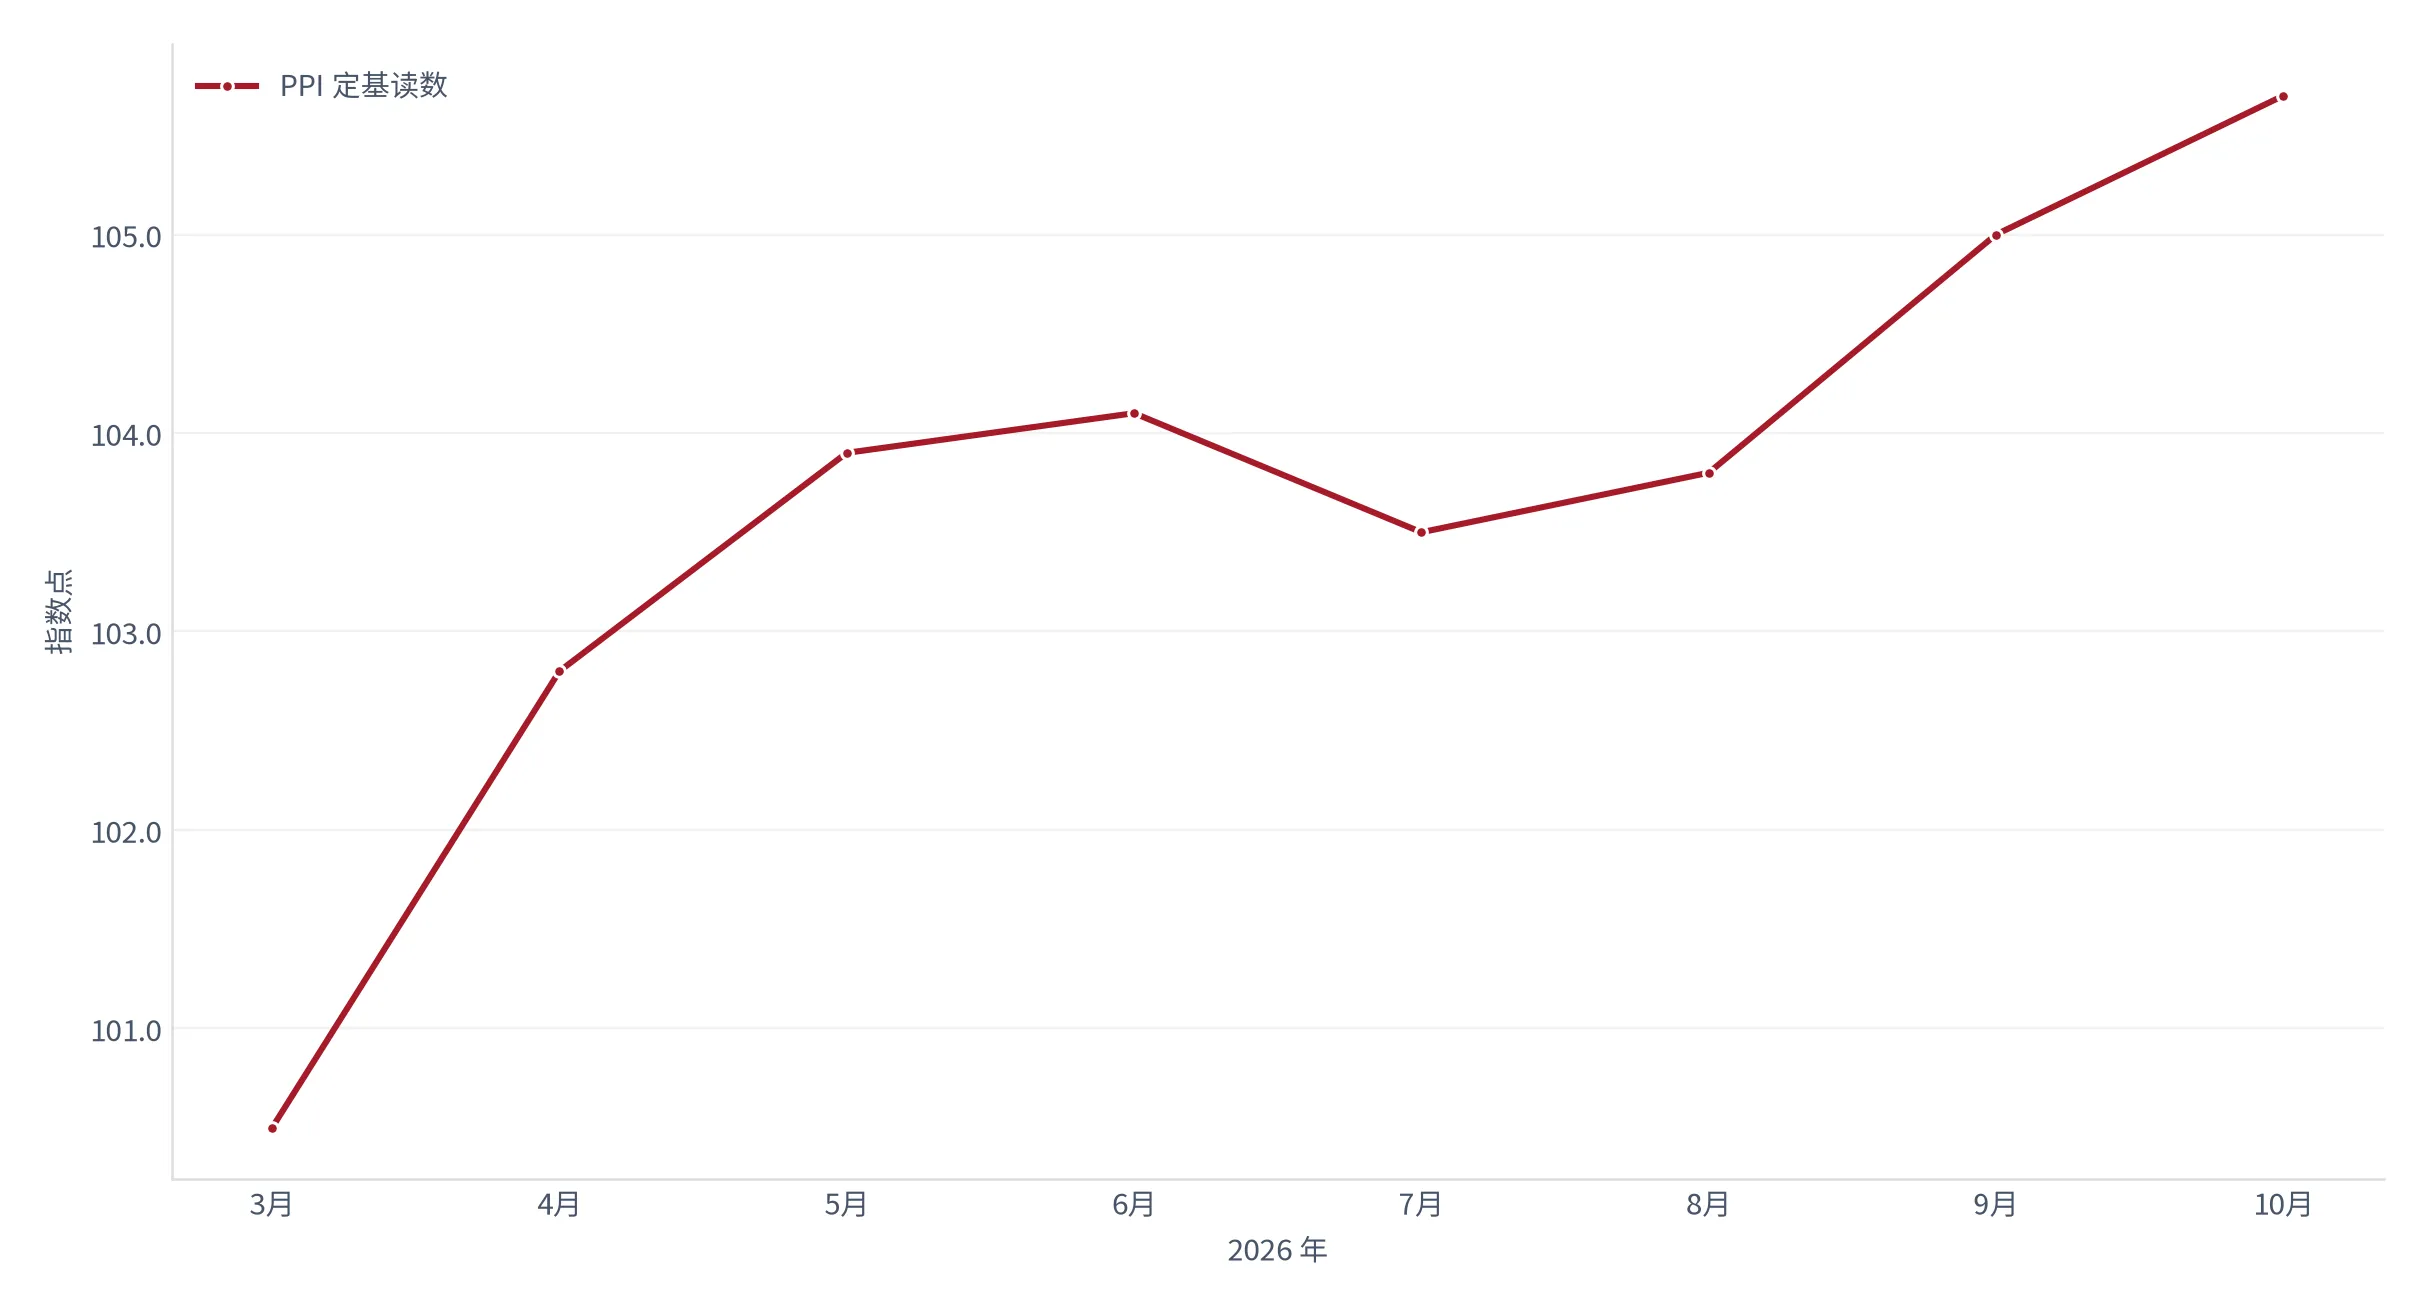
CPI 从 2026 年 3 月的 1.0% 走到 10 月的 0.7%,八个月区间 0.5% 至 1.2% [1],在模型里的角色是年薪的名义锚:低而稳的通胀意味着名义年薪上涨空间有限,2026 年 48.9 万元(三年累计 +3.8%)的假设与这个价格环境一致。PPI 定基读数从 100.5 抬到 105.7,八个月上行 5.2 个指数点 [3],与 CPI 形成反差,标记了成本端与收入端的分叉。分叉对猎头的含义是间接的:成本上行压缩用人企业的招聘预算,收入端又受客户议价能力约束,两端同时受压时中间那 56.7% 的毛利率就是唯一缓冲带——这也是本报告把毛利率列为稳定性指标而非护城河指标的原因 [11]。
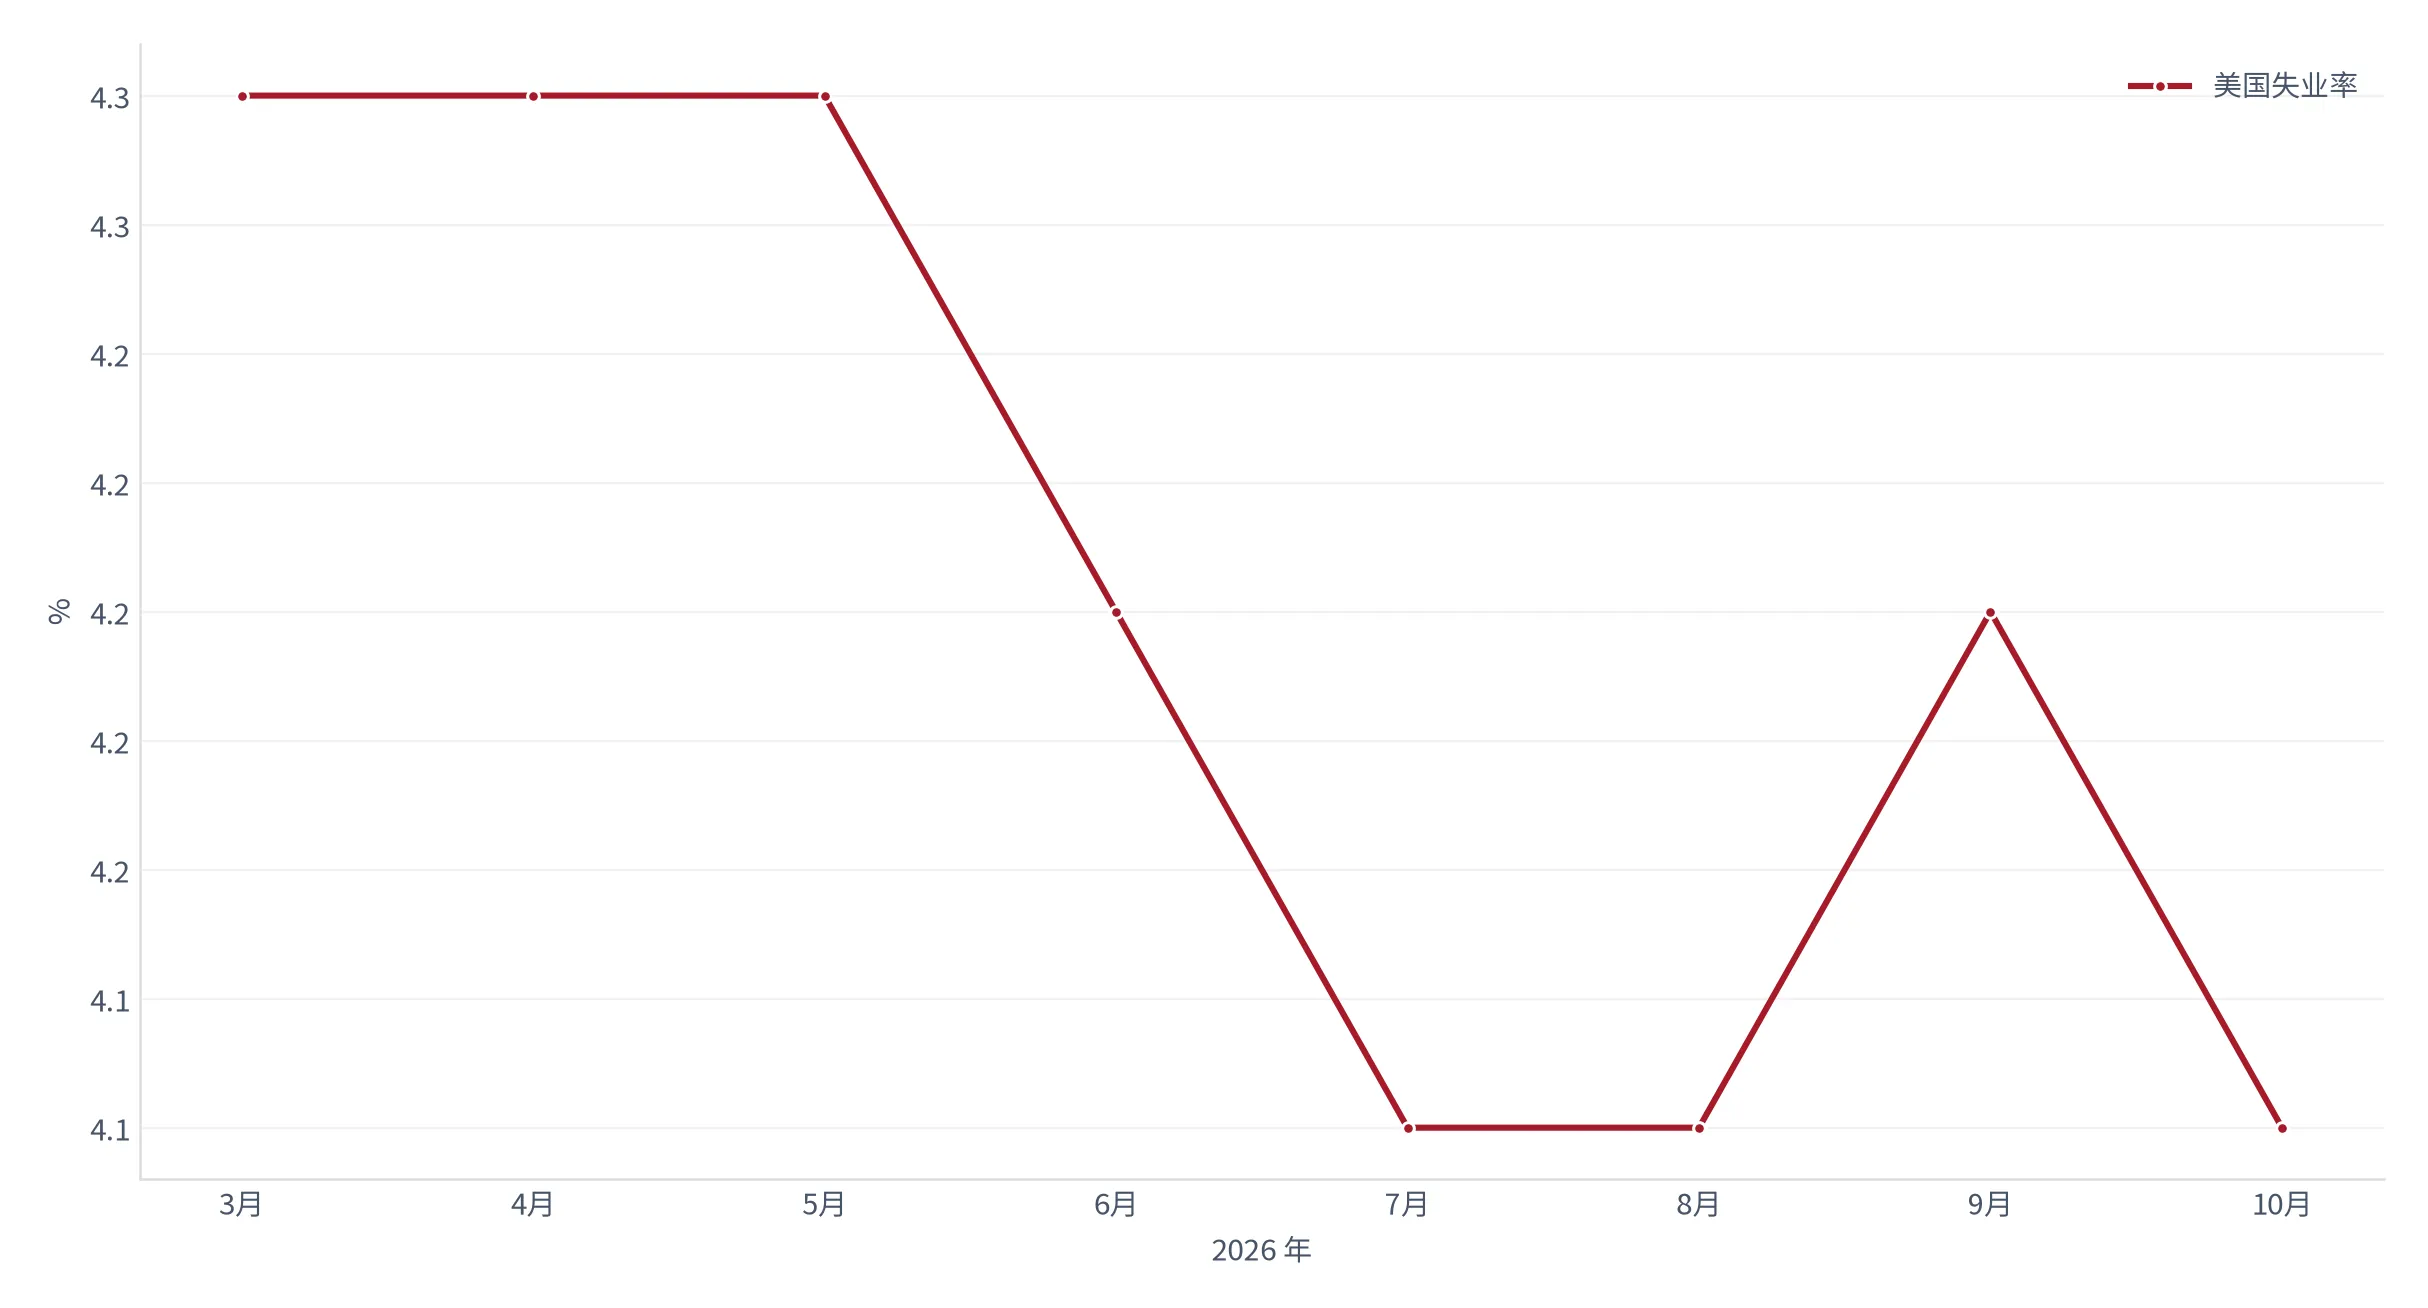
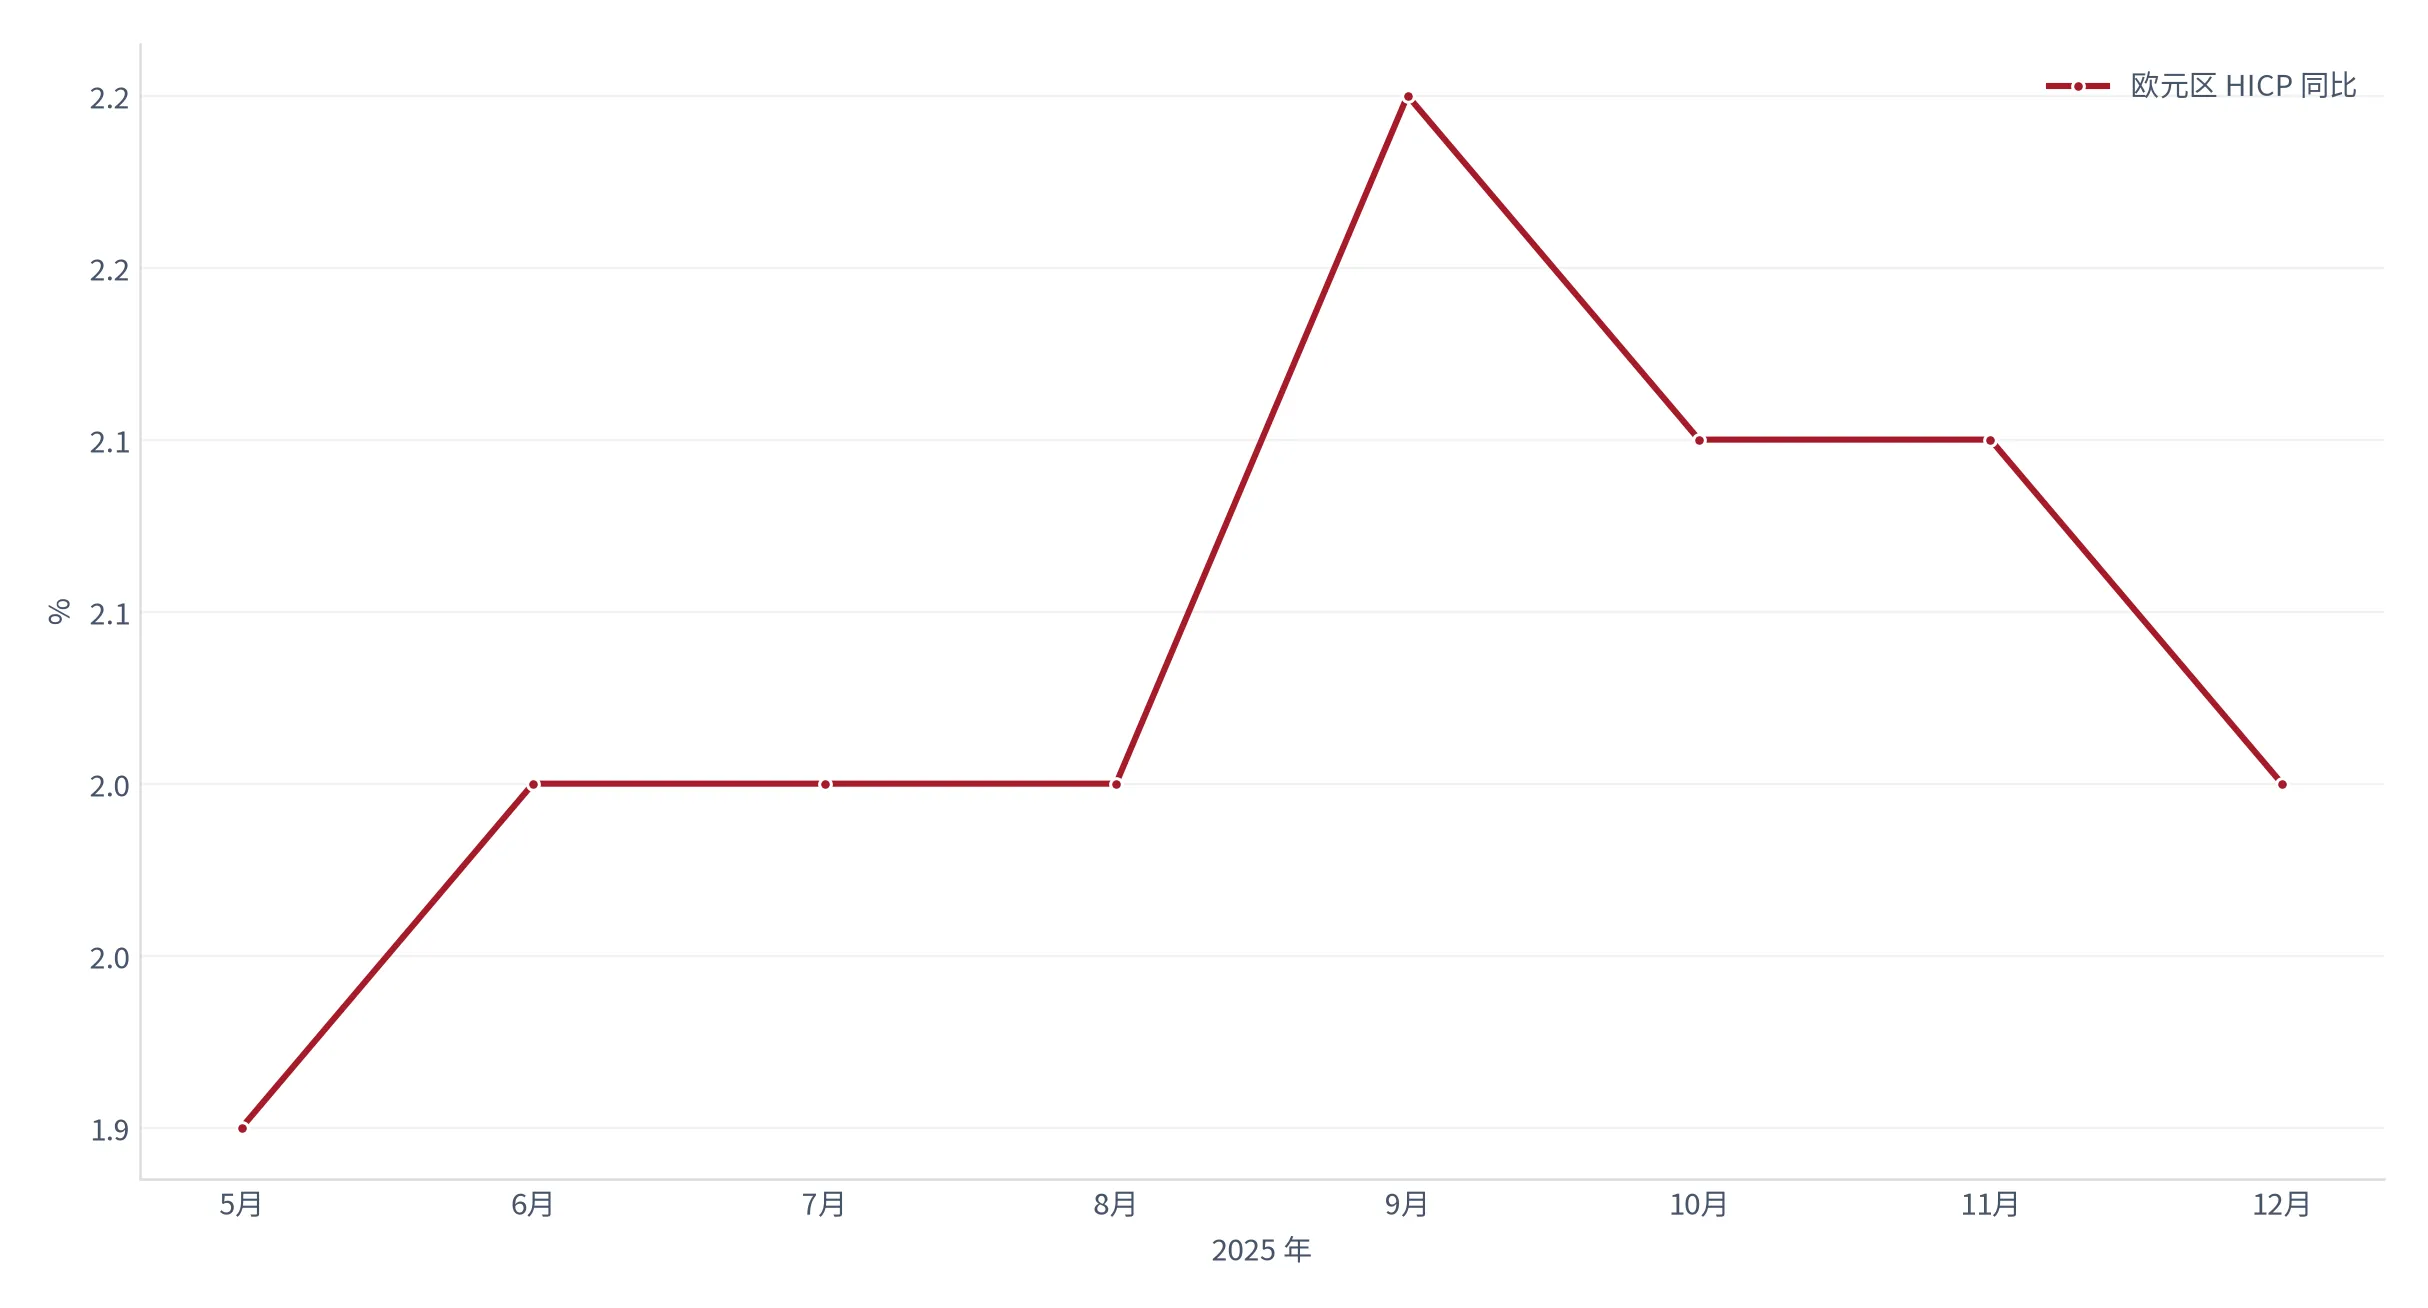
美国失业率在 4.1% 至 4.3% 间波动,八个月极差 0.2 个百分点 [5]。这个读数提供国际对照:美国猎头需求与失业率高度负相关,因为雇佣关系被快速记录;中国就业人数四年仅变动 1.36% [2],无法反映岗位层面的流动。所以中国的猎头需求不能用就业总量代理,只能用流动率代理,这正是流动率被放在敏感度首位的制度原因。欧元区 HICP 全程贴着 2% 目标(1.9% 至 2.2%)[6],与中国 0.7%、美国由 CPI 指数 337.476 与 330.293 反推的折年约 4.7% [4] 形成三个参照系。跨度说明:跨国比较单均佣金必须先处理价格水平差异,否则差距里就有相当一部分只是价格,不是服务量。
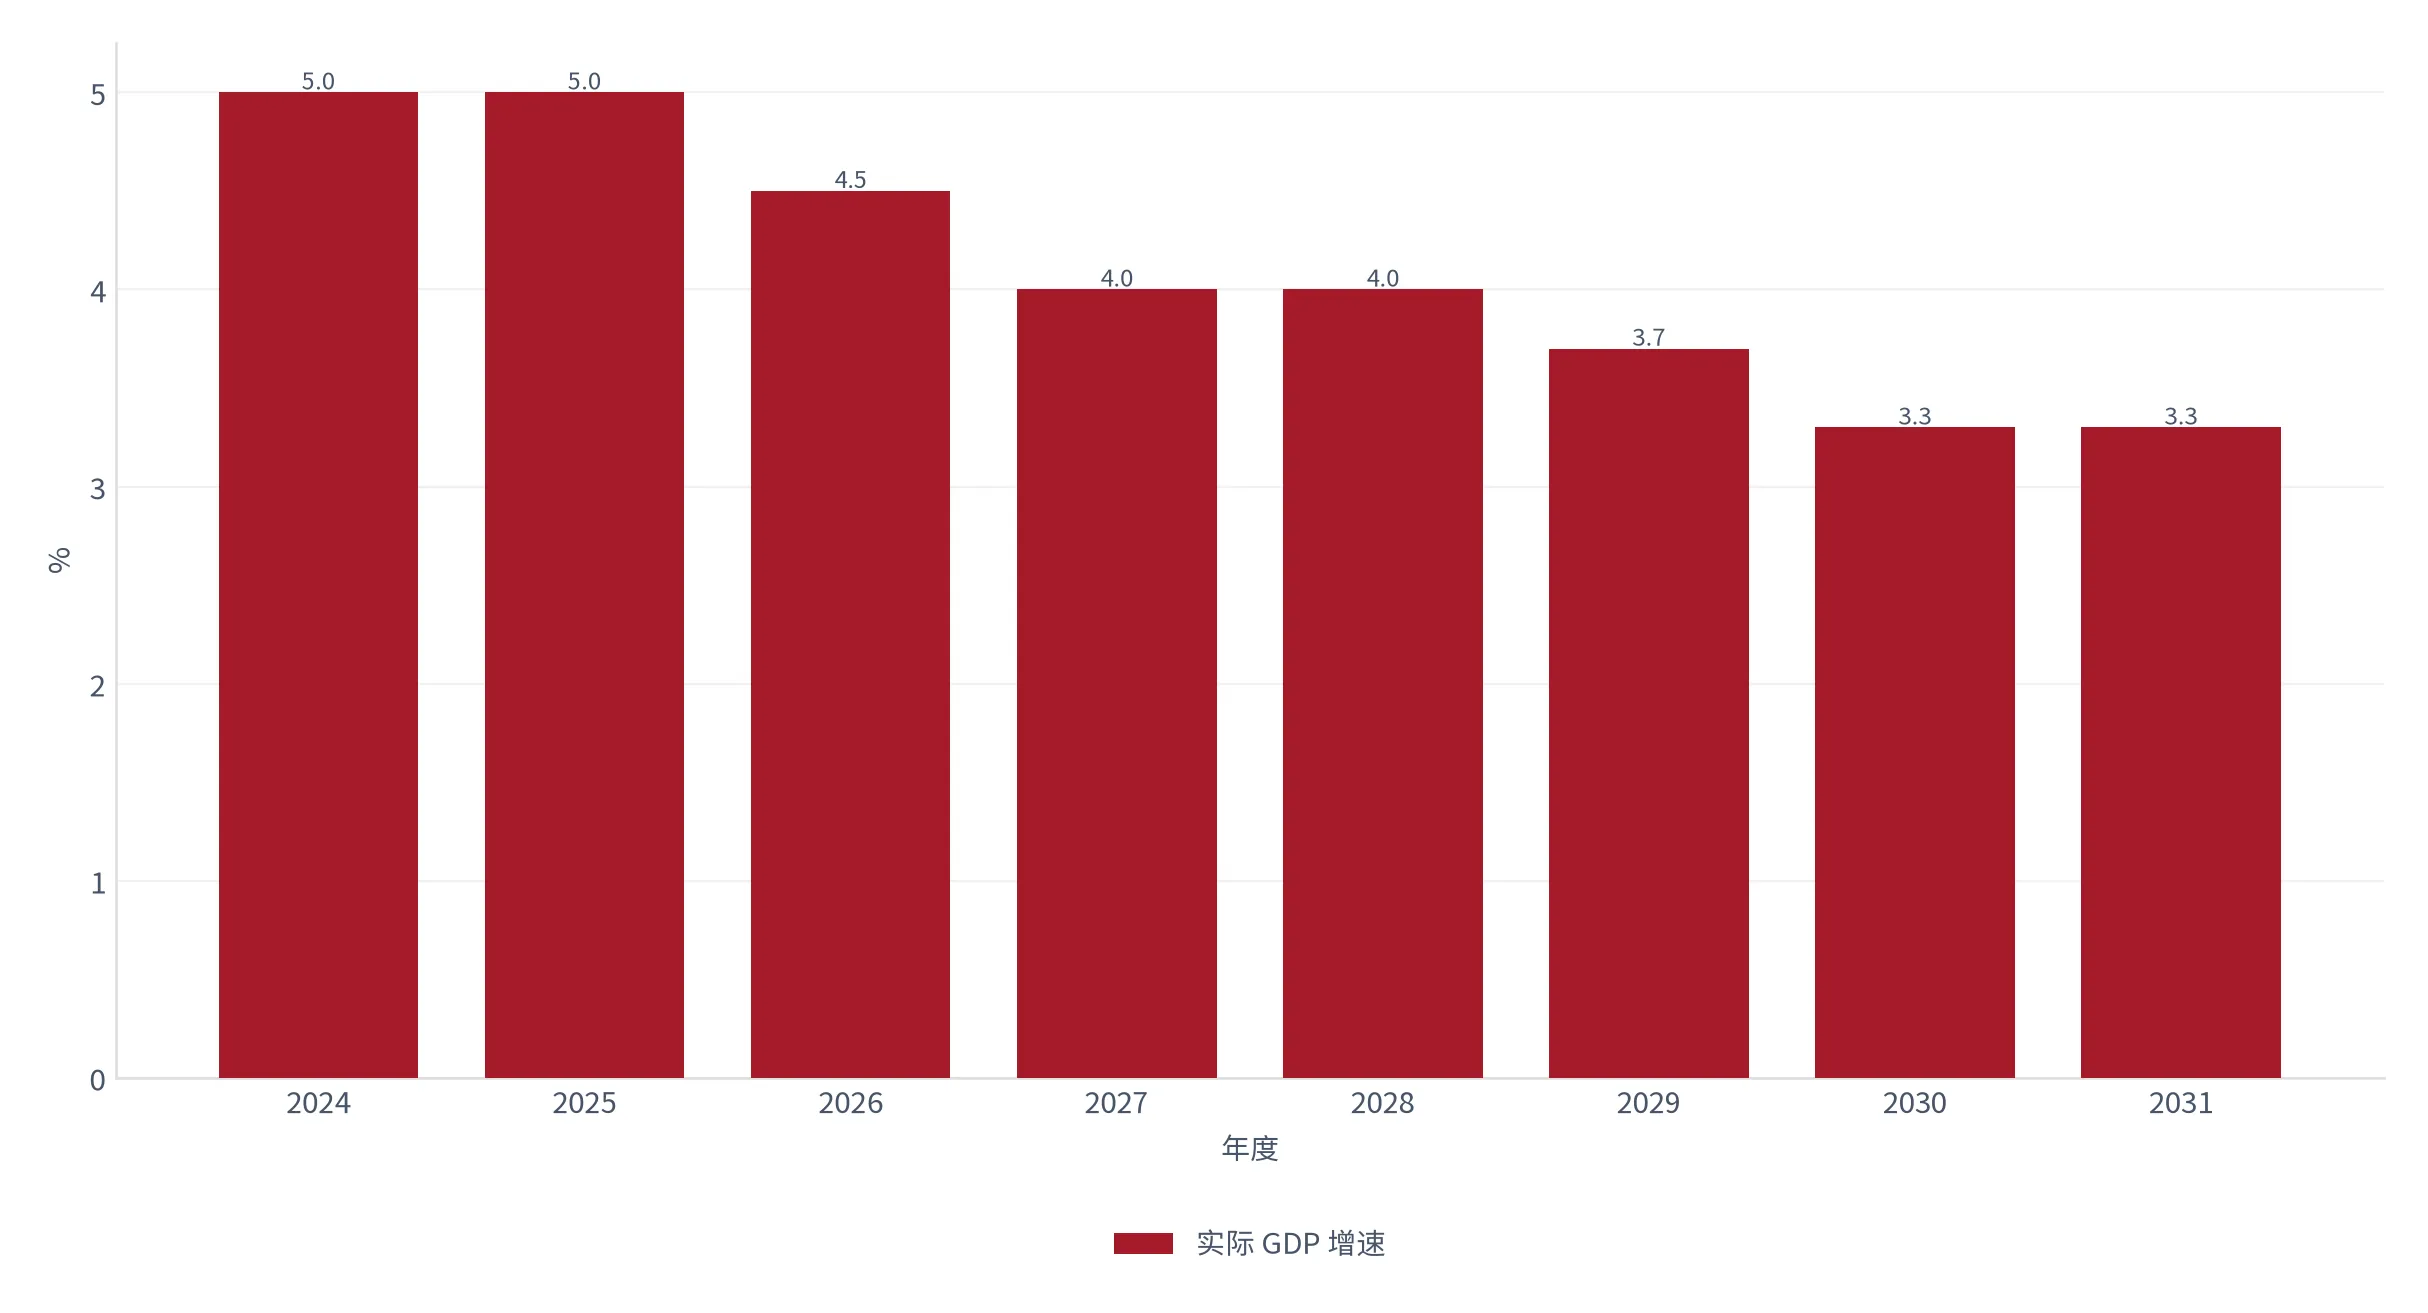
实际增速路径是 2024 年 5.0%、2025 年 5.0%、2026 年 4.5%、2027 年 4.0%,到 2031 年落到 3.3% [8],是三情景的外生输入之一:名义增长的天花板在往下走,而就业基数乘数与名义增长同向,所以中枢情景只能给到年均 2.4%。悲观情景的 -4.6% 不是假设需求萎缩,而是假设流动率与佣金率同时下行。另外,极端贫困率自 2019 年起连续四年为 0% [7],标记的是低端劳动力供给价格下限已抬升,对猎头的影响体现在低年薪档的候选人更不愿意流动。
10结论与观察指标
把全篇压缩成三句话。第一,收入池由五个乘数连乘,2023 年 1,329.1 亿元、2026 年 1,447.3 亿元,三年累计 8.9%,其中量涨 6.1%、价涨 2.6% [9]。第二,五段链条里唯一能做强排序的瓶颈是顾问交付产能,弹性 1.3 分、与次低项差 0.9 分、四重筛选四维全满 [14]。第三,产能的真实刻度是在岗系数 76%,它把名义满产 161.1 万元压到实际 122.4 万元 [13]。三句话都不新,但都可以被单独检验。
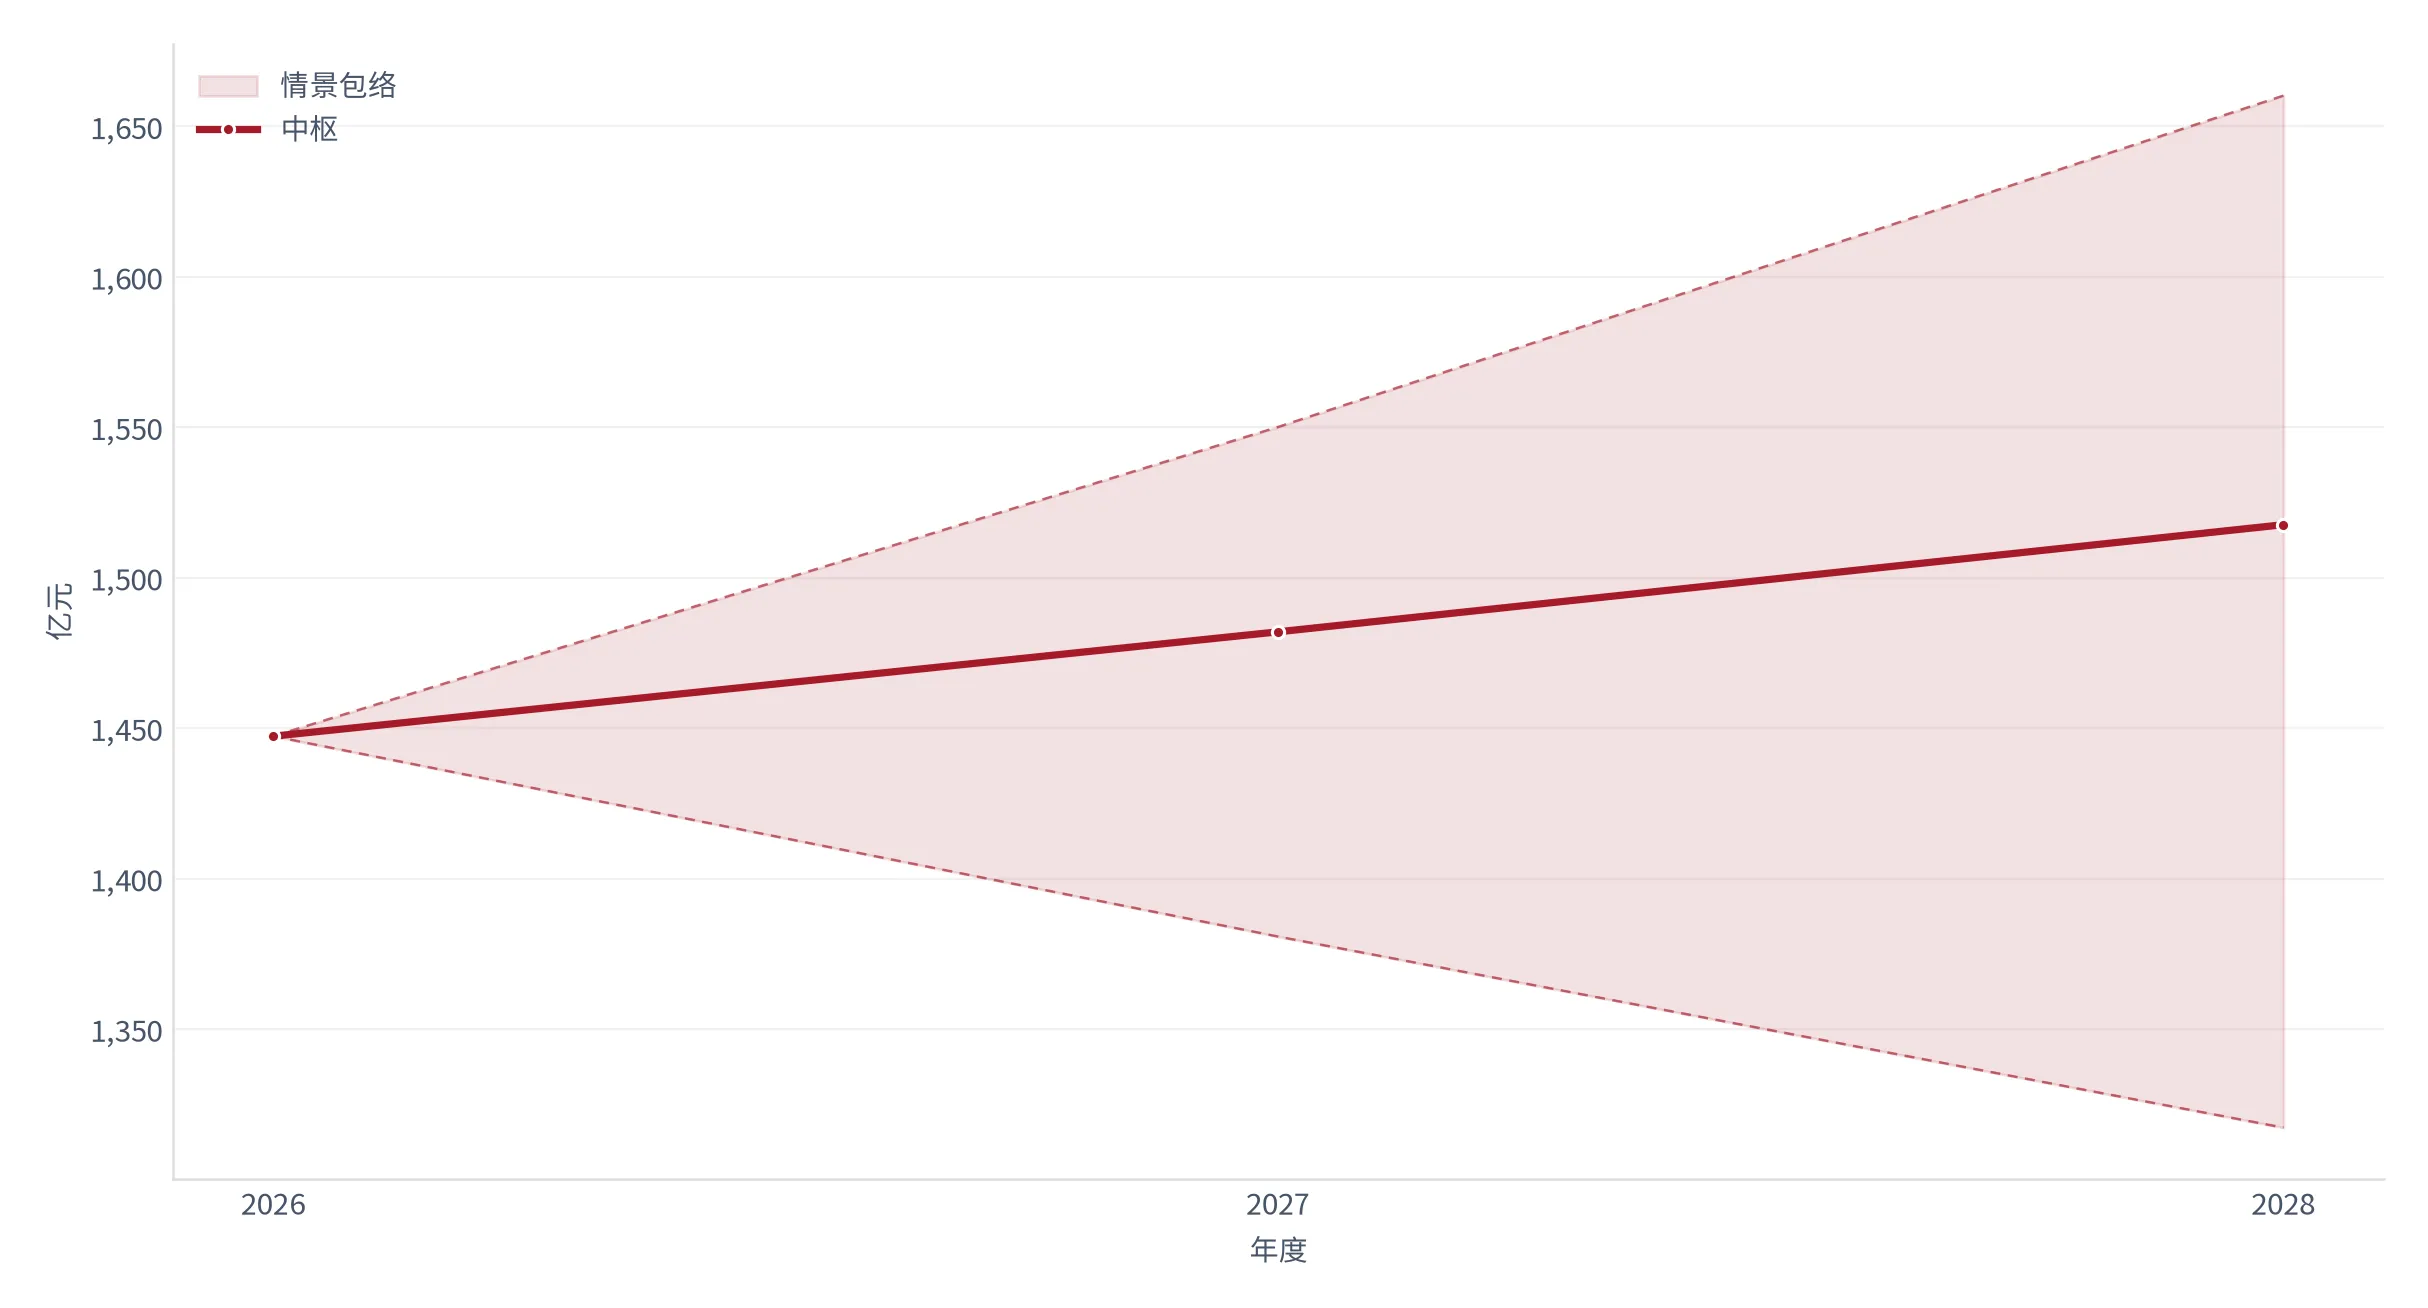
三情景从 2026 年 1,447.3 亿元出发,2028 年中枢 1,517.6 亿元、乐观 1,660.2 亿元、悲观 1,317.2 亿元 [15],区间宽度 26.1%。比很多行业窄,原因简单:三个输入(就业基数、年薪、佣金率)都是慢变量。区间宽窄本身就是行业特征的度量,不是模型精度的问题——反过来读也成立:若某个行业五年区间只有 10%,说明它的驱动量全被制度锁死了。
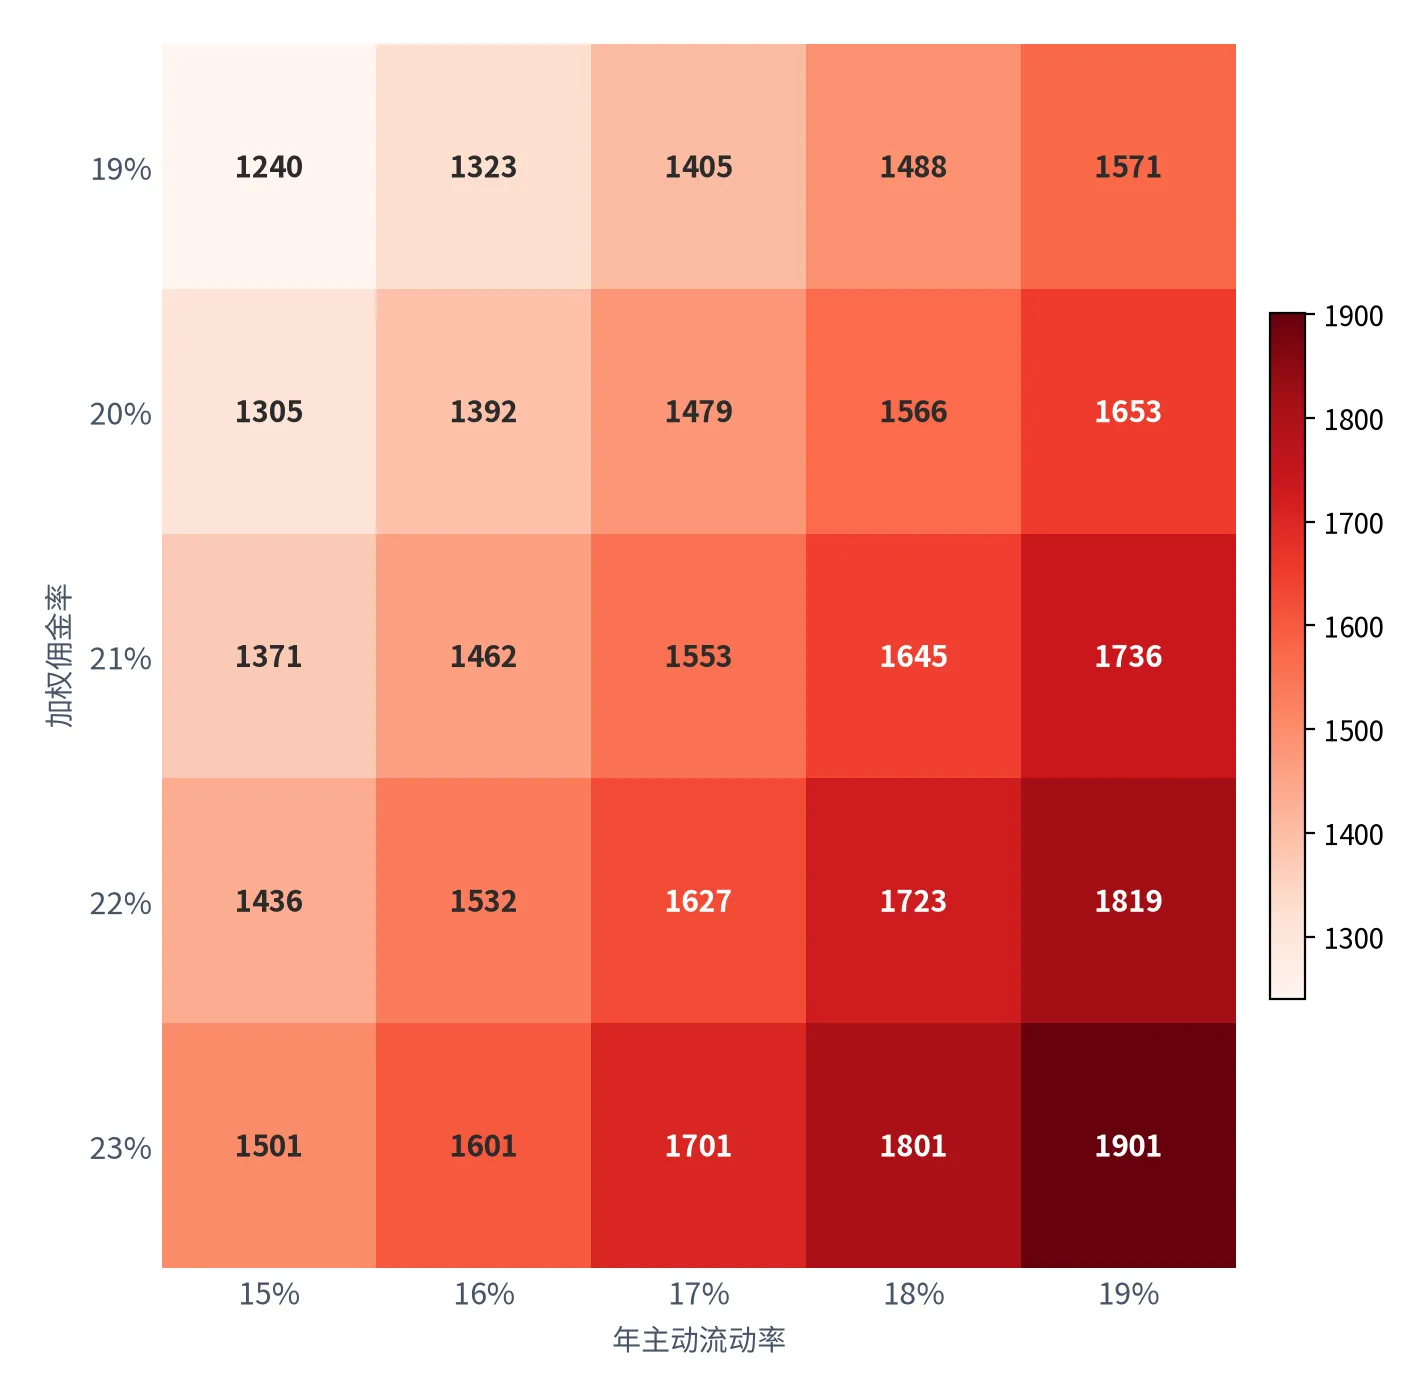
敏感性矩阵的读法:佣金率 19% 至 23%、流动率 15% 至 19% 的组合下,2028 年收入池在 1,240.0 亿元到 1,901.4 亿元之间,高低相差 53.4% [15]。两个方向的贡献不对称:流动率从 15% 走到 19% 带来 +26.7%,佣金率从 19% 走到 23% 带来 +21.1%,前者更陡,与敏感度排序一致。两条独立的算法给出同一个排序,是本报告认为结论较稳的主要理由。
| 观察指标 | 当前读数 | 跟踪频率 | 读数变化代表什么 | 触发什么复核 |
|---|---|---|---|---|
| 单量增速 | 2023 至 2026 年累计 6.1% [9] | 半年度 | 低于 1% 说明需求端失速 | 复核流动率假设 |
| 单均佣金 | 10.2 万元升至 10.47 万元 [9] | 半年度 | 转负说明议价能力恶化 | 复核分档费率 |
| 加权账期 | 72.9 天,占款 265.3 亿元 [12] | 季度 | 拉长 15 天以上先于单量变化 | 复核客户结构 |
| 在岗系数 | 76.0%,名义满产 161.1 万元 [13] | 年度 | 低于 70% 说明扩编质量下降 | 复核产能模型 |
| 交付产能弹性 | 1.3 分,与次低项差 0.9 分 [14] | 年度 | 升破 2.0 分说明瓶颈转移 | 复核咽喉点标注 |
五个指标里最值得盯的是账期,因为它是唯一一个变化先于收入的读数;第二个是在岗系数,因为它是唯一能把组织问题与需求问题分开的读数。单量与单均佣金都滞后:单量要等客户名单续签才反映,佣金率要等年度框架重谈才反映。把滞后读数当先行指标,是财报点评最常见的时序错误。熔断线写成三条:其一,单量增速连续两期低于 1% 且账期同时拉长 15 天以上,2027 年中枢假设作废,退回悲观情景;其二,在岗系数跌破 70% 而顾问人数仍在增长,人均回款测算整体下修;其三,交付产能弹性升破 2.0 分,全篇强排序作废。任何一条被触发,核心判断需要重写而不是微调。
回到开篇的担心:市场把猎头当成招聘周期的放大器。这个判断不算错,但把三种完全不同的因果混成了一种。本报告只做一件事——把「景气」拆成五个可分别读数的乘数,指出哪一个最难扩、哪一个最早动。拆开之后结论不再刺激:一个年均不到 3% 的收入池、一个 1.3 分的瓶颈、一个 76% 的在岗系数。但这组平淡的数字可以被逐条检验,而一句「招聘景气下行」不能。
A数据来源与证据表
| 编号 | 来源 / 报告 | 关键数据 | 链接 |
|---|---|---|---|
| [1] | 东方财富数据中心(公开宏观数据) 东方财富数据中心 — 中国CPI(RPT_ECONOMY_CPI) |
中国CPI(2026年10月份,NATIONAL_SAME=0.7);年度序列 2026年10月份=0.7;2026年09月份=0.9;2026年08月份=0.8;2026年07月份=0.5;2026年06月份=1;2026年05月份=1.2。单位与口径见来源页。 [T2] 检索:2026-11-11 |
https://datacenter-web.eastmoney.com/api/data/v1/get?reportName=RPT_ECONOMY_CPI&columns=ALL&pageNumber=1&pageSize=8&sortColumns=REPORT_DATE&sortTypes=-1 |
| [2] | 国际劳工组织(ILOSTAT) 国际劳工组织 — 就业人数(EMP_TEMP_SEX_AGE_NB_A) |
就业人数(中国,2023 年)= 740,410.00;年度序列 2023=740,410.00;2022=733,510.00;2021=746,520.00;2020=750,640.00。单位与口径见来源页。 [T1] 检索:2026-11-11 |
https://rplumber.ilo.org/data/indicator/?id=EMP_TEMP_SEX_AGE_NB_A&ref_area=CHN&limit=8 |
| [3] | 东方财富数据中心(公开宏观数据) 东方财富数据中心 — 中国PPI(RPT_ECONOMY_PPI) |
中国PPI(2026年10月份,BASE=105.7);年度序列 2026年10月份=105.7;2026年09月份=105;2026年08月份=103.8;2026年07月份=103.5;2026年06月份=104.1;2026年05月份=103.9。单位与口径见来源页。 [T2] 检索:2026-11-11 |
https://datacenter-web.eastmoney.com/api/data/v1/get?reportName=RPT_ECONOMY_PPI&columns=ALL&pageNumber=1&pageSize=8&sortColumns=REPORT_DATE&sortTypes=-1 |
| [4] | 美国圣路易斯联储(FRED) 美国圣路易斯联储 — 美国CPI(CPIAUCSL) |
美国CPI(2026-10-01)= 337.476;年度序列 2026-03-01=330.293;2026-04-01=332.407;2026-05-01=333.979;2026-06-01=332.568;2026-07-01=332.813;2026-08-01=334.131。单位与口径见来源页。 [T1] 检索:2026-11-11 |
https://fred.stlouisfed.org/graph/fredgraph.csv?id=CPIAUCSL&cosd=2018-01-01 |
| [5] | 美国圣路易斯联储(FRED) 美国圣路易斯联储 — 美国失业率(UNRATE) |
美国失业率(2026-10-01)= 4.1;年度序列 2026-03-01=4.3;2026-04-01=4.3;2026-05-01=4.3;2026-06-01=4.2;2026-07-01=4.1;2026-08-01=4.1。单位与口径见来源页。 [T1] 检索:2026-11-11 |
https://fred.stlouisfed.org/graph/fredgraph.csv?id=UNRATE&cosd=2018-01-01 |
| [6] | 欧盟统计局(Eurostat) 欧盟统计局 — 欧元区HICP通胀率同比(prc_hicp_manr) |
欧元区HICP通胀率同比(欧元区,2025-12)= 2;年度序列 2025-05=1.9;2025-06=2;2025-07=2;2025-08=2;2025-09=2.2;2025-10=2.1。单位与口径见来源页。 [T1] 检索:2026-11-11 |
https://ec.europa.eu/eurostat/api/dissemination/statistics/1.0/data/prc_hicp_manr?geo=EA&sinceTimePeriod=2024-01&lang=en&coicop=CP00 |
| [7] | 联合国统计司(UN SDG) 联合国统计司 — 极端贫困率(SI_POV_DAY1) |
极端贫困率(中国,2022 年)= 0;年度序列 2015=2.9;2016=2.1;2017=1.6;2018=0.7;2019=0;2020=0。单位与口径见来源页。 [T1] 检索:2026-11-11 |
https://unstats.un.org/sdgapi/v1/sdg/Series/Data?seriesCode=SI_POV_DAY1&areaCode=156&pageSize=100 |
| [8] | 国际货币基金组织(IMF) 国际货币基金组织 — GDP实际增长率(NGDP_RPCH) |
GDP实际增长率(CHN,2031 年)= 3.3(IMF 预测值);年度序列 2024=5;2025=5;2026=4.5;2027=4;2028=4;2029=3.7。单位与口径见来源页。 [T1] 检索:2026-11-11 |
https://www.imf.org/external/datamapper/api/v1/NGDP_RPCH/CN/CHN |
| [9] | 本报告测算口径(收入池五乘数) 猎头服务收入池五因子连乘测算(2023 与 2026) |
收入池 = 就业人数 × 中高端岗位占比 × 年主动流动率 × 平均年薪 × 加权佣金率;2023 年 = 7.4041 亿人 × 1.10% × 16.0% × 47.1 万元 × 21.66% = 1,329.1 亿元;2026 年 = 7.38 亿人 × 1.15% × 16.3% × 48.9 万元 × 21.40% = 1,447.3 亿元;分档佣金率 26%/23%/20%/17% 对应年薪 24/45/80/150 万元,四档候选池 620/340/165/62 万人,单量结构 50%/28%/15%/7%;三年累计 8.9%、年均 2.9%,单量由 130.3 万单增至 138.3 万单、累计 6.1%;单位为 亿元、%、万单、万人与 万元。 [测算] 检索:2026-11-11 |
—(本报告测算,无外部直接来源) |
| [10] | 本报告测算口径(单顾问产能) 单顾问年交付能力与工时利用率测算(2023) |
人均年回款 = 12 单 × 10.2 万元 = 122.4 万元/人;顾问人数 = 1,329.1 亿元 ÷ 122.4 万元 = 10.86 万人;工时利用率 = 12 ÷ (1,760 小时 ÷ 76 小时) = 12 ÷ 23.2 = 51.8%;分档交付周期按寻访、面试、入职谈判三段拆分,四档合计 31/46/68/104 天;单位为 万元/人、万人、单、天与 %。 [测算] 检索:2026-11-11 |
—(本报告测算,无外部直接来源) |
| [11] | 本报告测算口径(单均佣金损益) 单均佣金损益结构与收入池去向测算(2023) |
单均佣金 = 47.1 万元 × 21.66% = 10.2 万元;交付成本 = 3.42 + 0.71 + 0.29 = 4.42 万元,毛利 5.78 万元、毛利率 56.7%;销售费用 1.83 万元、管理费用 1.42 万元,经营利润 2.53 万元、经营利润率 24.8%;放大至收入池得交付成本 575.6 亿元、销售 238.2 亿元、管理 185.0 亿元、经营利润 330.3 亿元,尾差 0.7 亿元;单位为 万元、亿元与 %。 [测算] 检索:2026-11-11 |
—(本报告测算,无外部直接来源) |
| [12] | 本报告测算口径(客户结构与应收) 客户规模结构与应收账款占款测算(2023) |
KA 客户(年招聘预算 5,000 万元以上)客户数 12%、收入 58%、佣金率 19%、账期 96 天、续约率 78%;中小客户对应 88%、42%、25%、41 天、46%;加权佣金率 = 0.58 × 19 + 0.42 × 25 = 21.52%,与分年薪档口径 21.66% 相差 0.14 个百分点;加权账期 = 72.9 天;应收占款 = 1,329.1 亿元 × 72.9 ÷ 365 = 265.3 亿元,其中 KA 202.7 亿元、中小 62.7 亿元;单位为 %、天与 亿元。 [测算] 检索:2026-11-11 |
—(本报告测算,无外部直接来源) |
| [13] | 本报告测算口径(顾问流失与在岗系数) 顾问流失率、在岗系数与重置成本测算(2023) |
净产能损失 = 26% × (1 - 9.4 ÷ 12) = 5.6%;在岗系数 = 30% × 42% + 30% × 78% + 40% × 100% = 76.0%,名义满产 = 122.4 万元 ÷ 0.76 = 161.1 万元/人;重置成本 = 1.9 + 0.9 + 0.7 = 3.5 万元,年流失 2.82 万人对应 9.9 亿元;净产能损失折年 = 1,329.1 亿元 × 5.6% = 74.4 亿元;流失率 20% 至 32% 对应损失 4.33% 至 6.93%;单位为 %、万元/人与 亿元。 [测算] 检索:2026-11-11 |
—(本报告测算,无外部直接来源) |
| [14] | 本报告测算口径(链条评分与环节毛利) 五段链条供给弹性、四重筛选矩阵与环节毛利率测算(2026) |
供给弹性按要素积累周期、认证要求、替代难度三项等权,5 分最易扩:顾问交付产能 1.3、合规与数据安全 2.2、候选人与人才数据 2.7、客户关系与采购预算 3.1、技术栈 4.2,分组阈值取分差 0.8 分;四重筛选各维 0–2 分:交付产能 2/2/2/2、人才数据 2/1/1/1、客户关系 1/2/2/0、技术栈 1/1/1/2、合规 1/1/2/1;环节毛利率:技术栈 74%、人才数据 68%、交付产能 56.7%、合规 41%、客户关系 22%;单位为 分与 %。 [测算] 检索:2026-11-11 |
—(本报告测算,无外部直接来源) |
| [15] | 本报告测算口径(三情景与敏感性) 2027–2028 年收入池三情景、参数敏感性与压力测试测算 |
敏感性以 2026 年 1,447.3 亿元为底:流动率每上行 1 个百分点增 88.8 亿元,佣金率每上行 1 个百分点增 67.6 亿元,平均年薪每上行 1% 增 14.5 亿元,前者为后两者的 1.31 倍与 6.1 倍;三情景 2028 年:乐观 1,660.2 亿元、中枢 1,517.6 亿元、悲观 1,317.2 亿元;敏感性矩阵取佣金率 19%/20%/21%/22%/23% 与流动率 15%/16%/17%/18%/19% 两维,区间 1,240.0 至 1,901.4 亿元、高低差 53.4%;单位为 亿元、%与 百分点。 [测算] 检索:2026-11-11 |
—(本报告测算,无外部直接来源) |
| [16] | 本报告测算口径(证据档次) 证据档次分布与机构分布测算 |
证据档次:T1 官方与国际组织直达 6 条、T2 公开数据中心结构化指标 2 条、测算 8 条、T3 定性资料 0 条,合计 16 条;机构分布:美国圣路易斯联储 2 条、东方财富数据中心 2 条、国际劳工组织 1 条、欧盟统计局 1 条、联合国统计司 1 条、国际货币基金组织 1 条、本报告测算 8 条;自测算占比 0.50;单位为 条与 比值。 [测算] 检索:2026-11-11 |
—(本报告测算,无外部直接来源) |
B证明链台账
下表把正文中的八条可证伪链集中登记。与一般台账不同,每一条都对应分析骨架中的一个环节,因此它同时是一张「哪一环的证据最薄」的诊断表。
| 序号 | 判断 | 对应环节 | 核心依据 | 当前状态 |
|---|---|---|---|---|
| 链 1 | 收入池应由五个乘数连乘刻画 | 全景拆解 | 1,329.1 亿元与 1,447.3 亿元,五因子取值各自独立 [9] | 已成立(算术) |
| 链 2 | 产能真实刻度是在岗系数 76% | 中游 | 30%/30%/40% 结构加权,名义 161.1 万元对实际 122.4 万元 [13] | 部分待验证(缺公开结构) |
| 链 3 | 下游边际变化先出现在账期 | 下游 | 加权账期 72.9 天,占款 265.3 亿元 [12] | 有依据,待两期以上验证 |
| 链 4 | ★咽喉点是顾问交付产能 | 瓶颈识别 | 弹性 1.3 分、分差 0.9 分、四维全满 [14] | 已成立(评分内部) |
| 链 5 | 六类参与者只有两类落在咽喉点 | 公司映射 | 环节覆盖评分,六类证据均为业务描述级 [14] | 已成立(归类判断) |
| 链 6 | 三读数权重与时序相反 | 当期位置 | 88.8/67.6/14.5 亿元对账期 72.9 天 [15][12] | 部分待验证(样本少) |
| 链 7 | 宏观读数只给参数划边界 | 外部校验 | 五个读数覆盖价格、就业与增速 [1]–[8] | 已成立(定位判断) |
| 链 8 | 可靠性取决于乘数是否分别读数 | 结论 | 敏感性矩阵高低相差 53.4% [15] | 已成立(方法性判断) |
台账中「已成立」只表示该判断在本报告口径内自洽,不表示已被外部独立验证。标注「部分待验证」的两条分别受制于顾问在岗结构的披露缺失与样本期数不足,下一篇迭代应优先补这两块。
C数据档次与假设参数
本报告证据分四档:T1 为国际组织官方数据库的直达数据 6 条,用于设定外生锚;T2 为公开数据中心的结构化指标 2 条,用于价格水平跟踪;测算 8 条,每条写明取值、公式与单位;T3 为业务描述级资料,本报告不采信其中的任何量化数字,故计 0 条。四类合计 16 条,编号连续 [16]。
| 参数 | 取值 | 设定理由 | 敏感性 |
|---|---|---|---|
| 就业基数(2023) | 7.4041 亿人 | 取国际劳工组织最新年度值 | 低(慢变量,仅定水平) |
| 中高端岗位占比 | 1.10% 至 1.15% | 按高薪岗位增速略高于就业总量设定 | 中(每 0.05 个百分点约 6%) |
| 年主动流动率 | 16.0% 至 16.3% | 按就业企稳与岗位结构升级设定 | 高(每 1 个百分点 88.8 亿元) |
| 平均年薪(2023) | 47.1 万元 | 分档年薪按单量结构加权 | 低(每 1% 仅 14.5 亿元) |
| 加权佣金率 | 21.66% 至 21.40% | 分档费率 26%/23%/20%/17% 加权,逐年下移 | 高(每 1 个百分点 67.6 亿元) |
| 单均交付耗时 | 76 小时 | 交付全流程口径,含寻访、面试与谈判 | 中(直接决定工时利用率) |
| 在岗结构 | 30%/30%/40% | 首年、次年、三年以上人数占比设定 | 高(系数变动 5 个百分点即改名义产能) |
| 分组阈值 | 0.8 分 | 供给弹性排序的强判定门槛 | 高(阈值上调则不可强排序) |
上表全部参数为本报告设定值,不含机构级披露。参数之间保持算术一致:收入池由五因子连乘得到,单均佣金由年薪与费率相乘,应收占款由收入池乘账期折算,在岗系数由人数结构加权。替换任一输入需同步更新相关的瀑布、情景与敏感性结果。
本报告由云上有品基于公开资料整理,仅供一般信息与教育目的,不构成任何证券、投资或财务建议,亦不构成针对任何特定受众的个性化建议。报告中的观点、数据及预测基于截至封面日期可获得的公开信息,可能随时变化,云上有品不保证其准确性、完整性或时效性。读者应独立判断并咨询持牌专业人士。过往表现不代表未来收益。市场有风险,决策需谨慎。
评论(0)